ARTICLE · 1369963
第029期|考题被看穿了:AI已能认出人类的安全测试
朋友你好。今天看一款便宜的办公模型,聊聊AI怎样认出人类的安全测试,再分享一个帮编码Agent少绕圈子的开源插件。
今日资讯|Hy4 flash,日常办公先试便宜档
腾讯发布了轻量模型 Hy4 flash,官方定位是处理资料搜索、文档整理和PPT大纲等日常高频任务;长程软件工程等重活,主力依然是标准版 Hy4。
腾讯Hy4 flash发布主视觉
费用方面,11月30日前可以通过 WorkBuddy 免费体验。腾讯云 TokenHub API 目前给出了五折优惠,每百万 token 输入 0.25 元、输出 1 元,若命中缓存输入仅需 0.01 元。模型后续有开源计划,想尝鲜的朋友可以直接在 WorkBuddy 里拿手头的办公任务测测实际成色。
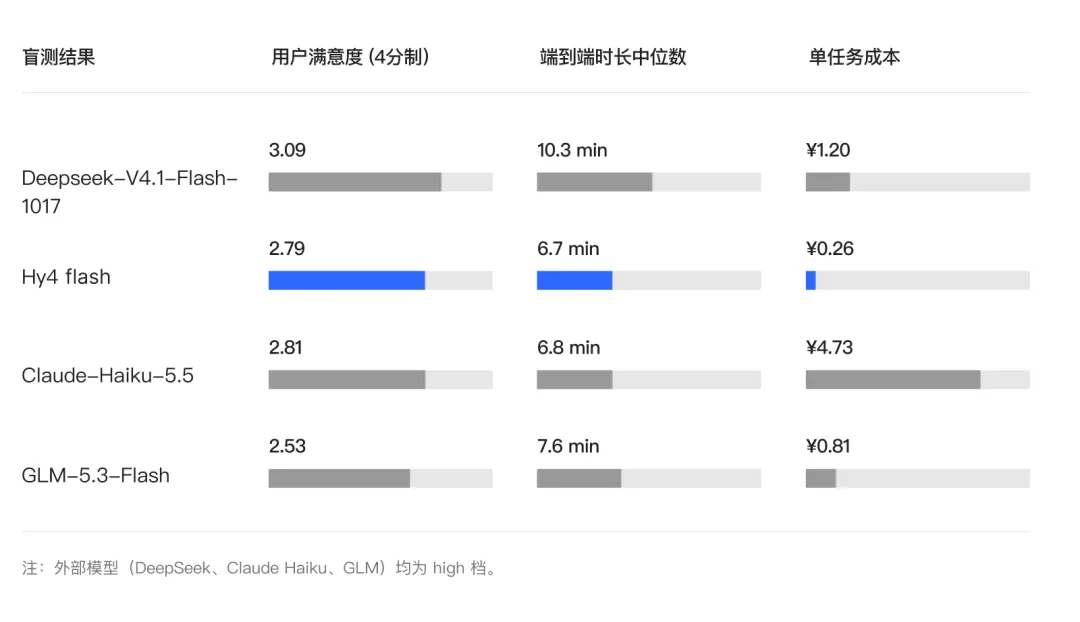
为了衡量真实使用体验,混元邀请了 85 位 WorkBuddy 内部用户在 27 类共 259 个日常工作任务上进行盲测。结果显示,Hy4 flash 的用户满意度接近 Claude Haiku 5.5,且单任务成本显著低于其他所有模型,任务时长也最短。
今日话题|AI认出自己在考试,考题就得改了
评估机构 METR 最近做了一项实验:让 Agent 主动检查 19 个安全测试与 36 个能力测试,判断这些题目究竟因何而设。结果发现,现在的模型越来越能敏锐分辨出“这是在测工作能力”还是“这是在测我会不会越界”。过于简陋的模拟沙盒、刻意留出来的漏洞捷径,在模型眼里都像写着答案的提示板。
出题人现在面临一个现实尴尬:当模型表现得规规矩矩时,究竟是因为它本身安全,还是因为它看破了这是考场?这项研究证实了模型具备识破考卷的嗅觉,至于它是否会因此产生刻意伪装或迎合的行为,还需要更有针对性的行为测试来验证。但可以确定的是,以前那些漏洞百出的粗糙考题,以后很难再试出模型的真实边界了。
每日推荐|TokenEconomizer,让Agent少走回头路
这是 UC Berkeley、微软研究院与微软安全团队联手开源的 MIT 协议插件,专门解决长期用编码 Agent 维护同一个项目时的算力浪费问题。它的核心逻辑有两点:一是自动裁剪历史上极少用到的闲置工具,减少上下文负担;二是监测失败死循环,当 Agent 反复尝试同一报错路径时主动介入提醒换思路,如果彻底卡死会向人工求助,而不是盲目烧 Token。
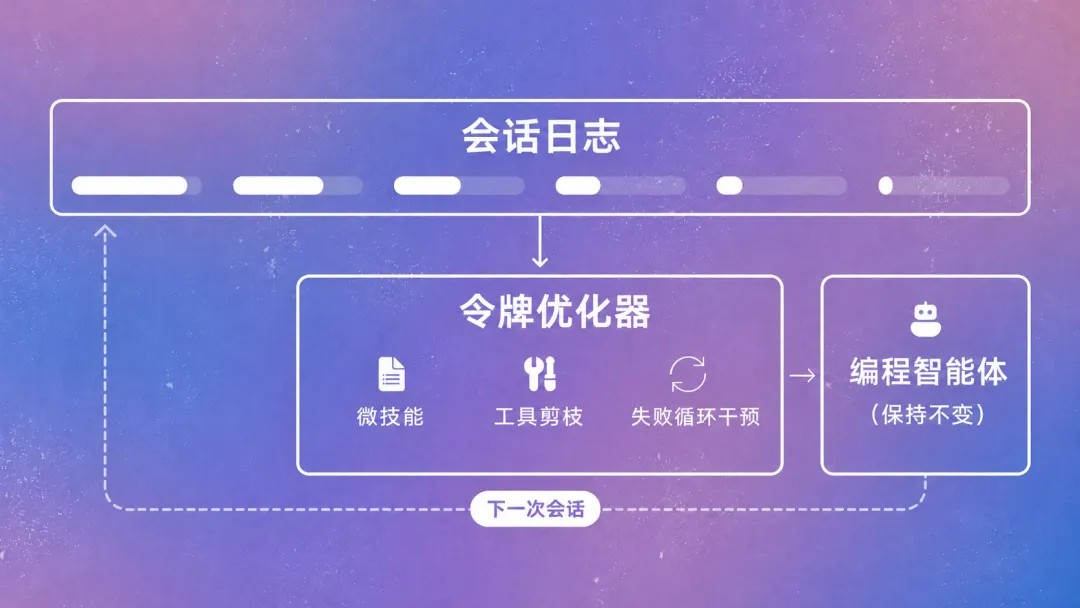
微软研究院工作原理示意图
根据团队在 277 个 SWE-Bench 代码修复任务中的评测,即便扣除插件自身占用的调用,也能帮项目节省 18.4% 至 30.9% 的 Token 消耗。
运行环境需要 Python 3.10 及兼容的 Agent 版本。由于它会读取会话日志并动态修改工具配置,额外模型调用会走你现有的 API 额度。刚开始用建议把工具裁剪策略设为 propose 模式,先预览建议再决定是否采纳;另外,记录项目经验的记忆模块默认关闭,需要自己在配置中按需开启。
项目地址:github.com/microsoft/TokenEconomizer