ARTICLE · 1371784
AI 编程省三成开销:微软开源插件,只改设置不动模型
给 AI 编程 agent 付钱的人,大概都算过这笔账:同一个仓库,今天让它改个 bug,明天让它加个功能,每次它都要重新搞清楚测试怎么跑、构建要先做哪一步、哪个命令在这台机器上根本不存在。这些钱花在了「重新认识这个项目」上,而不是花在改代码上。
微软研究院和加州大学伯克利分校的研究者把这个观察做成了一篇论文和一个插件:TokenEconomizer。它不碰模型、不碰权重、不碰 agent 的代码,只读 agent 已经跑过的会话记录,把学到的东西用在后面的会话里。
仓库地址 https://github.com/microsoft/TokenEconomizer
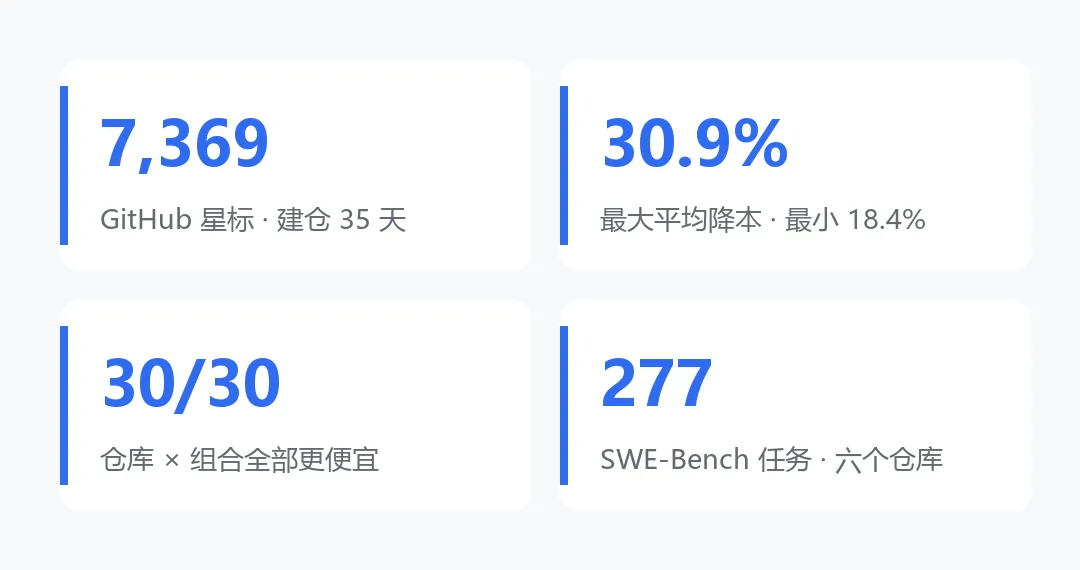
关键数字
01 · PART
它解决什么问题
论文里的说法是:编程 agent 是为完成任务设计的,不是为省钱设计的。每一轮对话都要重新付一遍 agent 的指令、每个已加载工具的定义、以及到目前为止的全部上下文。而开发者是在同一个仓库里反复用同一个 agent,所以这里面大量成本是重复的。
它把重复的部分归成三类浪费:反复重新认识仓库、发送从未用过的工具、卡在失败循环里空转。三个机制各治一类。
02 · PART
省了多少:五个组合的实测
同一批 277 个 SWE-Bench 任务,来自六个仓库,跑五种 agent 与模型的组合。每个任务单独一个会话,每个仓库的任务按顺序跑,从零开始学。成本包含插件自己发起的每一次模型调用。
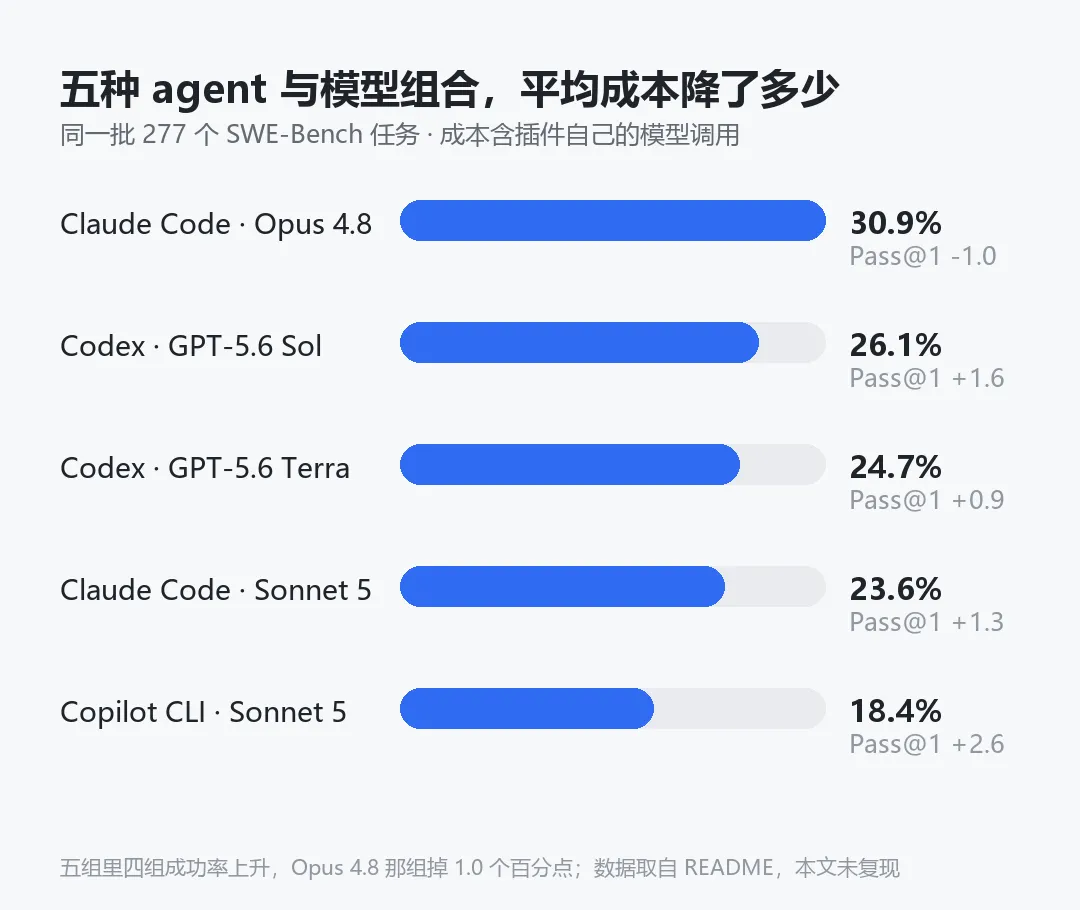
五种组合的平均降本
平均成本降低 18.4% 到 30.9%,六个仓库乘五种组合共 30 个格子全部比默认更便宜,五组里有四组的 Pass@1 是上升的。在单个仓库与组合内部,降幅区间是 5% 到 40%。
值得注意的是 Opus 4.8 那一组:成本降了 30.9%,是五组里最多的,但 Pass@1 掉了 1.0 个百分点。作者把这个负数照实写在了摘要里,没有藏起来。省钱和成功率不是同一件事,这一点它没有含糊。
另外两组外部验证:Web-Bench 上降 16% 到 21%;两个安全审计基准上降 6% 到 20%,而那两个基准的每个任务都在一个全新仓库里,也就是说没有历史可学的时候仍然有收益。
03 · PART
三个机制怎么起作用
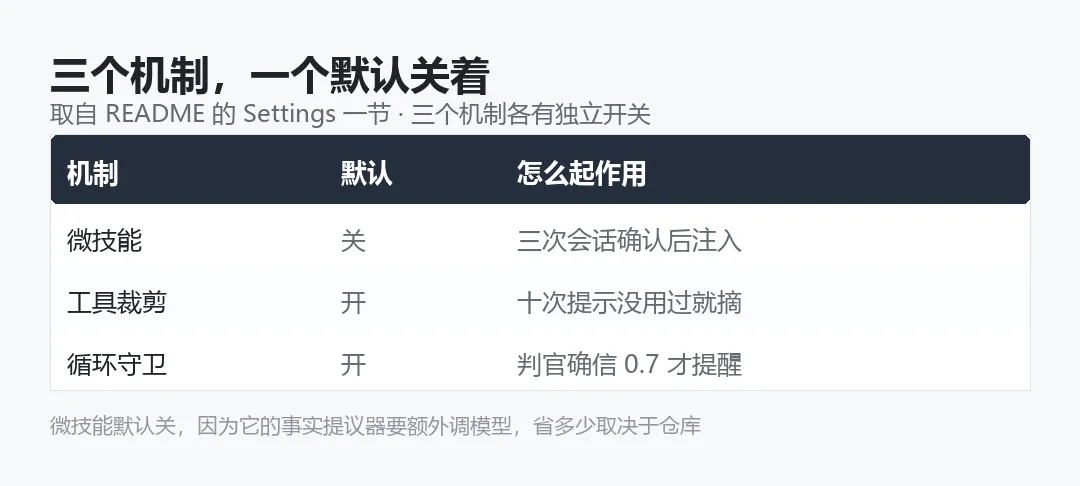
三个机制与默认开关
微技能负责记住仓库的事实。比如这里 pytest 命令不存在、要用 python -m pytest;比如某个命令需要先设一个环境变量。事实有两个来源:跨会话反复出现的同类失败(不需要调模型),以及每三次会话让模型读一遍近期会话摘要来提议。一条事实要被三个会话确认才会生效,被后续会话推翻就退休;命令拼写类的事实连续两次被推翻即退休。
工具裁剪负责摘掉从没用的工具。每个已加载工具的定义都会随每次请求发出去。一个工具在十次提示里没被用过、且横跨至少两个会话,或者连续五个会话都没用,就会通过 agent 自己的设置被排除在下一次会话之外。一条命令可以还回来。
循环守卫负责在卡住时提醒。它先要求这个仓库有五个正常结束的轮次作为基线,之后某一轮反复撞同一个失败,才交给判官模型判断;判官确信度到 0.7 以上才附一条改道提示,每轮最多一条。还卡着就告诉你怎么停,它自己从不停止任何一轮。
微技能默认是关的,因为它的事实提议器要额外调模型;工具裁剪和循环守卫默认开。
04 · PART
怎么装怎么用
需要 Python 3.10 或更新,以及一个已登录的 agent。插件不需要自己的 API key,也不接触任何凭据,所以任何套餐或登录方式都行。学到的东西留在本机 ~/.tokeneconomizer 目录里。
Claude Code:
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add"$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
Pi 更短:
pi install git:github.com/microsoft/TokenEconomizer
装完在仓库里正常干活,然后看它学到了什么:
/tokeneconomizer:status
/tokeneconomizer:toolprune
/tokeneconomizer:microskills
想把微技能打开:
/tokeneconomizer:config set microskills=on
只想学不调模型,用 microskills=envfacts;只想让它提议摘哪些工具、自己决定要不要动手,用 toolprune=propose,然后手动 toolprune apply。
Claude Code、Codex、Copilot CLI、opencode 是从克隆目录直接运行的,所以那个目录不能删。
05 · PART
工具裁剪在不同 agent 上不一样
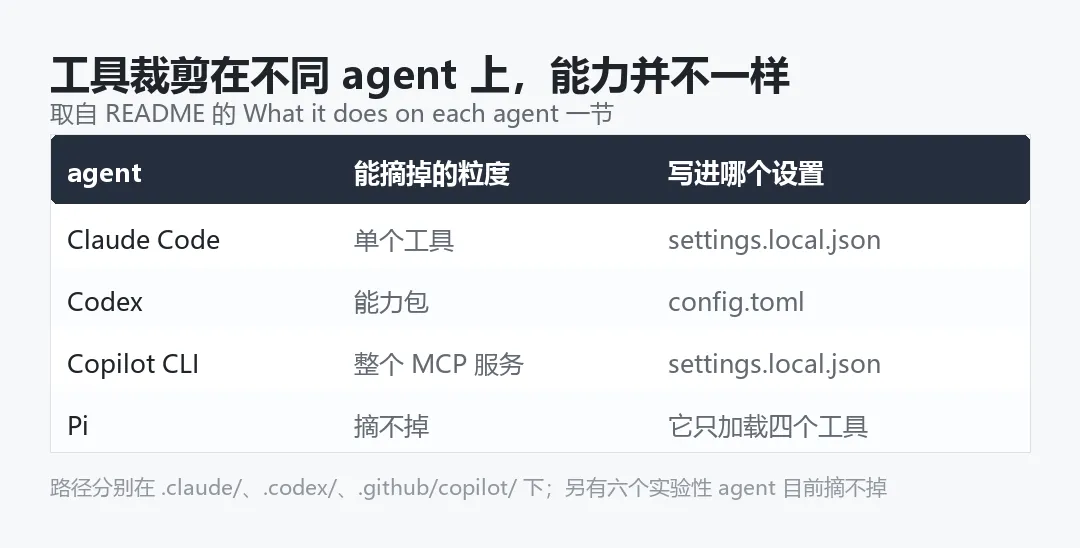
各 agent 的裁剪粒度
这张表是本期最该看的一页。同一个功能在不同 agent 上能做到的粒度差别很大:Claude Code 能摘单个工具,Codex 只能摘整个能力包,Copilot CLI 只能摘整个 MCP 服务,Pi 压根摘不掉,因为它本来只加载四个工具。
所以「装了就能省」是不成立的,省多少取决于你用的是哪个 agent、以及那个 agent 允许插件改什么。opencode、Hermes、Antigravity、Droid、Cursor、Grok 目前都还摘不掉工具。
06 · PART
一个容易忽略的坑:提示缓存
工具裁剪不是立刻生效的。它要等你在这个仓库的会话空闲六十分钟之后才写入排除名单。
原因写在文档里:一个被恢复的会话,如果工具集变了,就必须把整段历史重新写进提示缓存,而不是直接读缓存——那笔钱可能比省下来的还多。而空闲一小时之后缓存本来也过期了,这时候改才不亏。
这条设计很能说明这个项目的取向:它宁可晚一点生效,也不愿意为了省小钱把大钱花掉。如果你急着看效果,把 toolprune_quiet_minutes 设成 0 可以立刻写入,但代价你自己承担。
还有一个更细的坑:如果你同时装了压缩 shell 输出的 rtk,在 rtk 0.45.0 上,pytest 缺失时 rtk pytest 什么都不打印、只返回退出码 1。agent 看不到错误,插件也就学不到「这里要用另一种写法」这条事实。写成 .venv/bin/python -m pytest 这种带解释器的命令不会被改写,所以事实推荐的写法仍然有效。
07 · PART
作者自己承认的短处
第一,效果取决于仓库状态和你跑的任务,文档原话就是这么写的。它不是装上就固定省三成的开关。
第二,每个 agent 各学各的。Claude Code 在某个仓库学到的东西,Codex 在同一个仓库里用不上,设置共享但经验不共享。
第三,实验性支持覆盖面很窄。Cursor 只有 macOS 和 Linux,因为 Windows 上 Cursor 用 PowerShell 跑钩子而插件启动器是 POSIX 脚本;而且 Cursor 的会话成本报不出来,原因是它的记录格式不是公开接口。opencode 只在 1.19.5 和 2.2.0 上测过,Hermes 只在 0.22.5 上测过。
第四,Copilot 的 BYOK 用户拿不到插件自己的模型调用,错误日志里会出现 sidecall copilot: no reply,此时微技能只保留不需要模型的事实,循环守卫只在兜底阈值上动作。
第五,它从不停止任何一轮。卡住了它只提醒,停不停是你的决定。想要自动止损的人会觉得不够。
08 · PART
一处口径不一致:许可证
README 顶部的徽章写的是 Apache 2.0,但仓库根目录的 LICENSE 文件是 MIT,README 末尾的许可段也写着 MIT LICENSE,GitHub API 识别结果同样是 MIT。而今天最新一次提交的说明正是「Update license information in README」。
也就是说徽章还没跟上。以 LICENSE 文件为准,是 MIT。这类不一致本身不严重,但如果你要拿它做合规判断,别只看徽章。
09 · PART
前景与风险
它最有意思的地方不是省了多少钱,而是把「成本」这件事从模型层挪到了工程层。不换模型、不改 agent、不训练任何东西,只靠读日志和改设置,就能在三十个格子里全部降本。这条路对任何按 token 付费的场景都成立。
风险有两层。一是它要读你的会话记录,虽然全部留在本机,但记录里有你的代码路径和命令,介意的话先看清楚它读什么。二是它改的是 agent 自己的设置文件,虽然每条动作都可逆、失败时会话照常继续,但设置文件被别的工具同时改写时仍然可能互相覆盖。
适合在固定几个仓库里长期用同一个 agent 的人。不适合每天换项目、每个仓库只跑一次的人——没有历史可学,收益就只剩安全审计基准那种 6% 到 20% 的水平。
10 · PART
数据来源与抓取时间
星标 7,369、fork 489(占 6.64%)、watcher 26、开放议题 32、建仓 35 天、最近提交距今 1 天、最新版本 v0.1.0(2026-10-26)、许可证 MIT,取自 api.github.com,抓取于 2026-11-17。开放议题占星标 0.43%,三项刷星指标全部在阈值内。
降本与 Pass@1 数字、277 个任务与六个仓库、5% 到 40% 区间、Web-Bench 与安全审计基准结果、三个机制的默认阈值、安装命令、各 agent 裁剪粒度、提示缓存与 rtk 的坑、实验性支持的限制,取自仓库 README.md 与 plugin/README.md。论文编号 arXiv 2610.22732。
本文未运行该插件,也未复现论文实验,所有性能数字均为仓库文档的原始记录。
这里是「知识有道」,每天挑一个 GitHub 上真正在长的项目,把文档里的硬数字和坑一起摆出来,不替项目吹。