ARTICLE · 1373811
视频为什么可以一边下载一边播放?图解缓冲区、分片与自适应码率
视频为什么可以一边下载一边播放?图解缓冲区、分片与自适应码率
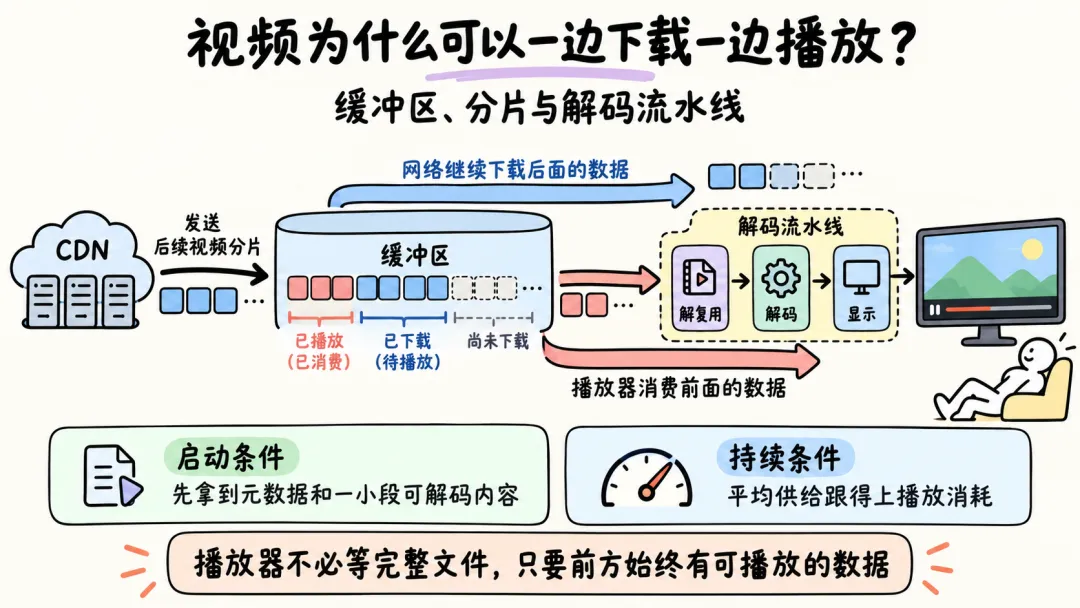
点开一部两小时的电影,明明文件还没有下载完,画面却能在几秒后开始播放。
更奇怪的是:网速偶尔抖一下,视频不一定会卡;把进度条拖到很远的位置,播放器又可能只转一会儿就继续播放。
这并不是播放器绕过了下载,而是它把一件大事拆成了几条同时运行的流水线:「网络继续获取后面的媒体数据,播放器则消费已经到达的数据。」
只要前方有一小段可以连续解码的内容,播放就不必等整个文件到齐。
下载和播放,其实是两根同时移动的指针
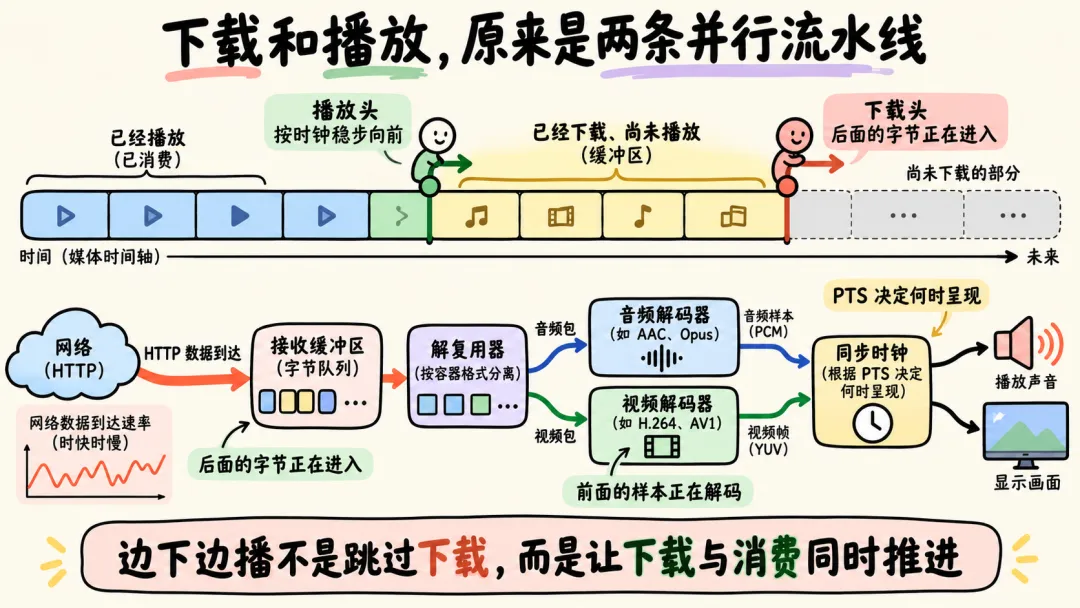
把一段视频想成一条很长的轨道。
轨道前方有一个“下载指针”,负责不断把网络上的数据搬到本地;后方有一个“播放指针”,负责把已经到达的数据送进播放器。
两根指针之间的区域,就是「缓冲区」。
播放器内部还会把这些数据继续向下传递:
解封装器从容器里拆出音频流、视频流和时间戳; 视频解码器把压缩数据还原成画面; 音频解码器把压缩数据还原成声音; 播放时钟依据时间戳同步音画,再把结果送到屏幕和扬声器。
因此,“边下边播”并不是同一批字节一边下载一边显示。真正发生的是:
「后面的数据还在路上,前面的数据已经进入了解封装、解码和渲染流程。」
只要下载指针长期领先于播放指针,画面就能持续前进。
❝欢迎大家支持我的付费文章:
❞
14.9 元,【3万字长文 70图】一文详解《数据结构(严蔚敏)》 11.9 元,【3万字长文 90+图】一文详解《操作系统教程(骆斌)》 11.9 元,【万字长文】一文详解《计算机组成原理(唐朔飞)》 9.9元,【万字长文58张图】一文详解《计算机网络(谢希仁)》 合集优惠,仅需36.9元
播放开始前,播放器必须先看懂这份视频
拿到一段媒体数据,并不代表播放器立刻知道该怎么播。
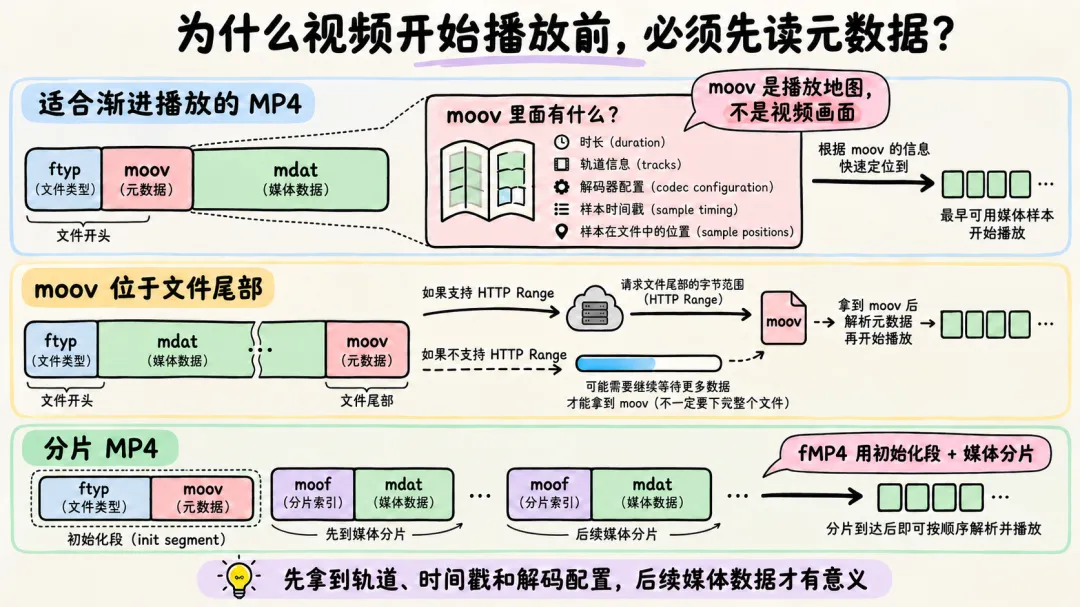
以常见的 MP4 为例,文件中通常既有真正的音视频数据,也有描述这些数据如何组织的元数据。播放器需要从中知道:
文件里有哪些音轨和视频轨; 使用了什么编码格式; 每个样本对应什么时间; 样本位于文件的什么位置; 哪些样本可以作为随机访问入口。
这些关键信息通常位于 MP4 的「moov」结构中,媒体数据则主要放在「mdat」中。
如果 moov 位于文件开头,播放器很早就能建立索引,然后一边读取后面的 mdat,一边播放。这类布局常被称为「Fast Start」。
如果 moov 放在文件末尾,播放器也不一定非要下载完整个文件。服务器支持 HTTP Range 时,它可以先请求文件尾部,取得 moov,再回头请求需要的媒体区间;如果服务器不支持范围请求,等待时间就可能明显增加。
分片 MP4 又是另一种组织方式:初始化片段先提供轨道和解码配置,后续的 moof 与 mdat 片段分别携带一段段时间范围内的媒体数据。播放器不需要提前拿到整个文件的全局结构,也能逐段解析。
所以,开始播放的前提不是“文件完整”,而是:
「描述信息已经足够,起播位置附近的数据已经到达,并且能形成一条连续可解码的媒体链路。」
单文件渐进下载,与 HLS、DASH 分片有什么不同
在线视频常见的传输方式,大致可以分成两类。
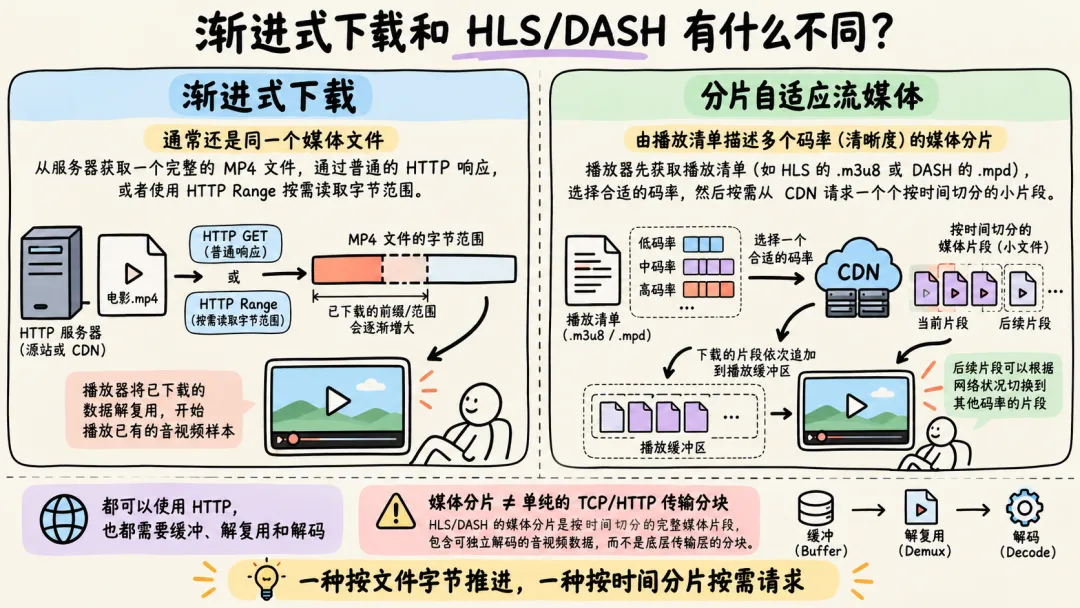
一种是「渐进式下载」。服务器提供一个完整的 MP4 文件,播放器从文件开头向后读取,或者通过 HTTP Range 只请求某个字节区间。已经下载到本地的前半段可以先播放,后半段继续传输。
另一种是「HLS 或 DASH 分片播放」。服务端先把视频切成许多按时间排列的媒体片段,并提供一份清单:
HLS 常见的是 m3u8 播放列表; DASH 常见的是 MPD 描述文件; 清单会告诉播放器有哪些清晰度、片段地址和时间关系。
播放器先读取清单,再按需请求接下来要播放的片段。长视频因此不再是一个必须从头搬到尾的大文件,而是一串可以独立调度的小任务。
两者都可以通过 HTTP 传输,也都可能使用范围请求。区别主要不在“是不是互联网下载”,而在于媒体内容怎样组织,以及播放器能以多细的粒度选择和调度数据。
还要注意:这里说的「媒体分片」是封装层按播放时间组织的内容,不等同于 TCP、QUIC 在网络上传输时拆出的数据块。网络包到了,媒体片段也未必完整;播放器通常要等到足够的数据可以解析后,才会交给后面的解码流程。
缓冲区为什么能把抖动的网速变成连续画面
视频播放有一个很特别的约束:消费速度由时间决定。
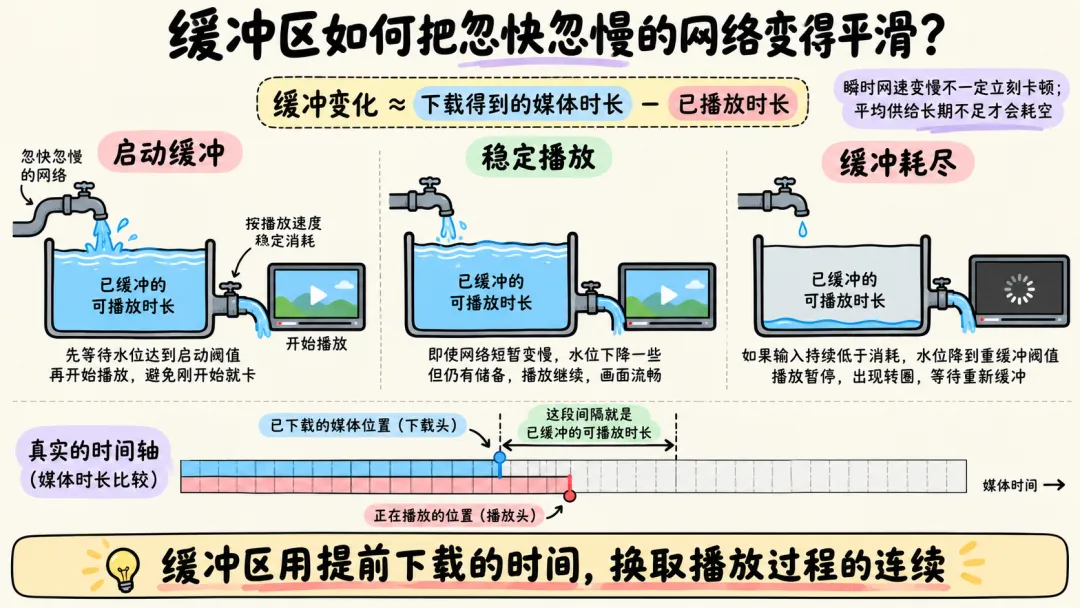
一段正常速度的视频,每经过一秒,就要消耗大约一秒的可播放内容。网络下载却不是匀速的:有时很快,有时拥塞,有时短暂停顿。
缓冲区就像放在两者之间的蓄水池:
刚打开视频时,播放器先积累一小段内容,达到起播门槛后再开始; 网速高于当前码率时,多下载到的内容会增加缓冲时长; 网速短暂降低时,播放器继续消耗先前积累的内容; 如果长期补充不足,缓冲水位降到安全线以下,就会暂停播放并重新积累数据。
可以把水位变化近似理解为:
「缓冲变化 ≈ 下载得到的媒体时长 − 已经播放的媒体时长」
这里比较的不是简单的字节数,而是这些字节代表多少秒可播放内容。相同大小的数据,在不同码率下对应的播放时长并不相同。
这也解释了为什么网络明明抖过一次,画面却没有卡:只要缓冲区提前存下的内容足以覆盖这次抖动,播放端就感受不到它。
但缓冲也不是越大越好。积累得越多,起播可能越慢;直播场景中,缓冲越深,观众看到的内容通常也离现场越远。播放器必须在流畅、起播速度和延迟之间做取舍。
网速变慢时,为什么画质会自动下降
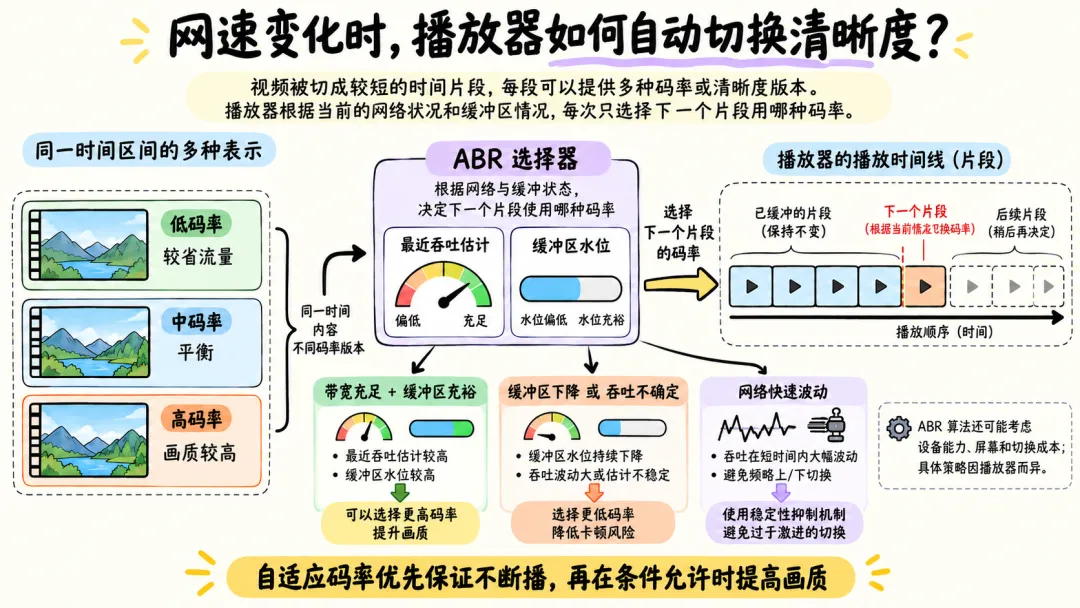
同一段视频,平台通常会提前编码出多套版本:画面内容和时间轴相同,但分辨率、码率或编码参数不同。
播放器每下载完一段内容,都可以重新判断接下来应该请求哪个版本,这就是「ABR,自适应码率」。
判断依据通常包括:
最近几次请求测得的网络吞吐; 当前缓冲区还剩多少可播放时长; 设备性能、屏幕大小和解码能力; 清晰度频繁切换带来的观看体验损失。
当吞吐下降、缓冲水位又偏低时,播放器会倾向于请求码率更低的后续片段。单个片段更小,更容易在播放指针追上之前下载完成。
当网络恢复、缓冲逐渐充裕时,它才会谨慎切回更高码率。
切换通常发生在媒体片段边界附近,已经缓存的片段不会因为一次决策全部重下。只要不同版本的时间轴和切换点对齐,播放器就能把它们接成一条连续的播放序列。
不同平台的算法并不完全相同。有的更相信带宽估计,有的更重视缓冲水位,也有的综合预测未来网络状况。但目标是一致的:
「宁可在必要时降低后续片段的质量,也尽量不要让缓冲区彻底见底。」
视频还没下完,拖动进度条为什么也能播放
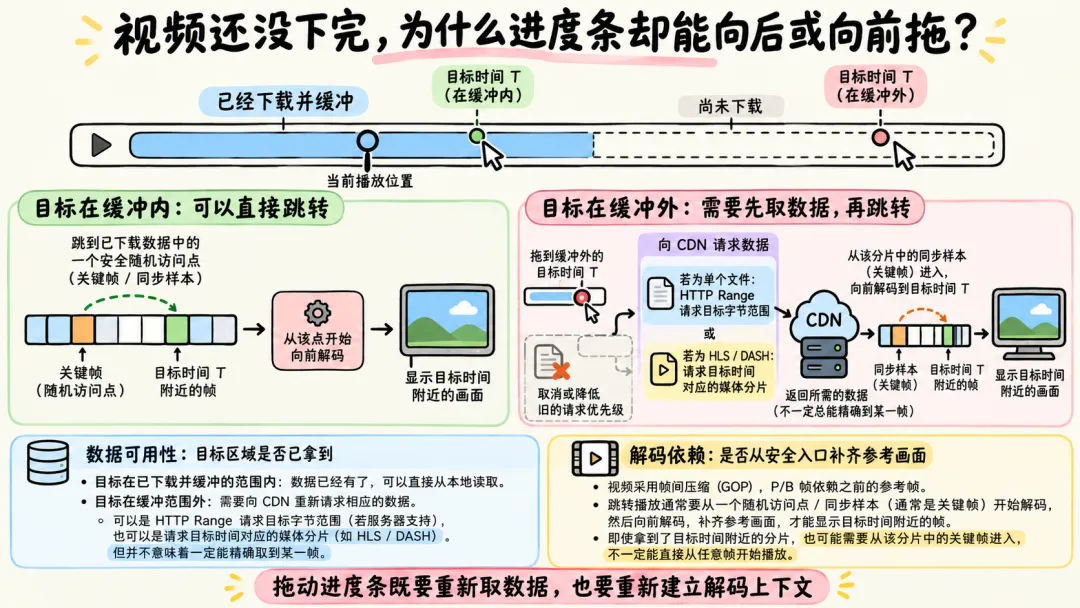
拖动进度条,本质上是在发起一次「Seek」。
如果目标位置已经位于缓冲区中,播放器可以直接从本地缓存寻找合适的随机访问点,重置解码状态,再向前解码到目标时间附近。
如果目标位置尚未下载,播放器会丢开当前的顺序读取计划,转而获取目标附近的数据:
对单文件视频,可以发起新的 HTTP Range 请求; 对 HLS 或 DASH,可以从清单里找到覆盖目标时间的媒体片段并请求它; 拿到数据后,还要寻找关键帧或其他随机访问样本作为解码入口。
这里有两个彼此独立的问题。
一个是「数据是否到达」:目标附近的字节或片段有没有下载下来。
另一个是「能否从那里开始解码」:许多视频帧依赖前面的参考帧,播放器往往不能从任意帧直接还原画面,而要从更早的关键帧开始,向前解码到目标位置。
所以,网络很快也不代表拖到哪里都能瞬间出画面;关键帧间隔较长、片段较大或者目标服务器响应较慢,都会增加等待时间。
边下边播解决的是“数据可以按需抵达”,关键帧和 GOP 解决的是“解码器可以从哪里重新进入”。两者配合,才让未下载完成的视频也能跳播。
直播也是边下边播,只是数据正在现场产生
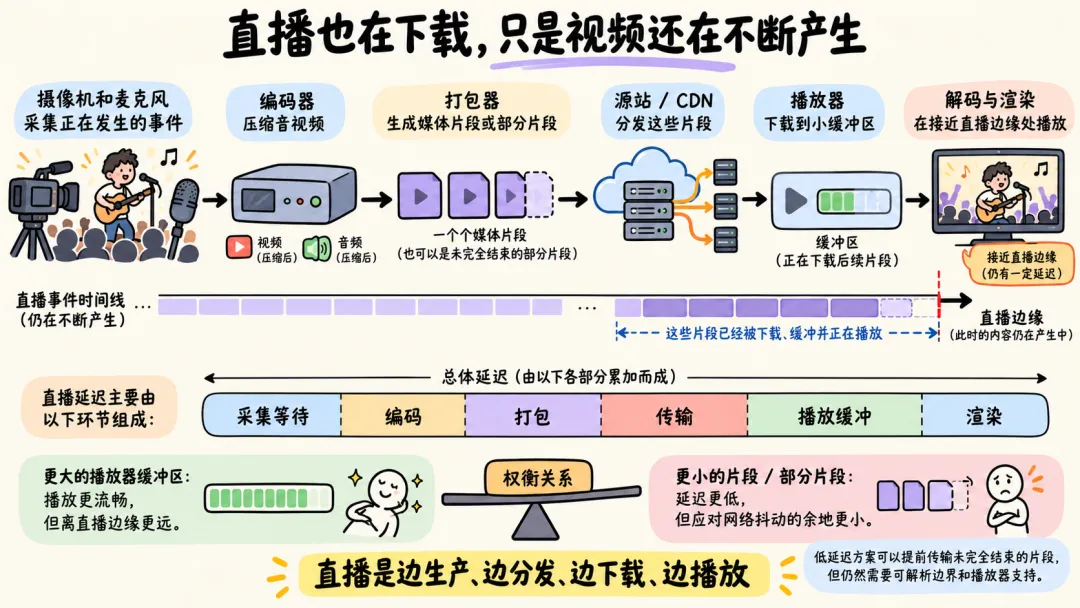
点播视频的全部内容早已存在,播放器只是按需获取;直播则不同,未来的画面还没有发生。
直播链路通常要经历:采集声音和画面、编码压缩、封装成片段、上传到源站、经过 CDN 分发、进入播放器缓冲、解码并渲染。
观众看到的画面总会比现场晚一点,因为这些环节都需要时间。总体延迟大致来自:
编码器积累和压缩画面的时间; 封装器生成片段或部分片段的时间; 网络传输与 CDN 转发时间; 播放器缓冲、解码和渲染时间。
为了降低直播延迟,系统可以缩短片段,甚至让尚未完整生成的片段以更小的部分持续发送。播放器不必等一个大片段彻底封装完成,便能更早收到前半部分。
代价是留给网络抖动的余量更小。缓冲很浅时,一次短暂拥塞就可能追上播放指针;缓冲很深时更稳定,却会离直播现场更远。
因此,低延迟直播不是取消下载和缓冲,而是让生产、传输、解析、解码几条流水线贴得更紧,并把每一段等待压缩得更短。
总结
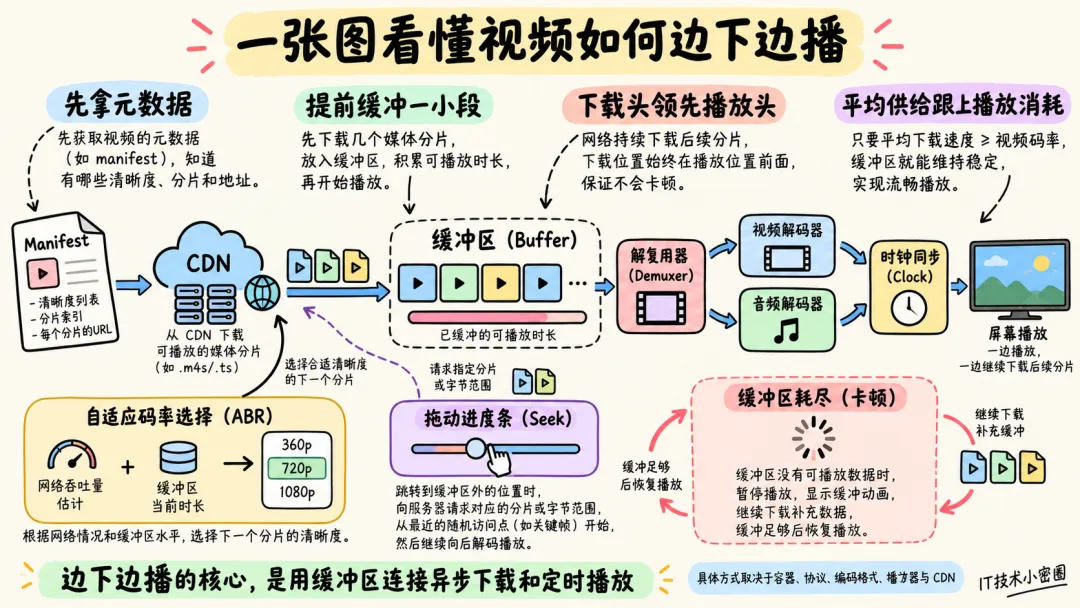
「容器元数据」让播放器在文件未完整到达时,也能知道媒体怎样组织; 「渐进式读取或媒体分片」让播放器只获取当前和接下来需要的内容; 「缓冲区」把不稳定的网络供应,转换成相对稳定的播放消费; 「解封装、解码和播放时钟」在下载继续进行时,处理已经到达的数据; 「自适应码率」根据吞吐与缓冲状态调整后续片段质量; 「范围请求、媒体清单和随机访问点」让播放器能够跳到尚未下载的位置; 「更短的片段与更紧密的流水线」让直播在保持可播放的同时降低延迟。
❝觉得这篇文章对你有帮助吗?
点个 「在看」,「关注」 我们,加个 「星标」,我们一起用最有趣的方式,读懂最硬核的技术!
你的 「支持」 对我非常重要,是我坚持更新的 「唯一动力」。
关注我们,回复 C++ 免费获取 243 节高质量C++课程。
❞