ARTICLE · 1376217
长PDF扔给DeepSeek最怕它瞎编数据,加这3句一眼验真伪
手头临时塞过来一份五六十页的公开行业白皮书、招投标公开说明或者冗长的产品更新手册,要在半小时内抓出核心数据写进汇报里——把 PDF 直接拖进 DeepSeek 、腾讯元宝或豆包,几乎是现在所有人最顺手的做法。
但凡真拿它干过几次正事的人,心里其实都有同一个阴影:它答得太自信了,自信到有时候把第 8 页的“A 品类预算”和第 23 页的“B 品类增速”嫁接成一句话,你一眼看过去根本察觉不到破绽。等原样搬上汇报桌被熟悉业务的人当场问住,那可比写得慢难受多了。
想既借上工具十倍速读长文的省力劲儿,又不掉进“一本正经胡说八道”的坑里,秘诀其实特别简单:永远别让它交“裸结论”,强迫它交“带页码的证据链”。
为什么模型读长文档也会张冠李戴?
很多人以为只有不传附件瞎聊时模型才会编数据,传了 PDF 就万无一失。其实几十页的长文档丢进去之后,系统在后台往往是切成很多小段落去检索匹配的。
一旦文档里有好几张结构相似的年度对比表,或者正文写的是“预计口径”、附录写的是“实际结算口径”,你只要笼统地问一句“帮我提炼核心数据”,它就很容易把两处相近的句子揉成一条看似通顺的新结论。
只要在提问时加上下面这三条硬杠杠,就能把这种隐患死死按住。
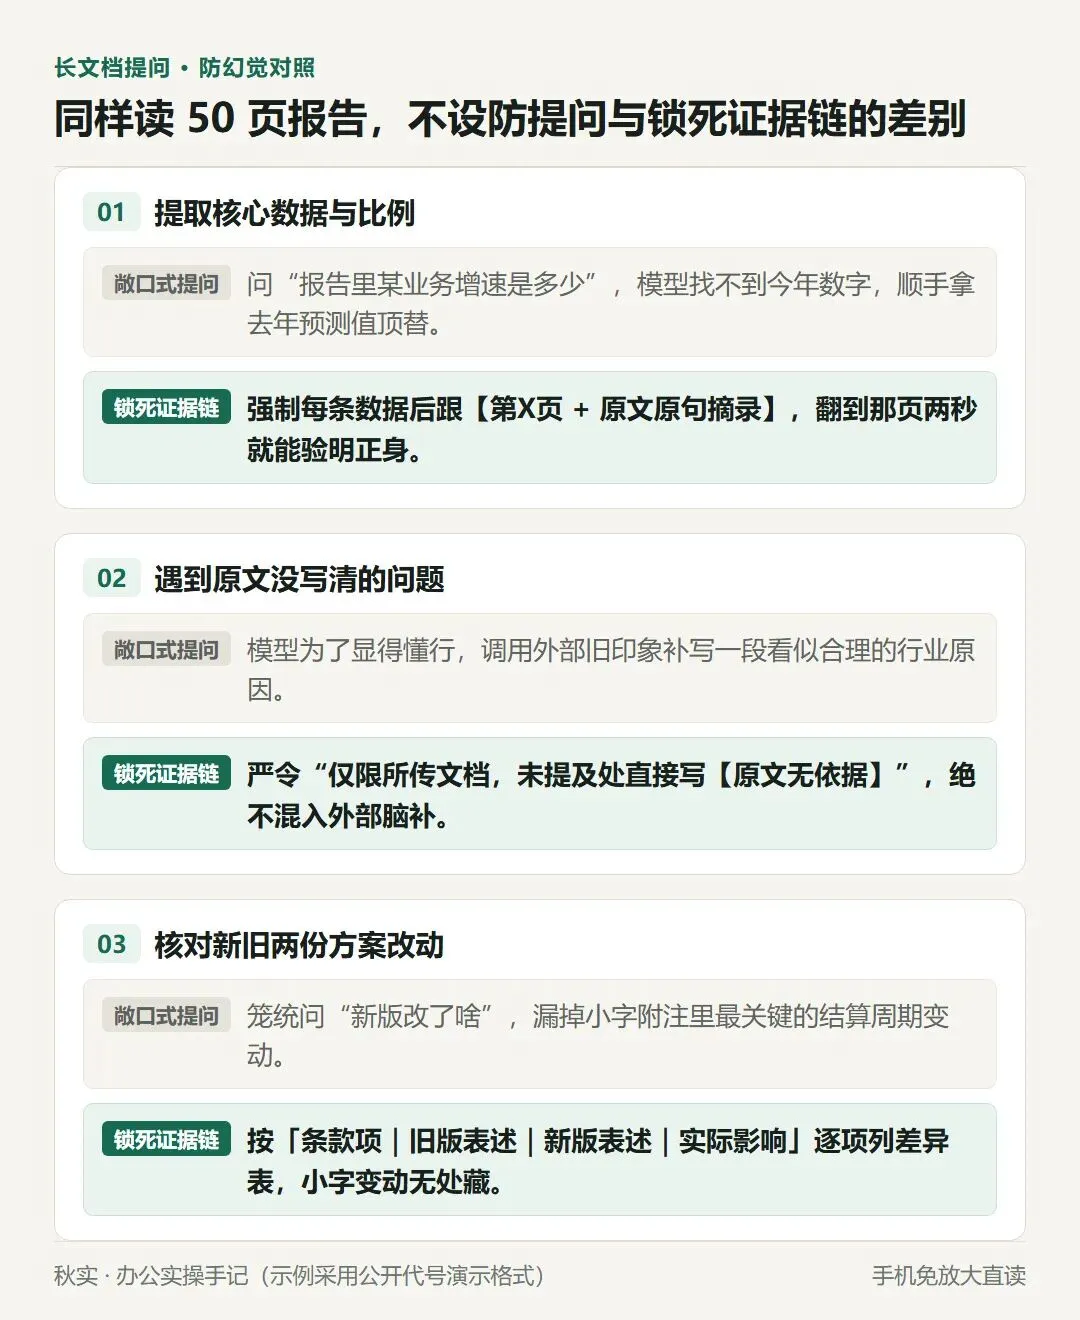
第一句:取数必带【页码 + 原句摘录】
上传完公开报告或说明文件后,不要问“这份报告讲了什么”,直接指定你要找的维度,并锁死出处格式:
【指令 01 :带页码原句提取核心数据】 请严格依据我上传的这份文档,提取与【填写你关注的业务主题】相关的所有关键数据、时间节点和明确结论。 格式硬性要求:每一条结论后面,必须紧跟标注【所在页码或章节名|文档原文原句逐字摘录】。不要对原文数字做任何换算或合并。
这一招最妙的地方在于把一小时的通读变成了十秒钟的抽查。看到哪条数字打算写进正式 PPT ,顺着它标出来的页码翻过去扫一眼原表,真假立判;要是哪一条它支支吾吾给不出原句摘录,那多半就是它自己揉出来的,直接划掉不用。
第二句:封死外部知识库——没写就标【原文未提及】
大模型特别怕显得自己“答不上来”。当文档里恰好没写某项细分指标时,它经常会悄悄调用训练时见过的旧网页印象,替你补上一段听着挺像那么回事的分析。
所以在同一个窗口追问具体问题时,一定要把这句“禁令”加上:
【指令 02 :禁止外部脑补与推算】 回答下面这个问题时,信息来源仅限刚才上传的这份文档,禁止使用文档以外的背景知识进行推测或估算。如果文档中没有明确写出答案,请直接回答【本文档未提及该信息】,不要试图替我补全。
第三句:核对新旧两版公开规则——拉四列差异表
平时遇到公开政策指南更新、平台规则修订或者公开招标文件发了补充更正版,人工拿眼睛左右对照几十页最容易漏看小字。这时候把新旧两段公开文本贴进去,用四列法找茬最稳:
【指令 03 :新旧版本实质改动核对表】 上面是旧版文本,下面是新版文本。请帮我逐段比对两者的实质性差异,忽略单纯的标点或语序微调,重点抓出「数字、时间、条件门槛、责任方」的变化,按【章节位置|旧版原话|新版原话|变化点说明】列成四列表格。
我把这三条读长文档最常用的防错口令做成了下面这张速查卡,平时看长报告前顺手翻出来套用就行:
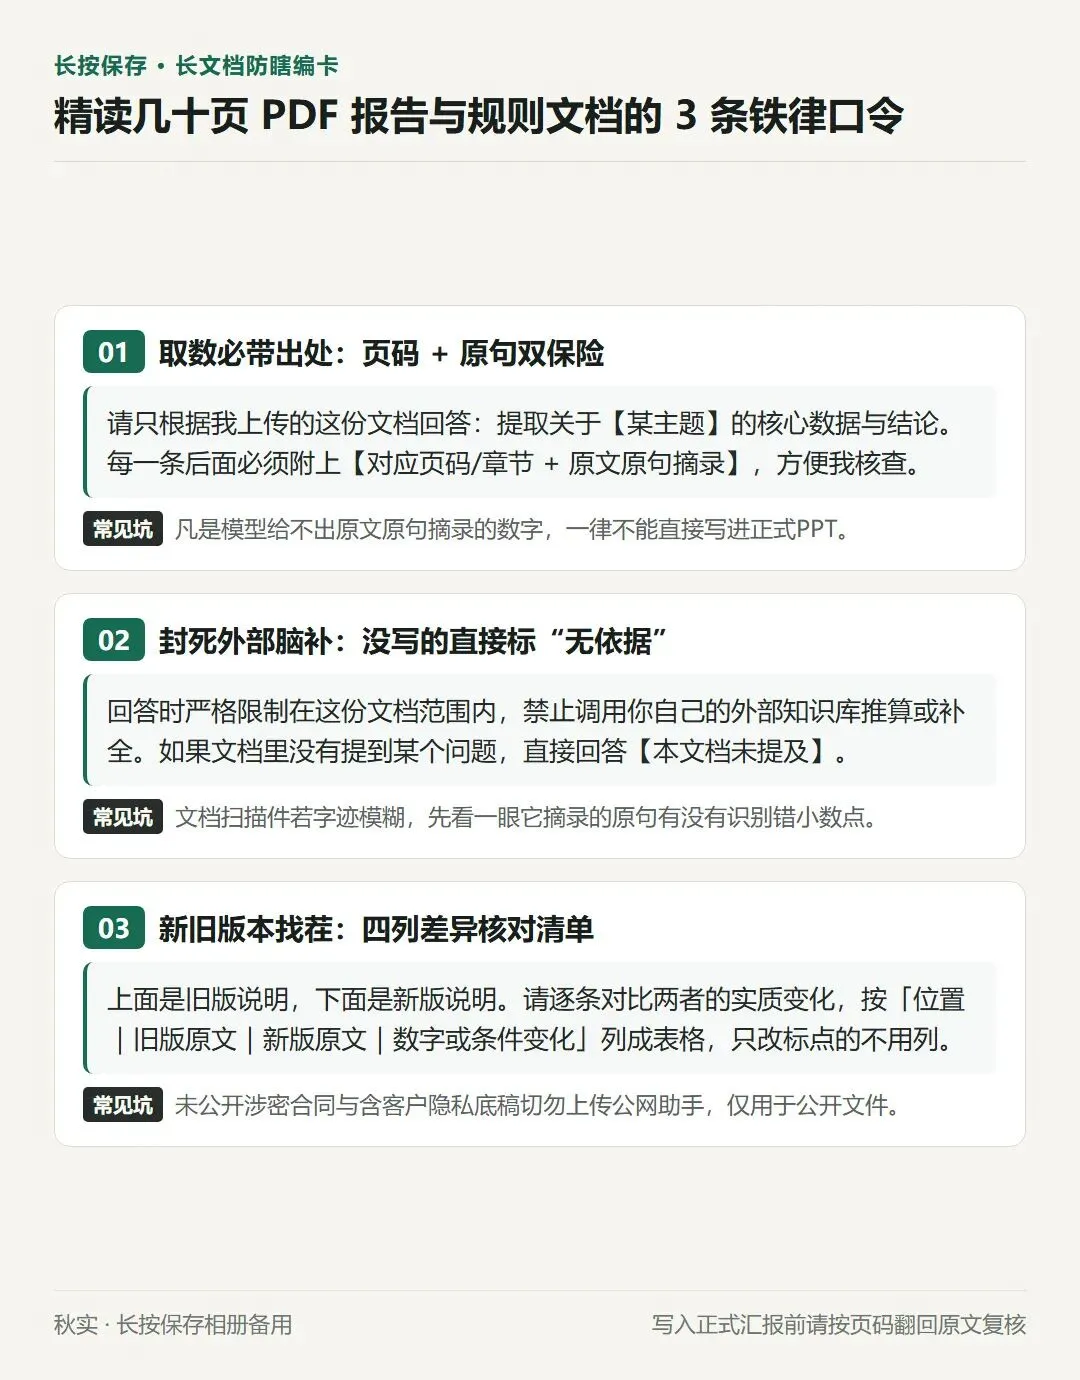
| 公开行业研报 / 白皮书 | |||
| 公开通知 / 平台规则修订 | |||
| 模糊扫描版 PDF 图片 | 3 认成 8、把小数点漏掉,必对原图 | ||
| 未公开商业合同 / 内部底稿 | 严禁直接上传外部网页 |
把上面表格最后一行当成习惯记住:公开长报告放心拿工具帮你做“带页码索引的目录员”,涉密内部底稿守住不外传红线,准备写进正式汇报的数字永远按页码翻回原表看一眼。守住这三条,工具就只会帮你省时间,不会替你埋雷。