ARTICLE · 1380821
pdf-inspector:开源工具让 AI 读 PDF 快了 50 倍:一键 Markdown 根本不用 OCR !
你把一份 PDF 丢给 ChatGPT、Claude 或其他 AI,让它帮你总结。有时候 AI 秒回,答得头头是道。有时候它却读出一堆乱码,表格全散了,标题和正文混成一团,甚至告诉你"文档内容为空"。
这是因为PDF 其实有两种完全不同的"长相":
- 文字型 PDF:从 Word 导出的论文、财报、合同、发票。文字是"真文字",可以复制粘贴。
- 扫描型 PDF:用手机或扫描仪拍出来的文件。它本质上是一张照片
一直以来,很多系统处理 PDF 的方式很粗暴:不管三七二十一,全部丢给 OCR(文字识别)服务。
这就像寄快递,不管是一张明信片还是一台冰箱,都叫货拉拉来拉。结果是:
贵:OCR 服务按页收费 - 慢:一份文档要 2~10 秒
- 浪费:很多 PDF 本来就是文字,根本不需要"认字"
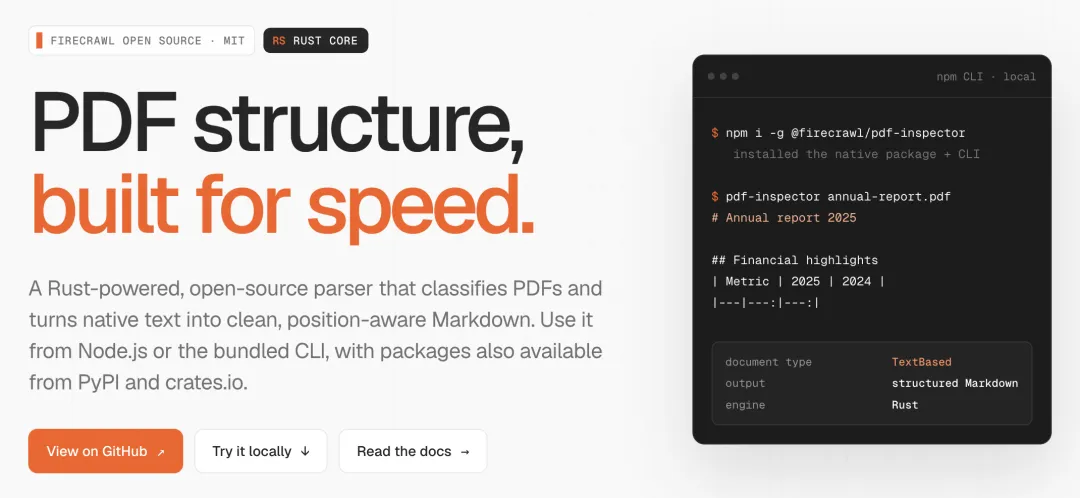
开源项目pdf-inspector
pdf-inspector是 Firecrawl 团队开源的一个工具。Firecrawl 是专门帮 AI 抓取网页和文档内容的公司,每天要处理海量 PDF。
它就像 PDF 世界的"安检员 + 翻译官":
- 先给 PDF 做个体检
:几十毫秒内判断这份 PDF 是文字型、扫描型、纯图片型,还是混合型。 - 能直接读的,本地秒读
:文字型 PDF 不需要 OCR,直接提取文字,并格式,也就是 AI 最爱的格式。 - 读不了的,再交给 OCR
:只有真的是"照片"的页面,才送去识别。
官方给出的数据是:大约 54% 的 PDF 根本不需要 OCR,本地不到 200 毫秒就能处理完。
换句话说,这个工具帮你把一半的 OCR 账单省下来了。
它有多快?看跑分
官方在 200 份真实 PDF 的公开测试集(opendataloader-bench)上做了对比,只比较不使用 AI 模型的本地解析工具:
工具 | 综合得分 | 表格还原 | 处理 200 份耗时 |
pdf-inspector | 0.875 | 0.814 | 0.47 秒 |
liteparse | 0.873 | 0.693 | 0.75 秒 |
opendataloader | 0.831 | 0.489 | 2.57 秒 |
pymupdf4llm | 0.735 | 0.401 | 17.1 秒 |
markitdown | 0.589 | 0.273 | 16.2 秒 |
200 份 PDF,不到半秒。同样的活,有的工具要跑 17 秒。表格还原能力也是这组里最高的。
核心能力一览
- 智能分类
:10~50ms 内判断 TextBased / Scanned / ImageBased / Mixed,附带 0~1 的置信度,并能指出具体哪几页需要 OCR - 位置感知的文字提取
:带字体信息、XY 坐标,自动识别多栏排版的阅读顺序,支持 RTL(从右到左)文字 - Markdown 转换
:标题(H1–H4)、列表、代码块、表格、粗斜体、链接、页码过滤,一应俱全 - 表格检测双模式
:基于 PDF 绘图指令里的矩形线框,加上基于文字对齐的启发式检测 - CID 字体支持
:解析 ToUnicode CMap,处理 Type0/Identity-H 等中日韩常见的字体编码 - 编码异常检测
:发现字体编码损坏时,主动提示调用方回退到 OCR - 选择性 OCR
:只渲染需要识别的页面,本地运行 PP-OCRv6 Small - 多语言绑定
:Rust、Python、Node.js、浏览器 WASM、命令行
快速上手Python
pip install pdf-inspector
import pdf_inspector
result = pdf_inspector.process_pdf("document.pdf")
print(result.pdf_type)   # "text_based", "scanned", "image_based", "mixed"
print(result.markdown)   # Markdown 字符串,或 None
# 选择性 OCR:干净的文字型 PDF 不会加载 OCR 运行时
ocr = pdf_inspector.process_pdf_with_ocr("document.pdf")
print(ocr.pages_routed_to_ocr)
Node.js
npm install @firecrawl/pdf-inspector
import { readFileSync } from 'fs';
import { processPdf, processPdfWithOcr } from '@firecrawl/pdf-inspector';
const pdf = readFileSync('document.pdf');
const result = processPdf(pdf);
console.log(result.pdfType);   // "TextBased", "Scanned", ...
console.log(result.markdown);
const ocr = await processPdfWithOcr(pdf); // 选择性 OCR,不阻塞事件循环
浏览器(WebAssembly)
import init, { processPdf } from '@firecrawl/pdf-inspector-wasm';
await init();
const res = await fetch('/document.pdf');
const pdf = new Uint8Array(await res.arrayBuffer());
const result = processPdf(pdf);
console.log(result.markdown);
命令行
cargo install pdf-inspector
pdf2md document.pdf                      # PDF 转 Markdown
pdf2md document.pdf --json               # JSON 输出
pdf2md document.pdf --select-pages 1,3,5-10   # 只处理指定页
pdf2md document.pdf --compact            # 省 token 模式,折叠目录点线
detect-pdf document.pdf --analyze --json # 只检测 + 版面分析
项目架构
PDF bytes
├─► detector → 判断 PDF 类型
└─► extractor
├─ fonts 字体宽度、编码
├─ content_stream 遍历 PDF 操作符 → 文字块 + 矩形
├─ xobjects 表单对象文字、图片占位
├─ links 超链接、表单字段
└─ layout 分栏检测 → 行聚合 → 阅读顺序
├─► tables 矩形检测(并查集) / 对齐检测 / 网格 / 格式化
└─► markdown 字体统计 → 预处理 → 转换 → 分类 → 后处理
一个值得学习的设计:文档只加载一次,检测和提取共用同一份解析结果,避免重复 I/O。
分类是怎么做到这么快的?
核心思路是不读全文,只看"抽样证据":
只解析 xref 表和页面树,不加载全部对象 按策略抽样页面(默认抽 8 页:首页、末页、中间均匀分布) 在内容流里找文字操作符 Tj / TJ 和图片操作符 Do 根据抽样页里有没有文字操作符来分类
道理很直观:真文字型 PDF 的页面里会有大量 Tj/TJ 指令;扫描件的页面里基本只有一个 Do,把整张图片画上去。所以 300 多页的 PDF 也能毫秒级判断。
项目还提供了四种扫描策略:
策略 | 行为 | 适合场景 |
EarlyExit | 遇到第一个非文字页就停 | 只想把纯文字 PDF 走快速通道 |
Full | 扫描所有页 | 精确区分 Mixed 和 Scanned |
Sample(n) | 抽样 n 页(默认 8) | 超大 PDF,速度优先 |
Pages(vec) | 只查指定页 | 调用方已知要查哪些页 |
Markdown 是怎么"猜"出来的?
PDF 里没有"这是标题"的标记,只有"这段文字,字号 18,坐标在这里"。所以项目用的是启发式规则:
- 标题
:统计正文字号,按字号相对正文的比例划分 H1–H4,并做 0.5pt 聚类 - 粗体/斜体
:看字体名里有没有 Bold、Italic、Oblique - 代码块
:检测等宽字体(Courier、Consolas、Menlo、JetBrains Mono 等) - 列表
:识别 •、1.、(a) 等前缀 - 上下标
:看字号和相对基线的 Y 偏移 - 跨行断词
:自动把被换行切断的单词接回去 - 目录点线
:...... 折叠成 ...
真正的杀手级用法:智能路由
这也是项目名里"inspector(检查员)"的本意:
PDF 到达
→ pdf-inspector 分类 (~20ms)
→ 是文字型且置信度高?
是 → 本地提取 (~150ms),结束
否 → 送 OCR 服务 (2–10 秒)
在大规模文档处理管线中,这个"前置分流"能同时省钱和省时间。对做 RAG、文档问答、知识库的开发者来说,只需加一层很薄的判断,成本结构就完全不同了。
如果你只想要某些页面的 OCR,也可以直接用 process_pdf_with_ocr:它只渲染需要识别的页面,并保留每页的来源和置信度,还会标出建议走云端高精度流程的页面。注意 OCR 依赖外部的 PDFium 和 ONNX Runtime,只有真正路由到 OCR 时才会加载。
AI 时代有个容易被忽视的事实:模型再聪明,喂给它的数据是垃圾,输出也是垃圾。PDF 恰恰是最常见、也最难读好的数据来源之一。
pdf-inspector 的思路很朴素:先判断,再决定怎么处理。能用便宜办法解决的,不动用昂贵办法。这个道理放在很多地方都适用。