ARTICLE · 1381489
MCP、API、插件:模型接入的三条路怎么选
这个问题看起来是协议问题,实际上是契约问题——“能调用什么”这份描述,到底存放在哪里、由谁维护、能被几个客户端复用。市面上常见的三条路:前端直接塞 tools 数组的自定义 tool calling、早期 ChatGPT 插件那套 OpenAPI manifest、以及 2024 年 11 月由 Anthropic 开源的 Model Context Protocol(MCP)。三者常被并列比较,但它们并不是同一层的东西,混着比就会得出“谁替代谁”的错误结论。
本文按课程 5-4、5-5 两节的脉络展开:先定位三者的差别到底落在哪,再拆 MCP 的协议机制,最后给一份能落地的选型判断和面试追问清单。
01定位:差别不在协议,在契约存放的位置
三种做法的终点完全一致:模型自己不执行任何东西,它输出一个结构化的调用意图,由宿主程序(harness)分发执行,再把结果回填进上下文。真正分岔的地方只有一处——那份“可调用能力清单”写在哪。
自定义 tool calling 把契约放在你的应用代码里,每次请求作为一个 tools 数组内联发给模型。好处是控制力最强:你这个请求带几个工具、描述写多细,全是显式决定。代价是复用为零,换一个客户端就得重写一遍。
插件模式(典型是早期 ChatGPT 的 ai-plugin.json 加一份 OpenAPI 文档)把契约托管在某个 URL 上,客户端在安装时把 manifest 和 spec 一次性摄进来。它的出发点是“让第三方服务能被一个固定客户端接进来”,本质是单向的、安装期的。
MCP 把契约放进一个 server 进程,客户端在运行期通过 tools/list 现拉。这一步差异带来的连锁反应最大:新增一个工具只需要改 server,所有连上来的客户端立刻可见,不需要发版、不需要改客户端代码。
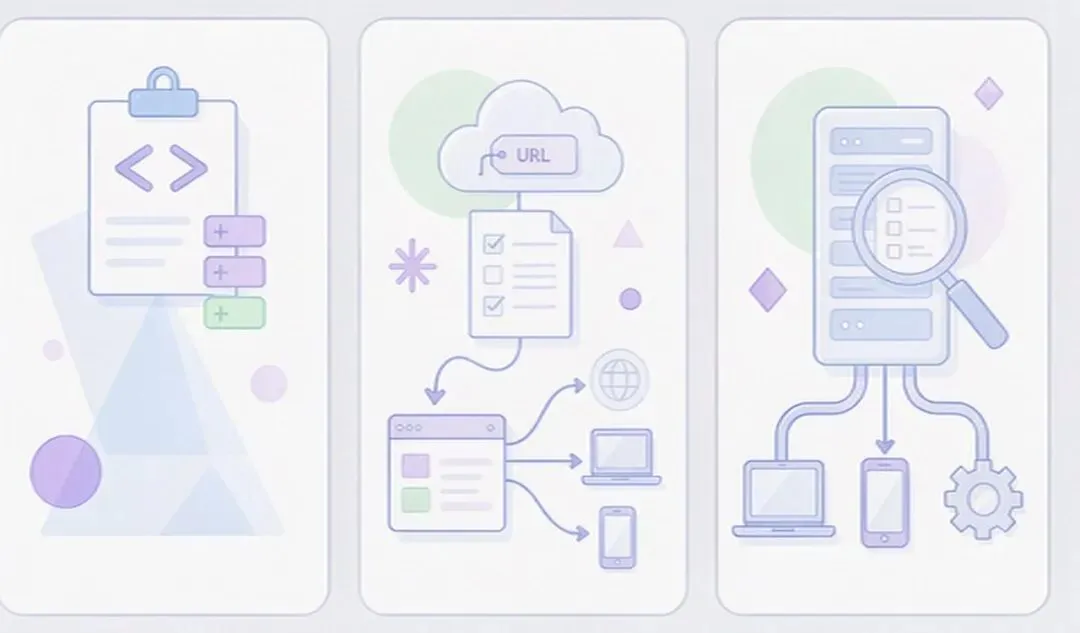
三种接法的核心差异:契约分别写在应用代码里、托管的 manifest 里、还是 server 的运行期清单里
用一句话概括这三种关系:自定义 tool calling 是原语,插件是它的一种“清单托管”变体,MCP 是在原语之上补了发现、复用和会话的一层标准。Anthropic 在官方文档里的比喻是“AI 应用的 USB-C 口”,指的就是这层标准化——把 M 个客户端乘 N 个数据源的适配器矩阵,压成 M 加 N。
02原理拆解:MCP 到底规定了什么
MCP 的数据层是 JSON-RPC 2.0,所有交互都是标准的请求/响应/通知三元组。一次会话的标准开头是这样的:客户端发 initialize 声明自己想用的协议版本和具备的能力(roots、sampling 等),服务端回一个同构的响应列出自己提供什么,客户端再发一条 notifications/initialized 通知(没有 id,因为它不需要回复)。握手完成后,才轮到 tools/list 和 tools/call。
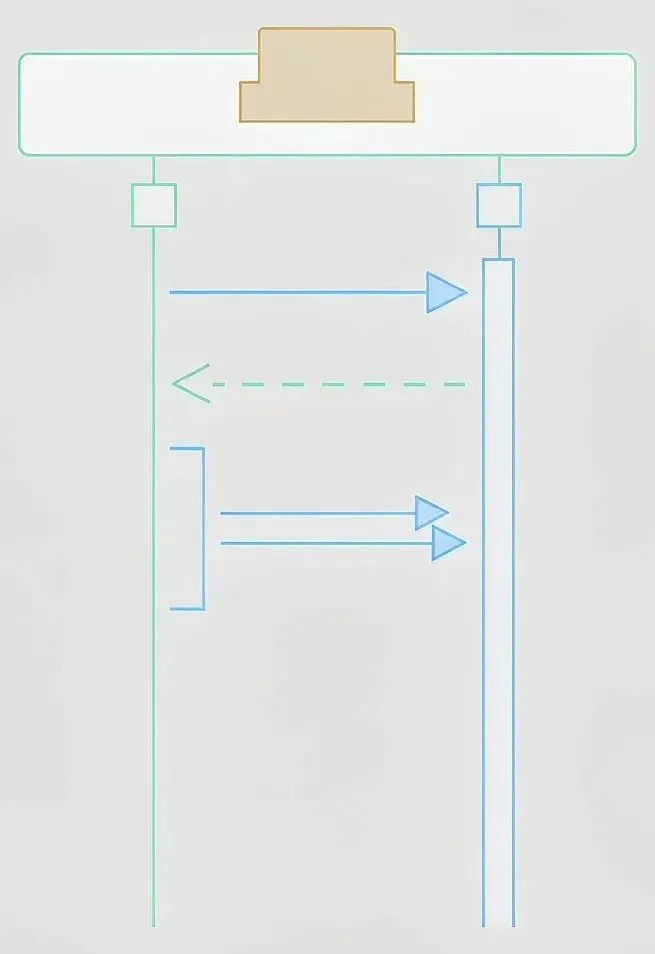
MCP 会话时序:initialize 协商版本与能力,initialized 确认后客户端才通过 tools/list 发现工具
协议定义了三个原语,理解它们的边界比背名字重要:tools 是可调用的函数,带 JSON Schema 描述的入参,生产环境里 90% 的用法都集中在这里,因为这是 Agent 真正会去“调”的东西;resources 是只读数据,比如一个文件、一条数据库记录、一段分页结果,语义上更接近“让模型看”而不是“让模型做”;prompts 是带参数的可复用模板,价值在于把服务端对某个任务的固化管理下推,减少客户端侧拼提示词的工作。
传输层有两条:本地 server 走 stdio,远程 server 走 Streamable HTTP。这里有一个常被旧教程写错的点——早期的 HTTP+SSE 方案在 2025-11-25 这一版规范里已经被 Streamable HTTP 取代,如果你读到的接入文档还在讲双端点 SSE,多半是过时的。
版本演进值得单独记一笔。“当前版本”这句话在 MCP 上时效性很差:规范从 2024-11-05 起,经历了 2025-03-26、2025-06-18、2025-11-25 几个带日期的修订,2025-11-25 是第一个被认为“final、完整、不再变动”的版本;此后 2026-07-28 的修订是上线以来改动最大的一次,它移除了 initialize 握手和协议级的会话模型,新增 server/discover。因为版本是按请求协商的,实现之前必须先确认你的客户端和服务端各自瞄准哪一版,否则会调不通——这不是理论风险,是真实存在的踩坑点。
还有一句必须说清:MCP 不是框架,不是编排层,也不替代 REST。任何一个 MCP server 底下包着的仍然是 HTTP 调用、SQL 查询或者文件读取。MCP 只是给这些能力补了一份模型能读的自描述,并处理会话状态。
03关键机制:三个容易被讲错的地方
第一,发现是运行期的,不是设计期的。这是 MCP 与 REST 集成的实质区别。你写一段调 REST 的代码,你事先知道要打哪个端点;而 Agent 用 MCP 时,是先读到 schema 再决定打哪个工具。同一份 Agent 代码换一个 MCP server 也能正确路由,因为能力描述是随 server 走的。代价也随之而来:工具定义要占上下文。企业里跑几十个 server 的时候,“工具太多导致模型选错”会变成一个真实的工程问题,官方 registry 和各家模型 API 里陆续出现的服务端工具搜索,都是为了压这个成本。
第二,会话是有状态的,这直接影响你的部署形态。2025-11-25 及之前的模型里,连接是有 session 的,服务端得维护状态,横向扩展比无状态 REST 麻烦得多。这也解释了一个常见困惑:为什么本地 stdio 的 server 一测就通,搬到 K8s 后面就开始偶发断连——负载均衡把同一个 session 的请求打到了不同实例上。
第三,鉴权在往“最小权限”方向收。2025-11-25 那一版规范补了 OpenID Connect Discovery 用于定位授权服务器、通过 WWW-Authenticate 挑战做增量 scope 授权、把 OAuth Client ID Metadata Documents 作为推荐的注册方式,并和 RFC 9728 的受保护资源元数据对齐。这一组改动的意图很一致:不要一连接就给一个大 token,而是按需、按 tool 授权。
04工程落地:一个最小 server 和一份客户端配置
理论说到这里,落到代码其实很短。下面是一个只暴露一个工具的 MCP server,用官方 Python SDK 的 FastMCP 写法,跑在 stdio 上,供本地客户端拉起:
from mcp.server.fastmcp import FastMCPimport dbmcp = FastMCP("order-tools")@mcp.tool()def get_order_status(order_id: str) -> dict: """按订单号查询履约状态,返回当前状态与最近一次物流节点。""" row = db.query_one( "select status, last_node, updated_at from orders where id = %s", order_id, ) if row is None: return {"order_id": order_id, "error": "not_found"} return { "order_id": order_id, "status": row["status"], "last_node": row["last_node"], "updated_at": str(row["updated_at"]), }if __name__ == "__main__": mcp.run(transport="stdio")函数的 docstring 不是给人看的注释,它就是模型看到的工具描述。这句话值得单独强调:docstring 写得含糊,模型就会乱选参数;写清了“按订单号”和返回字段,调用准确率立刻不一样。这跟写业务代码的习惯是反的——这里注释是接口的一部分。
客户端侧,本地 server 通常通过一份配置声明,由宿主程序去拉起进程:
{ "mcpServers": { "order": { "command": "python", "args": ["-m", "order_mcp_server"], "env": { "DB_URL": "postgres://readonly@db:5432/orders" } } }}如果要给外部客户端用,就得换成 Streamable HTTP 传输,并把鉴权接上 OAuth——这一步的工作量远大于写工具函数本身,是很多团队低估的地方。SDK 迭代较快,具体构造参数以官方 README 为准,不要照抄博客。
05边界与选型:按契约的生命周期来判断
我的判断标准不是“哪个更先进”,而是“这份契约会被谁、用多久”。逐方向列一下:
▪︎ 只有自家一个应用,模型调用和工具都在你手里 → 用自定义 tool calling。少一层进程、少一次网络跳转,工具的上下文预算你能精确控制。
▪︎ 手上已经有一份维护良好的 OpenAPI 文档,想让 Agent 快速用起来 → 写一个薄的 MCP server 包一层,不要重写业务接口。MCP 的定位本来就是“包住 API”,不是“取代 API”。
▪︎ 同一套能力要给 Claude Code、Cursor、自家 Agent、内部 Copilot 多端复用 → MCP。省下的是 N 份适配器的长期维护成本,这笔账通常算得过来。
▪︎ 要解决的问题是“事情该怎么做”,而不是“能碰什么东西” → 那不是 MCP 的范畴,属于 Skills 那一层,讲的是流程知识而非连接。
▪︎ 强确定性、跑在 CI 里的批处理 → 直接写代码调 API。把一个 nightly 同步任务塞进 Agent 循环,是给自己找不确定性。
选型决策树:先问契约的生命周期与复用范围,再问确定性要求,最后才轮到协议先进性
有一条判断经常被忽视:工具数量的上下文成本。给模型挂 40 个工具,它在选择上花的心思和出错的概率都会上升,这跟“能力越多越好”的直觉相反。我见过一个内部 Agent 挂了三个系统的全部工具,最后准确率反而不如只留 8 个高频工具——这不是模型不行,是工具边界没设计。
06面试常见追问
“MCP 和 Function Calling 是竞争关系吗?”不是。Function Calling 是模型侧的机制,MCP 是工具侧的供给标准。MCP server 最终仍然是被 harness 转成一份 tools 清单交给模型的,它站在 Function Calling 之上提供服务发现和跨客户端复用。
“为什么用 JSON-RPC 而不是 REST?”因为需要双向:server 侧可以发起 sampling(借用宿主的模型)和通知,REST 的请求-响应单向语义表达不了;另外方法名加 params 的结构比资源路径更适合“调用一个函数”这种语义。
“一个有状态的协议,怎么在无状态基础设施上跑?”要么做会话粘滞,要么把 session 外置到 Redis 之类的共享存储;2026-07-28 之后会话变成可选,这个痛点才真正缓解。回答这题能看出你有没有真部署过。
“MCP server 挂了,Agent 怎么办?”工具探测加超时降级,并且要在提示层明确告诉模型“某能力当前不可用”,而不是让它反复重试一个死掉的端点。
“权限怎么收敛?”tool 级最小权限、OAuth scope 增量授权、高危操作走人类确认。这三条是并列关系,不是替代关系。
07一线视角怎么看
工程上我按“契约的生命周期”选型:一次性的、只在自家进程里用的,别上 MCP,多一层进程就是多一处要监控、要重启、要排障的东西;跨三个客户端都要用的,MCP 值。真正需要警惕的是把 MCP 当银弹——它解决的是“能力如何被复用和发现”,不解决“这个能力该不该给模型”。我见过最贵的一次事故不是协议选错,是给模型挂了一个能直接删库的工具,而没人做二次确认。
08资料来源
▪︎Model Context Protocol 官方站点:架构总览、传输层说明(stdio 与 Streamable HTTP)、版本与兼容性说明,modelcontextprotocol.io。
▪︎ MCP 规范 2025-11-25 修订(授权相关:OpenID Connect Discovery、增量 scope、Client ID Metadata Documents、RFC 9728 对齐)与 2026-07-28 修订说明(移除 initialize 握手与协议级 session、新增 server/discover)。
▪︎ howaiworks.ai “Model Context Protocol” 词条:规范修订时间线与 2025-12 治理移交(Agentic AI Foundation / Linux Foundation)说明。
▪︎ startdebugging.net《MCP vs OpenAPI Plugins vs Custom Tool Calling》(2026-06):三方能力对照与“插件格式已被 OpenAI 弃用”的判断,属第三方评测,官方口径请以 OpenAI 文档复核。