ARTICLE · 1390591
OpenCode 技巧:分享上下文裁剪插件,长会话长任务的福音
这是怎么测的呢
让opencode自行搭了个测试。八个JS文件都是同一个脚本生成的,每个快六百行,八轮任务每轮读一个完整文件、数一下满足条件的条目有几条,全在同一个session里连着跑,模型固定deepseek-flash。
装它一行命令就行,压缩阈值我设成三万和六万,另外几个相关参数也一起调紧了。结果第一次跑完,日志里累计节省一直是零。我翻配置翻半天没找着毛病,最后才确认是版本问题,升到2.3.2才正常。
让它自己选,它就不读全文了
升完版本第一轮跑完,结果跟我想的不一样。八轮里它只完整读过两次文件,后面几轮全改用grep去搜,上下文到第八轮才三万。
合着我准备的那堆文件它没怎么看。
五次装DCP里,这样读到大文件的次数从零次到四次都有,token从十二万到二十二万多,摸不着规律。这五次又都是装着的,没设同样提示词的不装对照组,只能说差别更多看模型那一轮怎么挑工具。
它想真起点作用,前提是上下文需要真长起来。
省token
第二轮我在提示词里写死"完整读取文件、不许用grep",好把模型自己挑便宜路子这个变量按住。不然量出来的是它有多节省,不是插件能削多少。
这么一限定,上下文真涨起来了。
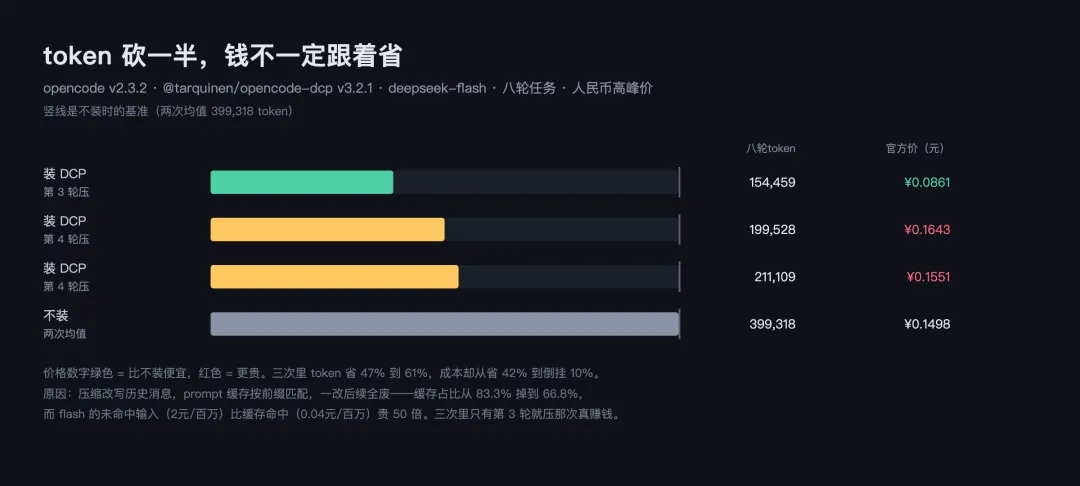
八轮跑完,不装插件的两次都是将近四十万,两次之间差不到半个百分点,说明这个任务本身挺稳。装了DCP的三次降到十五万出头到二十一万多,省了将近一半到六成。
但不一定省钱
按token算效果是明确的,可换成实际支出就反过来了。token少了一半多,钱只少了不到一成。不装的时候平均一毛五,装了平均一毛三。
原因在prompt缓存的匹配方式,插件作者自己在README里写过:DCP一压缩就需要改写历史消息,而缓存是按前缀精确匹配的,前缀一改,后面全废。所以不装的时候八成多的输入走缓存价,装了掉到六成多,剩下的全按没命中的价重算,两个单价差着五十倍。
三次里只有第三轮就压缩那次真省了钱,八分六,比不装的一毛五省约四成多。另外两次拖到第四轮才压缩,费用分别是一毛六和一毛五出头,都比不装的高。
样本也只有三次,同样在第四轮压缩的两次token还差着一万多,可见压缩在第几轮不是唯一的变量。压缩那一轮模型需要把历史对话重写一遍,要十几秒。
顺带说一句,opencode自己记的成本别拿来比。我一开始就拿它对账,越对越乱,同一个模型同一套价目能差出十几倍,我一度以为是自己算错了。后来全改成token乘官方单价重算才对上。
长会话的价值在上下文不爆
八轮里最直观的是上下文怎么涨。不装的时候从一万八一路涨到八万,每轮差不多加九千。装了DCP的那次从两万起步,第四轮压缩完掉到两万二,之后一直在两万二附近,到第八轮是两万三。
会话越长,这个差别越值钱。但好处主要在不撞上下文上限、不被内置压缩一刀重置上,费用能降多少按这次看也就一成。几十轮的效果我没测,这里是推算。
三个坑
第一个,模型可能对裁剪上瘾,issue 372标题就叫Models become obsessed with pruning,说模型压缩完甚至以为自己改的东西没保存。这毛病听着就挺离谱。
第二个,它跟内置压缩会打架,issue 440里记的是压缩完上下文反而涨到四十万以上,把内置压缩给触发了。
第三个,这项目已经放缓。README说后续工作搬去了作者自己的网关Sleev,DCP还在维护,只是新功能先上那边,许可证AGPL-3.0-or-later。
是否适合你?
如果需要跑长会话、又经常撞上下文上限的,这个插件确实有用,阈值调低让它早点压缩。费用按这次看不一定降,好处是会话不会因为撞上限断掉。
要是只想避免整文件读进去,直接写一句提示词约束就行,模型自己也常这么干。就这么着吧。
往期精选:
OpenCode 技巧:分享侧栏插件opencode-subagent-statusline