ARTICLE · 1391273
Nano-vLLM源码学习(6):ModelRunner、CUDA Graph 与性能基准
📑 目录
1. ModelRunner 的位置 2. 把序列张量化:prepare_prefill / prepare_decode 3. 全局 Context:算子的"隐式参数" 4. KV Cache 显存怎么切出来 5. CUDA Graph:只为 decode 加速 6. 张量并行的进程协同 7. 性能基准与 vLLM 对比 总结 自我检验清单 参考资料
1. ModelRunner 的位置
前面几节分别讲了算什么算子(3.3)、KV 放哪(3.4)、算谁(3.5)。ModelRunner(engine/model_runner.py,257 行)把它们接成一次真实的 GPU 执行:接过调度器选好的序列,构造模型 forward需要的张量,设置全局上下文,调用 Qwen3,再把 logits 交给采样器。
虚线框是一次 ModelRunner.run,框内五步从左到右依次执行,绿色两步调用模型本身:
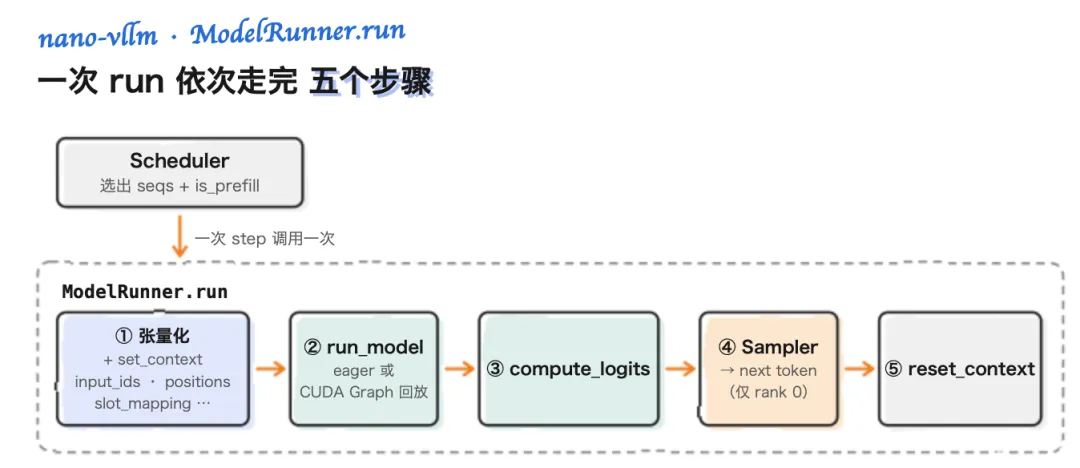
run本身只有几行:
●●●Pythondefrun(self, seqs, is_prefill): input_ids, positions = self.prepare_prefill(seqs) if is_prefill elseself.prepare_decode(seqs) temperatures = self.prepare_sample(seqs) ifself.rank == 0elseNone logits = self.run_model(input_ids, positions, is_prefill) # eager 或 CUDA Graph 回放 token_ids = self.sampler(logits, temperatures).tolist() ifself.rank == 0elseNonereset_context()return token_idsModelRunner.__init__在引擎启动时按固定顺序做完准备工作,后面几节逐个展开:
1. 用 NCCL 初始化进程组,绑定本 rank 的 GPU,把默认 dtype 设成模型的 dtype(Qwen3-0.6B 是 bf16)。 2. 构造 Qwen3ForCausalLM并从 safetensors 加载权重。 3. warmup_model:跑一次最大规模的 prefill,测出激活显存的峰值(第 4 节)。 4. allocate_kv_cache:把剩余显存切成 KV 块(第 4 节)。 5. enforce_eager=False时 capture_cudagraph,预先捕获 decode 的 CUDA Graph(第 5 节)。 6. TP>1 时建立共享内存,rank>0 进入 loop等待指令(第 6 节)。
2. 把序列张量化:prepare_prefill / prepare_decode
模型 forward吃的是张量,调度器给的是一批 Sequence对象。ModelRunner按阶段用两个准备函数做转换,两个阶段需要的张量形态不同。
Prefill:变长序列拼在一起
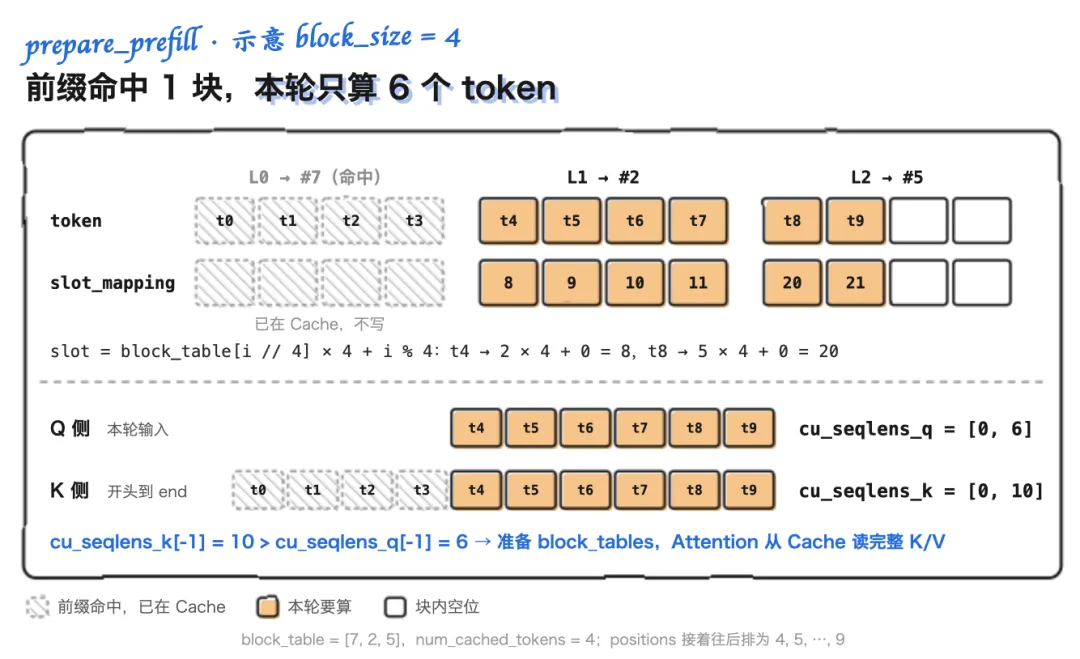
●●●Pythondefprepare_prefill(self, seqs): input_ids, positions, slot_mapping = [], [], [] cu_seqlens_q, cu_seqlens_k = [0], [0] max_seqlen_q = max_seqlen_k = 0 block_tables = Nonefor seq in seqs: start = seq.num_cached_tokens # 已经在 Cache 里的 token 数 end = start + seq.num_scheduled_tokens # 本轮算到哪里 input_ids.extend(seq[start:end]) # Q 只包含本轮要算的 token positions.extend(range(start, end)) # 位置接着 start 往后排 cu_seqlens_q.append(cu_seqlens_q[-1] + end - start) cu_seqlens_k.append(cu_seqlens_k[-1] + end) # K 覆盖从开头到 end 的全部 token max_seqlen_q = max(max_seqlen_q, end - start) max_seqlen_k = max(max_seqlen_k, end)ifnot seq.block_table: # warmup 的假序列没有块,不写 Cachecontinue# 把 [start, end) 映射成物理 slot(源码按块成段 extend,这里逐 token 展开)for i inrange(start, end): block_id = seq.block_table[i // self.block_size] slot_mapping.append(block_id * self.block_size + i % self.block_size)if cu_seqlens_k[-1] > cu_seqlens_q[-1]: # 有历史 KV:前缀命中或 chunked 续算 block_tables = self.prepare_block_tables(seqs)# ...转成 pin_memory 张量,non_blocking 拷到 GPU,再 set_context(True, ...)🔑 cu_seqlens(cumulative sequence lengths):多条变长序列首尾相接后,用一串累积长度标出每条的边界,这是flash_attn_varlen_func要求的格式(见 3.3)。Q 侧只有本轮要算的 token,K 侧从序列开头算起。🔑 何时带 block_tables:没有历史时,Q 和 K 一样长,kernel 直接用本轮新算出的 k/v。只要有一条序列的 K 比 Q 长,说明它的前半段 KV 已经在 Cache 里,这时才准备block_tables,Attention 改从 Cache 读完整的 K/V(3.3 第 7.2 节)。slot_mapping:每个 token 在 KV Cache 里的物理位置,等于物理块号 × block_size + 块内偏移。3.3 的 Tritonstore_kvcache按它把 K/V 写进 Cache。
下图用 block_size = 4 演示一条命中 1 块前缀缓存的 10 token 序列(灰色是已在 Cache 里的 token,橙色是本轮要算的 token):
Decode:每条序列只有一个 token
●●●Pythondefprepare_decode(self, seqs): input_ids, positions, slot_mapping, context_lens = [], [], [], []for seq in seqs: input_ids.append(seq.last_token) # 只喂上一步采样出的 token positions.append(len(seq) - 1) context_lens.append(len(seq)) # 包含这个新 token 在内的总长度# 新 token 是最后一块里的第 last_block_num_tokens 个 slot_mapping.append(seq.block_table[-1] * self.block_size + seq.last_block_num_tokens - 1) block_tables = self.prepare_block_tables(seqs) # 各序列 block_table 右侧补 -1,对齐成矩阵# ...转成 GPU 张量,set_context(False, slot_mapping=..., context_lens=..., block_tables=...)读 last_token而不是token_ids[-1]:TP>1 时 worker 收到的 decode 序列只有last_token,没有token_ids(3.4 第 3.1 节)。slot 的位置:调度器在 may_append里已经为跨块的 token 分好了新块,所以新 token 一定落在block_table[-1]里。🔑 context_lens:告诉flash_attn_with_kvcache每条序列要读多少个历史 K/V。它把新 token 也算进去,因为 Attention 先执行store_kvcache把新 token 的 K/V 写进 Cache,再做注意力计算。
⚠️ 注意:block_tables右侧补的 -1 只用于对齐矩阵,kernel 只按 context_lens读前面有效的块,不会访问补位。它和 store_kvcache跳过的 slot == -1不是一回事,后者来自 CUDA Graph 回放时补齐的 batch(第 5 节)。
3. 全局 Context:算子的"隐式参数"
cu_seqlens、slot_mapping、block_tables、is_prefill这些张量,Attention、LMHead 等算子都要用。如果当函数参数一层层传下去,Qwen3ForCausalLM、每个 DecoderLayer、每个 Attention的 forward都要多出七八个参数。nano-vllm 把它们放进一个全局 Context(utils/context.py),算子内部用 get_context()现取:
●●●Python@dataclass(slots=True)class Context: is_prefill: bool = False cu_seqlens_q: torch.Tensor | None = None cu_seqlens_k: torch.Tensor | None = None max_seqlen_q: int = 0 max_seqlen_k: int = 0 slot_mapping: torch.Tensor | None = None context_lens: torch.Tensor | None = None block_tables: torch.Tensor | None = None_CONTEXT = Context()defset_context(is_prefill, cu_seqlens_q=None, ...): # prepare_* 末尾调用global _CONTEXT _CONTEXT = Context(is_prefill, cu_seqlens_q, ...)defreset_context(): # run 末尾调用global _CONTEXT _CONTEXT = Context()其中 max_seqlen_q/max_seqlen_k是 flash_attn_varlen_func需要的本批最长序列长度,与 cu_seqlens配套使用;decode 只设置 slot_mapping、context_lens、block_tables三项。
💡 提示:这是用全局变量换代码整洁的做法。Qwen3.forward的签名只有 input_ids和 positions,代价是算子隐式依赖全局状态,每次 forward前必须先 set_context。nano-vllm 的推理循环是单线程串行执行的,每个 rank 一个进程,这个前提成立。run结束时 reset_context清掉引用,避免本步的张量被下一步误用。
4. KV Cache 显存怎么切出来
第 2 节 slot_mapping指向的物理显存,是引擎启动时一次性分配好的。ModelRunner不按最大长度给每条请求预留,而是先加载权重、用 warmup 测出激活峰值,再把剩下的显存全切成 KV 块。这就是 3.2 里 num_kvcache_blocks初始为 -1、运行时才算出来的原因。
warmup 用一批假序列跑一次最大规模的 prefill:
●●●Pythondefwarmup_model(self): torch.cuda.empty_cache() torch.cuda.reset_peak_memory_stats() # 峰值统计从这里重新开始 seq_len = min(max_num_batched_tokens, max_model_len) num_seqs = min(max_num_batched_tokens // seq_len, max_num_seqs) seqs = [Sequence([0] * seq_len) for _ inrange(num_seqs)] # 没有 block_table 的假序列for seq in seqs: seq.num_scheduled_tokens = seq_lenself.run(seqs, True) torch.cuda.empty_cache()默认配置下是 16384 // 4096 = 4条 4096 token 的序列,正好用满一步的 token 预算。这时 KV Cache 还没分配,k_cache.numel()为 0,3.3 里 Attention 的写 Cache 分支被跳过,测出的峰值只包含权重和激活。随后 allocate_kv_cache按余量切块:
●●●Pythondefallocate_kv_cache(self): free, total = torch.cuda.mem_get_info() used = total - free # 整张卡已占用的显存 peak = torch.cuda.memory_stats()["allocated_bytes.all.peak"] # warmup 期间的分配峰值 current = torch.cuda.memory_stats()["allocated_bytes.all.current"] num_kv_heads = hf_config.num_key_value_heads // self.world_size # 本 rank 负责的 KV 头 block_bytes = 2 * num_layers * block_size * num_kv_heads * head_dim * dtype.itemsize config.num_kvcache_blocks = int(total * gpu_memory_utilization - used - peak + current) // block_bytesassert config.num_kvcache_blocks > 0# 一个 6 维大张量装下所有层、所有块的 K 和 Vself.kv_cache = torch.empty(2, num_layers, num_kvcache_blocks, block_size, num_kv_heads, head_dim) layer_id = 0for module inself.model.modules(): # 按顺序绑定到每层 Attentionifhasattr(module, "k_cache") andhasattr(module, "v_cache"): module.k_cache = self.kv_cache[0, layer_id] module.v_cache = self.kv_cache[1, layer_id] layer_id += 1块数公式写成:
used是驱动看到的整卡占用,包括权重、CUDA 上下文、PyTorch 缓存池,也包括同一张卡上其他进程的占用。peak - current是 warmup 时激活比当前多占的部分,正式运行时还会再出现,要提前留出来。每块的字节数是:
以 Qwen3-0.6B 为例(28 层、8 个 KV 头、head_dim = 128、bf16,TP=1):字节,即每块 28 MiB,每个 token 112 KiB。每 1 GiB 显存大约能放 36 块,约 9200 个 token。
📌 关键点:KV Cache 是一个 6 维张量(2, 层数, 块数, 块大小, KV 头数, head_dim),第 0 维区分 K 和 V。分配后把每层的切片绑定到对应 Attention 模块的 k_cache/v_cache属性上,3.3 里的 store_kvcache和 flash_attn_with_kvcache直接用 self.k_cache读写。显存余量按块全部切给 KV,不按请求预留,能同时容纳的序列数由实际长度决定。
⚠️ 注意:KV Cache 的 dtype 跟模型的默认 dtype 一致(__init__里设成了 hf_config.dtype),nano-vllm 没有实现 KV Cache 量化。
5. CUDA Graph:只为 decode 加速
Decode 阶段每步每条序列只算一个 token,单个 kernel 的计算量很小,CPU 逐个发射 kernel 的开销(launch overhead)占比变大:GPU 算完一个小 kernel,要等 CPU 把下一个发过来。CUDA Graph 把一串 kernel 的发射录制成一张图,之后一次 replay()就重放整串,省掉逐个发射的 CPU 开销。
CUDA Graph 录下的是 kernel 和它们读写的固定显存地址,回放时只能换数据、不能换地址和形状。所以 nano-vllm 先按最大 batch 分配一组静态缓冲区,让 Context 指向这些缓冲区的切片,再为每个 batch 档位捕获一张图:
●●●Python@torch.inference_mode()defcapture_cudagraph(self): max_bs = min(self.config.max_num_seqs, 512) max_num_blocks = (config.max_model_len + self.block_size - 1) // self.block_size input_ids = torch.zeros(max_bs, dtype=torch.int64) # 静态缓冲区,所有图共用 positions = torch.zeros(max_bs, dtype=torch.int64) slot_mapping = torch.zeros(max_bs, dtype=torch.int32) context_lens = torch.zeros(max_bs, dtype=torch.int32) block_tables = torch.zeros(max_bs, max_num_blocks, dtype=torch.int32) outputs = torch.zeros(max_bs, hf_config.hidden_size)self.graph_bs = [1, 2, 4, 8] + list(range(16, max_bs + 1, 16))self.graphs, self.graph_pool = {}, Nonefor bs inreversed(self.graph_bs): # 从大到小捕获 graph = torch.cuda.CUDAGraph()set_context(False, slot_mapping=slot_mapping[:bs], context_lens=context_lens[:bs], block_tables=block_tables[:bs]) outputs[:bs] = self.model(input_ids[:bs], positions[:bs]) # 先正常跑一遍with torch.cuda.graph(graph, self.graph_pool): outputs[:bs] = self.model(input_ids[:bs], positions[:bs]) # 再捕获ifself.graph_pool isNone:self.graph_pool = graph.pool() # 最大那张图的内存池给后面的图共用self.graphs[bs] = graph torch.cuda.synchronize()reset_context()self.graph_vars = dict(input_ids=input_ids, positions=positions, slot_mapping=slot_mapping, context_lens=context_lens, block_tables=block_tables, outputs=outputs)🔑 档位:默认 max_num_seqs = 512时,档位是 1、2、4、8 和 16 到 512 之间每隔 16 一档,共 36 张图。从大到小捕获:第一张(最大的)图分配的内存池通过 graph.pool()传给后面的小图复用,36 张图不会各占一份中间激活。捕获前先跑一遍:被 @torch.compile修饰的算子遇到新的输入形状时可能重新编译,Triton kernel 也在首次调用时 JIT,这些都不能发生在捕获过程中。图里只到 hidden state 为止, compute_logits和采样在图外执行(3.3 第 8 节)。
运行时按实际 batch 大小挑一张不小于它的图,把数据拷进静态缓冲区再回放:
●●●Python@torch.inference_mode()defrun_model(self, input_ids, positions, is_prefill):if is_prefill orself.enforce_eager or input_ids.size(0) > 512:returnself.model.compute_logits(self.model(input_ids, positions)) # eager bs = input_ids.size(0) context = get_context() graph = self.graphs[next(x for x inself.graph_bs if x >= bs)] # 向上取档 graph_vars = self.graph_vars graph_vars["input_ids"][:bs] = input_ids graph_vars["positions"][:bs] = positions graph_vars["slot_mapping"].fill_(-1) # 补齐的位置 slot = -1:不写 Cache graph_vars["slot_mapping"][:bs] = context.slot_mapping graph_vars["context_lens"].zero_() # 补齐的位置长度为 0:不读 Cache graph_vars["context_lens"][:bs] = context.context_lens graph_vars["block_tables"][:bs, :context.block_tables.size(1)] = context.block_tables graph.replay()returnself.model.compute_logits(graph_vars["outputs"][:bs])下图以 37 条序列为例:没有 37 这一档,选 48 号图回放,多出的 11 个位置是补齐位(绿色是真实序列,灰色是补齐位):
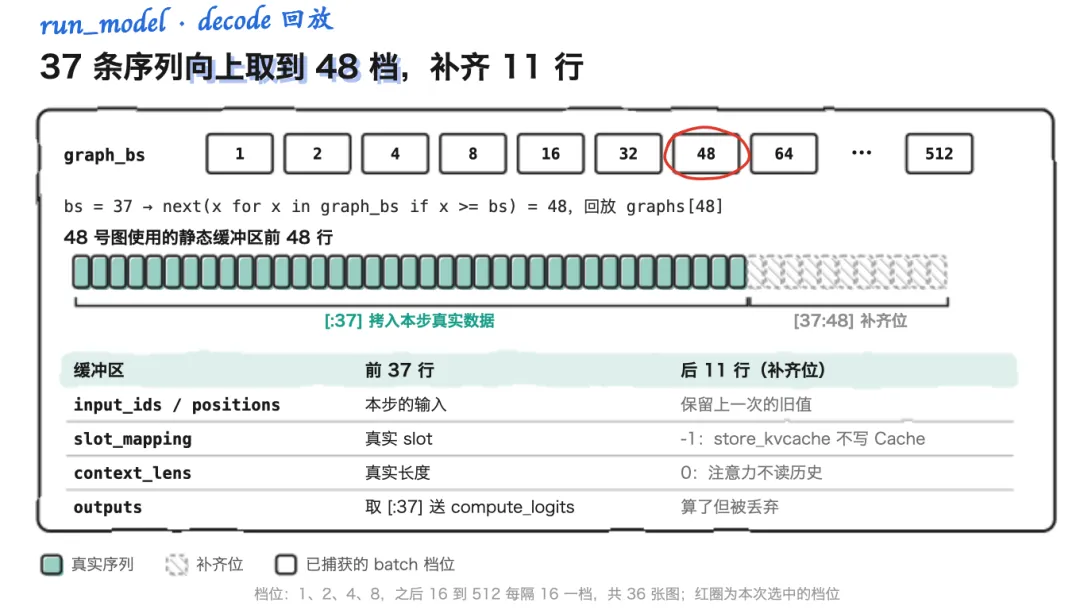
🔑 只捕获 decode:prefill 每步的 token 总数都在变,没法用固定形状的图;decode 每条序列恒为 1 个 token,只有 batch 大小在变,预捕获几十档就能覆盖。 🔑 补齐位怎么处理: slot_mapping填 -1,3.3 的store_kvcache遇到 -1 直接返回,不写 Cache;context_lens填 0,注意力不读任何历史。input_ids、positions的补齐位保留上一次的旧值,算出来的结果在outputs[:bs]切片时被丢掉。block_tables只覆盖前bs行、前若干列,残留的旧块号同样因为context_lens的限制不会被读到。enforce_eager=True:run_model永远走 eager 分支,启动时也不捕获图。调试时打开,每个 kernel 真实发射,方便定位问题;跑吞吐时关掉。batch 超过 512 时退回 eager:档位最多到 512, max_num_seqs设得更大时,超出部分直接普通执行。
⚠️ 注意:max_num_seqs小于 512 且不是 16 的倍数(大于 8)时,最大档位小于 max_num_seqs。比如设成 100,档位最大是 96,batch 为 97 到 100 时 next(...)找不到档位,会抛出 StopIteration。使用默认值 512 不会遇到这个问题。
6. 张量并行的进程协同
3.2 提过,LLMEngine用 spawn为 rank>0启动了 worker 子进程,子进程里跑的也是 ModelRunner。张量的汇合走 NCCL(init_process_group("nccl", "tcp://localhost:2333", ...)),「这一步该做什么」则由 rank 0 通过一块共享内存下发,构成一套很小的 RPC:
●●●Pythondefwrite_shm(self, method_name, *args): # rank 0 data = pickle.dumps([method_name, *args]) n = len(data)self.shm.buf[0:4] = n.to_bytes(4, "little") # 前 4 字节写长度self.shm.buf[4:n+4] = datafor event inself.event: # rank 0 持有所有 worker 的 Event event.set()defread_shm(self): # rank > 0self.event.wait() n = int.from_bytes(self.shm.buf[0:4], "little") method_name, *args = pickle.loads(self.shm.buf[4:n+4])self.event.clear()return method_name, argsdefcall(self, method_name, *args):ifself.world_size > 1andself.rank == 0:self.write_shm(method_name, *args) # 先广播给 workerreturngetattr(self, method_name)(*args) # 再自己执行defloop(self): # rank > 0 在 __init__ 末尾进入,不再返回whileTrue: method_name, args = self.read_shm()self.call(method_name, *args)if method_name == "exit":break共享内存名为 "nanovllm"、大小2**20字节(1 MiB),由 rank 0 创建,dist.barrier()之后 worker 再按名字打开。每步写进去的是 pickle 后的方法名和 Sequence列表。Sequence.__getstate__在 decode 阶段只打包几个整数、block_table和last_token(3.4 第 3.1 节),每步的消息很小。NCCL 的初始化地址和共享内存名都是写死的。TP=1 时也会在 2333 端口初始化进程组,所以同一台机器上同时起两个 nano-vllm 实例会端口冲突;TP>1 时共享内存名也会冲突。
📌 关键点:rank 0 负责调度、采样,持有分词器;rank 1 到 N-1 只负责自己那份权重的前向,通过 3.3 讲的 all_reduce/gather和 rank 0 汇合结果。3.2 里 step调用的 call("run", seqs, is_prefill)这一个入口,就让所有 rank 跑同一步。
7. 性能基准与 vLLM 对比
nano-vllm 的 README 给出了一组和 vLLM 的吞吐对比(数据取自 2026-04-26 提交的 README):
Qwen3-0.6B | |
| nano-vllm | 93.41 s | 1434.13 tok/s |
看这组数之前,先看 bench.py是怎么测的:
seed(0)固定随机数;prompt 是randint(0, 10000)生成的随机 token id,长度randint(100, 1024);每条的max_tokens取randint(100, 1024)。ignore_eos=True、temperature=0.6,保证每条序列都生成满max_tokens,两个引擎的输出总量一致。LLM(path, enforce_eager=False, max_model_len=4096),开启 CUDA Graph;正式计时前先用一条短请求预热。吞吐 = sum(max_tokens) / 总耗时。分子只算输出 token,分母却包含了所有 prefill 的时间,这是端到端的输出吞吐,不是 decode 吞吐。README 没有写对比用的 vLLM 版本。
💡 提示:这组结果说明,在单卡、0.6B 小模型、离线批量生成的场景下,nano-vllm 的吞吐和 vLLM 处在同一水平,高出约 5%。它不说明 nano-vllm 在大模型、长上下文、在线服务或多卡场景下也更快,这些场景下 vLLM 的混合批处理、更多 Attention 后端和量化支持都会起作用,而这个基准没有覆盖。更准确的说法是:nano-vllm 用约 1200 行代码实现了 PagedAttention、前缀缓存、连续批处理、CUDA Graph 这些主干机制,在这个测试里达到了和 vLLM 相当的吞吐。
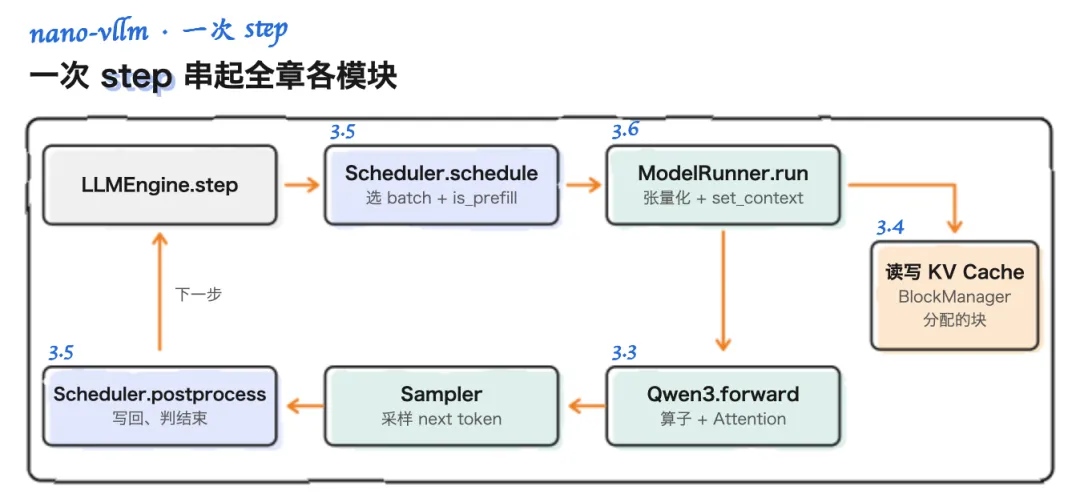
把全章的六节连起来,一次 step的完整调用链如下,每个框左上角的蓝字是讲解它的小节:
📝 总结
ModelRunner.run的流程是:张量化序列并set_context→run_model(eager 或 CUDA Graph 回放)→compute_logits→ rank 0 采样 →reset_context。Prefill 把变长序列首尾相接,Q 侧只放本轮要算的 token,用 cu_seqlens_q/cu_seqlens_k标边界;K 比 Q 长(前缀命中或 chunked 续算)时才带block_tables。Decode 每条只喂last_token,用context_lens和block_tables从 Cache 读历史。slot_mapping在两个阶段都负责把新 K/V 写到物理块号 × block_size + 块内偏移。全局 Context让算子通过get_context()拿到这些张量,forward签名只剩input_ids和positions,代价是每步必须先set_context。启动时先用一次最大规模的 prefill(默认 4 × 4096 token)测出激活峰值,再按 total × util − used − (peak − current)把剩余显存切成 KV 块。KV Cache 是一个 6 维张量(2, 层, 块, 块大小, KV头, head_dim),按层切片绑定到每个 Attention。Qwen3-0.6B 每块 28 MiB、每 token 112 KiB。CUDA Graph 只捕获 decode:默认 36 个 batch 档位从大到小捕获、共用一个内存池;运行时向上取档,补齐位的 slot_mapping填 -1、context_lens填 0。max_num_seqs不是 16 的倍数时,最大档位以上的 batch 会触发StopIteration。张量并行下,rank 0 把 pickle 后的方法名和 Sequence写进 1 MiB 共享内存,用 Event 通知 worker 执行同一个方法;张量的汇合走 NCCL。端口 2333 和共享内存名都是写死的。README 的基准(RTX 4070 Laptop、Qwen3-0.6B、256 条随机请求)里 nano-vllm 端到端输出吞吐比 vLLM 高约 5%。这只说明在单卡小模型离线批量生成的场景下两者相当。
📚 推荐阅读
AIInfraGuide : 开源全栈AI Infra 学习教程
推理优化系列:
AIInfra推理优化(3):PagedAttention - 像操作系统管理内存一样管理 KV Cache
AIInfra推理优化(4):Continuous Batching - 让 GPU 不再空等的动态批处理
AIInfra推理优化(5):Prefix Cache 与 RadixAttention 复用共享前缀的 KV
AIInfra推理优化(6):Chunked Prefill 与统一 Token Budget 调度
AIInfra推理优化(7):Attention 后端与CUDA Graph
Nano-vLLM源码学习(2):配置、入口与一次 generate 的全流程