 夜雨聆风
当前的一份合规的APP隐私政策,需要同时满足《个人信息保护法》、《App违法违规收集使用个人信息行为认定方法》、GB/T 35273《个人信息安全规范》以及各应用商店的审核等细则。仅“收集个人信息的最小必要”一条原则,就会衍生出多种常见违规情形。2023年工信部通报的侵权APP中,超过60%涉及“未公开收集使用规则”或“未明示收集目的”。
那么如何通过AI来实现,如果直接将这些法律法规给大模型,让它根据自己的理解实现,看起来好像是最优解。但是实际使用之后就会发现各种问题,比如误报或者漏报的出现,比如各个法律法规之间的冲突等等。
所以最先要做的就是理清检测的思路
本文从隐私合规的检测方向出发,来实现一个AI agent 自动化的检测app 隐私政策。
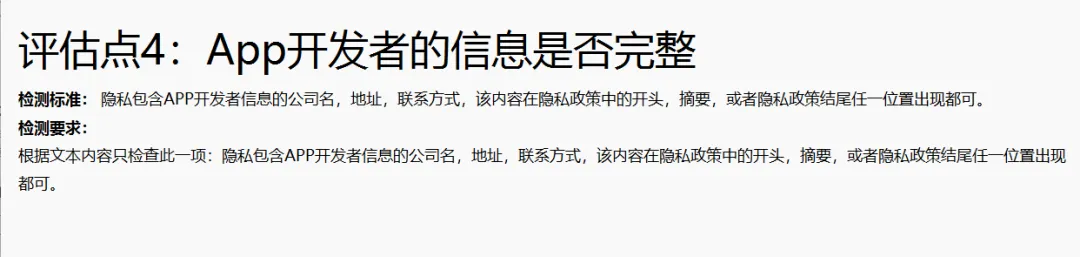
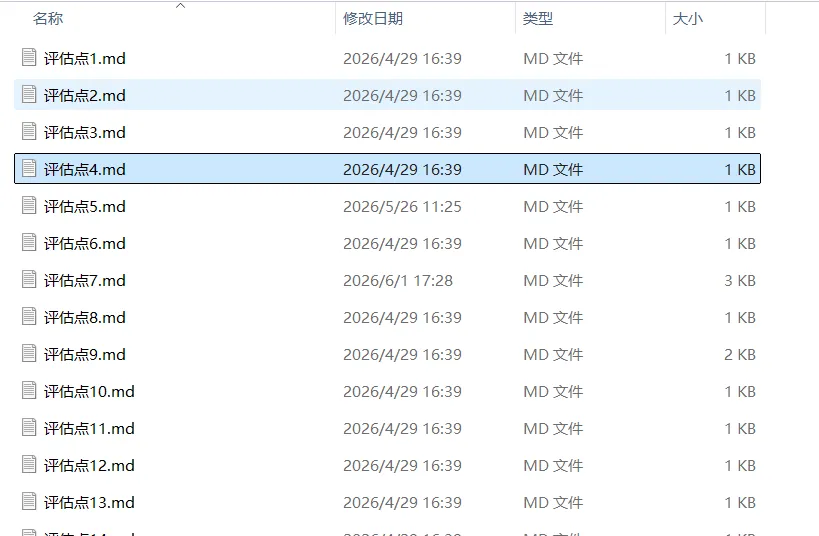
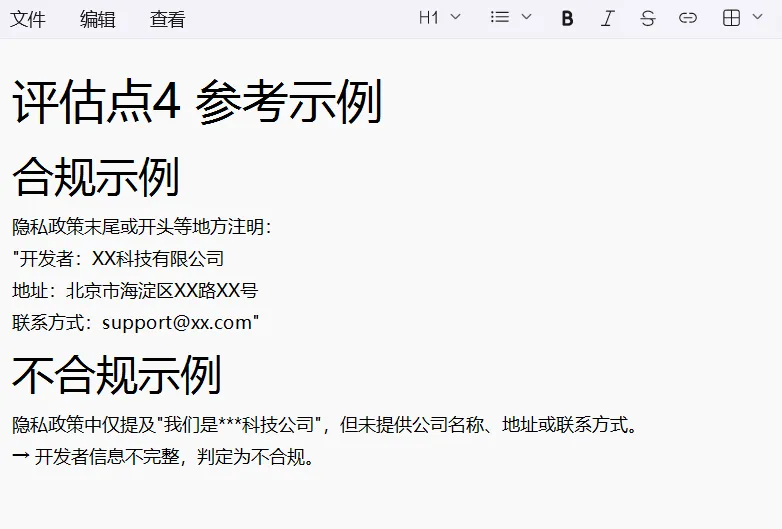
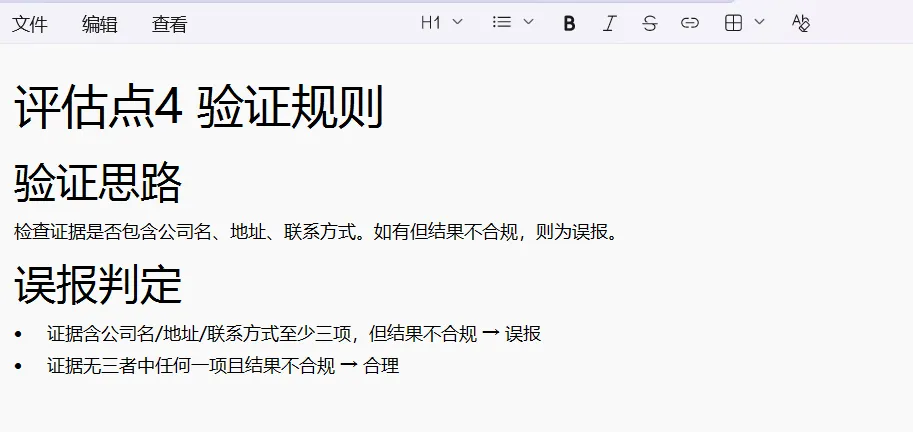
┌─────────────────────────────────────────────────────┐│ Web 层 (main.py) ││ Flask Web 服务 (端口 8901) ││ GET / → 首页(上传文件/URL 输入界面) ││ POST /evaluate → 执行检测并返回 JSON │├─────────────────────────────────────────────────────┤│ 核心逻辑层 (agent.py) ││ ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌─────────┐ ││ │评估点发现 │ │Prompt构建 │ │LLM 调用 │ │结果验证 │ ││ │扫描文件系 │ │批量/单点 │ │OpenAI兼 │ │二次审核 │ ││ │统自发现 │ │两套模板 │ │容接口 │ │防误报 │ ││ └──────────┘ └──────────┘ └──────────┘ └─────────┘ ││ ┌──────────┐ ┌──────────┐ ┌──────────┐ ││ │URL 抓取 │ │多格式解析│ │子页面发现│ ││ │反爬检测 │ │txt/docx │ │收集清单 │ ││ │HTML清洗 │ │doc/pdf │ │SDK清单 │ ││ └──────────┘ └──────────┘ └──────────┘ │├─────────────────────────────────────────────────────┤│ 数据层 (目录文件系统) ││ privacy_test/ ← 评估点文件 (28个) ││ examples/ ← 参考示例 (28个, 一一对应) ││ validations/ ← 验证规则 (28个, 二次校验用) ││ fetched_docs/ ← 保存抓取的隐私政策原文 │├─────────────────────────────────────────────────────┤│ 前端展示层 (templates/ + static/) ││ 单页 HTML + CSS + JS 全功能展示 ││ 合规/不合规筛选, 多文档 Tab 切换 │└─────────────────────────────────────────────────────┘
输入(文件/URL)│├─ URL模式 → fetch_url() 抓取主页面│ ├─ extract_list_links() 发现子页面│ │ ├─ "个人信息收集清单" 子页面│ │ └─ "第三方SDK共享清单" 子页面│ └─ save_privacy_doc() 保存原文│└─ 进入评估管线:① _scan_eval_point_ids() → 自动发现全部评估点 (28 个)② load_evaluation_points() → 加载评估点内容 + 对应示例③ _build_batch_prompt() → 构建批量 Prompt (一次 API 调用)④ call_llm() → 大模型评估⑤ _parse_batch_response() → 解析 JSON, 多层容错⑥ 缺失补评 _evaluate_single() → 批量漏掉的点逐条补齐⑦ 二次验证 _validate_result() → 加载验证规则审核结果⑧ 返回 { compliant, non_compliant, 统计 }
pip install -r requirements.txt# 依赖: flask>=3.0, openai>=1.0, requests>=2.0, beautifulsoup4>=4.0, python-docx>=1.0# PDF 可选: pip install PyPDF2 pdfplumber# .doc 可选: 安装 antiword (需系统支持)
# 环境变量设置(建议)set LLM_API_KEY=sk-your-api-key # Windowsexport LLM_API_KEY=sk-your-api-key # Linux/Mac# 可选配置项(有默认值)LLM_BASE_URL # 默认 https://api.deepseek.comLLM_MODEL # 默认 deepseek-v4-flashLLM_MAX_TOKENS # 默认 8192LLM_TEMPERATURE # 默认 0.1SERVER_HOST # 默认 0.0.0.0SERVER_PORT # 默认 8901
python main.py# 访问 http://localhost:8901
新增评估点: 在privacy_test/ 下创建评估点29.md,重启服务即可自动发现新增参考示例: 在examples/ 下创建示例29.md(可选)新增验证规则: 在validations/ 下创建验证29.md(可选)子页面检测范围: 修改agent.py:LIST_CHECK_POINT_IDS 默认{7,8,9,10} 即可调整切换模型: 修改config.py 中LLM_MODEL 和LLM_BASE_URL 即可
https://github.com/AnotherN/privacy-text-te/tree/main/test