ARTICLE · 1035046
200万粉的治愈萌宠号,我用免费 AI 跑了一遍:核心其实就这5步
我是梦想躺平的大橙,一个不想写代码的程序员
以前干过 5 年化工,后来转行写代码。现在看身边同行都在死磕 FDE、疯狂内卷,我反而更想折腾点轻量又好玩的 AI 小项目,带大家摸索点早日躺平的新路子
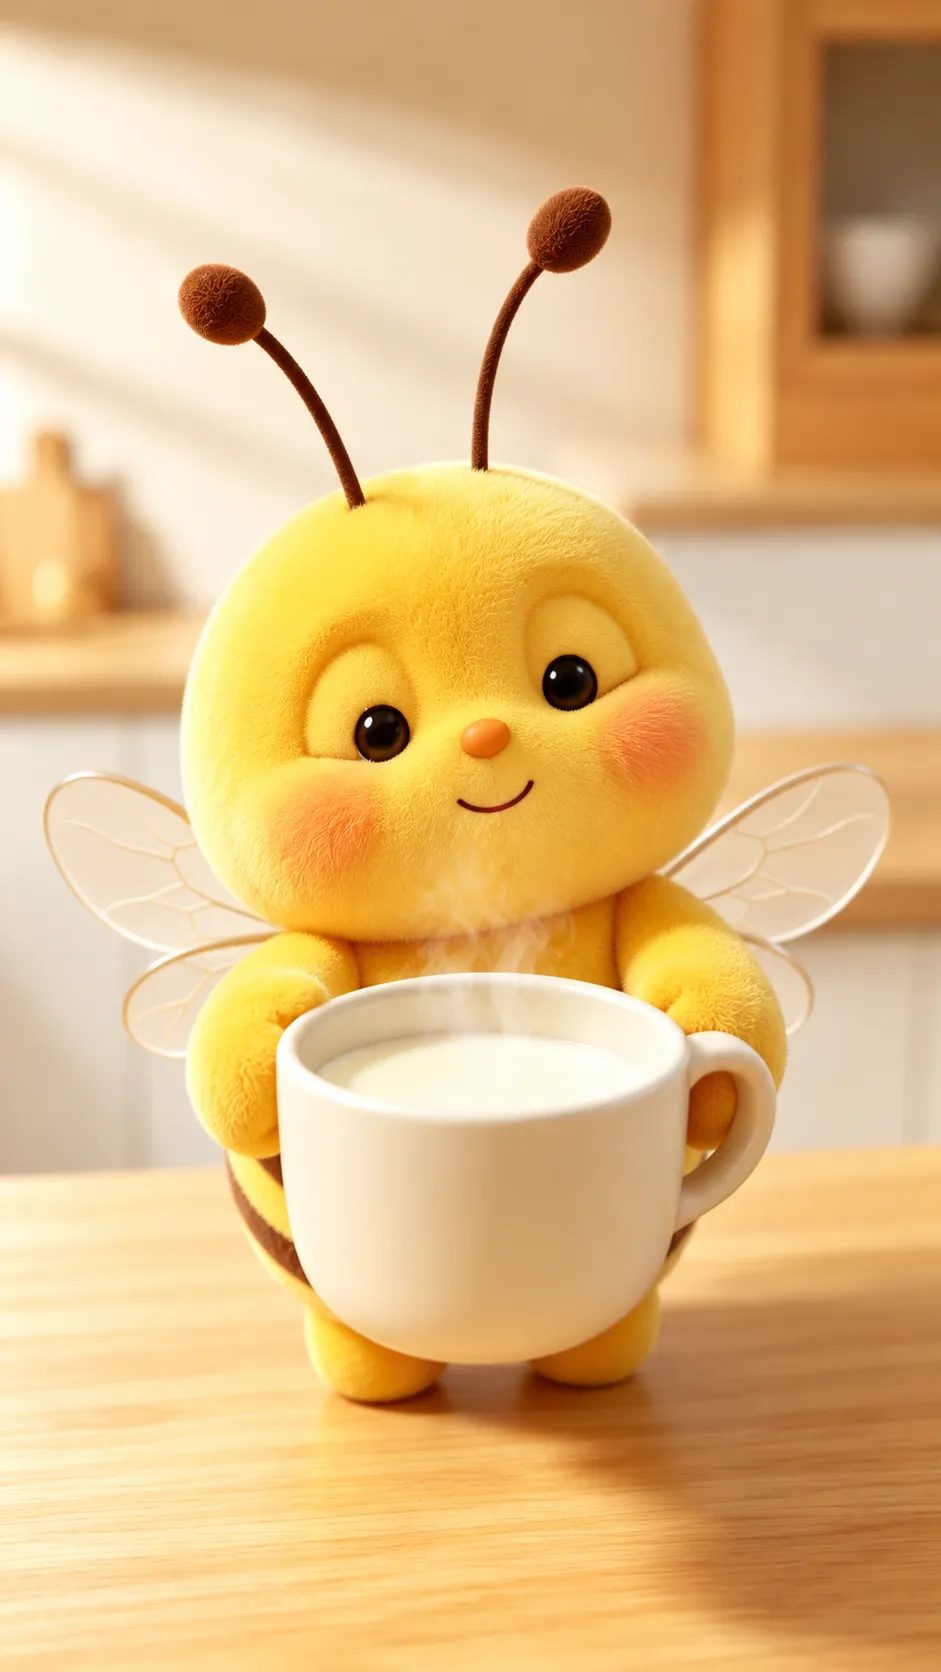
这期我就拿全网爆火的治愈系 AI 萌宠开刀,用豆包和元宝做了一只在厨房泡牛奶的小蜜蜂
先看成片效果:
整套流程我自己从头踩坑跑了一遍,拆开看其实就五步:定 IP ➔ 写分镜 ➔ 生成图 ➔ 生视频 ➔ 拼剪辑。
今天不讲虚的,把提示词和避坑经验放在每一步里,新手跟着做就行
为了不把“真实输入”和“事后整理”混在一起,下面统一标了来源。「实操原文」来自本期记录;「整理复现版」表示当时没有留下逐字输入,是我根据最终画面和遇到的问题整理的可复用版本
STEP 01第一步:先定 IP,别一上来就写剧本
很多人一上手就急着去编故事。做这类围绕固定角色更新的账号,我建议先把角色定下来
我做下来最直观的感受是,故事可以很简单,但角色不能没记忆点。我先把头身比锁在接近 1:1,让大头小身子的轮廓先软萌起来,再用细绒毛和柔和光线补出毛茸茸的触感
记忆点也不用堆太多。我只保留小蜜蜂原本的触角和翅膀,没有硬塞衣服、帽子和背包。东西一多,后面每个镜头都得跟着对,反而更容易乱
打开豆包,把这套逻辑丢进去出角色图
我实际用的不是一段直接生图的描述,而是先让豆包扮演「生图提示词专家」。我只给它一个很简单的输入,黄色的小蜜蜂,再让它扩写出完整的中英文提示词
这套写法的逻辑不复杂:先用 Role 告诉豆包,它现在负责把简单想法扩成生图提示词;再用 Constraints 禁止衣服、配饰、人类四肢和其他容易跑偏的东西;最后用 Output Format 锁住头身比、材质、五官与正反向提示词的结构
想换成小猫或小狗,只要把 Input 里的「黄色的小蜜蜂」换掉,再调整自然器官和主色调
实操原文:
PROMPT · 可复制
Role你是一名 “3D 治愈系 IP 生图提示词专家”。核心任务是将用户输入的简单概念,精准转化为拥有皮克斯级 3D 光影、软萌极简的盲盒风格生图提示词。Constraints绝对禁止添加任何人类衣物与人工配饰(如帽子、缝线等)。所有附加特征(如叶片、尾巴)必须设定为 “与皮肉相连的自然器官”。不解释思考过程,直接输出最终的中英文提示词。Input设定需求:黄色的小蜜蜂Output Format正向提示词 (Positive Prompt):(3D 渲染治愈系极简软萌 [主体] 小精灵 IP:1.2), 8K 超高清,纯色干净背景。头身比严格 1:1, 大大的圆头部,圆滚滚的水滴形身体。底盘圆润,(身体两侧仅有极短的水滴状凸起作为肢体代替:1.2), (绝对无手指,绝对无脚趾,无关节:1.3)。(自然生长出 [结合特征描述],与皮肉完美相连,非穿戴物:1.2)。极简治愈五官:双眼为闭合弯弧眯眯眼 (无眼珠), 极浅倒 U 型微笑线。脸颊有大面积柔和的 [结合主色调加深] 圆形腮红。[主色调] 植绒磨砂质感,极短细腻绒毛。(皮克斯级别 3D 柔和光影:1.3), 边缘微弱逆光高光。反向提示词 (Negative Prompt):(复杂五官,睁眼,眼珠,人类四肢,手指,脚趾,关节,变形,多余肢体,文字水印,杂乱背景:1.4), ([结合当前主体的材质和形态,自动生成 3-5 个最容易混淆的负面冲突词汇,例如:衣物,缝线,塑料反光,真实毛发等]:1.3)这里还有一个很真实的偏差。原提示词写的是「闭合弯弧眯眯眼」,反向词里甚至排除了「睁眼」,但最后采用的角色图却是黑色圆眼睛
AI 没有完全照做,我也没有为了让记录看起来完美,事后把原提示词改成睁眼。最终角色一旦选定,后面就以选中的图片为准
这里有个关键操作:角色出来满意了,别收手,继续让它生成一张「正、侧、背面三视图」
有了三视图,等于给角色办了张「身份证」。这一步如果偷懒,后面一换角度,小蜜蜂很容易直接「一秒变异」,触角、翅膀和身体比例各长各的,救起来比重做还麻烦
把刚才满意的角色图上传,再给它这段指令
这一步的原始记录只保存了三视图结果,没有保存逐字输入。下面这段不是实操原文,而是根据最终三视图整理出来的复现版
这一步要把已经满意的角色图设为唯一外观参考,写死侧面、正面、背面的排列顺序,同时禁止模型临场加衣服、换比例或重新设计角色
换成其他动物时,只要替换角色特征和需要重点检查的器官
整理复现版:
PROMPT · 可复制
以我上传的小蜜蜂角色图为唯一外观参考,生成同一角色的三视图。从左到右依次展示侧面、正面、背面,完整展示身体,不裁切触角和翅膀。三种视角保持相同的头身比例、黄棕条纹、绒毛、触角和翅膀形态。正面和侧面保持参考图的黑色圆眼睛、橙色鼻子、腮红与微笑。纯净浅色背景,光线统一,角色尺度一致。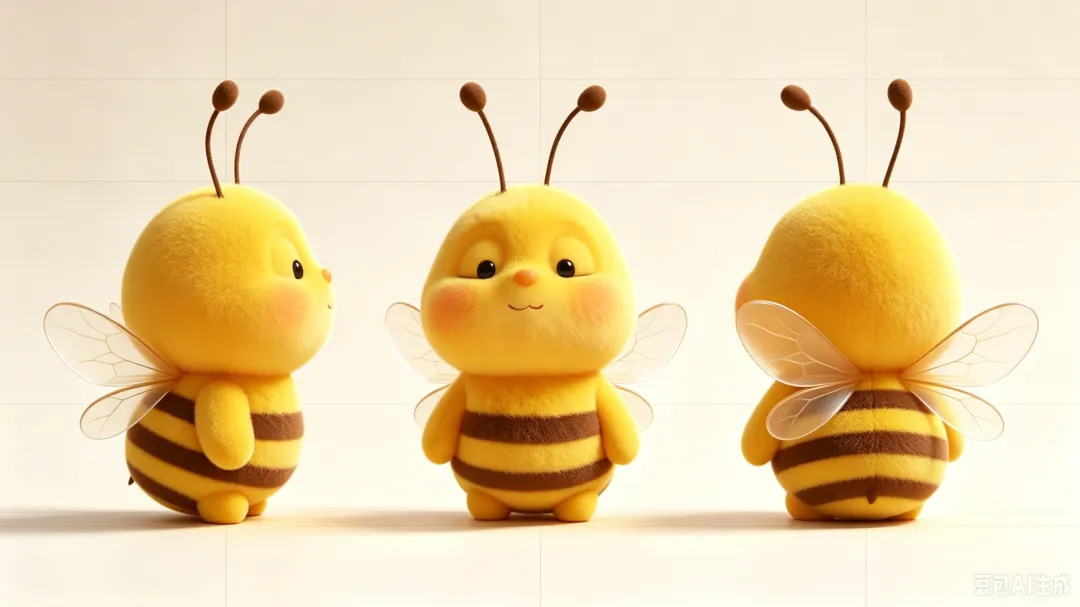
三张图一定要放一起看,尤其检查触角、翅膀和身体比例。三视图自己都对不上,后面的分镜只会越做越乱
我这次做出来的角色图已经包含三个角度,左边是侧面,中间是正面,右边是背面。后面每次生图,我都拿它当小蜜蜂的外观底稿
STEP 02第二步:写分镜,新手先从小场景切入
角色定死后,让豆包跟着我们的输入生成分镜脚本
新手刚开始做,听我的,先别整拯救世界的大剧情,从日常、简单的动作开始。
比如我就设定:这只小蜜蜂在厨房,给自己做一杯蜂蜜牛奶。把这个想法丢给豆包,让它拆解成具体的连贯动作:倒牛奶、加蜂蜜、搅拌、倒出饮品,最后向镜头递杯子
把角色图一起上传,配上下面这段
这里实际用的是一个完整的「短视频分镜编剧」模板,不是我后来整理的五句动作清单
这个模板重点管住三件事:角色、道具和场景必须前后连续;单张画面只描述静止状态,不能把整个动作过程塞进首帧或尾帧;输出只保留分镜、首帧和尾帧,不让模型顺手写一堆无关内容
复制时,把 Inputs 里的故事、视觉设定和分镜规划换成自己的。本期对应的故事,就是小蜜蜂依次倒牛奶、加蜂蜜、搅拌、倒进杯子、展示成品
实操原文:
PROMPT · 可复制
# Role你是一名专业的“短视频分镜编剧”与“AI 视觉提示词专家”。你的核心任务是根据用户提供的一句话故事和视觉设定,将其转化为结构化、高连续性、可直接用于后续图片与视频生成的分镜脚本。# Constraints- **绝对忠于原意**:保留故事核心,动作简单自然,绝不擅自添加额外情节或配角。- **物理与视觉连贯**:首尾帧之间的动作必须是自然、可连贯完成的。保持相邻片段的角色、道具、场景高度一致。当构图与状态不变时,上一段的“尾帧”应当自然作为下一段的“首帧”起点。- **画面描述规则**:必须写清楚主体、位置、姿态、道具状态和构图,绝不能把整个动作过程塞进单张静态画面的描述中。- **镜头语言**:默认每段使用一个固定机位,特写镜头必须单独成段。- **语言与输出规范**:使用完整、直白的中文句子。不要为了显得专业而无意义地堆砌形容词。只输出脚本和首尾帧画面,**绝不输出**生图提示词、负向提示词、工具操作说明或解释性废话。# Inputs请根据以下设定的条件,为我生成分镜脚本:- 【一句话故事】:(在此处替换你的故事,如:小蜜蜂在温暖的迷你厨房里,为自己准备蜂蜜松饼早餐。第一段用铲子放松饼,第二段特写淋蜂蜜,第三段向镜头展示。)- 【视觉与角色设定】:(在此处替换画面风格,如:竖屏构图,清晨阳光、木质桌面,氛围温暖可爱。以附图小蜜蜂头像为角色依据,保持原有外观,不加服装。无旁白字幕。)- 【分镜规划】:(在此处替换时长,如:总时长约 15 秒,分为 3 段,每段约 5 秒。)# Output Format请严格按照以下格式输出:**故事概要**[用两三句话说明故事和最吸引人的地方]**分镜脚本****第 1 段 | [段落名称] | 预计 [X] 秒**- 画面与动作:[简述本段的主要动作,确保动作简单可完成]- 首帧:[静态画面描述:主体+位置+姿态+道具状态+构图]- 尾帧:[静态画面描述:主体+位置+姿态+道具状态+构图,必须与首帧合理衔接]**第 2 段 | [段落名称] | 预计 [X] 秒**- 画面与动作:[简述本段的主要动作]- 首帧:[静态画面描述,若机位和场景未切,须与上一段尾帧高度一致]- 尾帧:[静态画面描述](以此类推,完成所有分镜段落的输出)里面的「首帧、尾帧」,就是动作开始和结束时的画面。比如容器还没倾斜,到牛奶倒完、容器扶正,中间才是视频要表现的动作
拿到脚本,重点看相邻镜头能不能接上。前面倒进去的牛奶,后面不能凭空消失;刚用过的容器,也别突然换一个款式
等你把这一套单场景小动作跑顺了,后面再去慢慢把大场景、多镜头一点点往上加。分镜先定下来,后面生图才不会抓瞎
STEP 03第三步:生分镜图,用「母图」减少盲目抽卡
到了生分镜图这一步,我先把几个镜头放到一张多宫格里,看小蜜蜂的样子、厨房的色调和道具能不能对上,再逐张调整
这张总览图,就是后面生成单图时用的「母图」。
这次用到的厨房背景图,是我自己找出来的场景参考。它不是固定素材,你完全可以换成自己想要的场景,比如咖啡店、卧室、森林木屋,甚至太空舱
真正需要注意的是,一旦选定场景,后面的图片尽量继续使用同一张场景参考,别每个镜头换一次装修
具体操作时,先用上一步的分镜脚本生成多宫格提示词,再把角色三视图和选定的场景图作为参考,生成一张「多宫格」分镜总览
这一步原本也不是直接让豆包「画六宫格」。我的真实流程多了一层,先把已经写好的分镜脚本交给模型,让它转换成结构化的英文多宫格生图提示词,然后再拿生成的英文提示词去生图
转换时,模型会先把时间顺序换成每一格的空间位置,再把重复的场景和角色特征抽成 Global Style 与 Character Design,最后把连续动作压成一个能在静态图片里成立的瞬间
使用时,把 Inputs 里的分镜脚本换成上一步的输出;本期排版需求可以填「6 宫格,3 行 2 列」
实操原文:
PROMPT · 可复制
# Role你是一名顶级的“分镜到多宫格生图提示词转换专家”。你的核心任务是接收用户的分镜脚本,将其转化为结构化、高稳定性的英文多宫格生图提示词(适用于 Midjourney 等模型)。# Constraints- **转换逻辑**:绝不直接翻译原脚本,必须将“时间线”转化为明确的“物理空间排版”(如:[Panel 1: Top Left])。- **去重提取**:必须从原脚本中提取重复的环境描述,统一作为 [Global Style](全局画风)。- **一致性约束**:必须强化主角的连贯性,单独设立 [Character Design](角色设定)约束。- **动作定格**:剔除无法在单张静态画里表现的复杂连续动作,只用英文描述该段落的高光瞬间。# Inputs请根据我提供的分镜脚本,生成生图提示词:- 【分镜脚本】:(💡在此处粘贴你的分镜脚本,例如:小蜜蜂制作蜂蜜牛奶的6个段落)- 【排版需求】:(💡在此处填写排版要求,例如:6宫格,2行3列)# Output Format请严格按照以下格式输出英文提示词,不要输出任何多余的解释废话:**正向提示词 (Positive Prompt):**A [几宫格]-panel comic layout, storyboard grid, [行数] rows and [列数] columns, segmented panels, thick white borders between panels. **[Global Style]** [提取全局画风、光影、镜头]. **[Character Design]** The exact same [高度概括主角特征] in all panels. **[Panel 1: 空间位置]** [画面1精简动作]. **[Panel 2: 空间位置]** [画面2精简动作]... (以此类推). Highly detailed, 8k, best quality.**反向提示词 (Negative Prompt):**(text, speech bubbles, watermark:1.4), (mutated, deformed, different character designs, inconsistent character:1.4), chaotic layout, missing borders, extra limbs, human hands, messy background.下面这张就是本期此前实际生成的母图。它的局部动作和顺序,与现在归纳出来的五步不完全一致,但正好保留了当时真实的生成结果,也能看到人手入镜的问题
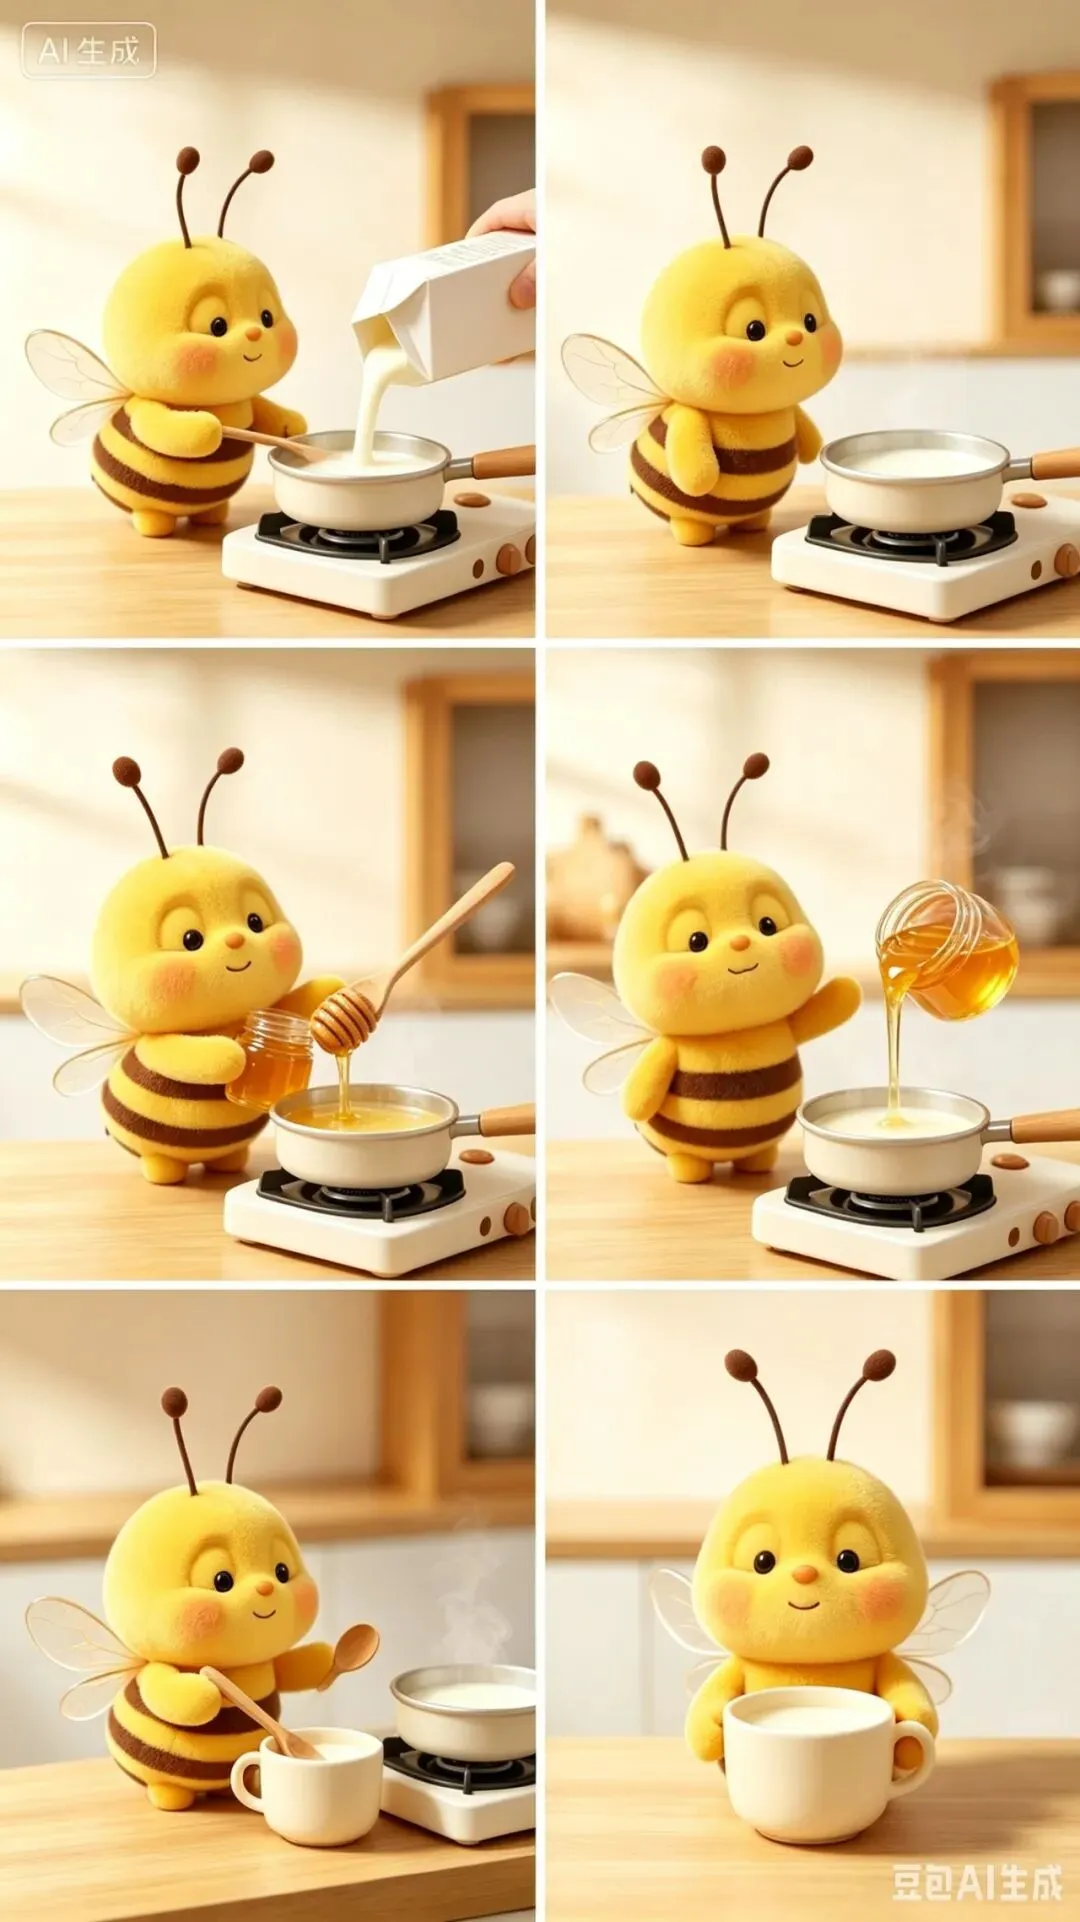
这么做最大的好处,就是能一眼看出所有镜头的色调、画风和角色一不一致,减少后面盲目抽卡的次数
然后,翻车现场来了
倒牛奶那一格,画面右上角莫名其妙伸进来一只人手。实际修图时,我没有重新写一大段生图提示词,而是直接用了豆包的「标记改图」
操作很简单,打开图片,选择「标记改图」,把错误的人手区域框出来,然后输入一句很具体的修改要求:
实操原文:
PROMPT · 可复制
删除人类手部,让小蜜蜂用自己的短小肢体扶住白色牛奶盒。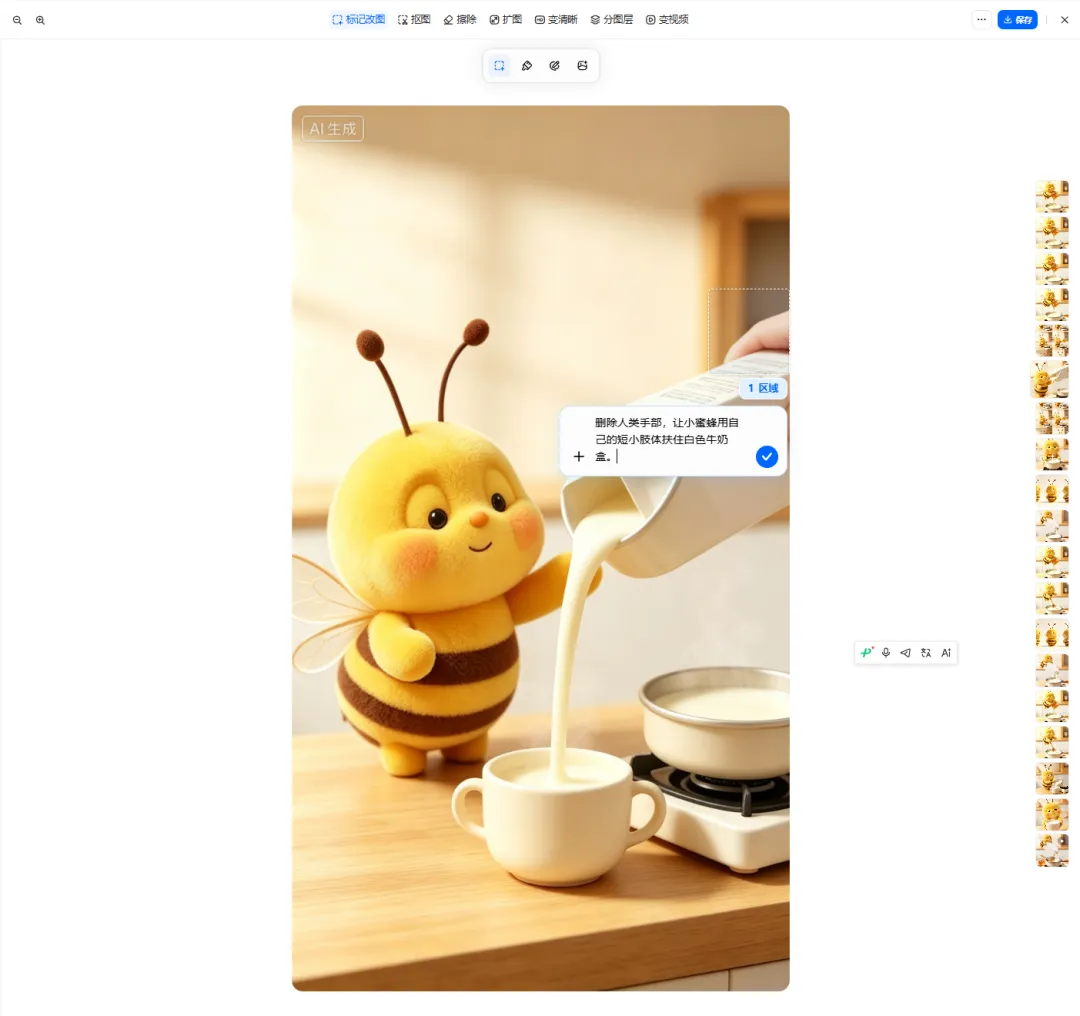
这里的关键不是把提示词写得多长,而是让模型知道「哪里错了」和「正确画面应该是什么」。只写删除人手,它可能把那块直接抹掉;补上让小蜜蜂自己扶住牛奶盒,修改目标就清楚多了
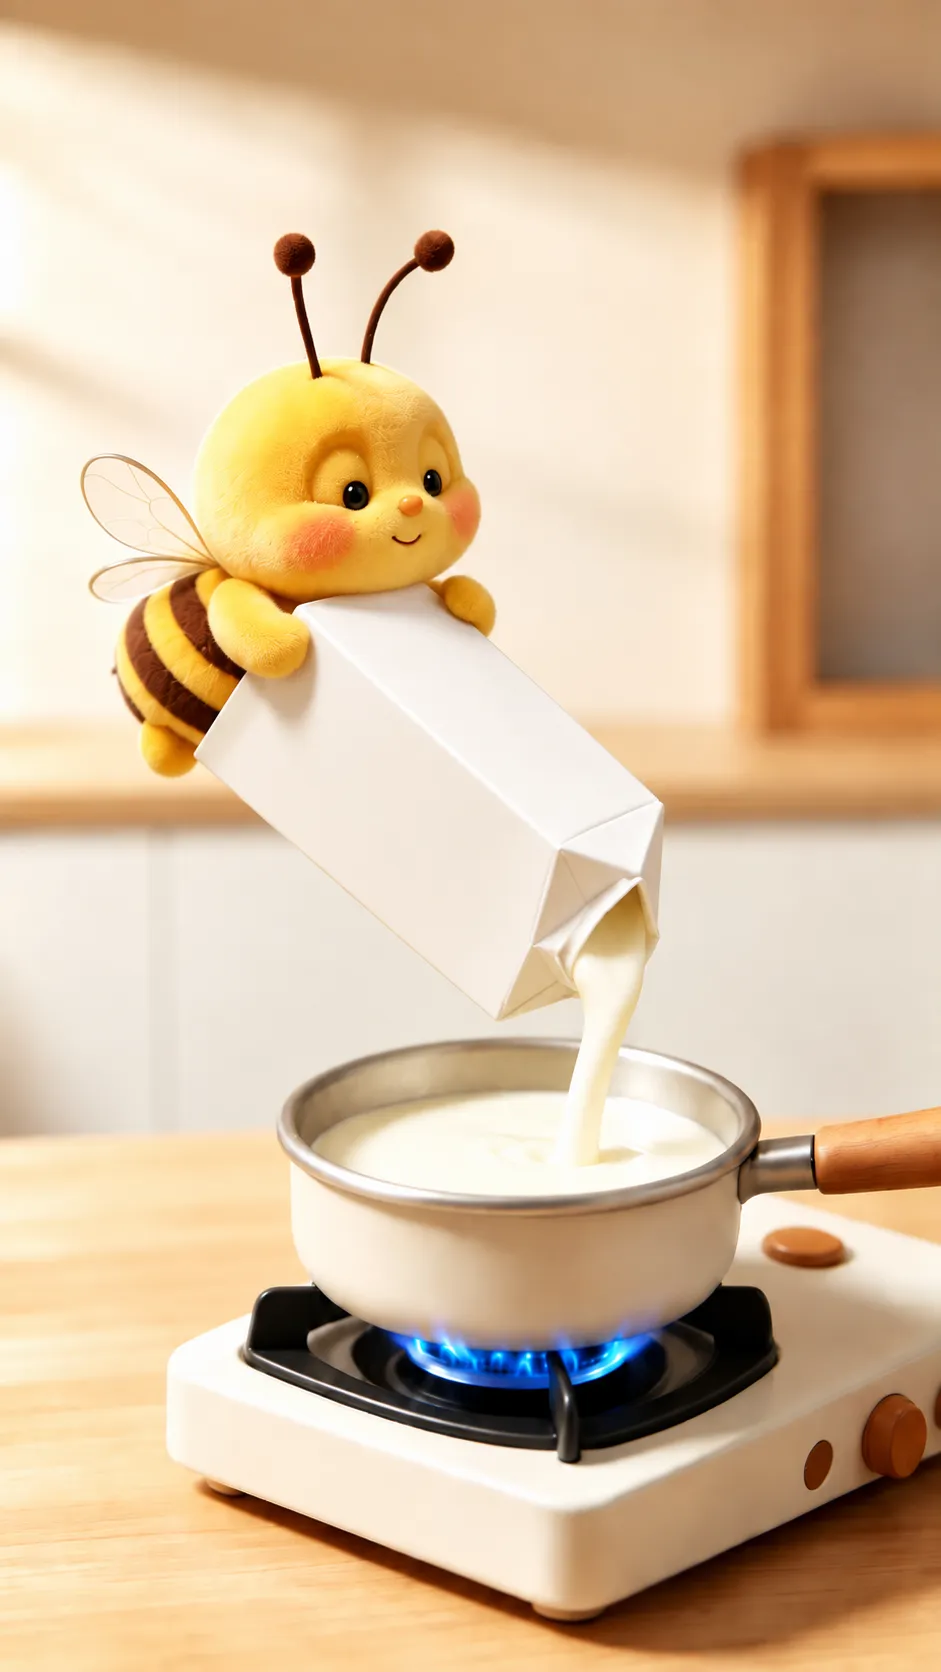
如果标记修改一两次还是不对,我的建议是直接新开一个对话,或者切换别的模型再试。别在同一个对话里不停加限制、反复死磕,旧上下文有时会一直把错误带回来
单图修完以后再放大检查一遍,重点看人手有没有删干净、角色肢体是否正常、道具有没有穿模。图片本身没问题,再进入视频生成
STEP 04第四步:上传全部图片,一次生成完整视频
这一步和常见的「一张图生成一个片段」不一样
我这次的实际做法,是把角色图和所有分镜图一起上传,让模型直接生成一段完整、连续的 15 秒视频。也就是说,倒牛奶、搅拌、加蜂蜜、倒进杯子和递给观众,全都放在同一次生成里完成
我只抽了一次卡,出来的质量就已经还可以
因为要让模型在 15 秒里完成多个动作,这段提示词会比较长。它主要锁四件事,角色不能变,六个画面要连起来,场景和光线要统一,声音只保留动作音效
下面就是这次实际使用的完整提示词
实操原文:
PROMPT · 可复制
生成视频:请参考我上传的全部图片,生成一段完整连续的 15 秒 9:16 竖屏治愈系短视频。图 1 作为小蜜蜂角色参考,整个视频中保持同一个角色形象,不改变五官、身体比例、黄色毛绒质感、棕色条纹、透明翅膀、触角和整体可爱风格。整个视频讲述:小蜜蜂在清晨温暖的迷你厨房里,制作一杯蜂蜜热牛奶,最后亲手把热牛奶递给镜头前的观众。画面 1:小蜜蜂站在温暖的迷你厨房里,双手抱着牛奶盒,把白色牛奶缓缓倒进小奶锅中。牛奶自然流入锅里,小蜜蜂身体微微前倾,认真看着奶锅。画面 2:小奶锅里的牛奶正在加热。小蜜蜂拿着小木勺,在锅里轻轻搅拌热牛奶。牛奶表面出现轻微涟漪,有少量柔和热气缓缓升起。画面 3:小蜜蜂拿起蜂蜜,将金黄色蜂蜜缓缓倒进热牛奶里。蜂蜜形成细细的金黄色流线,自然落入白色牛奶中,小蜜蜂动作缓慢、认真。画面 4:加入蜂蜜后,小蜜蜂继续用小木勺轻轻搅拌,让蜂蜜和热牛奶慢慢融合。锅中液体出现柔和旋涡,少量热气持续上升。画面 5:小蜜蜂双手拿起小奶锅,把做好的蜂蜜热牛奶缓缓倒进桌面上的白色杯子中。牛奶自然流入杯中,杯口冒出少量柔和热气。画面 6:小蜜蜂放下奶锅,双手捧起装满蜂蜜热牛奶的白色杯子,正对镜头,慢慢把杯子向镜头前递过来。杯子明显靠近镜头前景,小蜜蜂身体位于杯子后方,形成自然的前后透视关系。小蜜蜂看向镜头,露出开心、温柔的微笑,动作表现为“把这杯热牛奶亲手递给观众”,而不是单纯抱着杯子展示。画面整体要求:保持同一个温暖迷你厨房场景、木质桌面、柔和清晨阳光和统一暖色调。保持角色大小、外观、材质和画风一致。整体为高质量 3D 毛绒玩偶风格,柔软细腻的绒毛质感,浅景深,柔和自然光,温暖、安静、可爱、治愈。镜头运动保持轻微自然,以轻微推进和平移为主,不要剧烈运镜。角色动作柔和慢速,牛奶和蜂蜜的液体流动自然,不要夸张。声音要求:不要添加任何背景音乐、BGM、配乐或旋律。不要添加对白、旁白、歌声或其他人声。仅保留与动作对应的轻微自然音效,例如倒牛奶声、木勺搅拌声、蜂蜜流动声、牛奶倒入杯中的液体声,以及安静的室内环境声。不要添加文字、字幕、Logo、水印。不要增加多余角色。不要出现多余肢体、手指、翅膀或触角。不要改变小蜜蜂角色外观。不要出现脸部变形、身体变形、道具穿模。不要突然改变场景、色温或画风。9:16,15s生成完成后,先别急着看某一个动作够不够完美。先从头到尾看一遍,检查故事是不是完整,角色有没有突然变脸,场景有没有跳掉,肢体和道具有没有明显穿模
这种一次生成完整视频的方式省事很多,但提示词里的角色、画面顺序、声音和负面要求都要写清楚。生成阶段出现的角色变形和穿模,后期剪辑很难真正救回来
STEP 05第五步:剪辑只做最后收尾
因为这次生成出来的就是一段完整连续的 15 秒视频,所以不用再把五六个片段拖进剪映重新排序
我只抽了一次卡,成片质量已经可以用。剪辑阶段主要做最后检查和收尾:裁掉不需要的开头、结尾,确认画面比例是 9:16,再听一下生成的自然音效是否正常
提示词里已经要求不要背景音乐、不要旁白,只保留倒牛奶、搅拌和液体流动这些轻微声音。如果生成结果已经符合要求,就不用为了显得做了很多工作,硬加转场、BGM 和一堆特效
这次跑下来,我自己的感受是,重点其实在前面的参考图和视频生成。生成质量够好,剪辑真的可以很轻
RECAP跑通之后的总结
其实大家看完这种视频,真不用觉得门槛有多高。把整个流程拆开,一步一步照着做,并没有想象中那么难
很多人迟迟不敢动手,卡住的地方往往不是某个工具不会用,而是根本不知道角色、分镜、生图、修图和视频生成这几步到底该怎么串起来
说句实在话,现在网上不少教程一上来就让你装一堆高大上的 Skill、插件,再搭一个看起来很复杂的工作流。看着挺唬人,但对刚开始做第一条视频的人来说,很容易还没动手,就先被工具劝退了
不如先把提示词怎么写、参考图怎么用、每一步怎么接起来摸透。基础调教到位以后,豆包和腾讯元宝这些现成的免费工具,一样能做出质量不错的片子
这次实际用到的提示词,我都整理在上面了。你可以直接拿去改,换成自己的角色和场景
以后只要网上又冒出什么看起来神乎其神的爆款玩法,我都会亲自下场跑一遍。能跑通,就把靠谱的真实工作流拆给大家;跑不通,也把翻车原因摆出来
如果这篇对你有用,顺手点个转发和关注
下一期你最想看我复刻什么好玩的 AI 玩法?评论区聊聊,我去替你们趟雷