ARTICLE · 1035037
买到 GPU 还不够,AI 公司下半场开始“抢电”了
买到 GPU 还不够,AI 公司下半场开始“抢电”了9 月 16 日,Google、NVIDIA 和 Emerald AI 软件公司联合推动了一个新联盟:AI Energy Management Alliance (AEMA, AI 能源管理联盟)。它讨论的不是怎么给 AI 再造一座电厂,而是另一个更反常识的问题:能不能让数据中心自己学会在电网最紧张的时候少用一点电? 这件事之所以值得关注,是因为 AI 基础设施的瓶颈正在发生变化。过去一年,行业最常讨论的是 GPU、HBM 和网络带宽;现在,越来越多项目开始被另一个更常见的指标卡住:电什么时候能接上。
美国现在面对的并不是简单的“全国没电”。真正的约束更分散,也更难处理:发电能力、输电线路、变电站、配电设备、并网审批和高峰时段容量,任何一个环节跟不上,都可能让一座已经买好服务器的数据中心继续等。 所以电力行业和数据中心行业开始频繁使用一个词:Speed to Power (电力交付效率)。谁能更快获得稳定、可交付的百兆瓦甚至吉瓦级电力,谁就能更快把 GPU 变成真正上线的算力。 美国联邦能源监管委员会 FERC 今年 6 月已经把这个问题写进监管动作里。FERC 要求六大区域电网运营机构重新解释或修改大型负荷接入规则,范围明确包括数据中心,并把“Speed to Power”直接写进目标。换句话说,AI 数据中心如何接入电网,正在从企业选址问题变成电力制度问题。 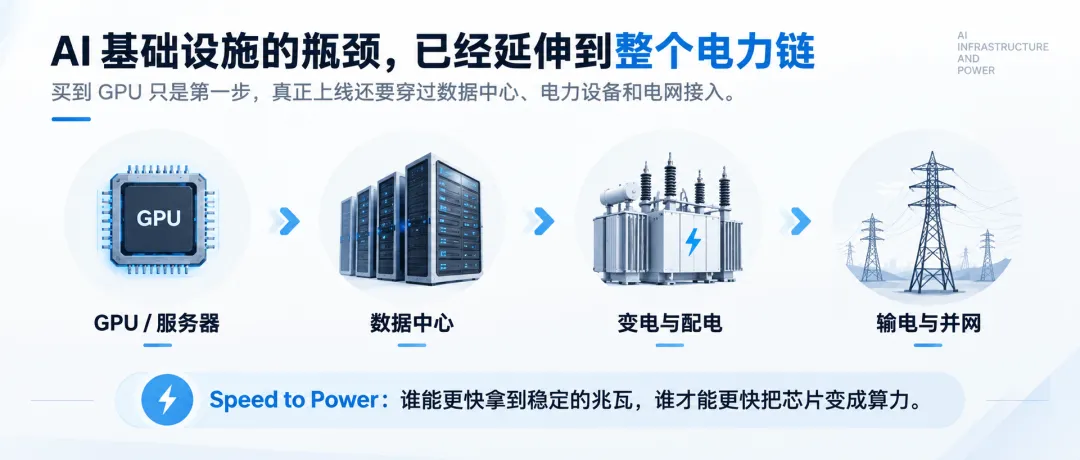
需求增长也在加速。EPRI 2026 年版《Powering Intelligence》估计,美国数据中心目前约占全国用电量的 4%—5%,到 2030 年可能升到 9%—17%。这个预测区间比 EPRI 2024 年版本高约 60%。 全球层面,IEA 的最新展望也给出类似方向:数据中心用电量可能从 2025 年约 485 TWh 增长到 2030 年约 950 TWh,其中 AI 专用数据中心的电力消耗增长更快,预计同期约增至三倍。IEA 同时提醒,电网和电力设备等瓶颈可能让部分数据中心项目延迟。 电网有一个天然矛盾:系统必须为一年中最难熬的那些高峰时刻准备容量,但大量基础设施在其他时间并没有满载。如果一个超大数据中心能够在极少数高峰时段主动降低一部分负荷,电网就可能在不立刻扩建全部基础设施的情况下,先接入更多新增负荷。 杜克大学尼古拉斯研究所 (Nicholas Institute) 的研究给出了一个很直观的模型结果。研究覆盖美国 22 个主要电力平衡区,估算如果大型新增负荷全年平均只允许被削减 0.25% 的运行时间,现有系统理论上可以增加约 76 GW 新负荷;如果削减率提高到 0.5%,理论空间约为 98 GW。 这里必须强调:98 GW 不是美国已经“多出”的电,也不是一个已经释放的现实容量。它是模型推算出的“可调节负荷容纳空间”。研究中 0.5% 情景下,平均一次调整约持续 2.1 小时,而且接近 90% 的需调整时段仍能保留至少一半新增负荷。 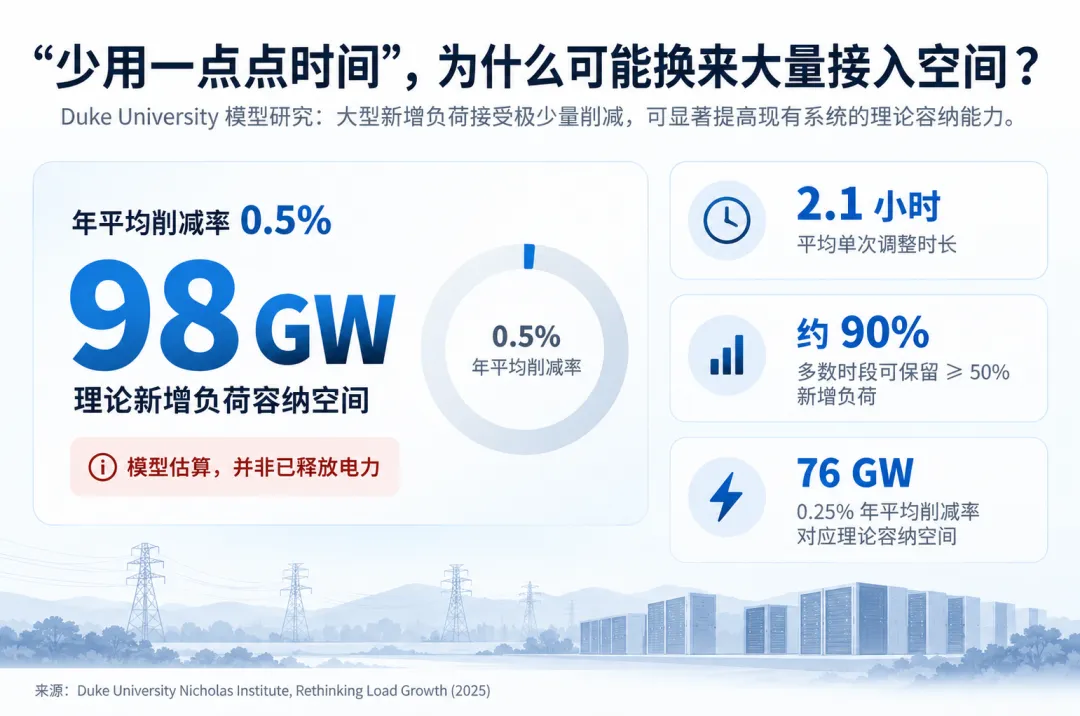
这也是 AEMA 这次成立真正想推动的东西:让数据中心不再只是一个固定的巨大负荷,而是变成能够被验证、被调度、可预测响应的“弹性负荷”。联盟希望进一步定义响应速度、持续时间、可预测性和紧急状态下的行为标准,让这种灵活性有机会换来更快的并网速度。 Google 今年 3 月披露,公司已经把累计 1 GW 的数据中心需求响应能力写进与美国多家公用事业公司的长期能源合同。做法不是简单“关机”,而是限制或转移一部分机器学习任务,让电网在高负荷时段得到喘息。 这件事的边界也很清楚。批处理、训练、数据处理等任务更容易延后;搜索、地图、大量在线推理和对延迟敏感的云业务不能随便停。未来所谓“可调度 AI”,更像是调整任务组合、功率和执行时间,而不是粗暴地拔掉服务器电源。 在加利福尼亚州圣克拉拉市的商业规模项目里,硅谷电力 (Silicon Valley Power) 向 NVIDIA 使用的 AI 集群发送降载信号,Emerald AI 的 Conductor 软件自动调整任务优先级:可等待任务放慢或延后,高优先级任务继续运行。 NVIDIA 披露的一个现场实例中,数据中心功率从约 4 MW 降到 3 MW;之后 Silicon Valley Power 又发送了 200 多次需求信号,系统均完成响应。这个结果目前主要来自项目参与方披露,可以把它看作商业化验证的尝试。 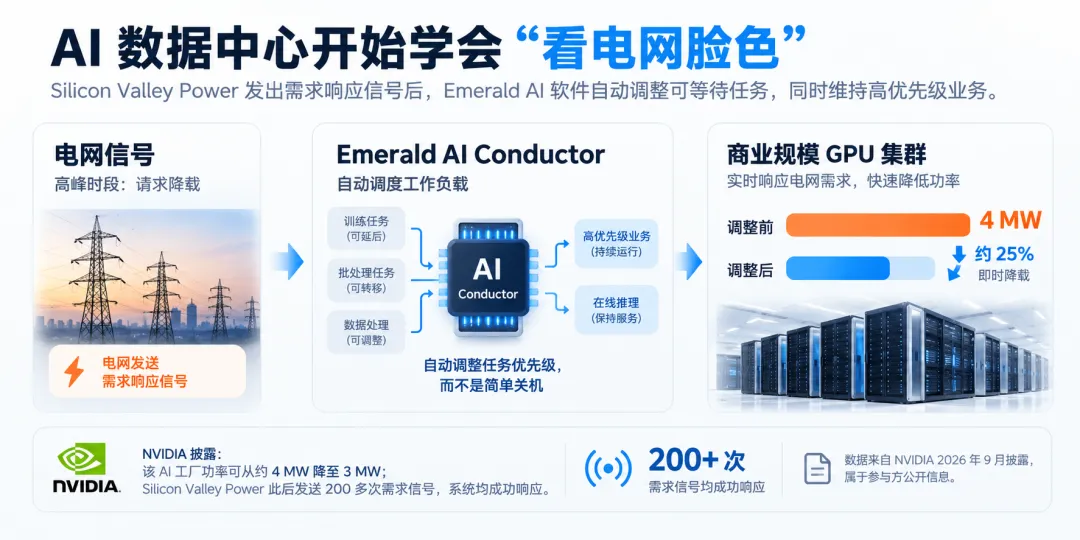
NVIDIA 现在还把这种能力做进 DSX Flex。其思路是让 AI 数据中心接收限电、需求响应、电价等信号,再自动调整工作负载和现场能源。公司计划在弗吉尼亚的一座约 96 MW 的 Vera Rubin AI 工厂部署这一模式。 以前谈 AI 基础设施,最直观的数字是 GPU 数量、训练 FLOPS、参数量和网络带宽。现在另一些指标开始进入同一张表:多久能获得 100 MW 电力、一个园区能调节多少负荷、每兆瓦到底能产出多少有效 Token (词元)。 这并不代表 GPU 不再稀缺,也不代表电力已经成为唯一瓶颈。芯片、HBM、网络、变压器、审批、资本和工程能力仍然同时约束 AI 基础设施扩张。变化在于:当 GPU 供应增加、单个园区规模继续上升,电力系统开始从“后台条件”变成需要和计算系统一起设计的核心组件。 美国能源部 2026 年《National Transmission Needs Study》也把这种变化写得很直白:美国电力系统正在从长期需求相对平稳的时代,进入由超大规模 AI 数据中心、制造业和电气化共同推动的快速负荷增长阶段,需要更多输电基础设施。
所以,“AI 缺电”真正值得关注地方,不仅是电价的波动,还是算力和能源开始被放进同一套基础设施设计里。过去科技公司采购的是芯片和服务器;接下来,它们还必须采购、调度甚至共同建设兆瓦级电力能力。 当 GPU 越来越多,真正稀缺的东西,正在变成可以按期交付、稳定运行、还能灵活调度的电量。
买到 GPU,为什么还可能开不了机?
最反常识的解法:不是先造更多电,而是让算力会“让路”
先手:Google 已经签下 1 GW
NVIDIA 更进一步:直接让 GPU 集群听懂电网信号