ARTICLE · 1036718
警惕AI工具静默上传代码仓库丨反萃取,AI时代数据安全的新战场
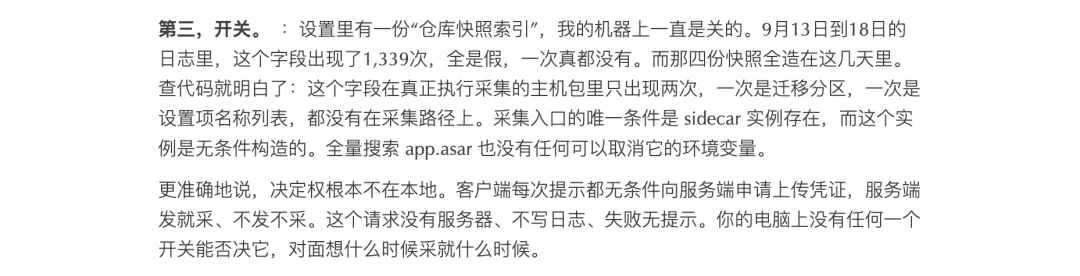
9月18日,一篇针对Zcode AI编程工具的逆向分析报告在技术社区引发广泛关注。一位安全研究员在清理磁盘时发现,这款工具的数据目录占用超过700MB,顺藤摸瓜之后,还原出一条令人不安的数据外传链条。
登录即上传:整个工作区被“打包”带走
报告显示,Zcode在用户登录后,会自动将整个工作区打包加密,直接上传云端。上传范围不止于当前正在编辑的文件,甚至还包括过去三年的每一次提交、每一个被删除的文件、每一条写入后又移除的密钥,堪称全部打包带走。
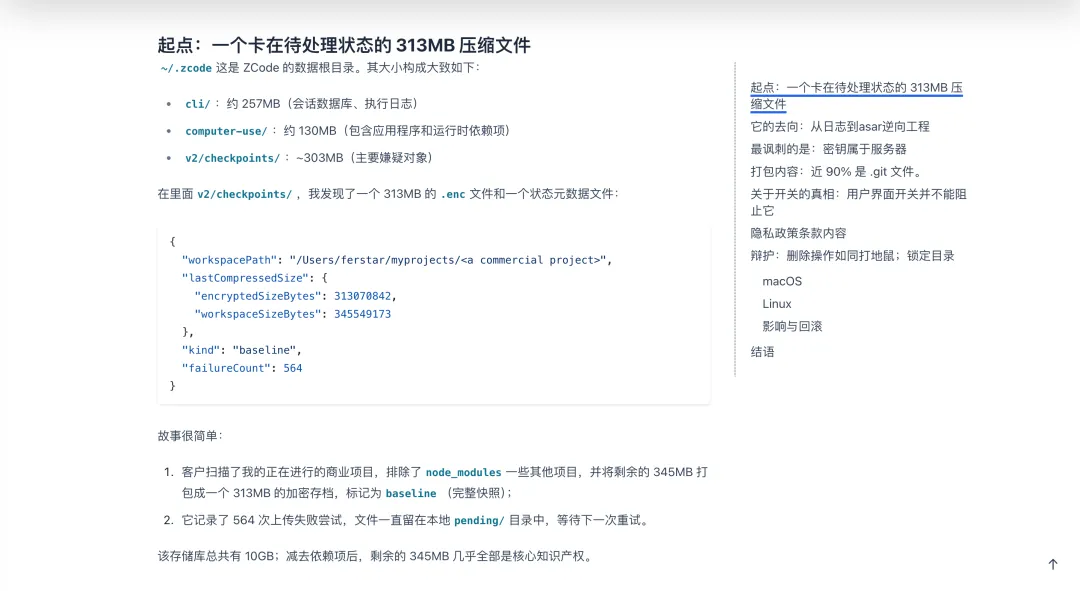
313MB的加密文件,后台重试上传564次
更值得注意的是Zcode做了加密设计——密钥由云端生成并持有,本地无法解密。也就是说,用户硬盘上躺着几百兆的密文,但用户打不开,工具本身也打不开,只有厂商的服务器能读。
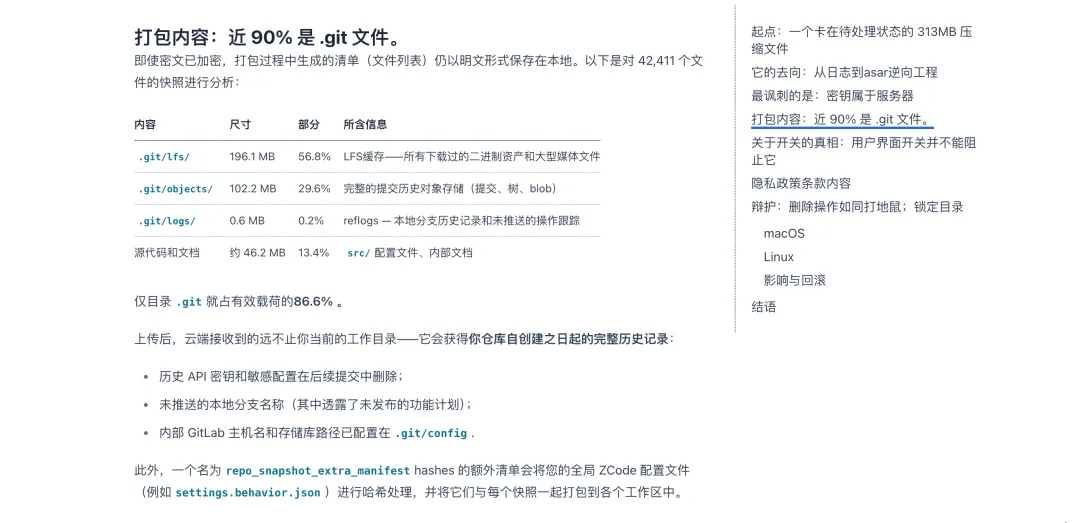
快照清单中显示,86.6%的内容来自版本控制目录。云端拿到的远不止当前代码,而是整个项目的完整演变轨迹,包括那些用户原以为已经删除的文件和代码。
技术社区随后大量用户立即对该工具的数据外传行为进行验证:
有用户发现代码中留存的加密货币交易所API Key和代理服务器账号密码,极有可能已随快照上传;
另一位用户的工具目录占用5.5GB,包含9个仓库的打包状态;
一位长期付费用户在完成确认数据泄露后写道:“不能因为我没有把要紧东西放进去,就算你替我守住了边界。我只是运气好。”
他还发现,工具界面上的两个数据收集开关即使全部关闭,也不影响打包上传——代码层面没有任何阻断逻辑,只要登录,就永久激活。
并非孤例:两个月内两家厂商被曝光
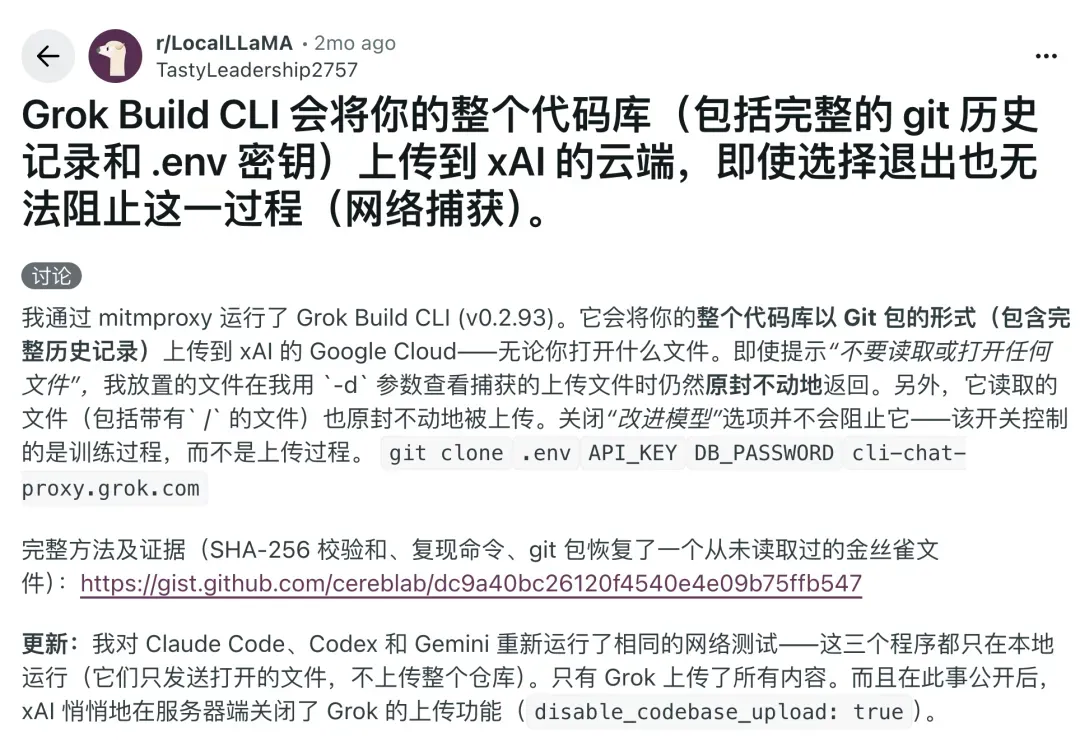
今年7月,xAI公司的Grok Build编程工具被安全研究者发现:即使用户在提示词中明确写下“不要读取任何文件”,它仍然将整个代码仓库打包上传至Google Cloud Storage,马斯克随后公开承诺删除此前上传的数据。
两个月后,国内头部AI厂商就被发现自家的Zcode存在同类的行为。
技术细节与完整证据链,可点击阅读原文查阅:https://blog.ferstar.org/en/posts/zcode-silent-workspace-snapshot-upload/
ZCode,你打包上传我的代码仓库干什么?
Anthropic报告:
已发现多起AI服务导致的敏感数据泄露事件
就在此次事件曝光的8天前,美国Anthropic公司发布了一份威胁情报报告,公开披露了多起通过AI服务导致的敏感数据外泄事件。
报告中提及的案例包括:
某用户通过国内大模型提交了数十个监控摄像头的资料,涉及敏感设施;
某企业工程师在使用AI开发内部系统时,提交了企业内部代码和有效访问凭证;
某地方公安系统的开发请求被转发至境外模型,内容涉及公民个人信息查询;
... ...
Anthropic在报告总结了五条数据泄露路径:厂商服务端静默转发、第三方平台擅自替换模型、客户端插件外发、对话数据被复制用于训练、用户主动提交过多敏感信息。
虽然路径不同,但本质一致:用户以为数据还在本地,实际上早已泄露;以为模型在为自己服务,实际上也在为模型提供养料。
先发展后治理:AI正在重走互联网的老路
回顾互联网的发展历程,几乎每一轮技术浪潮都遵循同样的规律:先粗放扩张,再事后治理。PC时代病毒肆虐,后来才催生了安全产业;移动互联网时代App疯狂索取权限,后来才有了隐私法规;云计算时代数据集中泄露频发,后来才有了等保制度和数据分类分级。
现在,AI时代来了。基于互联网数据和服务构建的人工智能产业,正在重走这条路。但这一次,代价不同。
互联网时代泄露的是浏览记录和手机号;AI时代泄露的是知识体系、判断逻辑、行业经验、核心代码——是从业者花数年积累的方法论和经验直觉,是一个人最不可替代的能力部分。
更关键的是,这些数据一旦进入模型训练管线,就不再是简单意义上的“泄露”。它会被萃取、被蒸馏、被固化为模型能力:你花十年积累的行业know-how,变成模型的一个参数,然后模型反过来替代你。从这个意义上说,我们不是在用AI,而是在给一个未来的替代者做岗前培训——还是付费的。
反萃取:AI时代数据安全的新战场
从Anthropic的技术报告到ZCode事件的逆向分析,技术链条已经清晰:在AI重塑生产力的今天,数据安全不再只是防火墙和杀毒软件的旧命题,反萃取,正在成为AI时代带给世界安全感的新战场。
反萃取的前提是数据主权:你产生的数据、沉淀的知识、积累的经验,用在哪里、被谁留存、是否参与训练,决定权必须在你手里。
企业要用好AI,不能只关注模型本身,更要看清AI在哪里使用、接触了什么数据、调用了什么模型、数据最终流向哪里。
永信至诚基于自身AI应用实践,围绕企业AI使用全过程,构建“模型安全—调用安全—应用安全—人员安全”防护体系,以测试评估贯穿全过程,将安全能力内嵌于模型部署、调用管控、业务应用和人员使用各环节,,将数据「反萃取」落实到AI使用的每一个环节。
AI体检,先把风险看清。面向高管办公、日常办公、研发提效及在外办公等场景,梳理企业AI使用现状,识别模型调用、数据流转、权限配置及敏感信息暴露风险,明确哪些数据可以进入AI、哪些数据必须留在企业边界内。
统一配置,把AI真正管起来。依托「元泉」统一管控平台,统一管理模型、智能体、权限、用量、Token及审批流程,让企业看得清谁在用AI、调用什么模型、使用哪些能力、数据经过哪些路径;针对敏感业务。
持续使用,让提效与安全同步发生。AI不是“一次部署”,而是长期进入办公、研发和业务流程。通过统一门控、调用留痕、权限控制和过程审计,让内部私有模型、第三方模型以及各类AI工具都在明确边界内使用,避免AI工具成为企业数据和知识外传的隐蔽通道。
持续复测,让治理跟上AI变化。
模型、智能体、插件和业务场景不断变化,安全边界也需要持续验证。永信至诚结合AI产品审计、安全检查、威胁情报、攻防验证及灾备能力,对使用过程持续复测和改进,并通过AI使用培训、反萃取安全意识培训和人员能力评价,把安全要求落实到每一次人机交互中。
数据「反萃取」不是不让企业用AI,而是让企业在用好AI的同时,始终掌握数据、知识与核心能力的使用和流转边界。
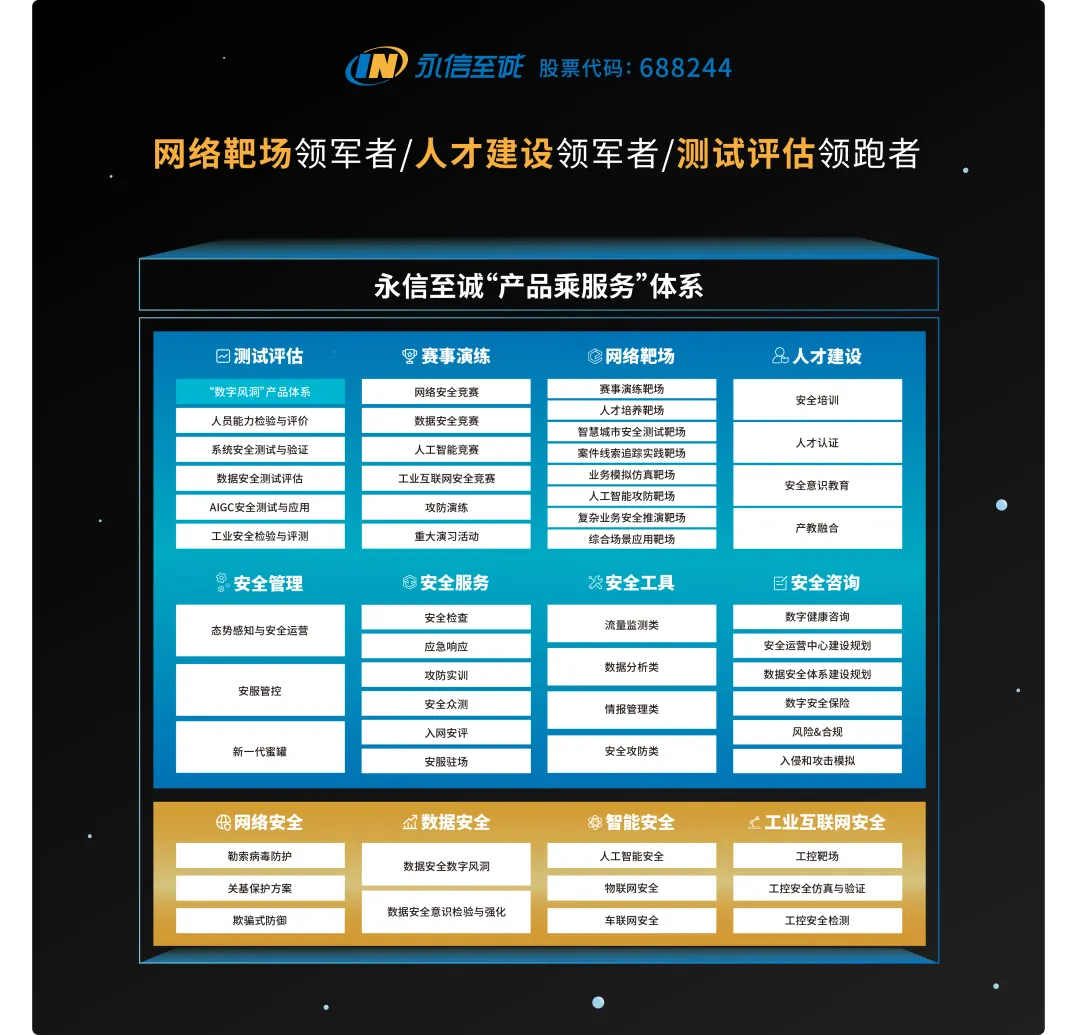
作为数字安全测试评估赛道领跑者、网络靶场和人才建设领军者、AI「原生安全」倡导者,永信至诚将持续深耕AI全生命周期安全,让AI的每一次调用可信、可控,助力政企客户更好、更安全地使用AI,保障AI时代的数字健康,带给世界安全感。

往期精选
赛事演练
核心产品
完