ARTICLE · 1038867
一份方案文档丢给灵犀 AI,一天变成 27 张表的多维表系统
先说个事。
9 月 18 日,客户给我一份《热处理工厂编码组件规划方案》,50 个组件码,写得挺认真,条理也清楚。我把它丢给灵犀,一天之后,出来一个27 张数据表的多维表系统——每张表有字段、有示例数据,点开就能看。
不是 PPT,不是架构图,是能跑的东西。
中间发生了什么,我拆开讲。
一、方案为什么落不了地
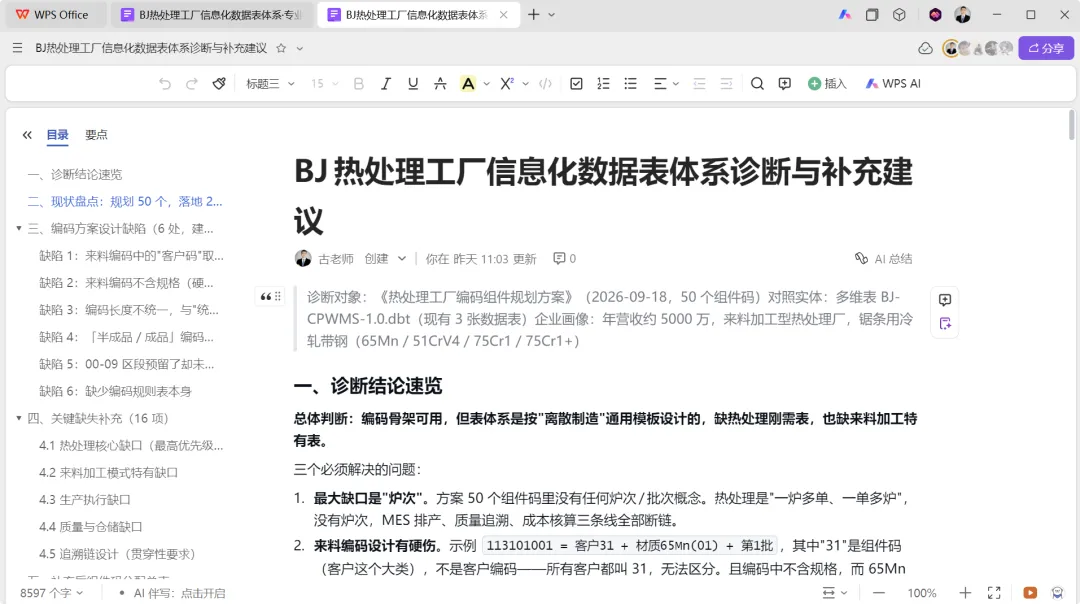
先看这家厂的底子:年营收 5000 万上下,来料加工型热处理厂,做锯条用的冷轧带钢,材质主要是 65Mn、51CrV4、75Cr1。
客户给的方案里规划了 50 个组件码,从 00 系统数据一路排到 99 预留区,看着挺全。
但对照实际建出来的多维表 BJ-CPWMS-1.0,是这样的:
现有数据表 | 记录数 | 状态 |
基础数据库 | 3 条(全空) | 空壳表,只有 1 个文本字段 |
客户明细表 | 6 条 | 字段偏薄,缺客户编码、结算方式 |
销售订单明细表 | 19 条 | 缺交期、订单状态、加工单价、来料状态 |
规划 50 个,落地 2 个,另一个是空壳。落地率 4%。
这不是这一家的问题。我见过太多工厂都是这个状态:方案写得漂亮,最后躺在文件夹里。
为什么?我的判断是——方案是给人看的,系统是给机器用的,中间缺一道翻译。
举两个具体的例子。
第一个,硬度要求是自由文本。
订单表里这一栏填的是 HRC47-48(47-47.5为最佳)、HRC45.5-46.5、HRC44-45.5。
人看没问题,一眼就懂。但程序判定不了合格不合格——括号里那句"47-47.5为最佳"是给人看的备注,不是数据。这栏得拆成三个数值字段:下限、上限、目标值。
第二个,工艺备注也是自由文本。
有一栏写的是"抛光、拉圆边、二次回火,韧性好,平整度、直线度较好,注意刮边(毛刺)、不能双翘边"。
一句话里塞了三类东西:工序(抛光、拉圆边、二次回火)、质量要求(韧性、平整度、直线度)、外观缺陷(刮边、翘边)。不拆开,排产排不了,计工计不了,工序负荷也统计不出来。
第三个最要命:整个方案里没有"炉次"。
热处理是"一炉多单、一单多炉"。没有炉次,MES 排产、质量追溯、成本核算三条线全断。客户来料以后问他这批货是哪一炉做的、谁做的、参数多少、硬度检测多少——答不上来。
所以卡住的不是没规划,是规划里缺了业务跑起来真正需要的那几根柱子。
二、第一步:让 AI 做诊断,别急着让它执行
很多人用 AI 是这样的:直接说"帮我建 50 张表"。结果表建出来不能用,因为地基是错的。
我的做法反过来:先让它诊断。
我把方案文档和多维表现有结构一起给灵犀,话是这么说的:
这是客户给的编码组件规划方案,这是现在实际建的多维表。你先别动手,帮我看三件事:一、方案和实际落地差多少;二、方案的编码设计有没有硬伤;三、按热处理这个行业,还缺哪些表。
它跑了 5 个命令,看了 2 个文件,编辑 1 个文件,给我一份诊断报告。
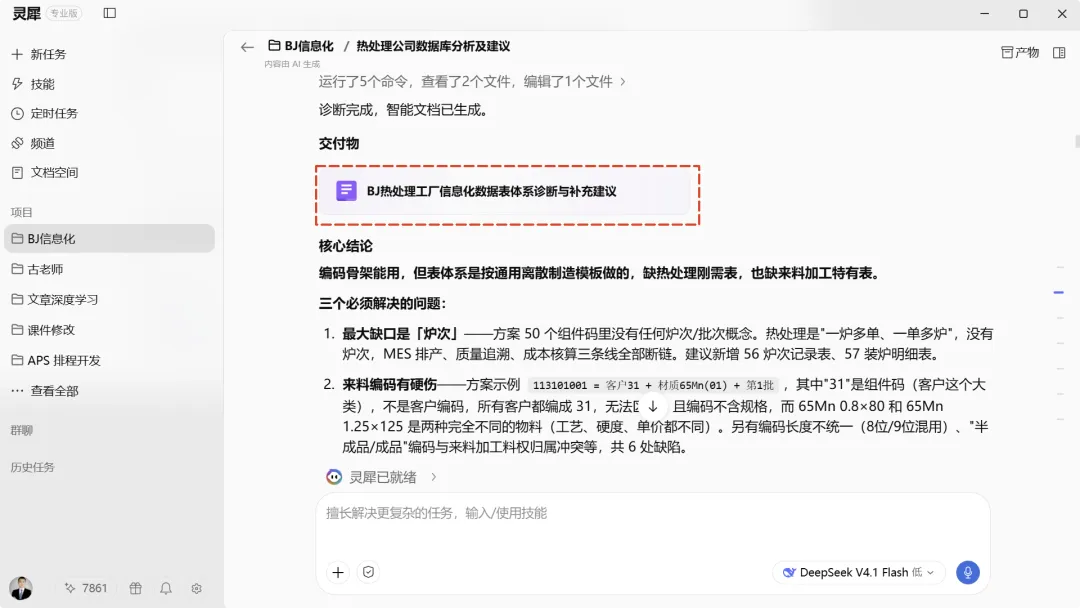
编码设计 6 处缺陷,其中 3 处是硬伤。
硬伤一,来料编码里的"客户码"取错位。
方案定义 11 + 客户码(2位) + 材质码(2位) + 流水号(3位),示例 113101001 = 客户31 + 材质65Mn(01) + 第1批。
问题出在"31"。31 是组件码,代表"客户"这个业务大类,不是某个客户的编码。所有客户都编成1131xxxxx,谁都分不清谁。
修正办法:取客户编码的流水部分。客户编码 31000001、31000002,来料编码就取末两位,变成 1101...、1102...。
硬伤二,来料编码不含规格。
热处理厂的物料唯一标识是材质 + 厚度 + 宽度。65Mn 0.8×80 和 65Mn 1.25×125,工艺参数、硬度公差、加工单价全不一样,这是两种物料,不是一个物料的两个尺寸。
修正:11 + 客户(2) + 材质(2) + 厚度码(2) + 宽度码(2) + 流水(2),65Mn / 0.8×80 就是 11 01 01 08 80 01。
硬伤三,编码长度不统一。
客户编码 8 位,销售订单 9 位,来料编码 9 位。方案自己写的是"统一 8 位或 10 位",实际一个都没对上。
修正:定死两类。主数据 8 位(组件码 2 + 流水 6),单据 12 位(组件码 2 + 年月 4 + 流水 6)。
另外三处是设计层面的:
缺的表补了 16 项。
按优先级排,最要紧的是 6 张:
建议新增 | 组件码 | 为什么 |
炉次记录表 | 56 | 热处理的最小生产单元,追溯和成本全挂在这一层 |
装炉明细表 | 57 | 炉次和工单、来料批次的多对多关系 |
工艺参数表 | 58 | 材质+规格+硬度要求 → 温度、保温时间、淬火介质、回火次数 |
排产计划表 | 59 | 按炉台排程、交期倒排 |
设备产能参数表 | 66 | 炉膛尺寸、最大装炉量、额定功率,没有它设备主数据没法排产 |
炉温均匀性记录 | 65 | 热处理行业强制要求,定期检测留证 |
来料加工特有的还有:受托物资台账(13)、加工费报价表(14)、重量损耗/得率记录(67)、对账单(49)。另外方案里只有领料退料,没有报工,报工记录表(68)是 MES 的核心数据,也补上了。
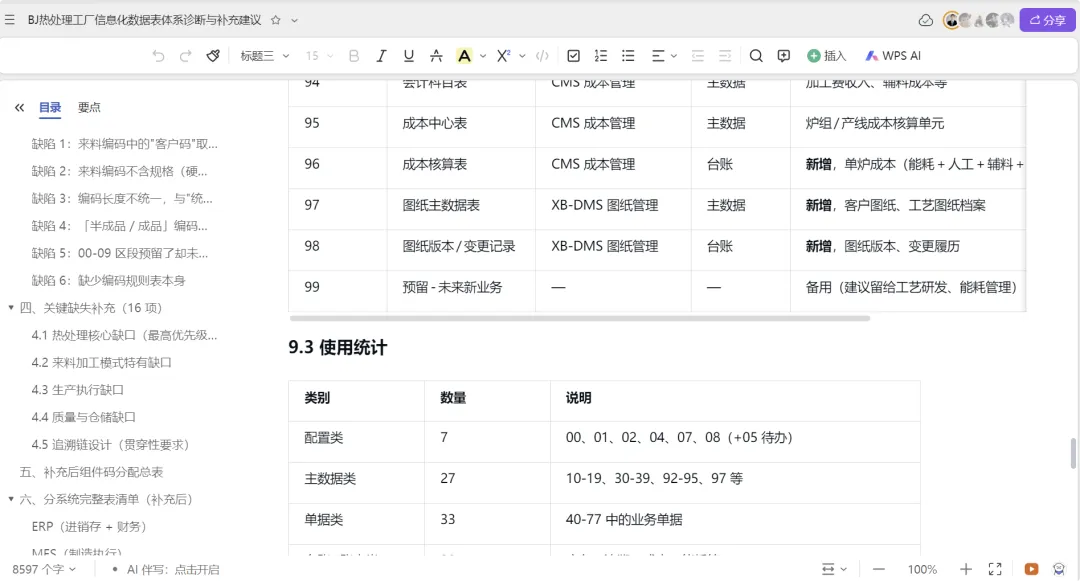
补完之后,99 个组件码全量分配完毕。
原来的 49 个码位不动,避免返工;新增 51 个全部填进预留区段。最后统计:配置类 7 个、主数据类 27 个、单据类 33 个。
这里说一句我的体会:AI 做诊断的价值不在于它比我聪明,在于它不累。
50 个组件码,逐个对照现有表,看哪个有哪个没有,看编码规则哪里自相矛盾,看哪些自由文本字段会卡住下游——这种活人做一天也会漏。它十分钟扫完,还给你列成表。
三、第二步:分批建表,建一批验一批
诊断报告出来,才开始动手。
这里有个细节很重要。我没让它一口气把表全建完,我说的是:
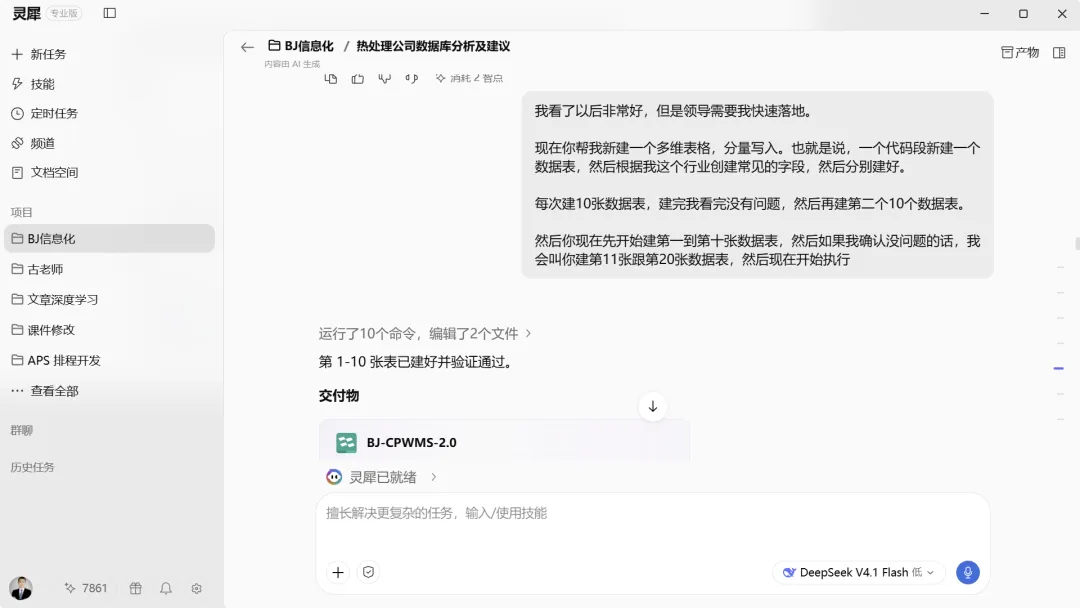
你现在先帮我建一个多维表格,分次写入。每次建 10 张表,建完我看没问题,再建第二个 10 张。现在先建第一到第十张,我确认没问题的话,再建第 11 到第 20 张。
为什么这么做?两个原因。
一是可控。表一次全建完,中间有个字段类型搞错了,后面全得返工。10 张一批,错了好改。
二是能看。建表这个活,看进度条没意义,得看结果。第一批 10 张建完,点开一看,字段对不对、类型对不对、命名规不规范,一眼就知道。
第一批 10 张表(00-09 系统与配置),它跑了 10 个命令,编辑 2 个文件,建完验证通过。
四、第三步:"这样不行,我看不出效果"
第一批建完,我点开看了一下,跟它说了句话:
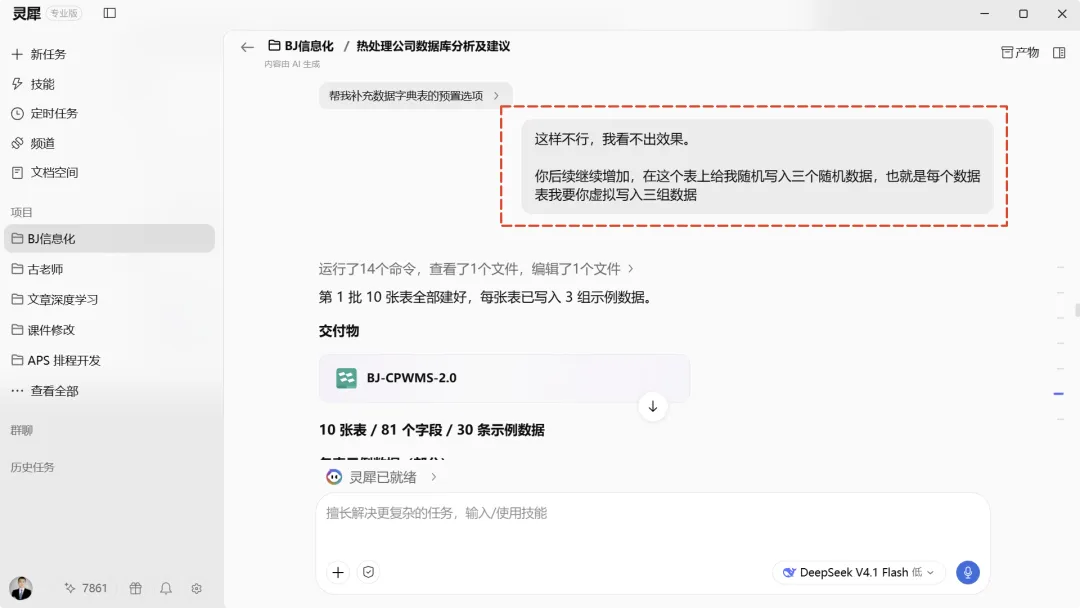
这样不行,我看不出效果。你后续继续增加,在这个表上给我随机写入三个随机数据,也就是每个数据表我要你虚拟写入三组数据。
这句话可能是我这次做下来最有价值的一句。
为什么?因为空表看不出对错。
一张表建好了,字段齐、类型对,但你不知道它能不能用。塞三条数据进去,问题立刻暴露:这个字段该是数值的设成了文本,那个字段该有默认值的没默认,主键字段和业务字段混在一起了。
它跑了 14 个命令,看了 1 个文件,编辑 1 个文件。
结果:10 张表 / 81 个字段 / 30 条示例数据。每张表三条,全部虚拟,不涉及真实业务。
五、第四步:从一个系统扩到一套系统
配置表建完,接着建仓库管理系统。
我跟它说:
不错,先继续在这个多表的基础上建立仓库管理系统 XB-WMS。10-13、18、44-47、52-57、90、91 优先,也是每个对应 3 条虚拟记录。
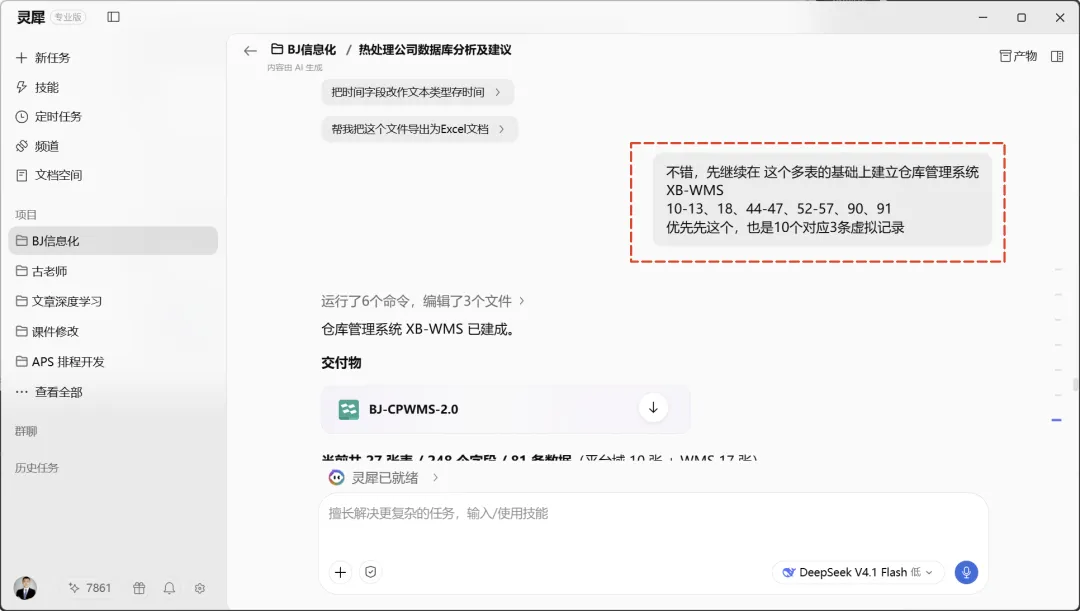
这一串全是码号,人看着累,它不用解释。因为诊断报告里已经把这 99 个码的用途写清楚了,它自己去对照。
跑了 6 个命令,编辑 3 个文件,WMS 建成。
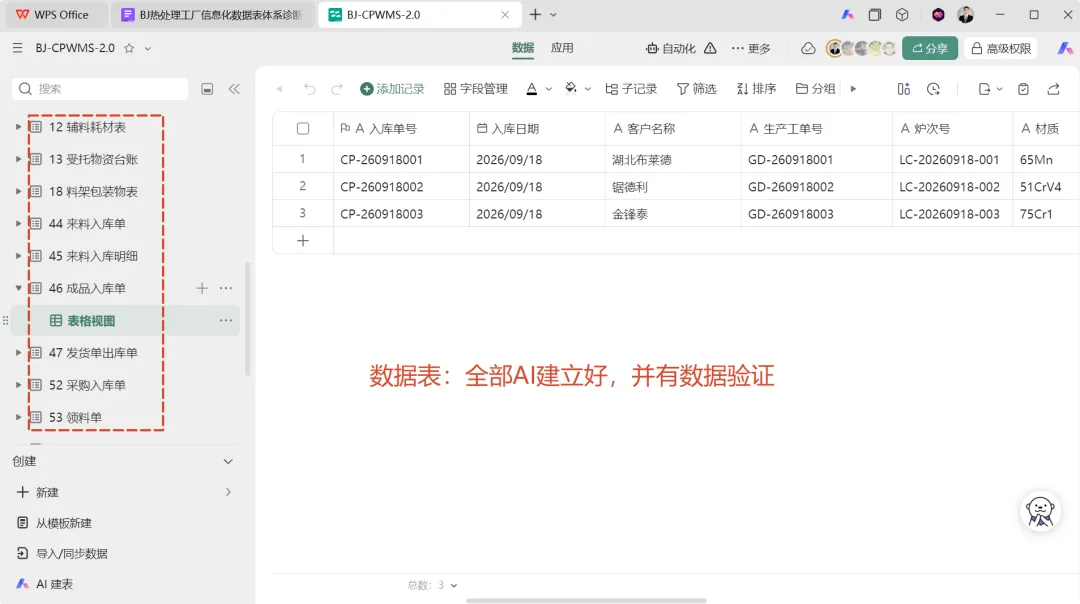
左边这一列你数一下:12 辅料耗材表、13 受托物资台账、18 料架包装物表、44 来料入库单、45 来料入库明细、46 成品入库单、47 发货单/出库单、52 采购入库单、53 领料单……
这些表不是我一张张点的,是它按编码规则批量建出来的,每张还带着验证数据。
六、一天下来,账是这么算的
环节 | 以前 | 这次 |
架构诊断 | 人工对照,1-2 周 | 10 分钟出报告 |
建表 | 手点,一张 20 分钟 | 一批 10 张,分钟级 |
字段设计 | 边建边想,容易漏 | 先定规则再建 |
示例数据 | 一般没有,等真实业务 | 每张表 3 条,先验结构 |
一天产出 | 3 张表(还带空壳) | 27 张表,全带示例数据 |
再说一遍:这不是演示,是 9 月 18 日一天真实干出来的。
七、我总结的三条
第一条,先诊断,后执行。
不要上来就让 AI 建表。让它先读方案、读现状、找矛盾、列缺口。诊断报告出来了,建表只是执行。地基错了,建得越快越麻烦。
第二条,小步快跑,建一批验一批。
10 张表一个批次,批与批之间人来确认。这不是效率低,是省返工。AI 跑得快,人只需要在关键节点看一眼。
第三条,空表不算建成,有数据才算。
这条最容易被忽略。表建完了不等于能用。塞几条虚拟数据进去,字段设计的问题立刻暴露。虚拟数据不涉及真实业务,不泄密,还能当培训样例。
最后说一句
很多人问我,AI 到底能不能做数字化落地。
我的答案:AI做不了决策,但它能把决策之后的执行压到极限。架构怎么设计还得你自己判断——这家厂是做来料加工还是自有产品、有没有炉次概念、编码规则怎么定,这些它不懂业务就做不了。
但你判断完了,剩下 90% 的活——建表、配字段、填样例、验结构——它一天能给你干完。
术语解释
文章里出现的几个词,一句话说清楚:
组件码:给每一类数据表编的两位数字编号,比如 31 代表客户、56 代表炉次。一个码对应一张表,看编号就知道是哪类数据。
主数据:相对不变的基础档案,比如客户、材质、规格、设备。业务单据都要引用它,所以要先建、要准。
单据:有生命周期的业务凭证,比如销售订单、入库单、发货单。会新增、会审批、会完结。
台账:按对象记录的流水账,比如受托物资台账、即时库存台账。特点是要能"结存",随时查余量。
炉次(Heat):一炉料装进炉子到出炉的全过程记录。热处理是"一炉多单、一单多炉",炉次是排产、追溯、算成本的最小单元。
自由文本字段:想写什么就写什么、没有固定格式的字段。人看着方便,但程序读不懂,没法自动判断、统计、汇总。
MES(Manufacturing Execution System,制造执行系统):管车间生产的系统,从工单下达到报工、检验、入库。
WMS(Warehouse Management System,仓库管理系统):管仓库进出的系统,收料、发料、库存、盘点。
落库:把纸面规则、方案文档变成系统里真实存在的表和数据。方案写得再好,没落库就等于没做。
古老师(古哥计划)|中小制造数字化专家|金山 KVP(金山办公最有价值专家)|金山多维表格应用场景专家|金山 WPS 社区优秀创作者
深耕中小制造业数字化落地,擅长用 WPS 多维表格 + AI 低代码方案,帮工厂快速搭建进销存、生产计划、质量追溯等轻量化系统。不用复杂 IT,低成本落地,已服务数百家制造企业,实战经验丰富。