ARTICLE · 1054211
RTX 3060跑实时语音AI助手,我踩了这4个坑
RTX 3060跑实时语音AI助手,我踩了这4个坑
做AI项目半年,最折腾的不是写代码,是做一个"实时语音对话助手"。3.8万行代码,WebRTC+VAD+流式STT/TTS,在我那台RTX 3060笔记本上跑。最开始以为不就是"语音转文字→AI回答→文字转语音"吗?真做起来才知道,实时对话的难点根本不在这。 坑1:打断处理——不是检测人声就行你跟人说话的时候,对方还在念上一句,你插一句话,对方会停下来听你说。这是真人对话的基本操作。但让AI做到这个,踩了第一个大坑。最开始的方案很简单:用VAD(语音活动检测)监测麦克风,检测到人声就停TTS播放。结果呢?喘气、咳嗽、清嗓子、环境噪音,全被当成"用户要打断"。AI经常话说一半突然闭嘴,特别奇怪。后来加了两层判断:能量阈值:低于-30dB的声音不算人声持续时间:连续200ms以上的人声才算真打断即使这样,用户清嗓子还是会误触发。最终方案是VAD+恢复机制:检测到人声后先静音TTS,如果200ms内没有连续语音输入,就恢复播放。这一个功能,改了5版。 坑2:延迟——超过1秒人就觉得卡实时对话的延迟指的是:从你说完最后一个字,到AI开始回答的时间。最开始全链路串行:STT识别完整句 → 800msLLM生成回答 → 500msTTS合成语音 → 300ms总延迟1.6秒。用户说完话,等1.6秒AI才开口,对话像打电话留言,完全不自然。后来改成全流式:STT边说边识别,最后一个字落音就触发LLM(省掉完整句等待时间)LLM边生成边送TTS(不用等整段回答生成完)TTS边合成边播放(第一个字合成就开始播)总延迟压到300ms以内。这个延迟下,对话才像真人。这个优化,改了3版。 坑3:显存——6GB显存跑三个模型RTX 3060只有6GB显存。STT模型(Whisper)+LLM(Qwen)+TTS模型(CosyVoice)三个模型同时加载,直接OOM崩溃。最开始三个模型常驻显存,崩了无数次。报错都是CUDA out of memory。后来做了模型懒加载:LLM常驻显存(最常用,随时要回答)STT用完就释放(识别完一句话就不需要了)TTS用完就卸载(合成完就可以卸载)显存占用从8GB压到4.2GB,终于不崩了。还有个小技巧:STT用small版本不用large。准确率差5%,但显存省一半。对话场景下5%的准确率差异用户感知不到,但显存省一半是真的。 坑4:网络——WebRTC比WebSocket靠谱最开始用WebSocket轮询,每100ms发一次音频包到服务器。结果网络稍微抖一点就卡顿,对话断断续续。后来改成WebRTC直连。P2P打洞成功后,延迟从200ms降到50ms以内。WebRTC自带的JitterBuffer自动处理网络抖动,比自己写缓冲强太多。这个坑其实最不技术,但影响最大——用户体验差,不是模型不好,是网络传得慢。 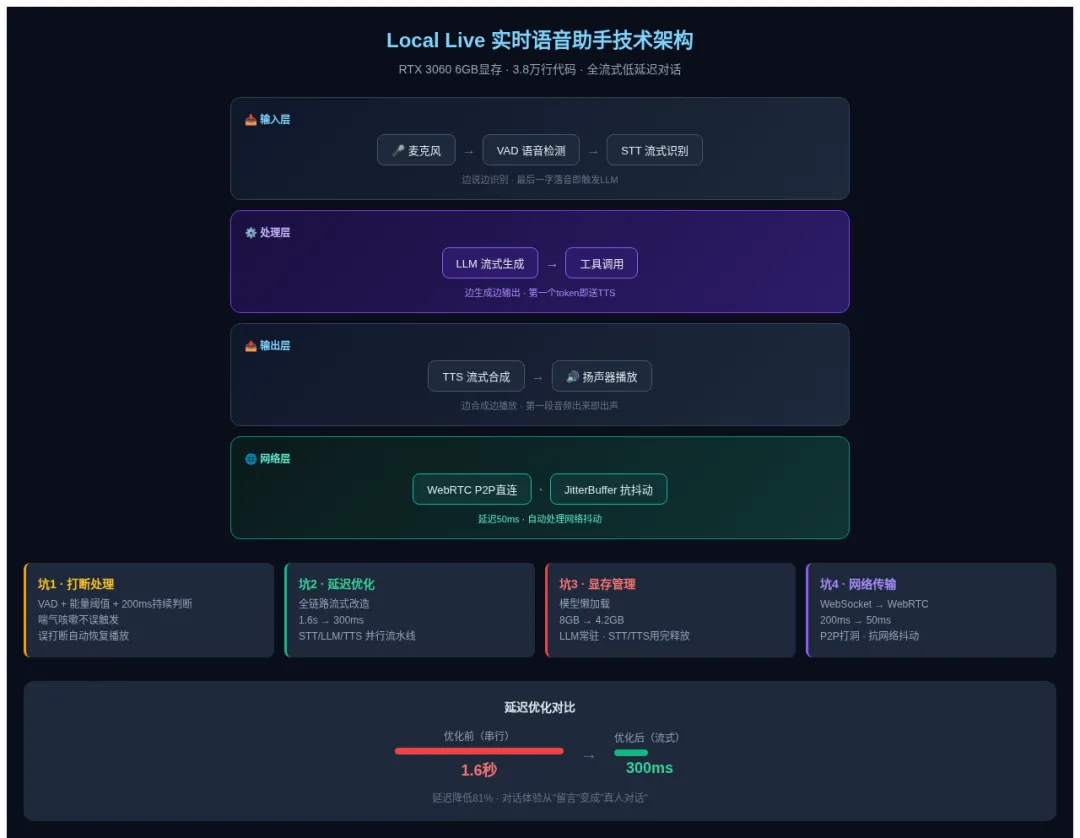
写在最后:做实时交互类AI项目,模型能力只占30%。剩下70%是工程: 打断处理:让对话自然延迟优化:让对话流畅显存管理:让程序能跑网络传输:让对话稳定 用户不会关心你用了什么大模型,只关心一件事:跟它说话顺不顺。 这个认知,花了我3.8万行代码才真正搞明白。
RTX 3060跑实时语音AI助手,我踩了这4个坑