ARTICLE · 1056055
Jev 和 Laya:给软件装上"快思考"
Jev 和 Laya:给软件装上"快思考"
过去两年,AI 编程智能体越来越强。但写代码的每个瞬间,软件其实都在做另一类工作:判断。
这条工单该进哪个队列?这封邮件是不是钓鱼?这个用户有多可能流失?这次工具调用风险大不大?
这些"判断"占掉了企业 AI 调用量的大头,而我们一直用最贵的工具去做它——调用一个几百上千毫秒的对话大模型,让它吐出一段文字,再写正则去把答案抠出来。
2026 年 9 月,两个月的时间里,先后出现了两个"另一类"模型:TypeSafe 的 Jev(9 月 15 日)和 ConvAI Innovations 的 Laya(9 月 18 日)。
它们不生成文字。它们的输出是一个带置信度的判断。
今天我们把这个品类掰开讲清楚:它是什么、为什么现在才出现、Jev 和 Laya 各自站在哪边、以及普通开发者该怎么用。
🧠 "快思考"模型到底是什么
名字来自诺贝尔奖得主丹尼尔·卡尼曼的《思考,快与慢》:
● 系统 1(快思考):直觉式,毫秒级,"那是什么"的反射判断
● 系统 2(慢思考):审慎式,几秒到几分钟,"这道证明题怎么做"的推理
TypeSafe 把前者做成了一类模型:System One 模型。
它的工作方式和 LLM 完全相反。LLM 是"你给它一段话,它一个字一个字往下写";System One 模型是你给它一段状态(工单、邮件、JSON、日志)加上一组你提前定义好的问题,它在一次前向传播里把所有答案并行算出来。
答案不长,答案很短:
● choice:在 N 个选项里选一个,返回选项 + 每个选项的概率 + 置信度
● score:把对象放在一个量表上(比如"多紧急"分 4 级),返回落在几级,可以是 2.87 这种非整数值
● noul:是的/不的,返回一个 0 到 1 的概率
就这么三种问句,覆盖了你 90% 的"判断"需求。
因为它从头到尾不吐一个 token 的文字,所以没有"JSON 写错再修"这一步,没有"模型话多跑偏"这回事,输出空间物理上就只有概率和数字。
🏢 Jev:闭源那一侧
先说 Jev。
TypeSafe AI 成立于 2024 年,创始人 Diogo Almeida 是 OpenAI 的 RLHF / InstructGPT 共同发明人之一。公司拿了 DCVC 领投的 4000 万美元,Jev 于 2026 年 9 月 15 日上线 early access。
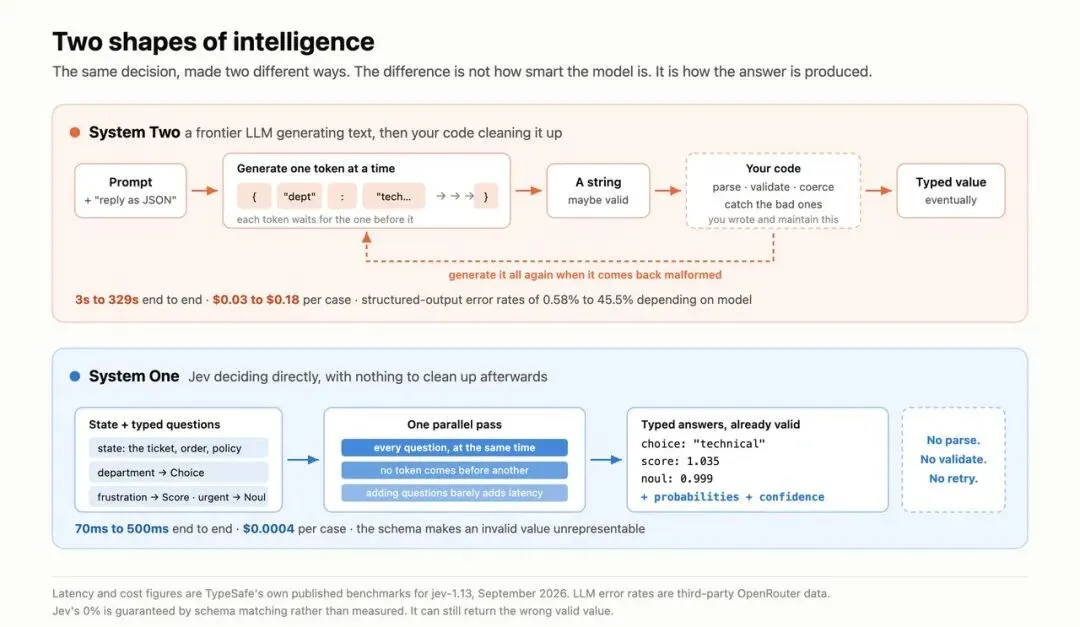 ▲ 图①:TypeSafe 官方博客里的 Jev vs 前沿 LLM 对比
价格:输入 0.042 美元/百万 token,输出免费。("免费"的潜台词:输出太便宜,不值得计量。)
延迟:70 到 500 毫秒,同一任务下前沿 LLM 是 3 到 329 秒。
上下文:state + 所有问题共 64K,单个最长问题配 32K。
几个设计选择值得注意:
第一,它训练的方式叫 RLCD(Reinforcement Learning for Calibrated Decisions)。奖励函数是一个严格的评分规则——模型只有报出"诚实概率"时期望奖励才最大。这意味着你拿到的 confidence 不是模型"编"出来的自我感觉,而是被训练出来、可以按阈值用的数字。
第二,三个基本原语就是整个 API。Jev 的 choice 上限是 255 个选项——所以你可以把整张"团队/类别"表直接塞进去,不用先做一轮粗筛。
第三,它自称"不会幻觉"。输出空间里没有自由文本,类型错误在数学上不可能发生。这不是"更少幻觉",是"没有幻觉面"。
第四,有一个概念值得单独讲:投机式扇出(speculative fan-out)。
因为问题在同一个 state 上并行评估,多问一个问题几乎不花时间,只花点便宜的 token。所以正确姿势不是"先问粗的,再按需追问",而是把你想知道的维度一次全问完,剩下的交给代码判断。
TypeSafe 官方 cookbook 里的数字:把 13 个合规问题拆成一问一答跑,和合成一次跑,答案一模一样,但合并调用便宜 12.2 倍、快 10 倍。
🎓 Laya:开源那一侧,以及它的"早一年"
Laya 的故事更有意思。
ConvAI Innovations 的 CEO Nandakishor Mukkunnoth 声称,同样的非自回归决策模型思路,他在 2025 年 3 月就发过 arXiv 论文(arXiv:2503.23303,销售转化轨迹模型),同年 10 月发了第二篇(arXiv:2510.01237,把"schema 引导 + 强化学习"形式化)。
2026 年 9 月 18 日,他把这套东西做成了 Laya——Apache 2.0 权重、代码、数据集全开源,发布当天上了 Hacker News 560 分。
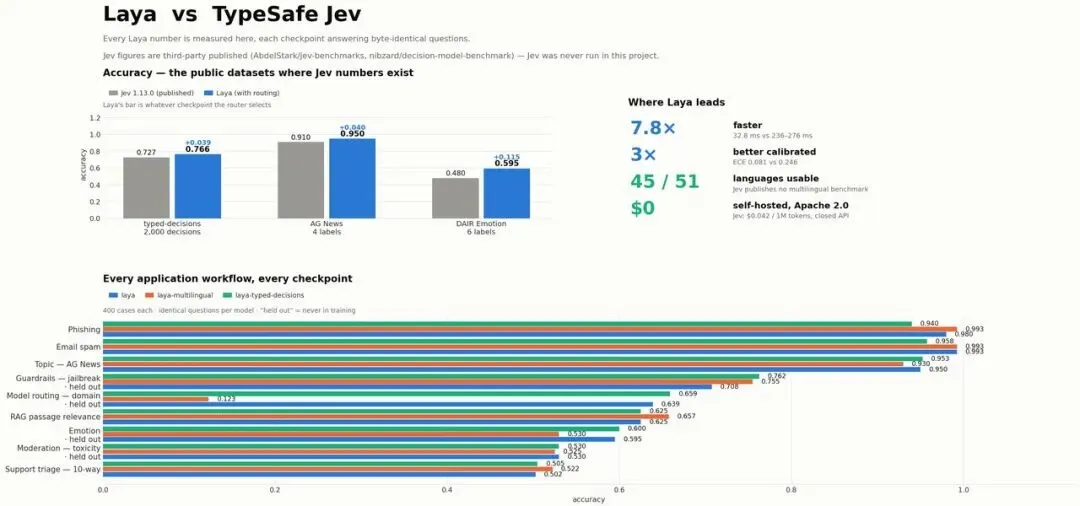 ▲ 图②:Laya 官网完整基准板:准确率、工作流、51 语言、延迟、校准
Laya 是一个家族,三个 checkpoint 装在一个仓库里:
laya | |||
laya-multilingual | |||
laya-typed-decisions |
关键能力:
延迟 32.8 毫秒(T4 单卡 P50),批量时 7.2 毫秒/问。Laya 官方基准板里 Jev 同期单问 P50 是 236–276 毫秒——约 7.8 倍差距(注意口径:Laya 是本地 GPU,Jev 是 API,含网络往返)。
Router 自动识别语言。它扫 Unicode 脚本(22 套字母表 + 拉丁停用词分布),把英文请求给英文模型、天城文/其他 100+ 语言给多语言模型。检测开销 0.09 毫秒(英文)到 0.73 毫秒(200 行嵌套 JSON)——对一个 33 毫秒的前向传播来说可以忽略。
零 API 成本,权重可以空跑在自己的 GPU 上,适合私有化、数据不出境、或者要接在边缘的场景。
但这里有一组数字必须掰开了看,否则容易被带跑:
Laya 官方基准板上对 Jev 的胜出(typed-decisions 0.766 vs 0.727、AG News 0.950 vs 0.910、DaIR Emotion 0.595 vs 0.480)——
● Laya 那个 0.766 是微调后的结果(在基准训练集上 SFT 出来的),Laya 的 zero-shot 只有 0.35 左右,接近随机
● 所以严格讲,这不是"零样本模型 A vs 零样本模型 B",而是"微调过的 421M 开源模型 vs 闭源前沿模型"
Laya 官方页自己承认了这一点("Honest Limitations"一章),这是加分项。但阅读 Laya 官方对比时,要把这条口径带进去。
还有一个反向的例子同样来自 Laya 官方:在 77 标签的 Banking77 上,Laya 0.425 vs Jev 0.870——选项一多,Laya 崩得厉害。原因是架构约束:候选共享 192–256 token 的 head 预算,77 个选项摊到每个只有 3–4 个 token。Laya 官方建议:choice 问题控制在 20 个选项以内,或者做两级"先粗后细"。
🔬 它们和 LLM 到底差在哪
一张对照表(数据来自 TypeSafe 官方博客 + dev.to 的 Jev 实践指南):
最后一条最关键。LLM 说"我 95% 确定"的时候,它只是在生成一个听起来很笃定的 token 序列——训练目标没有让它为这个数字负责。而 Jev/Laya 的 confidence 是被 RLCD 按"报对概率拿最多奖励、报错被惩罚"训练出来的,高置信就真的对应高准确率(Laya 官方 ECE 0.081,Jev 同口径 ECE 0.246)。
一句话:LLM 的 confidence 是修辞,System One 的 confidence 是可以用 if 语句分支的输入。
⚙️ 实际怎么用:两种接入方式
Jev 是 API,装一个 SDK 就能跑:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient client = TypeSafeClient() response = client.system_one( state={ "ticket": { "subject": "重复扣款", "messages": [{ "from": "customer", "text": "我被扣了两次款,订单 A-104,请退款。" }], }, "refund_policy": "重复扣款可退款。", }, questions={ "department": Choice( instructions="该由哪个团队处理?", criteria={ "billing": "支付或订阅类问题", "technical": "故障或集成问题", "sales": "报价或合同", }, ), "refund_wanted": Noul( instructions="用户明确要求退款吗?" ), }, ) print(response.answers["department"].choice) print(response.answers["refund_wanted"].noul) Laya 是本地,pip install laya 之后:
import laya from laya import Router router = Router(preload=True) # 预载,避免语言切换时 7–10s 冷启动 ticket = { "ticket_id": "TCK-8821", "customer": "enterprise_user", "subject": "系统宕机+账单争议", "body": "我们的生产 API 从早上 6 点开始挂,丢了大量交易。要求立即 SLA 退款。" } questions = { "queue": { "type": "choice", "instructions": "该进哪个工程队列?", "criteria": { "infrastructure": "服务器/网络/数据库故障", "billing": "退款、SLA、发票", "security": "泄露、漏洞", "support": "一般咨询", }, }, "urgency": { "type": "score", "instructions": "多紧急?", "criteria": ["低", "中", "高", "P0 阻塞"], }, "churn_risk": { "type": "noul", "instructions": "客户有流失意图吗?", }, } res = router.predict(ticket, questions) print(res["answers"]["queue"]["choice"]) # infrastructure print(res["answers"]["urgency"]["score"]) # 2.87 / 3.0 print(res["answers"]["churn_risk"]["noul"])# 0.914 生产上常见的组合是:Jev 做前沿判断(需要最强智能的高价值决策),Laya 做高频过滤(垃圾邮件、guardrail、路由,跑在本地 GPU 上零成本)。
一个值得记住的模式叫置信度门槛路由(confidence-gated routing):
a = response.answers["intent"] if a.confidence < 0.5: route_to_human() # 真的不确定就转人工 elif a.choice == "approve_transfer" and a.confidence > 0.85: approve() # 涉及钱,阈值高 else: act() # 只读类操作,阈值低 不同动作的错判成本不同,阈值就应该不同——这是用 System One 模型和用 LLM 最大的架构差异。
📊 已经跑出数字的场景
Laya 官方基准板上的 9 个应用工作流,数字(准确率 / ECE):
● 邮件垃圾过滤(Enron 数据集):0.993
● 钓鱼识别:0.980
● LLM guardrail / jailbreak 检测(held-out ToxicChat):0.755 – 0.762,选择性覆盖 50% 时 0.931
● RAG 段落相关性过滤:0.657(单前向)
● 客服工单 10 路路由:0.522(弱,官方也承认这是短板)
Jev 侧官方 demo 覆盖了 WikiRace、支持工单、浏览器 agent、实时交易 agent、大规模邮件分拣。Prompt Engineer 48 还把两个模型放进同一个游戏 harness 对测(贪吃蛇、Mortal Kombat 风格对战,每个动作都是模型决策)——Laya 本地跑、Jev 走 API。那个视频值得单独看一次。
⚠️ 冷思考:三组容易误读的数字
第一,Laya 的"7.8× 快"是本地 T4 vs API 网络往返,不是同机同条件。同一台机器上跑 Laya 和自部署的 Jev,差距会小得多。
第二,Laya 微调版 0.766 vs Jev 0.727 这个"胜出",建立在 4 个工作流合成集上 SFT 过的前提下。你拿 Laya 直接零样本去干 typed-decisions,只有 0.35。它是"快速起点",不是"零样本神器"。
第三,Laya 英文 checkpoint 有个反直觉的坑:扫 51 种语言,它在 Khmer(高棉文)上准确率 0.000、但平均置信度 0.952——错得极其笃定。这意味着只用 confidence 做门槛防不住它,得靠 Router 在前置把它路由到多语言模型。TypeSafe 那边的 FAQ 里也承认 Jev 的"高置信≠高准确"没有严格的数学保证(只是他们宣称"更稳")。
第四,"不会幻觉" ≠ "不会错"。 输出空间被限制在 N 个选项里,不代表它选对了。它只是把"错误"压缩到了"在 N 里选错"这一个面,省掉了"生成一段胡话"那一面。
💡 为什么这两个模型重要
TypeSafe 给 Jev 取名致敬经济学家威廉·斯坦利·杰文斯:蒸汽机效率提高让煤更便宜之后,用煤的总量反而涨了——成本降一个数量级,解锁的需求比省下来的还多。
这是"智能"未来最可能走的路径:
当一次判断的成本从 100 毫秒 2 分钱,降到 33 毫秒 0 分钱(Laya 自部署),"每个请求都过一次模型判断"就从奢侈品变成了水电费。
工单路由、邮件分拣、guardrail、发票核对、RAG 段落过滤、agent 内部工具调用的风险检查——这些你本来用正则或简单分类器在糊弄的场景,突然可以塞进一个"能读复杂 JSON、带置信度、且 33 毫秒返回"的判断器。
这不是"更便宜的大模型",是一个新的原语。
Jev 和 Laya 一个闭源前沿、一个开源自部署,正好把这个品类的两头都钉住了。接下来的问题不是"该用哪个",而是"你现在的哪个判断,可以降级到 System One"。
参考资料
参考资料. TypeSafe AI 官方博客 · https://typesafe.ai/blog/introducing-system-one-models-and-jev ConvAI Innovations(Laya 官网) · https://laya.convaiinnovations.com AI/TLDR · https://ai-tldr.dev/tools/laya DEV Community · https://dev.to/valyuai/how-to-use-jev-a-practical-guide-to-typesafes-system-one-model-g5e arXiv 2503.23303(Laya 前身论文) · https://arxiv.org/abs/2503.23303 arXiv 2510.01237(schema+RL 形式化) · https://arxiv.org/abs/2510.01237 Prompt Engineer 48 · https://www.youtube.com/watch?v=x1GFo1eG8d0