ARTICLE · 1060430
微软OpenAI机密文件全网解密!内部高管坦白:我们正在进行人类史上最大盗窃
谁也没想到,彻底撕下生成式AI遮羞布的,正是微软和OpenAI自己的高管。
一份长达92页的重磅法庭文件悄然解密。
纽约南区联邦法院的卷宗里,那些曾经被大面积涂黑的内部邮件、备忘录和高管证词,第一次一字不差地被扒得干干净净。
在这份原告简报中,人们看到了一句足以载入科技史册的内部评价。
微软应用科学主管在备忘录里直言不讳:
“这可能是人类历史上规模最大的一场劳动盗窃。”
几乎同一时期,OpenAI负责ChatGPT业务的核心高管也在内部承认:
我们的产品对新闻出版商而言,就是“纯粹的替代品”,是一场“生死存亡的生存威胁”。
台前,两家巨头西装革履,在听证会上高呼“合理使用”、“技术造福人类”;幕后,内部邮件里却充满了心照不宣的算计、秘密代号的爬虫流水线,以及对内容生态被活活抽干的末日预警。
这场价值数十亿美元的版权世纪大战,终于把硅谷最隐秘的底牌翻到了阳光之下。
一声“ah nice”,击碎了所有的体面
过去几年,当全世界惊叹于大语言模型无所不知、下笔千言时,外界总在追问一个问题:
这些模型到底吃了什么,才变得这么聪明?
OpenAI和微软对外的标准答案往往充满学术美感:公开网络数据、统计规律学习、无害的文本摘要。
但解密文件揭开的现实,却充满了粗暴的“直接硬撬”。
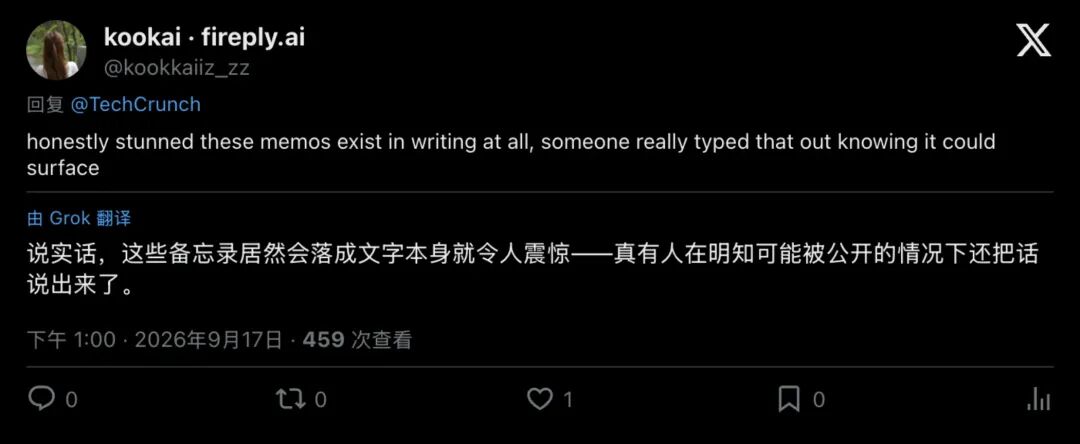
▲ 网友在社交平台惊叹:竟然有人敢把这些话白纸黑字敲进公司备忘录
在OpenAI内部,研究员Nick Ryder曾兴奋地向公司总裁Greg Brockman汇报:
“我找到了一个能绕过《纽约时报》付费墙的黑客方法。”
现任总裁 Brockman 的回复只有简洁的两个词:“ah nice.”(啊,漂亮。)
如果说突破付费墙还只是战术上的“小动作”,那两家巨头之间的数据输送,就是工业化的大规模运作。
解密文件曝光了两个此前从未公开的绝密项目代号:Project Taxi(出租车计划) 与 Project Mango(芒果计划)。
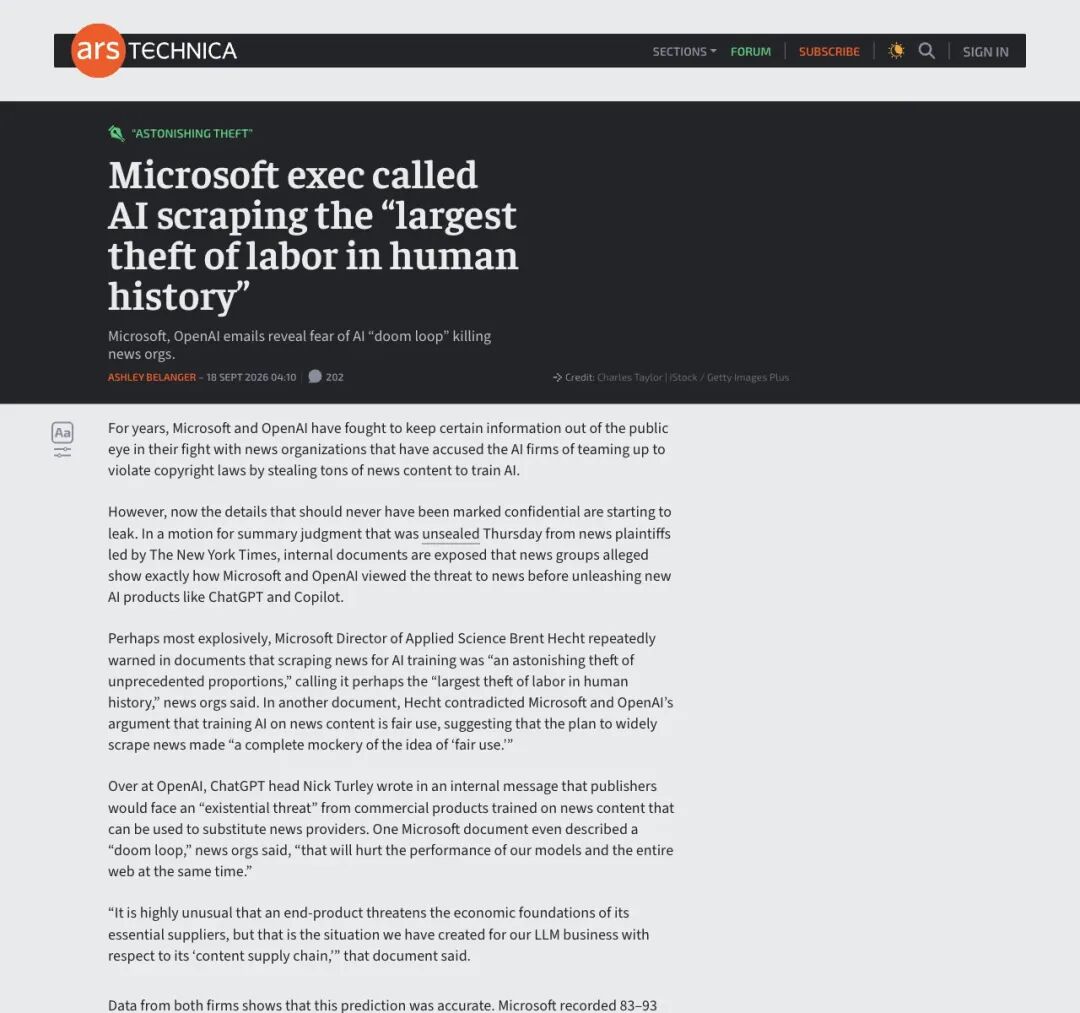
▲ Ars Technica深度报道:微软与OpenAI内部邮件曝光对行业毁灭的担忧
- Project Taxi
:微软把支撑必应(Bing)传统搜索引擎数十年的网页索引库打包复制,直接提供给OpenAI当粮食。当时OpenAI研究负责人甚至私下打趣,这笔交易的逻辑就是“我们给他们数据,他们给我们数据”。 - Project Mango
:微软专门为OpenAI开发并运行定制爬虫,目标只有一个,尽可能多地抓取高质量内容。光是这个数据集里,就至少包含了原告媒体超过 160,903 件 独特作品的完整副本。
更有甚者,为了防止模型在回答用户时“露馅”,工程师们在清洗数据时,甚至特意把文本里的版权声明(Copyright Notices)全部剔除。
理由荒诞得令人发指:不希望模型在生成内容时,不小心把原作者的版权标识也给吐了出来。
暴跌94%!杀鸡取卵的“末日循环”
如果AI只是读了你的文章,帮你带去更多读者,出版商或许还能忍受。
但事实完全相反AI正在把整个内容生态的水库彻底抽干。
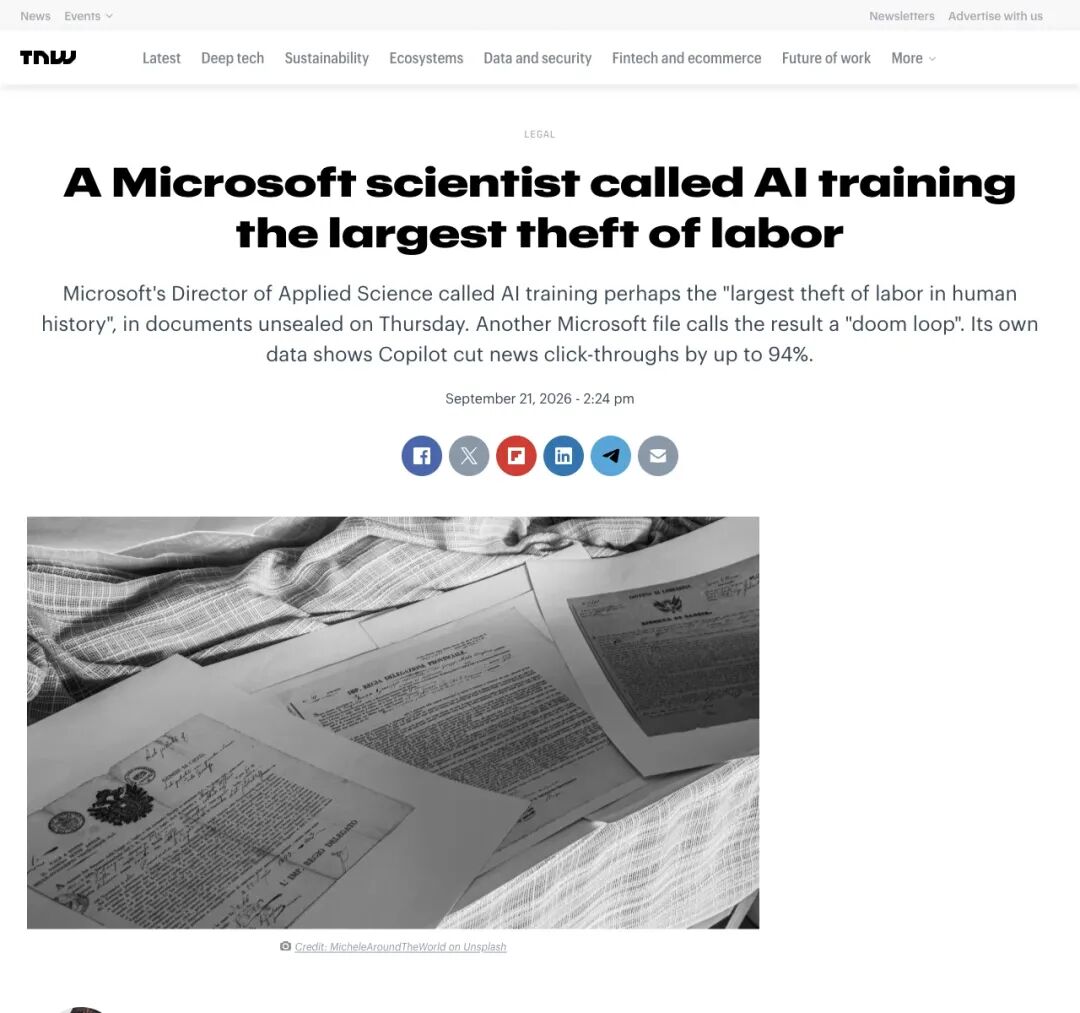
▲ 科技媒体TNW报道:解密数据显示Copilot让媒体点击率最高暴跌94%
根据微软内部自己统计的流量数据,当用户从传统的搜索引擎转向AI聊天助手(如Copilot)后,媒体网站的真实出站点击率遭遇了断崖式坍塌:
- 《纽约时报》域名点击率狂跌 87% ~ 93%
; - 《每日新闻》系媒体点击率狂跌 83% ~ 91%
; - 知名科技媒体集团Ziff Davis的点击率狂跌 51% ~ 94%
。
微软甚至在自家的宣传文案里大摇大摆地写道:“别去点那些网页链接了,有啥想知道的,直接跟我聊就行。”
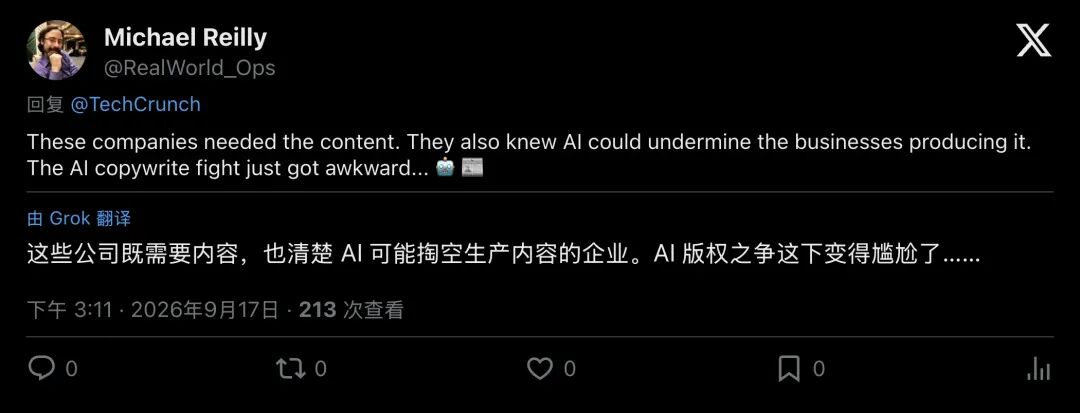
▲ 网友直言:巨头既需要内容,又心知肚明AI会摧毁生产内容的企业
这直接击穿了大模型赖以生存的根基。
微软应用科学主管在内部演示文稿中画出了一张令人不寒而栗的示意图,并将其命名为“末日循环”(Doom Loop):
- 第一步
:AI无偿抓取人类记者、作家数十年积累的高质量深度内容; - 第二步
:AI在前端直接给出答案,用户不再点击原文,媒体失去访问量与订阅收入; - 第三步
:专业媒体失血倒闭,高质量人类内容生产断崖式萎缩; - 第四步
:互联网上充斥着低质的洗稿文与机器生成的胡言乱语(AI Slop); - 第五步
:下一代大模型失去优质养分,只能去吃机器自己排泄出来的合成垃圾,最终导致模型性能与开放网络一同走向崩溃。
微软高管在备忘录里写下的那句话,成为了科技界最毒辣的预言:
“大语言模型,是一种正在亲手摧毁自己供应链的产品。”
“一边偷数据,一边造过滤器掩盖痕迹”
当《纽约时报》等媒体在2023年底正式打响版权诉讼后,巨头们随即采取了一系列隐蔽操作。
起诉书指出,聊天机器人有时能近乎逐字逐句地把需要付费订阅的深度长文直接背出来。
为了应对取证,OpenAI被曝出紧急上线了一种被称为 Bloom filter(布隆过滤器) 的技术拦截机制。
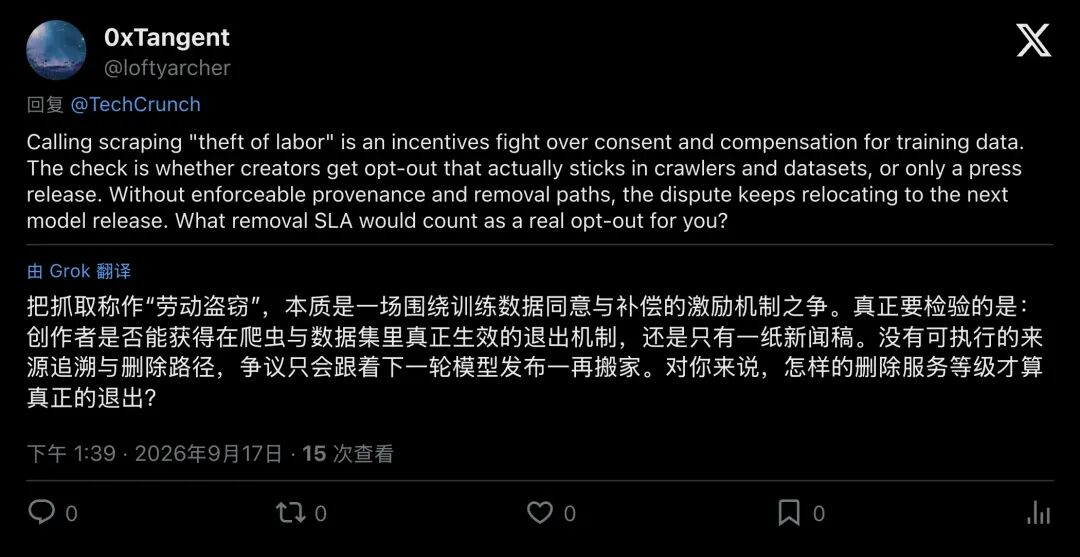
▲ 网友在X上深入讨论:缺乏可执行的溯源与删除机制,争端只会不断延宕
通俗地讲,就是把那些最容易被模型一字不差背诵出来的经典报道做成一张“黑名单”。一旦用户提问触发了这些段落,系统就在最后一瞬间强行掐断,不让完整内容显示出来。
原告律师在法庭上严正指出:这种做法实质上是在毁灭证据并实施技术掩盖。
微软内部主管甚至私下提醒,这种做法很可能会被法庭和公众看作是一场“意外的掩盖行为(accidental cover up)”,因为你在模型肚子里留着别人的劳动成果,却在嘴巴上套了个口罩,让权利人更难抓到现行。
致命的自白:合理使用的神话破灭
在过去的版权诉讼中,硅谷科技公司最强大的护身符叫做“合理使用”(Fair Use)。
他们向法官辩称:人类读书不叫抄袭,AI阅读海量文本提炼规律,属于高度的“转换性使用”(Transformative Use),不构成对原作市场的直接替代。
但这次解密的92页档案,却用他们自己的话,亲手把这块挡箭牌砸得粉碎。
在版权法体系中,判断合理使用最致命的一条标准是:你是否摧毁了被侵权者的潜在市场?
在法庭上,微软CEO萨提亚·纳德拉(Satya Nadella)在宣誓作证时不得不承认:
付费墙后的内容如果用于AI训练或生成,理应获得许可; AI直接回答问题的确替代了用户前往原始网站的需求。
而OpenAI的ChatGPT业务负责人Nick Turley更是在内部沟通中白纸黑字地写着:我们的产品“大体上就是替代性的,而且随着技术变好,它只会变得越来越具有替代性。”
当被告方自己的高管都在内部承认这是“替代品”、是“生存威胁”、是“破坏供应链”时,法庭上的“合理使用”辩护,已经变得苍白无力。
算计与傲慢:十亿罚款,不过是早已计提的过路费
很多人会感到困惑:既然这些顶尖高管和科学家早在两三年前就预见到了法律风险、道德困境和“末日循环”,为什么他们当时没有停下来?
答案很简单,也很残酷:在万亿美元的AGI军备竞赛面前,版权侵权的代价实在太便宜了。
▲ 行业梳理显示:巨头们一边打官司,一边开始私下与部分媒体签订授权协议
对于估值数千亿乃至万亿美元的科技帝国而言,先用最快速度吞下全人类的一切知识,把模型能力推到霸权地位,再回过头来处理法律诉讼。
最差的结果是什么?哪怕最终被判赔偿几十亿美元,或者达成高额和解,这笔钱在AGI带来的绝对统治力和海量资本面前,也不过是一张早就计提在财报里的“高速公路过路费”。
但这场掠夺留下的烂摊子,却由全人类的内容生态来买单。
当优质的新闻机构被吸干养分,当独立创作者的声音被机器淹没,当未来的AI只能在一片充斥着机器合成垃圾的数字荒原上自噬反刍,
这场被微软高管自己命名的“人类史上最大规模劳动盗窃”,蚕食着数以百万计的新闻报道,更在动摇整个文明赖以沉淀、求真与思考的知识土壤。