ARTICLE · 1066088
DeepSeek-Harness 源码深读(12):全包没有一个 tokenizer,token 计量凭什么可信
摘要:压缩引擎自己不带计数器,触发阈值、保留区间、收敛校验的每个数字都出自 token-meter。而这个包全包没有一个 tokenizer:报价是 4 字符/token 的启发式,绝对精度外包给 provider usage 锚点,压缩替换区间值多少 token 则作为影子价格写进事件流本身。锚点加增量、一个估计器两种折叠,拆完这 1027 行。
压缩引擎每一步都在问同一个问题:上下文还撑得住吗。这个问题的答案是一个数字,totalTokens。dsh 里提供这个数字的只有一个包,token-meter。压缩引擎 inject 它,触发用它,保留区间用它,连「摘要必须更小」的校验也用它,压缩自己一行计数代码都没有。
打开这个包,第一件反常的事:src 下 1027 行,没有一个 tokenizer。没有分词器,没有 vocab 文件,没有任何 tokenizer.encode 调用,全部报价出自三个魔法数字。
我们先把结论放这儿。这个包追求的不是数得准,是两边永远一致:绝对精度外包给 provider 上报的 usage,自己只对「之后的增量」做启发式估算;而所有消费方,服务、投影、压缩,共享同一个估计器,等式按构造成立,不靠运行时对账。
我们跟着一条会话把账本走一遍。
一、三个魔法数字,给全世界报价
没有 tokenizer,一条消息值多少 token 怎么算?答案在 estimate.ts,全部魔法数字就三个(estimate.ts:12-19):
/** Fixed text-density estimate used until exact tokenization is needed. */const CHARS_PER_TOKEN = 4/** Per-block structural overhead for JSON framing and type tags. */const BLOCK_OVERHEAD = 4/** Role-field framing overhead added to every priced message. */export const ROLE_OVERHEAD = 4这段是干嘛的:定义整个运行时的 token 报价口径。4 个字符算 1 个 token,每个 content block 加 4 个结构开销,每条消息再加 4 个角色开销。定价的执行是对 content block 的递归(estimate.ts:26-49,摘录):
export function estimateContent(blocks: readonly ContentBlock[]): number { let tokens = 0 for (const block of blocks) { switch (block.type) { case 'text': case 'reasoning': tokens += Math.ceil(block.text.length / CHARS_PER_TOKEN) + BLOCK_OVERHEAD break // … default: // ContentBlockMap is merge-extensible; unknown blocks retain a // conservative structural JSON price under the fixed heuristic. tokens += BLOCK_OVERHEAD + Math.ceil(JSON.stringify(block).length / CHARS_PER_TOKEN) } } return tokens}注意看 default 分支。ContentBlockMap 是声明合并扩展的,任何插件都能注册新的块类型,估计器不认识的块就整体 JSON 序列化后按 4 字符/token 兜底。新块类型进来,定价不断链。
4 字符/token 对中文明显偏低,对 JSON schema 也偏低,包自己在投影的注释里承认了(projection.ts:51-58)。不准的数,凭什么敢拿来触发压缩?
答案藏在「谁在用」里。estimate.ts 是全包唯一定义「多少钱」的地方,服务和投影都从这里拿价:一条消息在服务侧算 800,在投影侧也是 800,在压缩的计划表上还是 800。误差人人有份,且份份相同。对「还撑得住吗」这种判断,两边用同一个不准的数,比两边各用各的准数更稳。
但一致性解决不了漂移。会话跑到第 40 轮,启发式的误差会累积成什么样,没人敢保证。这时候需要准数,而准数不在估计器里,在事件流里。
二、记账的本体:把日志从头再读一遍
TokenMeter 是个 cordis Service,状态按会话隔离(index.ts:79):
private readonly states = new WeakMap<Session, ReplayState>()构造器里只注册一个监听(index.ts:95-97):
ctx.on('session/event', (session) => { if (this.states.has(session)) this._sync(session)})这段是干嘛的:已被读过、状态已建的会话,在每个事件边界追平一次。注意看判断条件是 states.has,惰性到「没有消费者,状态就不存在」。
追平的动作是把日志从上次读到的位置逐事件折过去(index.ts:174-179):
while (state.consumedEvents < session.events.length) { // oxlint-disable-next-line typescript/no-non-null-assertion -- contiguous session seqs index the durable log const event = session.events[state.consumedEvents]! this._foldEvent(session, state, event) state.consumedEvents += 1}把日志从头再执行一遍就能重建账本,这是《不保存任何会话状态,session 插件凭什么断点续跑》定下的地基。token-meter 把重放用在了记账上:事件流里有什么,账上就有什么。
那么事件流里的准数在哪?provider 的 usage。适配器完成一次调用,把 provider 上报的 inputTokens、outputTokens、缓存读写数塞进 assistant/message 事件,随日志落盘(《不封装任何 SDK,llm 插件凭什么接住所有模型调用》拆过这条链)。读数的基准形状就三种(types.ts:15-18):
export type TokenMeasurementBaseline = | { readonly kind: 'none'; readonly tokens: 0 } | { readonly kind: 'estimated'; readonly tokens: number } | { readonly kind: 'usage'; readonly tokens: number; readonly usage: Readonly<TokenUsage> }none 是还没发过请求,estimated 是纯启发式,usage 是 provider 真值。
三、锚点:把 provider 真值焊进账本
我们带着一条具体会话看。第 3 轮,step 开始时账面表面 12,000 token;模型回复完,assistant/message 事件带着 usage 进了日志。折叠函数这样构造锚点(index.ts:232-249):
if (event.data.usage !== undefined && nextHeader !== undefined) { const providerAssistantTokens = this._estimateProviderAssistant( session, event, eventTokens, ) const anchorSurfaceTokens = stepStart.surfaceTokens + providerAssistantTokens const providerTokens = usageTokens(event.data.usage) const estimatedAnchorTokens = estimateHeader(nextHeader) + anchorSurfaceTokens nextAnchor = { header: nextHeader, surfaceTokens: anchorSurfaceTokens, // Signed heuristic deltas remain conservative only from an anchor // that is at least as large as the matching full heuristic price. baseline: providerTokens >= estimatedAnchorTokens ? { kind: 'usage', tokens: providerTokens, usage: event.data.usage } : { kind: 'estimated', tokens: estimatedAnchorTokens }, }}这段是干嘛的:在 provider 报账的时刻,把当时的账面整个封存成一个基准点。注意看两处。
第一处,anchorSurfaceTokens 等于 step 开始时的表面加 provider 侧的助手输出。为什么不直接用账面上那条 assistant 消息的价?因为账面消息是持久化版本,provider 实际吐出的流可能和它有出入。_estimateProviderAssistant 拿事件自带的 sourceEventSeqs,把引用到的 assistant/chunk 逐个用 BlockAssembler 重新拼装再定价,只统计真正进过 provider 流的内容(index.ts:285-309);遗留事件没有 sourceSeqs,就保守回退到持久消息的价(index.ts:282-283)。
第二处,结尾那个三元表达式。provider 上报 14,600,启发式同口径估出 13,100,取 14,600 当锚点;反过来,provider 报 12,000 而启发式估 13,100,就放弃 usage,用 13,100。注释写明理由:带符号的启发式增量,只在锚点不低于对应的全启发式价格时才保持保守。锚点选小了,之后的增量会把 totalTokens 拽成虚低的数,压测就漏报。宁可高估。
四、measure():锚点加增量,包络变了就重估
读数入口 measure() 拿锚点做差,三个分支(index.ts:125-137):
if (anchor !== undefined && optionalHeaderEquals(anchor.header, header)) { baseline = anchor.baseline surfaceDeltaTokens = state.surfaceTokens - anchor.surfaceTokens} else if (header === undefined && state.surfaceTokens === 0) { baseline = { kind: 'none', tokens: 0 } surfaceDeltaTokens = 0} else { baseline = { kind: 'estimated', tokens: estimateHeader(header) + state.surfaceTokens, } surfaceDeltaTokens = 0}包络没变走第一分支:当前总压等于 provider 真值锚点,加表面自那以后的启发式增量。第 3 轮锚定 14,600,之后用户又发了一条消息加 500,读数 15,100,其中只有 500 是估的。
包络变了,system 提示换了、工具表加了、模型切了,锚点作废,落到第三分支整体重新启发式定价。锚点在构造时记录了当时的 header,比对不上就不用。这个细节决定了一件事:换模型,不会拿旧模型的真值算新模型的账。
measure() 还接受一个可选的 requestHeader 参数,调用方可以传「即将发出的包络」提前测压。返回值经 deepFreeze(structuredClone(...)) 深冻结后交出,完全脱离内部状态(index.ts:139-146)。
到这里,一条会话的日常记账闭环了。但有个角色一直没出场,而这个包一半的复杂度是它带来的:压缩。
五、压缩来了:replace 把账本撕出一段
会话跑到第 40 轮,totalTokens 62,900,超过阈值 57,600,压缩开动。它把旧消息换成一条摘要,账面上的动作是一个 replace 表面操作:从位置 start 到位置 end 的消息全部下账,换上一条新的。
服务侧的折叠长这样(surface-fold.ts:52-64):
const startIdx = nodes.findIndex(node => node.seq === op.start)const endIdx = nodes.findIndex(node => node.seq === op.end)if (startIdx === -1 || endIdx === -1 || startIdx > endIdx) { throw new Error( `token surface: replace at seq ${event.seq} has invalid current range ${op.start}-${op.end}`, )}const removed = nodes .slice(startIdx, endIdx + 1) .reduce((total, node) => total + node.tokens, 0)const next = [...nodes]next.splice(startIdx, endIdx - startIdx + 1, { seq: event.seq, tokens })return { tokens, nodes: next, deltaTokens: tokens - removed }这段是干嘛的:在逐节点价格表上执行区间替换。注意看 nodes,服务侧的表面不是一条消息列表,是每个节点自带价格的表,measure().nodes 交出去的就是它。压缩选保留区间,直接从这张表尾部倒序扣预算。区间找不到就 throw:落盘日志在追加时做过表面校验,解析不了的区间等于日志损坏,宁可崩。
问题跟着来了。这个包还有三个投影(tokenUsage、contextPressure、contextBreakdown),投影状态要被持久化缓存整块 checkpoint,状态必须是 O(1);而逐节点价格表随会话长度线性膨胀,投影带不起。被替换的区间值多少 token,投影怎么知道?
六、影子价格:把价格写进事件流本身
答案是投影不自己算,生产者报账。协议本体(surface-projection.ts:70-93,摘录):
if (event.type === 'compaction/summary' || event.type === 'compaction/prune') { const { shadowedRange, shadowedTokenCount } = event.data return { deltaTokens: 0, claim: { start: shadowedRange.start, end: shadowedRange.end, tokens: shadowedTokenCount }, }}if (!isSurfaceEvent(event)) return { deltaTokens: 0, claim: undefined }// …if (op === 'append') return { deltaTokens: tokens, claim: undefined }if (claim === undefined) return { deltaTokens: 0, claim: undefined }if (claim.start !== op.start || claim.end !== op.end) { throw new Error( `token surface: replace at seq ${event.seq} over range ${op.start}-${op.end} has no adjacent shadow price` + ` (armed claim covers ${claim.start}-${claim.end})`, )}return { deltaTokens: tokens - claim.tokens, claim: undefined }这段是干嘛的:投影侧的折叠只维护一个运行总和,加至多一个待兑现的 claim。注意看事件的先后。压缩提交时先 append 一条 compaction/summary,事件体里带着被替换区间的 token 价格,这就是影子价格;紧跟着的 replace 事件兑现它,运行总和减去 claim.tokens、加上新消息的价,claim 清空。
价格本身哪来的?压缩包里一行 reduce(region.ts:354):
shadowedTokenCount: selectedNodes.reduce((total, node) => total + node.tokens, 0),selectedNodes 是从 measure().nodes 切出来的(region.ts:344-345):影子价格就是服务侧那张逐节点表上直接求和的结果,两边共用 estimate.ts 的价。服务算 9,000,投影兑现的也是 9,000,按构造相等。
一账两册的全景图:
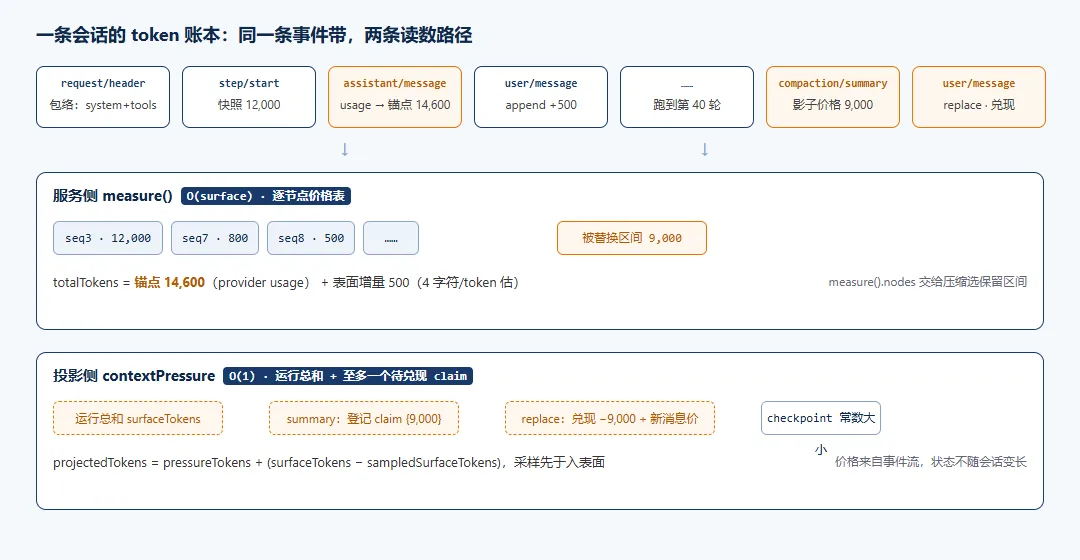
服务侧位置式记账,投影侧总量式记账,影子价格在事件流里交接
协议的两条失败策略分得很清。区间对不上,立即 throw:summary 和 replace 是生产者在同一同步段内相邻写入的,出现不一致只可能是活着的生产者违约,不是历史数据的问题。没有 claim 的 replace,折成零增量:协议启用前的旧日志,O(1) 状态重建不了区间价格,读数允许漂移,重放不许崩。
七、压缩不敢自己数数
回头看压缩那一侧的依赖声明(compaction-basic/src/index.ts:104):
static inject = ['llm', 'tokenMeter', 'sessions']触发判断的数字从计量器来(compaction-basic/src/index.ts:304):
if (measurement.totalTokens < spec.thresholdTokens) return null低于阈值直接不动。免模型剪枝之后重新 measure,循环直到低于阈值;保留区间从 measurement.nodes 尾部扣预算;摘要生成后还有一道收敛校验(region.ts:373-378):
const framedSummaryTokenCount = dependencies.meter.estimateMessage(checkpointMessage)if (framedSummaryTokenCount >= prepared.shadowedTokenCount) { throw new Error( `summary is not smaller than the shadowed content (${framedSummaryTokenCount} estimated framed tokens >= ${prepared.shadowedTokenCount})`, )}摘要不比被替换的内容小,直接拒绝提交,连错误消息都把两个数摆出来。framedSummaryTokenCount 用的也是 meter 的 estimateMessage。假设压缩自带一套计数器:摘要用自己的数,区间用计量器的数,两边口径一旦不合,就会出现压完反而更大的循环。单一读数把这条事故路径堵死了。
八、空的 invariant:等式为什么不用检查
包里还有个 invariant.ts。dsh 每个包都有不变量伴随插件,这个包的实现是空的(invariant.ts:29):
const install: InvariantInstaller = () => {}《守不变量的不是测试,是编译器和 Object.freeze》那篇讲过这套机制的语言,这里走到了它的另一面:值得留空的留空。注释给了理由,投影的 messageTokens 恒等于 measure().surfaceTokens、影子价格源自服务的同一张节点表,这些等式不靠运行时观察,因为两边共用同一个估计器、价格由同一次求和写出,等式在构造上就是真的。
三个问题收尾。
为什么不用真 tokenizer?精确计数要走模型词表,CJK 和 JSON schema 的收益撑不起这个开销。体系是按用途给精度:计费读 tokenUsage 投影,四个桶全部来自 provider 上报,一个启发式数字都没有(usage-projection.ts:19-24);放行判断读 measure(),锚点加增量,粗估只碰锚点之后的新增(index.ts:125-137);构成参考读 contextBreakdown,类型注释明示三个分量不保证加和等于总压(projection.ts:51-58)。
投影为什么不准带节点表?投影缓存会把每个 unit 的整个状态 checkpoint 进持久层(surface-projection.ts:4-7),逐节点价格随会话线性膨胀,缓存就没了 O(1) 的意义。价格写进事件流,状态压成常数,两头都保住。
锚点为什么不无条件信 provider?usage 是那次请求的真值,但拿它当未来增量的基准,前提是基准不低于同口径的启发式价,否则带符号增量会把 totalTokens 拽到虚低。index.ts:246-248 那个三元把方向固定成宁可高估,触发压缩的判断因此总是站在安全一侧。
结语
回到开场的反常:1027 行,没有一个 tokenizer,压缩的每个决定却都压在它的读数上。逐条对账。绝对精度从哪来?assistant/message 里的 provider usage,经 index.ts:246 那个三元封存成锚点,包络不变就一直在它之上加增量。增量会不会两边算得不一致?服务和投影共用 estimate.ts,压缩的影子价格是 region.ts:354 那行 reduce 从 measure().nodes 现场求和写进日志的,投影只兑现、不开口。旧日志怎么办?无 claim 的 replace 折零增量,读数漂移,重放不崩。
这篇一直站在计量器这边看压缩。下一篇换到压缩那一侧:阈值到了怎么选保留区间、摘要调用怎么复用 KV 缓存前缀、提交时那对相邻事件怎么不被并发撕开。深读第 13 篇拆 compaction-basic。
你的 Agent 上下文占用是怎么估的,tokenizer 现算,还是也养着一个 4 字符/token 的土办法?评论区聊聊。
本系列基于 DeepSeek Harness 源码(MIT,0.1.1-rc.1)与官方 Agent Notes 整理,仓库:github.com/deepseek-ai/deepseek-harness。有收获就点个关注,下一篇见。