ARTICLE · 1066197
AI改变生活:AI 语音工具盘点,让文字开口,让声音干活
AI改变生活:AI 语音工具盘点,让文字开口,让声音干活想做个视频,文案改了三遍,卡在配音上:自己的声音不好听,露脸更没戏;请配音师,一条几十到几百块,试错成本太高。 另一边,开完两小时的会,录音在手机里躺着,回头整理成纪要还得再花两小时。 收藏了一堆好文章一直没空看,心想这些字要是能像播客一样听着就好了。 这三件事,AI 语音工具现在都能接住。 放在三年前,配音得靠人、转写靠打字员外包、跟机器对话还是科幻片情节;现在打开手机,这些全是免费或者几十块钱月费的事。 一 四大能力:文字和声音互转是基本功 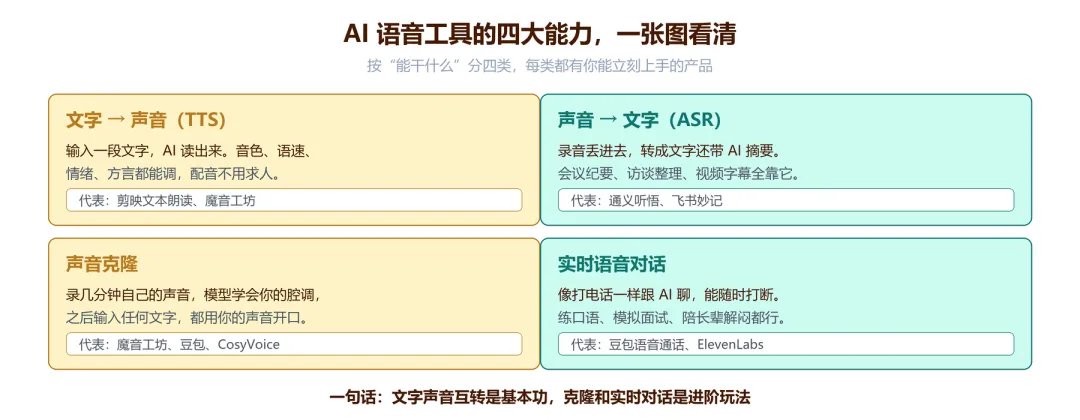
AI 语音工具的四大能力地图:互转、克隆、实时对话,每类都有代表产品 第一类,文字转语音,行话叫 TTS。 给一段文字,AI 读出来。剪映的“文本朗读”和魔音工坊是代表。音色从几十种到上千种任挑,语速能调,能加情绪——同一段词,让它温柔地读还是激动地读都行。方言也是标配,粤语、四川话、东北话都有,做地域内容很吃香。以前找配音师,一条音频几十到几百块、等一天;现在三百字稿子,十秒出声,不满意换个音色重来,成本约等于零。 第二类,语音转文字,行话叫 ASR,方向反过来。 把录音丢进去,出来的是带标点、分好段的文字稿,好一点的还自动区分说话人、写摘要。代表是通义听悟和飞书妙记。会议纪要、访谈整理、给视频做字幕,都归这一类管。一小时录音,人工整理两小时起步,机器几分钟跑完,你只需要通读改错。 第三类,声音克隆。 录几分钟自己的声音,模型学会你的音色和腔调,之后输入任何文字,都用你的声音读出来。魔音工坊、豆包都能做,开源圈还有阿里的 CosyVoice,几秒钟的样本就能克隆,免费可商用。 第四类,实时语音对话。 不是你一句它一句地轮流发语音,而是像打电话,延迟低到可以随时打断、自然接话。豆包的语音通话是代表,免费,能当英语口语陪练、模拟面试,也能陪家里老人闲聊解闷。 二 声音克隆:原理一句话,红线一条 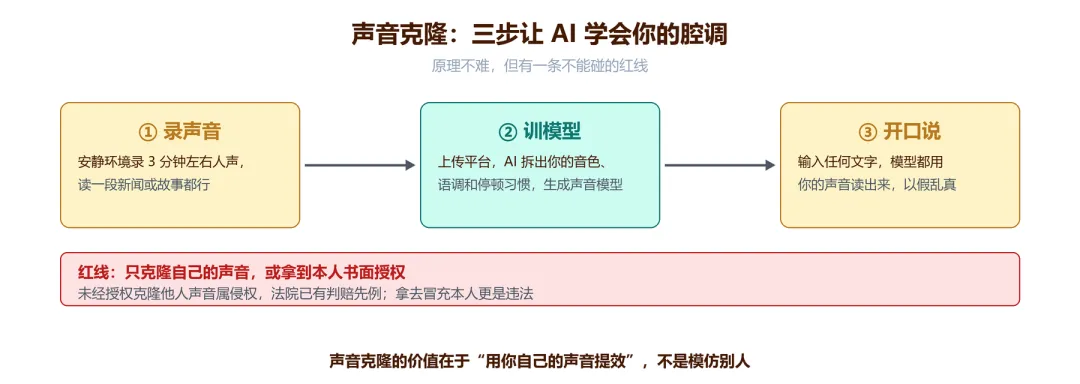
声音克隆三步:录声音、训模型、开口说;红线是仅限本人或获授权 原理不神秘。 模型先从你的录音里提取“声音指纹”——音色、语调、停顿习惯这些特征,学完之后,文字转语音那套流程就换成你的指纹来驱动。所以录音质量决定克隆质量:安静房间、离麦近一点、自然地读一段话,效果比在地铁上录强得多。 实际体验一下:打开魔音工坊或者豆包,找个安静房间,用正常说话的语速读一段两百字左右的新闻,上传等几分钟到十几分钟,模型就成了。然后输入任何文案试听,不像的地方回头补录几句话重新训练,两三轮就能到一个“熟人听了会愣一下”的程度。 红线只有一条:只克隆自己的声音,或者拿到本人书面授权。未经授权克隆别人的声音是侵权,法院已经有判赔的先例。想复刻名人、动漫角色音色的,停在“自己听着玩”这一步,公开传播有法律风险。正规配音平台都要求录制授权声明,这不是走形式。 三 三个主力工具,逐个说清楚 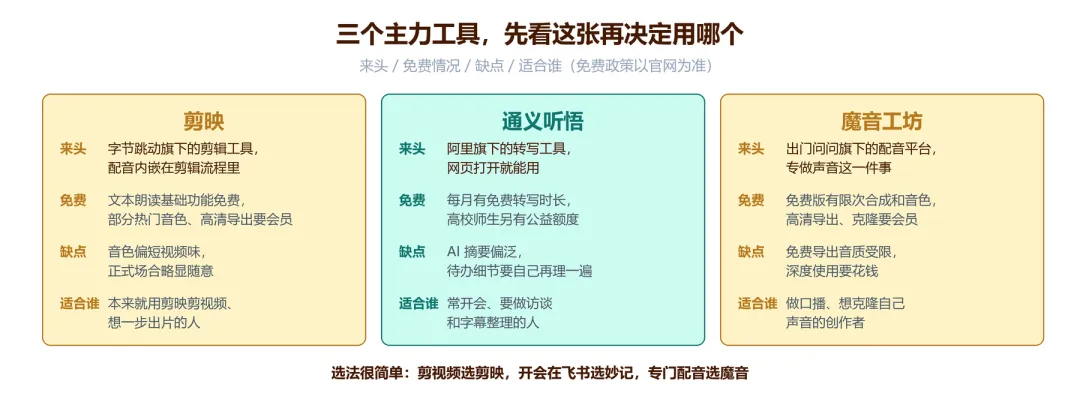
剪映、通义听悟、魔音工坊对比:来头、免费情况、缺点、适合谁 剪映。 字节跳动旗下,抖音生态的默认剪辑工具。配音就内嵌在时间轴上:选中文字轨道里的一段词,点“文本朗读”,挑个音色就出声,字幕自动对齐,不用在软件之间倒腾。基础功能免费,部分热门音色和高清导出要开会员。缺点是音色整体偏短视频味,做正式内容略显随意。适合本来就用剪映剪视频、想一步出片的人。 通义听悟。 阿里旗下,浏览器打开网页就能用,不用装客户端。转写准确率在国内属于第一梯队,转完还能让 AI 写摘要、划章节、生成思维导图。免费用户每月有几小时转写时长,高校师生有公益计划,认证后能拿到几百小时的额度,具体政策以官网为准。缺点是 AI 摘要偏泛,待办和决策项常常要自己再过一遍。适合经常开会、做访谈、整理课程录音的人。 魔音工坊。 出门问问旗下,专门做声音的平台。长处是音色库和精细控制:上千款音色,十几种中文方言,能逐句调语气、改多音字、局部变速。免费版每天有限次合成、可用音色也有限,高清导出和声音克隆要会员。缺点是免费档的水印和音质限制比较明显,重度使用一定要花钱。适合做口播、想克隆自己声音批量生产的创作者。 顺带补两个海外的。 ElevenLabs 是英文语音里自然度最好的一档,免费档每月约一万字符,做英文内容值得试。 Fish Audio 开源了模型,中文效果也在第一梯队,动手能力强可以本地部署,没有额度限制。开源这条路适合折腾得动的人:模型免费、数据不出门,代价是要自己装环境,普通用户还是先用在线产品。 四 组合玩法:一个人的有声内容生产线 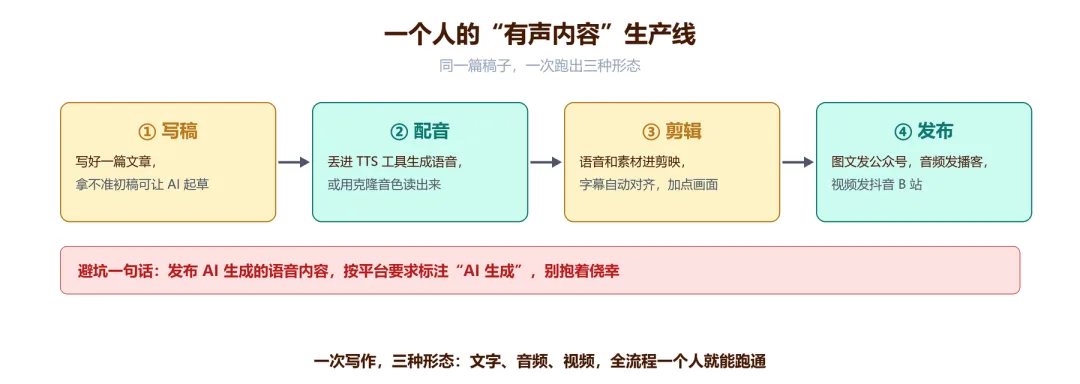
一人生产线:写稿、配音、剪辑、发布,一次产出三种形态 这些工具单看都不稀奇,连起来才是重点。假设你写了篇文章:第一步,稿子丢进 TTS 工具生成音频,或者用克隆音色读,几分钟出成品;第二步,音频和画面素材拖进剪映,字幕自动对齐,加点空镜就是一条视频;第三步,一鱼三吃——文字发公众号,音频发播客,视频发抖音和 B 站。 举个数。一篇三千字的稿子,TTS 出音频两分钟;音频加十个空镜进剪映,字幕自动生成,抠一抠错别字,半小时内出片;同样的稿子顺手就是一篇图文。以前这套流程要三个人:写手、配音师、剪辑师,一条三分钟的视频成本几百块。现在一个人加几个免费工具就够。不说产能碾压,至少原来“想做但做不动”的事,现在做得动了。 两个提示:配音前把稿子里的数字、专有名词改成你想要的读法,多音字可以改写成不会读错的词,能省一遍返工;字幕别全信自动对齐,专有名词和英文最容易错,发布前通读一遍。 五 避坑:三条都和钱、法律有关 第一,声音克隆的授权问题:只克隆自己的。 第二,平台标注义务。按国内生成式 AI 的管理规定,AI 合成的语音内容公开发布时要显著标识,剪映这类工具的免费版会自动加“AI 生成”标识,别手动去掉它,被平台限流或处罚得不偿失。 第三,AI 拟声诈骗。骗子拿几秒钟的公开音频就能仿出熟人的声音,“是我是我,急用钱”这种电话,挂掉回拨本人核实。这条转给爸妈,比转给同事更要紧。 还有个容易被忽略的坑:录音上传之前想想内容敏不敏感。在线转写工具会把音频存到云端处理,涉密的会议、涉及他人隐私的谈话,先想清楚再上传,或者找本地部署的方案。 六 今天就动手 两个动作,十分钟:把你最近写的一段文字丢进剪映,选个音色生成配音;再把一段一小时的会议录音丢进通义听悟,让它出摘要。做完你就知道,这些工具该出现在你流程的哪个位置。 进阶一点:每天开车、通勤的时间别浪费,让豆包陪你练十分钟口语,或者让通义听悟把囤积的文章转成音频听着走。语音工具最大的价值,是把眼睛腾出来——排队、做饭、散步的时间,全都能变成输入和练习的时间。