ARTICLE · 1067838
看 LangChain 文档就头大?我用“拖拽+连线“,搭了个能回答公司的 AI
说明:这是一篇个人试用记录,不是官方软文。下面的结论来自我自己跑通和翻社区反馈,不代表项目方立场。
先说我的痛点
我第一次正经想给团队搭一个"基于内部文档的问答机器人"时,照着 LangChain 的文档往下写,写到第三层嵌套就放弃了。
Chain 套 Memory 套 Retriever,每个类还各自带一堆参数。跑起来之后,数据到底在哪个环节变了样,只能靠 print 一点点猜。那种感觉,就像在黑屋子里修水管——你不知道哪一截漏了。
后来逛社区,有人提了一嘴 Langflow,说"不用写代码,拖几个方块连起来就行"。我半信半疑去试了下,结果是真能跑,而且搭完的东西不是玩具——它能直接变成一个 API 接口挂到线上。
这篇文章就聊聊:它到底怎么用、适合谁、以及我觉得哪些地方还差点意思。
[一句话解释 RAG:检索增强生成。简单说就是"先去资料库里翻出相关内容,再让 AI 带着这些资料回答问题"。比纯靠 AI 记忆回答要靠谱,因为答案有据可依。]
它到底是什么
Langflow 是一个开源的低代码 AI 应用搭建平台(MIT 协议,商用随便用)。它的核心思路特别直白:
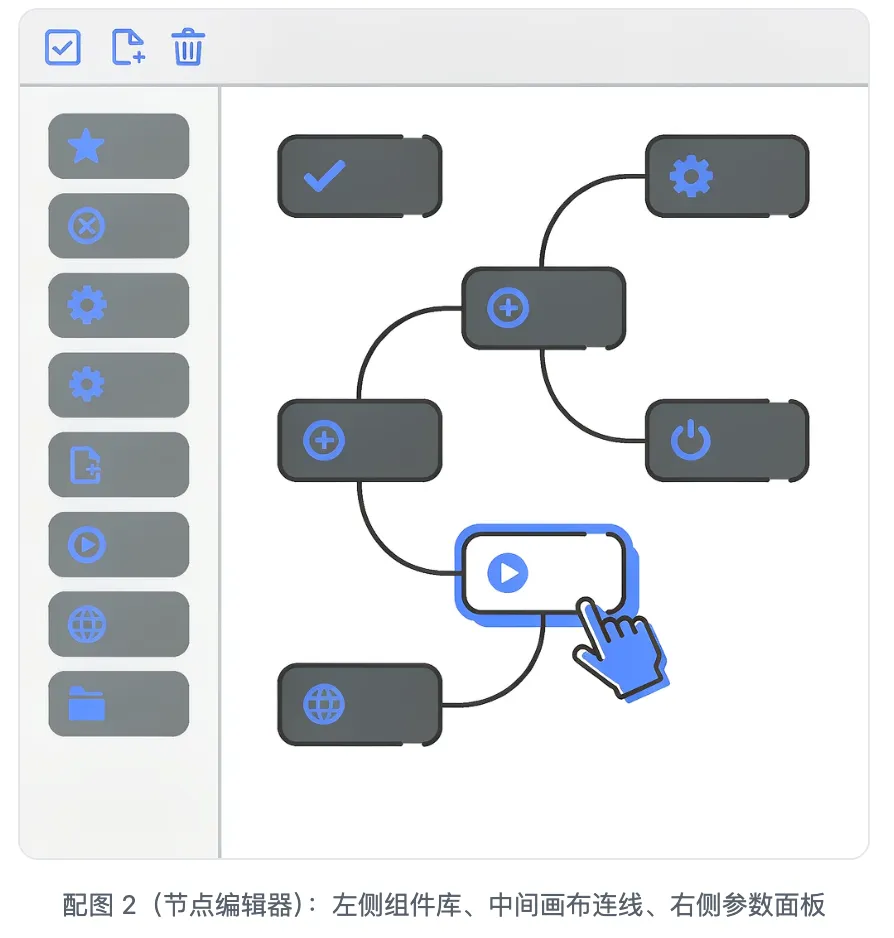
把 AI 应用里的每个零件(模型、向量库、提示词模板、工具、智能体)都做成一个能拖的方块,方块之间用线连起来表示数据怎么流动。连线画完,一个 AI 应用就成了。
举个生活化的例子:你小时候玩的"管道工"游戏,把弯管接起来让水流通。Langflow 差不多就是这个逻辑,只不过流的是数据,接的是 AI 模块。
这个项目 2023 年初就有了,最早是架在 LangChain 上面的可视化壳子,后来慢慢长成了独立生态——既能用 LangChain 的组件,也有一大堆自己的原生组件。2024 年做 Cassandra 数据库的 DataStax 把它收了,所以现在既有开源版,也有企业托管版。
几个基本面(数据来自项目主页和 GitHub,截至我写稿时):
GitHub Stars:5 万+ Forks:6,000+ 开源协议:MIT 后端 Python(FastAPI),前端 React / TypeScript 最新大版本:1.x
我上手之后,觉得最实用的几个能力
1. 拖拽画布,所见即所得
左边是一堆组件,拖到画布上、配一下参数、连上线,点右上角的 Playground 就能直接在页面里对话测试。
我特别喜欢的一点是:哪个节点出问题,点一下就能看到它收到了什么、输出了什么。 这比在代码里打 print 调试直观太多。之前是黑屋修水管,现在灯打开了。
2. 组件库覆盖面广
这是我翻完组件列表后的感受,基本主流的都齐了:
[一句话解释 向量数据库:普通数据库存的是"表格里的行",向量数据库存的是"意思相近的放一起"。用它做语义搜索,你问"怎么退款",它能翻出"退钱流程"那段,即使字面上不完全一样。]
[一句话解释 Embedding(向量化):把一段话变成一个长长的数字数组(向量),意思越接近,数组越像。相当于给文字发了张"语义身份证"。]
3. 搭完直接变 API
这是我觉得最香的一点。流程画好之后,Langflow 自动给它生成一个 REST 接口,还带鉴权和流式输出(SSE,就是那种字一个一个蹦出来的效果)。
[一句话解释 REST API:一种让不同程序互相"打电话"的约定。你发个请求过去,它回你一段数据。不用你再自己写后端服务了。]
4. 不够用?自己写个 Python 组件
内置组件满足不了需求时,可以在界面里直接写 Python,封装成一个新节点,跟其他组件无缝接上。对会 Python 的人来说自由度很高。
5. 多 Agent 协作
支持 ReAct、Plan-and-Execute 这些 Agent 模式。你可以把"搜索 Agent"“写代码 Agent”"总结 Agent"串起来,让它们分工干一件复杂的事。
[一句话解释 Agent(智能体):不像普通程序只走固定流程,Agent 能"自己决定下一步干啥"——比如先搜一下、再算一下、最后总结,像个小助手而不是流水线工人。]
6. 版本管理与团队协作
Flow(你画好的那个流程图)能导出/导入成 JSON,可以存版本、在团队间共享复用。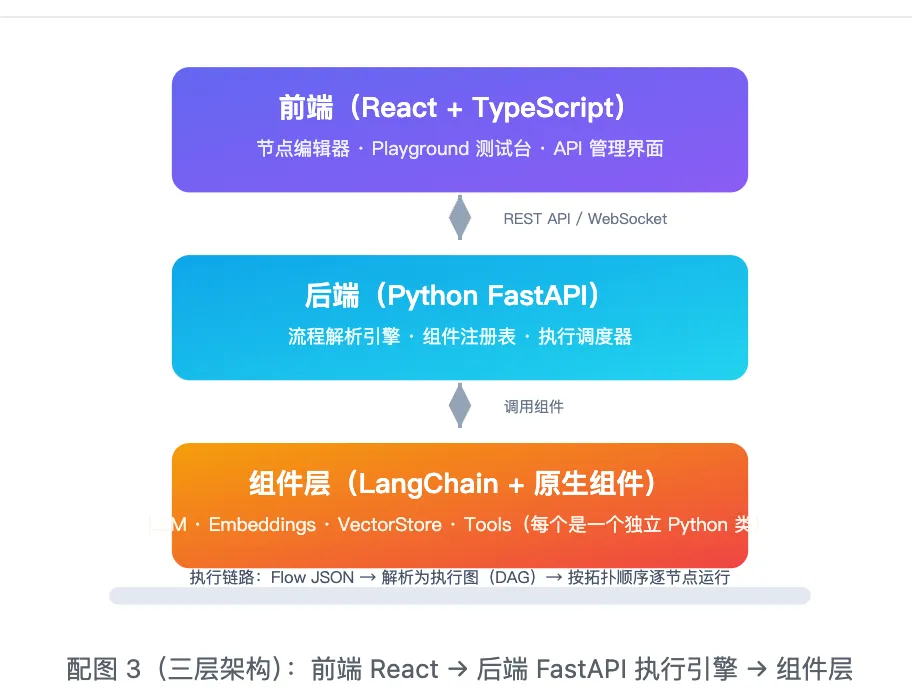
它是怎么跑起来的(架构大概)
我翻了下它的结构,整体是三层:
前端(React):节点编辑器 / 测试台 / API 管理界面↕ REST API 和 WebSocket后端(Python FastAPI):把流程图解析成执行图,按拓扑顺序挨个跑节点↕组件层(LangChain + 原生组件):每个功能是一个独立的 Python 类
[一句话解释 拓扑顺序 / DAG:有向无环图。简单理解就是"谁依赖谁"——A 的结果要喂给 B,那就先把 A 跑完再跑 B,而且不能绕回圈。]
你画好的流程图会被导出成一份 JSON,后端读这份 JSON,按依赖关系一个个节点执行,上一个节点的输出自动喂给下一个。
它的"一切皆组件"设计
Langflow 里最聪明的抽象,是把所有功能单元——不管是 OpenAI 的模型,还是你自己的 Python 函数——都归到一个统一的 Component 基类下面。官方给的自定义组件示例长这样(Python):
from langflow.custom import Componentfrom langflow.io import MessageTextInput, Outputfrom langflow.schema import Dataclass MyCustomComponent(Component):display_name = "我的自定义组件"description = "一个示例自定义组件"inputs = [MessageTextInput(name="input_text",display_name="输入文本",info="待处理的文本内容"),]outputs = [Output(display_name="处理结果",name="output",method="process_text"),]def process_text(self) -> Data:result = self.input_text.upper() # 示例:转大写return Data(data={"text": result})
这个设计的妙处是:你在类里声明一下输入输出,界面上的配置面板就自动生成了,不用单独写前端;而且输出类型和输入类型对不上时,连线的时候界面会直接提示你。
实战:我拖了一个"PDF 问答"出来
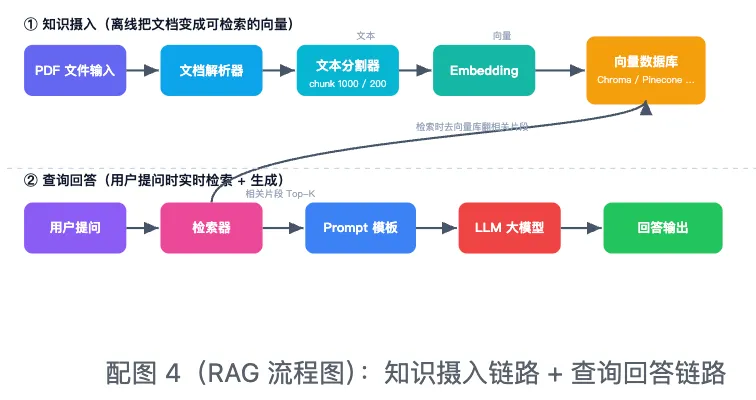
以"基于 PDF 文档的问答系统"为例,我在画布上连了这么一串节点:
[PDF 文件输入]↓[文档解析器] ← 把 PDF 拆成文字↓[文本分割器] ← 切成一段段,chunk_size=1000, overlap=200↓[Embedding 模型] ← 把每段变成向量↓[向量数据库] ← 存起来↑[用户提问] → [检索器] → 找出最相关的几段(Top-K=4)↓[Prompt 模板] ← "根据下面内容回答:{context} 问题:{question}"↓[LLM 大模型]↓[回答输出](流式)
[一句话解释 分块(Chunk):长文档不能整篇塞给 AI,得切成小段。chunk_size 是一段多大,overlap 是相邻两段重叠多少,防止一句话被切两半。]
[一句话解释 检索器(Retriever):你提问时,它去向量库里翻出最相关的几段文档,交给大模型当"参考资料"。]
最爽的是调参:我想改 chunk 大小或者换模型,直接在节点面板上改,改完在 Playground 里重测,比改代码、重启服务快得多。
搭好的 Flow 能导出吗?能,而且不锁你
Langflow 不是黑盒。构建好的流程可以导出两种东西:
① JSON(用来部署或存版本)——就是一份描述"有哪些节点、怎么连"的文件。
② Python 代码——导出的代码直接调 LangChain 或底层 SDK,能在任何 Python 环境里跑,不再依赖 Langflow 服务本身。也就是说,你可以把它当开发和调试工具,生产环境跑纯 Python。
还能接进 AI 编程工具(MCP)
Langflow 1.x 开始支持把 Flow 暴露成 MCP 工具。配置好后,你在 Claude Code、Cursor 里就能直接说"查一下公司退款政策",它会通过 MCP 调你搭好的 RAG,返回基于真实文档的答案。
[一句话解释 MCP:一种让 AI 工具(比如编程助手)调用外部能力的标准接口,类似给 AI 装了个"万能插头"。]
配置大概长这样(JSON):
{"mcpServers": {"my-rag-flow": {"url": "http://localhost:7860/api/v1/mcp/flows","apiKey": "your-langflow-api-key"}}}
和 Dify、n8n 比,怎么选
我翻了一圈社区讨论,三家定位不太一样,简单对比:
我的看法:如果你需要精细控制 RAG 的每个环节(分块大小、检索条数、重排器等),团队里又有会 Python 的人,Langflow 很顺手;如果你想开箱即用、少配置,Dify 可能更舒服;如果你主要是做各种自动化流水线、AI 只是其中一环,n8n 更对口。
三种上手方式(代码都留着)
方式一:pip 装(本地体验最方便)
pip install langflowlangflow run # 默认开在 http://localhost:7860
方式二:Docker 跑
docker run -p 7860:7860 langflowai/langflow:latest方式三:uv(生产部署推荐)
uv pip install langflowuv run langflow run
用 Python SDK 调已搭好的 Flow:
from langflow.load import run_flow_from_jsonresult = run_flow_from_json(flow="my_rag_flow.json",input_value="公司的退款政策是什么?",tweaks={"OpenAI-xxxx": {"model_name": "gpt-4o"},"ChromaDB-yyyy": {"collection_name": "company_docs"}})print(result)
用 REST API 调:
curl -X POST \"http://localhost:7860/api/v1/run/{flow_id}" \-H "Content-Type: application/json" \-H "x-api-key: your-api-key" \-d '{"input_value": "公司的退款政策是什么?", "stream": false}'
谁适合用,谁先等等
适合:
想快速验证一个 RAG 想法的开发者,先拖出来跑通再落地代码 不擅长后端、但需要搭私有文档问答的产品 / 数据同学 想要一个标准化平台、让团队共享复用 Flow 的技术团队
可能不太适合:
完全不想碰任何概念、只想点几下就出效果的——它还是要求你懂点 RAG / LLM basics 追求极致简单、零配置开箱即用的——这类需求 Dify 可能更对路
一句话总结
Langflow 干的事,是把"会写 LangChain 代码"这个门槛,降到了"会连线"——而且没牺牲掉对细节的控制力。如果你也被嵌套代码劝退过,值得花半小时拖一把试试。
官方资源(都是公开链接):
GitHub:github.com/langflow-ai/langflow 文档:docs.langflow.org 社区:Discord(langflow 频道)