ARTICLE · 1067844
数据从千万到百亿级,KES文档版的分布式答卷
在企业的数智化转型中,文档数据库承担着关键支撑作用。IDC统计显示,文档数据库是中国非关系型数据库软件市场中规模占比最高的细分品类,3年前整体市占就超过了60%。这个品类中,MongoDB是绕不开的名字。但企业真正落地时,需求并不单一。
面向中小型业务系统,通常采用架构更简洁、管理维护更简单的单机或副本集形态。金仓数据库的协议兼容、功能对等、单机性能、企业级高可靠高安全等相关能力,已经过众多用户实践验证。
而面向数十亿甚至百亿级的超大数据规模、超高并发读写,就需要具备横向扩展能力的分布式架构。政务的证照共享与一网通办、金融的用户画像与风控事件流、能源的设备采集与运行日志、运营商的行为分析,都是典型场景。这也是电科金仓重点投入方向之一:在金仓数据库(KES)融合多模内核基础上,用已有的分布式数据库组件KSOne,把数据节点的能力从关系模型扩展到文档模型,使KES文档版在保持MongoDB协议兼容的同时,具备横向扩展能力。
三层分布式架构:继承内核级企业能力
KES文档版分布式集群采用三层架构。
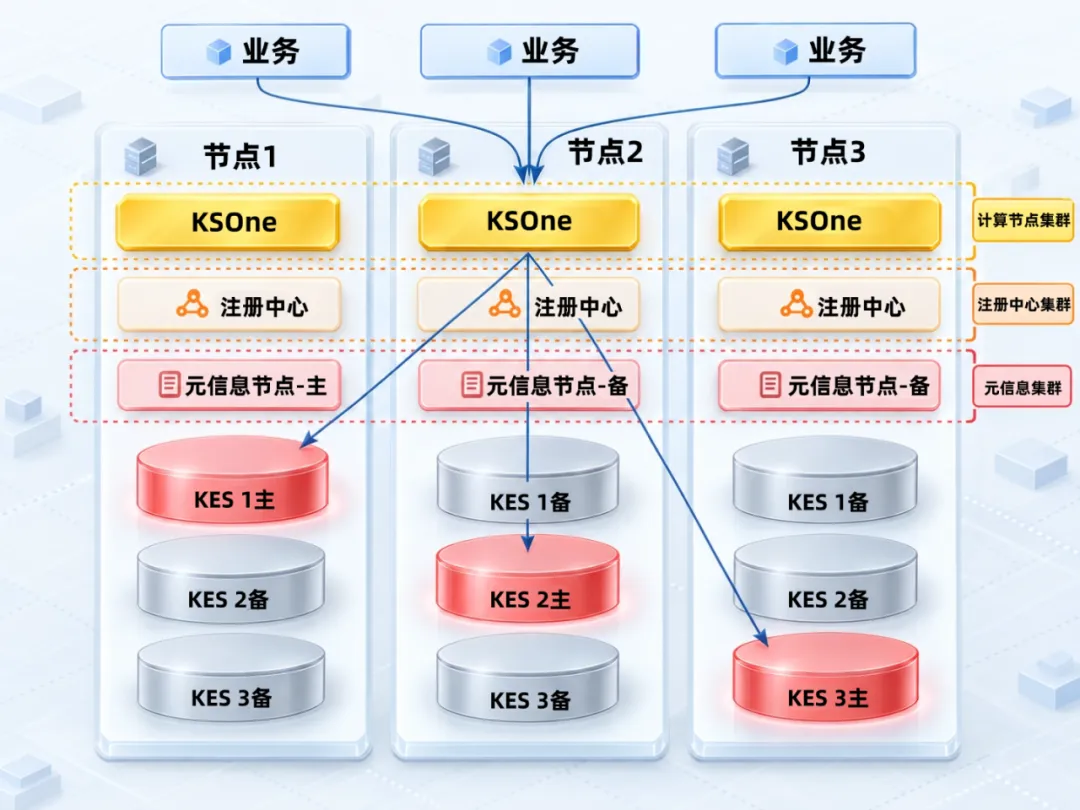
计算层是KSOne代理节点,无状态、多活并行可读写,负责查询路由与结果汇总,可按连接压力横向增加节点。
元信息层由注册中心与KES元信息集群组成,管理分片拓扑与路由元数据。
存储层的每一个数据分片,都是一个KES文档实例,并可按需配置多副本。
关键在存储层的KES内核。主备高可用、备份恢复、透明加密、统一管控等企业级能力都继承自KES,KES具备的,它天然具备。由此带来三点优势:
▷ 应用透明:应用仍按MongoDB协议访问,只需要修改连接地址。
▷ 灵活扩展:算力不够扩算力,容量不够扩容量,弹性伸缩,不用停业务。
▷ 更低OPEX:集成KES的统一管控、备份恢复、加密等企业级能力,运维更简单。部署平台覆盖X86、飞腾、鲲鹏、龙芯,单机与集群两种形态可以按业务规模选择。
能力一:兼容性
替换MongoDB,最怕的不是性能,而是既有业务跑不起来。KES文档版对MongoDB 5.0+通信协议原生兼容,常用命令与操作符兼容度接近100%,业务迁移只需调整连接地址。
我们按功能域完成了60+项验证,全部通过:
数据类型与索引:复合索引、TTL索引、全文索引
数据操作:CRUD、查询操作符、聚合管道
大对象存储:GridFS协议
管理与诊断:13项管理命令、13项诊断命令
安全:SCRAM-SHA-256认证
备份与迁移:兼容mongodump/mongorestore/mongoexport/mongoimport
集群:集群管理命令与集群级功能等
能力二:分片和路由
1
分片键与路由策略
• 分片键支持:支持单字段与多字段组合。
• 分片策略:配套提供四种分片策略。
• 路由类型:按集合类型提供三种路由方式:
• 分片集合:按分片键定向到目标分片;若未带分片键,则路由给所有分片并行执行。
• 广播集合:每个实例上都保存全量数据。写入时同时落到所有实例,读取时可任选其一。
• 未分片的单集合:由元信息直接定位到某个具体实例。
2
跨分片关联查询解决方案
分片切分后,关联查询是首要面临的挑战。KES文档版通过以下两组机制进行处理:
• 绑定集合(解决大表关联)
当两个数据量大且分片规则一致的集合进行关联时,对应的分片会落到同一节点。这使得“跨节点关联”转化为“节点内关联”,从而避开跨分片笛卡尔积带来的性能损耗。
• 广播集合(解决小表关联)
针对读多写少的小字典表,在每个实例上保存全量数据。当分片集合与其关联时,可以就地完成计算,无需在节点之间搬运数据。
能力三:性能
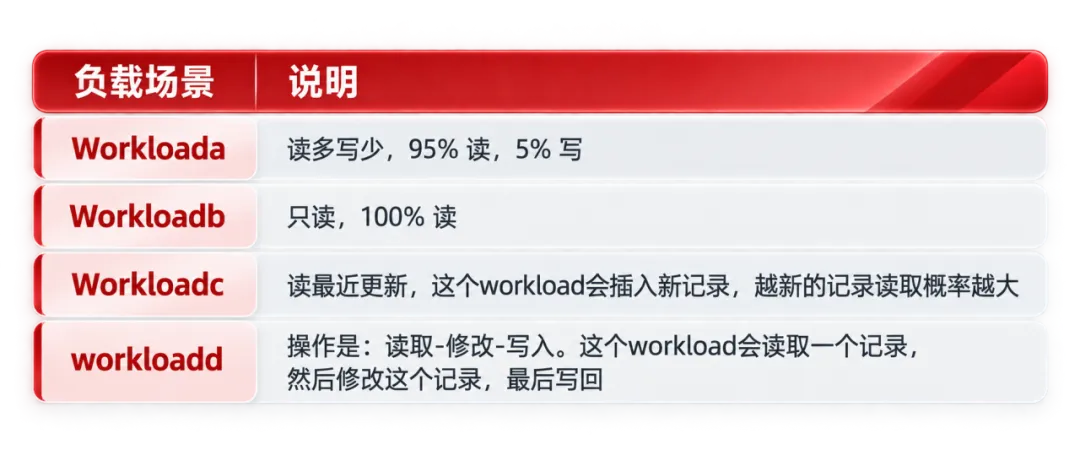
为验证KES文档版分布式在不同数据规模和访问模式下的性能表现,我们基于YCSB基准测试工具开展KES与MongoDB分布式版本的对比测试。测试统一采用 batchsize=10000、100并发配置,分别针对 100万条数据和1亿条数据两种规模进行测试,并覆盖读多写少、纯读、热点数据读取以及读改写四类典型负载场景。
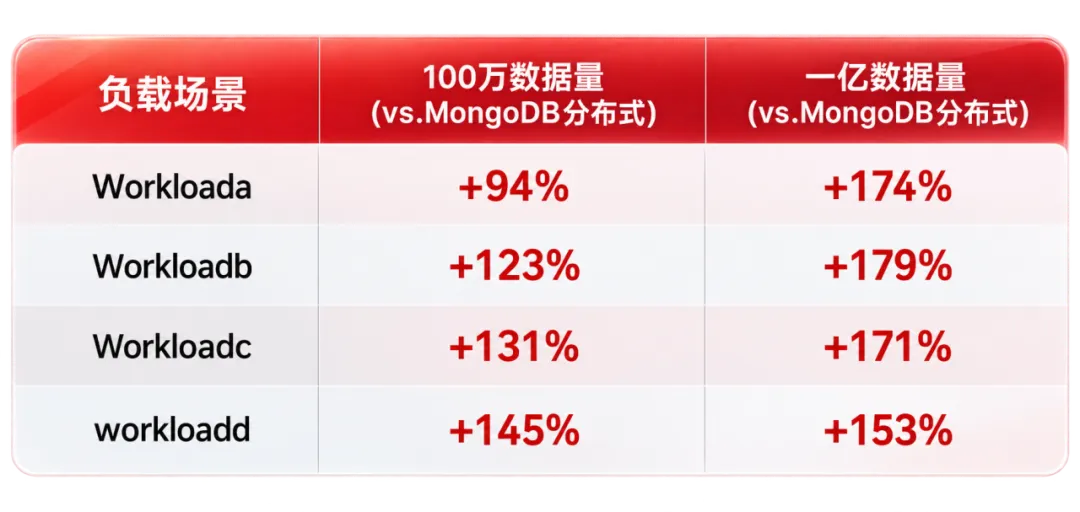
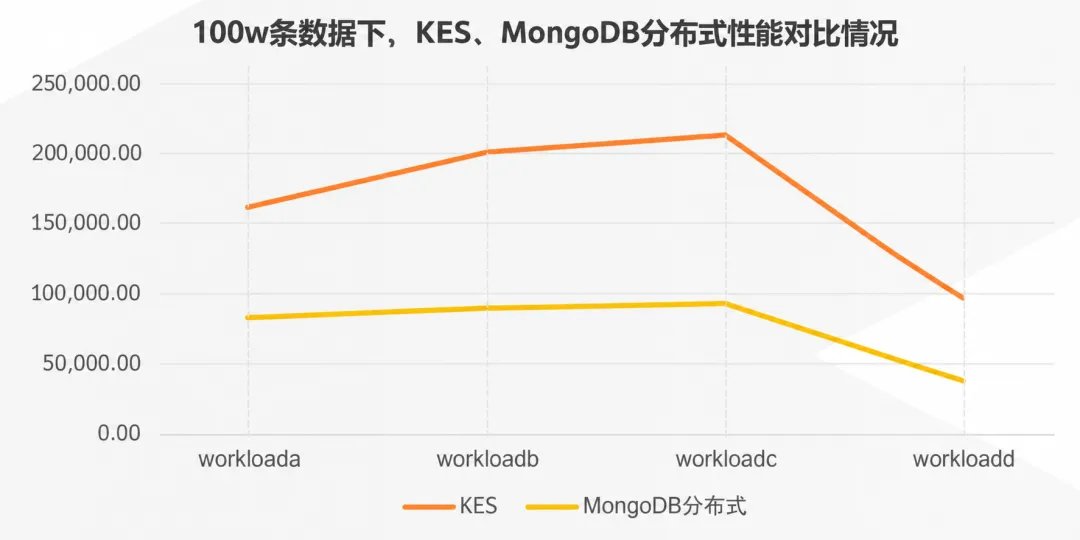
在100万条数据规模下,KES已经表现出较好的吞吐优势。在读多写少、纯读以及热点读取场景中,KES相比MongoDB分布式分别提升94%、123%、131%,对于包含更新操作的读改写场景,KES优势的更为明显。
当数据规模提升至1亿条后,随着数据访问压力增加,KES与MongoDB分布式版本之间的性能差距进一步扩大。测试结果显示,在四类负载场景下,KES相比MongoDB分布式版本性能提升达到153%~179%。
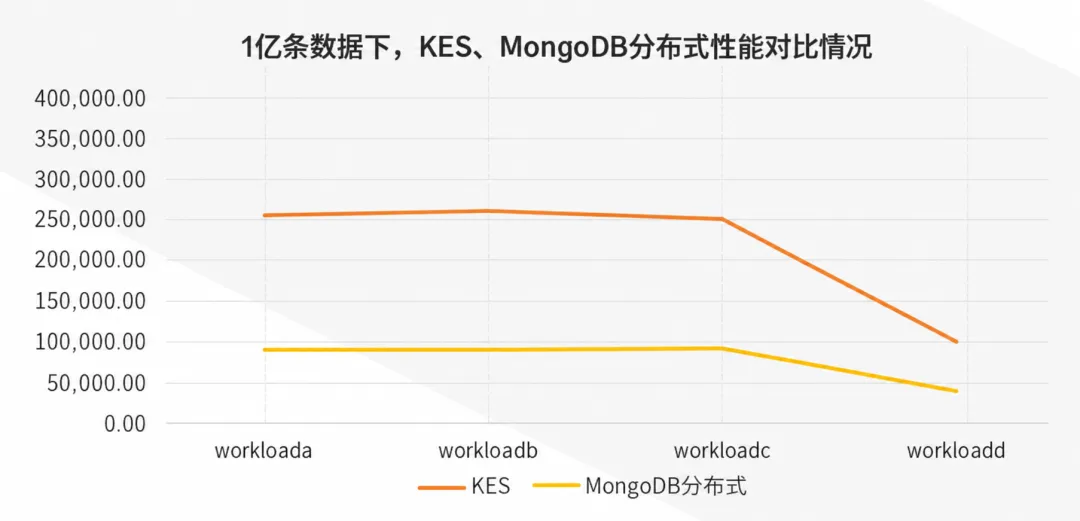
综合不同数据规模和业务负载测试结果,KES文档版分布式集群在百万级到亿级数据规模下均保持稳定吞吐能力,并在高并发访问场景中展现出良好的性能扩展性。
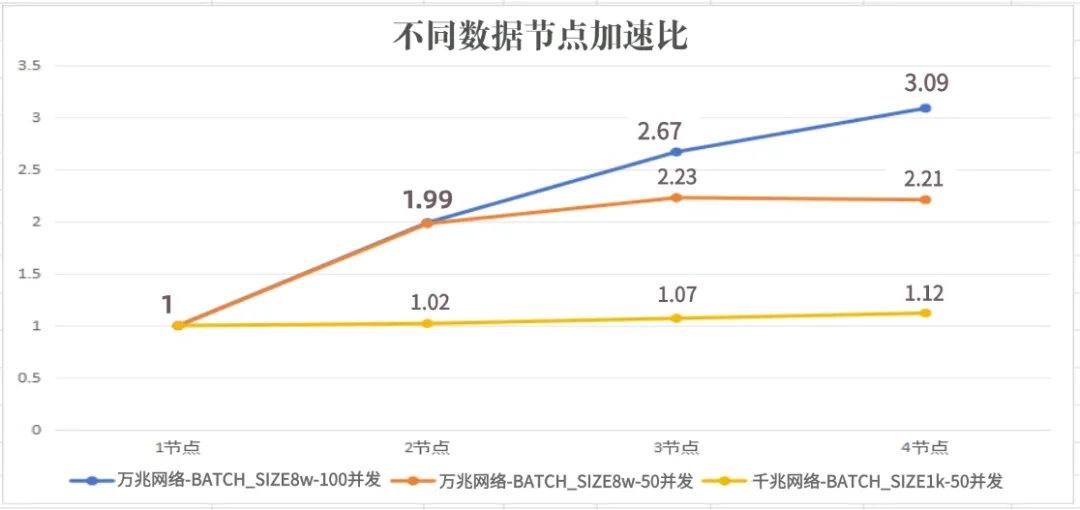
在具体落地方面,我们在某电力系统中,采用KES Sharding部署1个计算节点 + 4个数据节点,并用JDBC接口进行压测,100 并发,batchsize 80000情况下,1亿行数据24.33秒完成写入,平均写入速度为411.01万 row/s;1440亿数据入库仅耗11.01小时。
后信创时代,市场标准在变。标准变了,产品要走的路也不一样。兼容与平替解决的是“能不能换”,那是入场资格,不是终点。电科金仓坚持多走一步——从平替到超越,从超越到引领。KES文档版的sharding能力就是其中一步:它让文档库的替换场景更全面,也让替换之后的数据底座留有继续生长的空间。未来,我们会沿着多模融合的路继续走,用扎实的工程基础和长期的技术积累,结合AI创新,让企业在替换的每一步都有确定的技术支撑,为智能世界注入中国力量。

供稿:数据库产品研发中心
编辑:格格
审核:日尧
部分插图由AI辅助生成