ARTICLE · 1070861
AI 进了审批流之后:一份来自深水区的落地复盘
1深水区的真相
卡住 AI 的三堵墙,都不在模型这边
先看一组来自真实落地现场的数据。这套 AI 审批助手的官方能力,判定结果与人工的一致率已经做到 95%+——而且在"AI 拒绝、人工同意"的分歧案例里,复盘下来往往是 AI 判得更严谨。模型层面,它早就"够用"了。
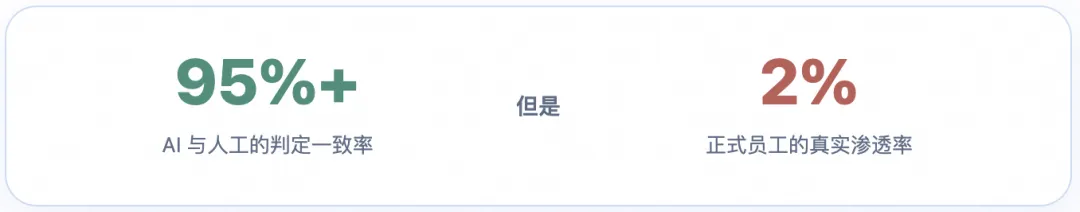
更扎心的是:贡献了大部分自动审批量的,是极少数"超级用户"——头部两个人就占了四成以上的任务量。换句话说,这不是一个被组织用起来的产品,而是几个高手的自留地。
这就是深水区的典型症状。把它拆开,是三堵墙:
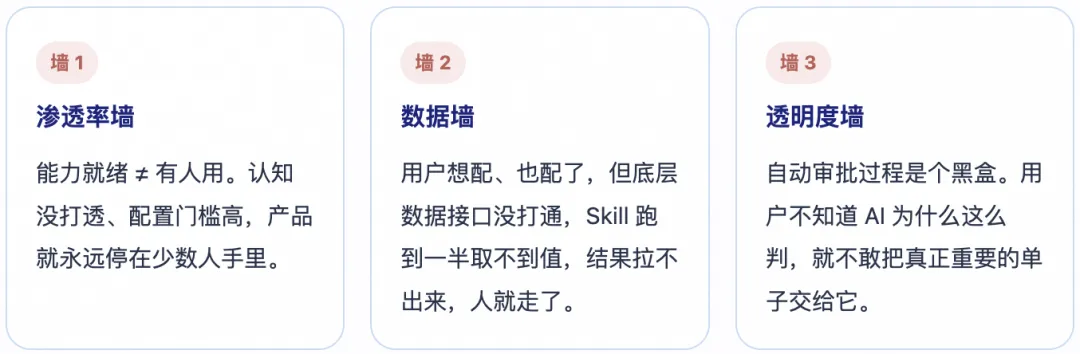
反直觉的第一课:当你的 AI 准确率已经过关,落地的瓶颈会整体后移——从"模型准不准"变成"数据通不通、用户会不会配、过程敢不敢信"。继续堆模型能力,边际收益极低;把力气花在这三堵墙上,才是真正的杠杆。
2AI Skill 不能像软件那样测试
从"上线即交付"到"上线才开始"的品控范式转移
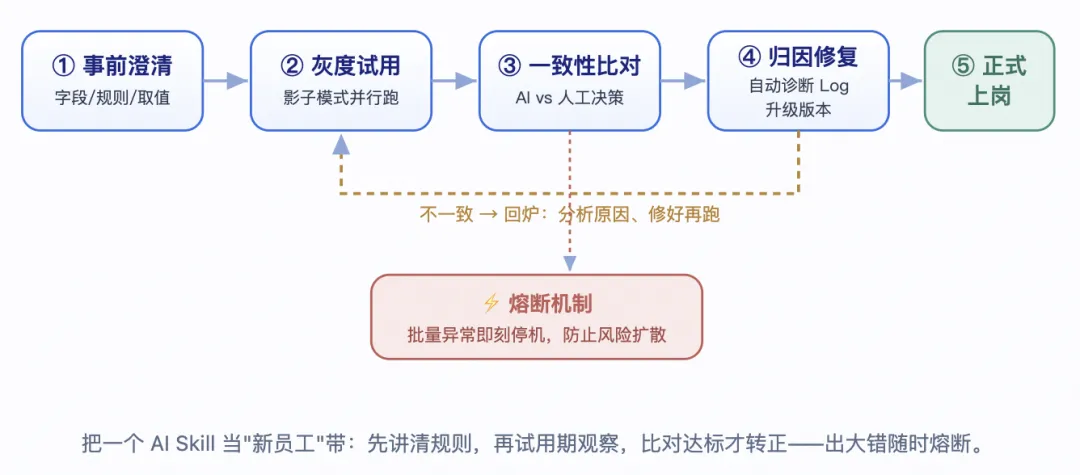
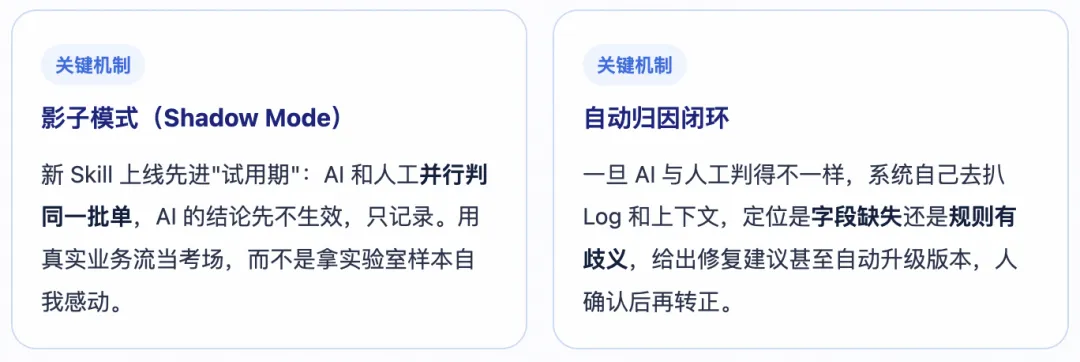
传统软件有确定的输入输出,测完就能上线。但一个 AI Skill 面对的是不确定的语义、不确定的数据、不确定的边界——你没法用一次性回归测试保证它永远对。所以这场会上最有价值的共识,是给 AI Skill 设计了一套动态品控生命周期,而不是把它当普通功能发出去就不管了。
3评测体系:护城河,还是照妖镜
"95% 准确率"这句话,到底硬不硬,全看评测题
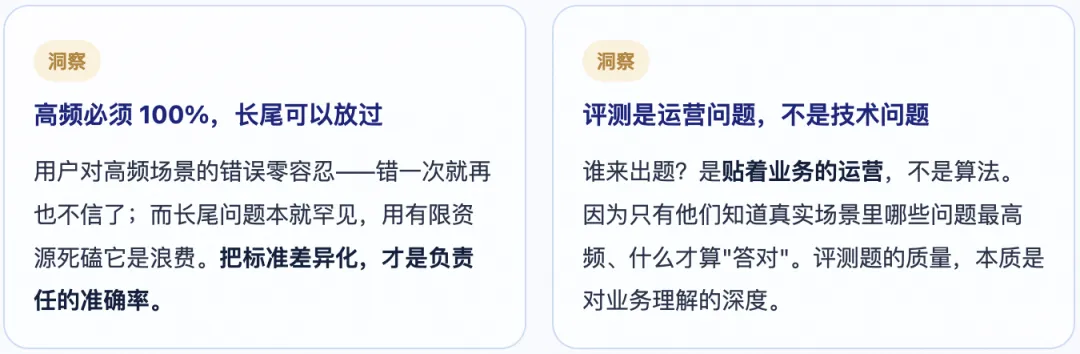
会上有句话我记了下来,大意是:"评测题决定了我们这个 95% 的过硬程度。如果评测题很烂,就会有人从评测题上找漏洞。" 这戳中了一个普遍的自欺欺人——很多团队报出来的"准确率 95%",其实是拿自己出的、偏简单的题考出来的成绩。
他们的做法是分层设定基准,而不是笼统追一个平均分:
| 100% 必须答对 | ||
| 允许 75%–85% 容错 | ||
| 整体达到 95% |
4从"工具"到"服务"
别再等用户反馈了——四类人群,四种主动运营
我觉得最大的思路转变,是从"做一个等人来配的工具",转向"主动上门服务的 Agent"。核心动作只有一个词:主动——主动发现断点、主动推荐授权、主动答疑,而不是被动等用户来投诉。落到运营上,是四类人群、四种打法:
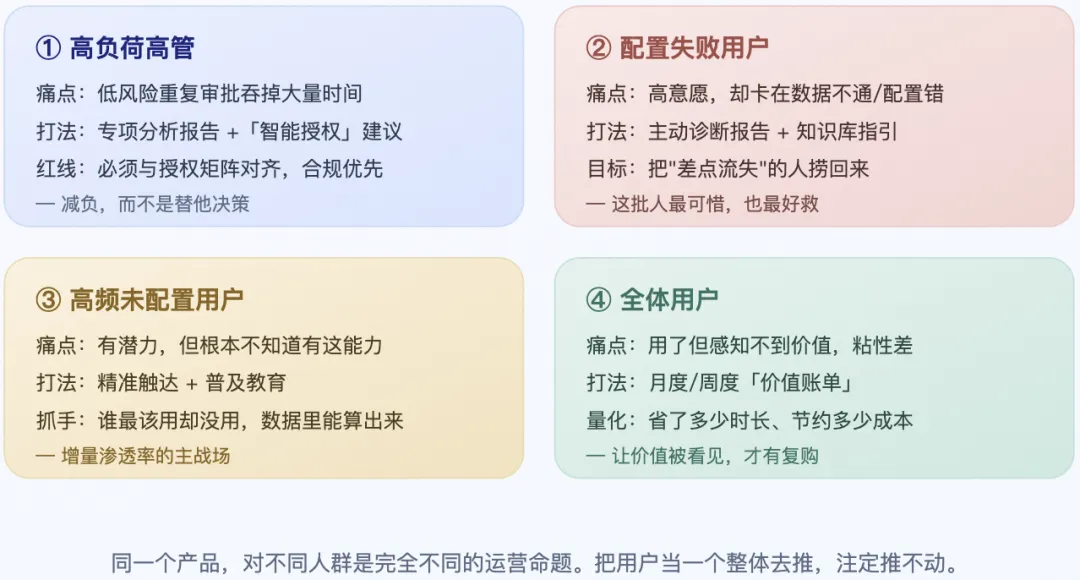
其中我最想强调第 ④ 类——价值账单。这几乎是所有 AI 产品都欠用户的一样东西:用户其实感受不到 AI 帮他省了什么,直到你用一张账单把"这个月你少批了多少单、省了多少小时"摆到他面前。说不清价值,用户就会默默流失;把价值量化出来,才谈得上粘性。
- 别再盯着准确率了。
先算渗透率和头部用户集中度——如果 Top 几个人贡献了大半用量,你做的是玩具,不是产品。 - 先打数据墙,再谈能力扩张。
用户配了却跑不出结果,比没这功能更伤人心。底层接口连通性,往往比模型更值得投入。 - 给每个 AI Skill 设"试用期"。
影子模式并行跑、和人工比对达标才转正,别上线即放养。 - 让系统自己找错。
不一致就自动归因(字段缺失还是规则歧义),能自动修就自动升级版本。 - 装一根熔断保险丝。
批量异常立即停机,AI 犯错的下限必须由机制兜住。 - 评测题让运营来出,且分层。
高频 100%、长尾容错,加权达标——评测题的质量就是你准确率的含金量。 - 变被动为主动。
主动诊断断点、主动推荐授权、主动答疑,别等用户投诉。 - 给用户开一张价值账单。
省了多少时长、多少成本,量化出来,价值才被看见。
总结:从"帮我批这一单"到"看整条链路"
今天的数字人还只是"帮我批这一单"的授权工具;但当它能端到端地看懂整条流程链路时,可能就不再需要业务方一个个手动配 Skill 了——AI 自己就能从流程里长出该有的能力。
这也是"智能审批"改名叫"智能流程规划"的真正原因:审批只是流程的一个切口,真正的终局是让 AI 理解并优化整条流程。而通往那里的路,不在更大的模型里,在这些不性感、却必须一件件啃下来的深水区工程里。