ARTICLE · 1076372
AI 两天生成 LTE Turbo 译码器并上板
封面:两天内完成 LTE Turbo 译码器;AI 驱动 RTL 生成、架构优化和上板验证。
简介|两天内,从任务推进到上板。
Harness 把一个此前没有实现过的 LTE Turbo Decoder 推进到可综合 RTL、硬件结构优化、同口径比较,以及包含 ZU67DR 上板测试的完整验证链。从首个 LTE 工件进入仓库到重写后实现重新验收、帧吞吐与延迟比较闭合,用时约 33 小时。
这条链路由 AI/Agent 生成和修订候选,自动运行模型、RTL、实现与板级门禁,再由证据决定候选是否留下。它没有掩盖失败:初始 forge 没有独立完成 SISO 和 Turbo engine,architect agent 接管补齐 RTL,所有后续候选仍接受同一组固定门禁。
最后的结果也并不完美:相对同器件、同流程下的 MathWorks HDL 生成设计,我们的 LUT、FF、频率和帧吞吐更好,首判决延迟却多了 684 个时钟。这个未被修剪成单一胜利的结论,恰好说明 AI 自动化已经从“生成一段代码”推进到“交付一个经过架构取舍和分层验收的 IP 候选”。
上一篇AI 做 FPGA 设计,怎样从“能跑”走到“可验收”?已经系统说明怎样划分候选权与验收权、建立有限修订循环,以及如何组织证据包。这一篇不重复操作方法,直接检查那套方法能交付什么:一个复杂通信译码器能否在两天内完成结构优化、实现测量和上板验收。
目录
- ▶一、先看一个不够漂亮、却更可信的结论
- ▶二、最终采用了怎样的硬件结构
- ▶三、AI 优化要搜索结构轴,而非代码行
- ▶四、同口径比较:赢在哪里,输在哪里
- ▶五、验证闭环:不仅要会通过,还要会拒绝
- ▶六、两天交付,对批量 IP 生产意味着什么
1先看一个不够漂亮、却更可信的结论
真正的亮点先看用时。2026 年 9 月 23 日下午,LTE golden vectors、QPP 表、参考模型和基线脚本首次进入仓库;约 29 小时后,译码器完成 ZU67DR 板级 playback 与故意错误 refutation;约 33 小时后,重写后的 RTL、真实帧吞吐/延迟测量和同流程比较全部重新闭合。
两天内,AI 驱动的 Harness 完成了 RTL 生成与修订、微结构优化、实现测量、独立交叉验证和上板测试。
先不谈 Agent,不谈提示词,也不谈模型排行榜。看同一个问题上的五个数字:K=6144、6 次迭代、5-bit 输入,两边都在 xczu67dr-fsve1156-2-i 上完成 out-of-context place-and-route。
如果只想写一条适合传播的标题,可以挑前五行;如果要做工程决定,就必须把最后一行也留下。当前实现用更多时间复用换面积,在真实帧上得到更高吞吐,但第一比特出来得稍晚。按照“一个点在所有目标上都不差、至少一项更好”这一 Pareto 判据,结论是:neither dominates,双方都没有支配对方。
这里还有一个容易漏掉的限定:MathWorks 参考记录了首输出时刻,却没有记录下一帧何时被接收,所以 28.0 Mb/s 是由“首输出 + K 个输出”推出来的上界。它已经足以支持当前比较,但不能被写成更精确的持续吞吐测量。
AI 自动化流程的输出不应该是一句“我赢了”,它需要交付一组带口径、带边界、能支持决定的取舍。
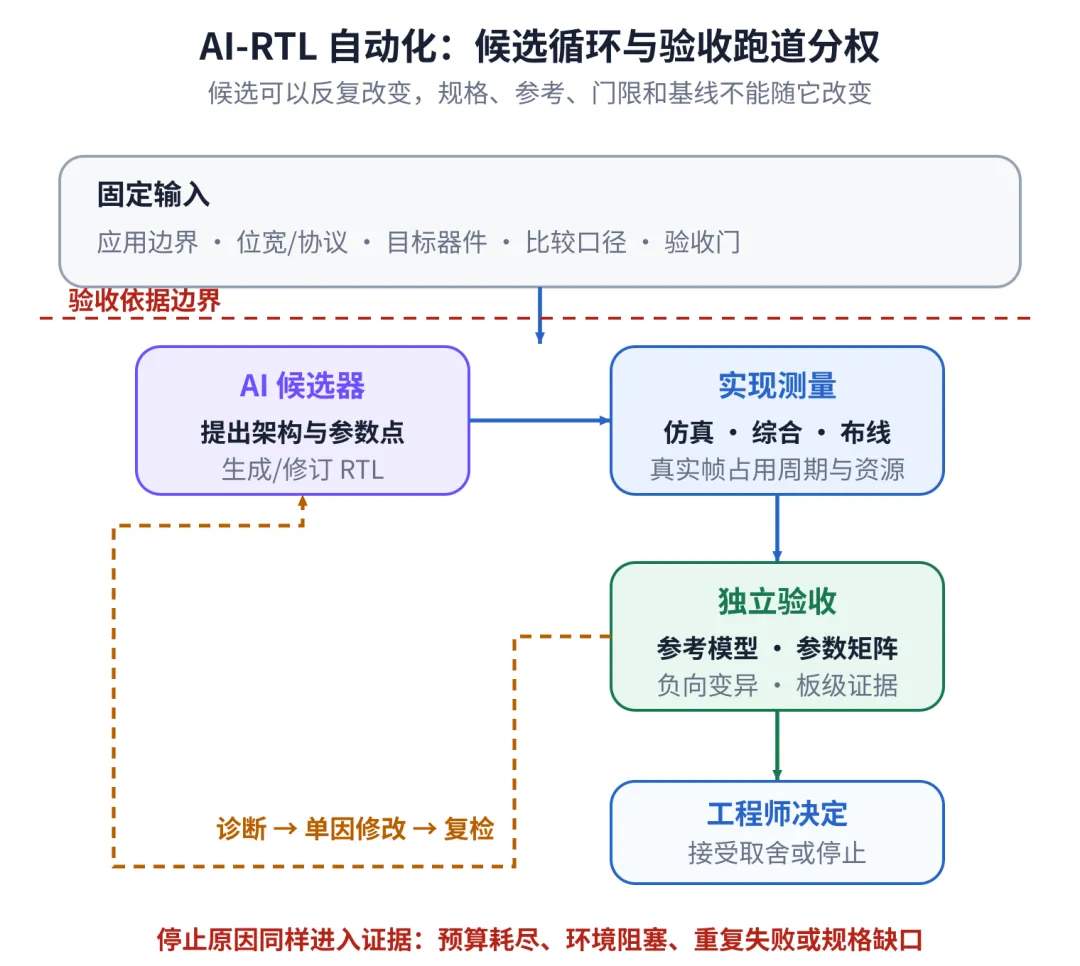
AI-RTL 自动化流程:固定应用边界、位宽协议、器件、比较口径和验收门;AI 候选器提出架构与 RTL,交给仿真综合布线和独立验收,失败经诊断后单因修改并复检,工程师决定接受或停止。
在这套流程里,模型和 Agent 只有候选权:可以提出微结构、参数点和 RTL 修改。规格、参考模型、测试、门限、基线和最终签核不应随着候选一起被改写。AI-RTL 研究也在把编译、仿真和覆盖反馈接回生成循环;但论文 benchmark 的通过率只是方法背景,不能替代具体项目自己的验收证据。
2最终采用了怎样的硬件结构
LTE Turbo Code 的抽象描述很短:两个相同的递归系统卷积分量码并联,中间通过 QPP(Quadratic Permutation Polynomial)交织;译码时,两套软输入软输出过程交替交换外信息。Max-Log-MAP 用 max 近似 log-domain MAP 的 Jacobian 修正,减少计算复杂度,代价是算法近似。
算法留下了多种硬件可能:可以复制两套分量译码器,也可以复用一套计算核心;可以增加并行度换吞吐,也可以用帧存储和调度换面积。最终实现选择了明确的面积—时间折中:一套 siso_maxlog、一套 qpp_interleave、一套外信息存储。6 次完整迭代由同一套计算核心完成 12 个半迭代。
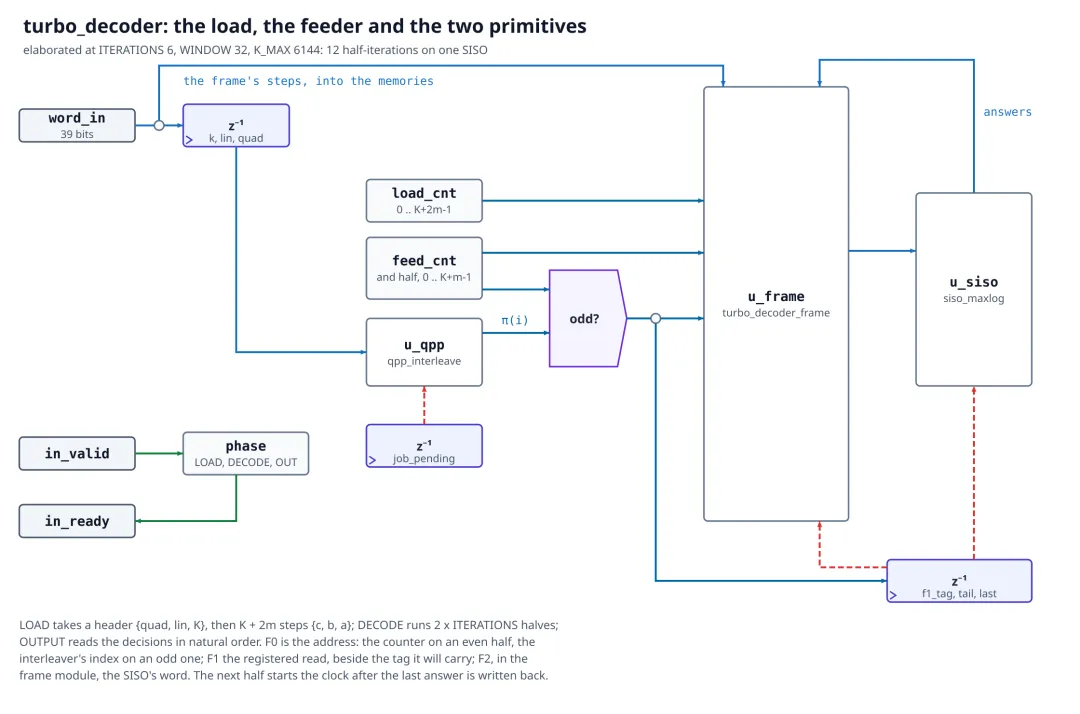
源码绑定的 feeder 微结构:输入 header 和帧数据进入 frame memories;偶数半迭代使用 feed counter,自然地址;奇数半迭代使用 QPP index;一套 SISO 输出经 tag 返回 frame。点击图片查看原图。
上图是从当前 RTL 生成并通过源码绑定审计的结构图。自然序和 QPP 序共用同一条 SISO 通路,标签把计算结果送回正确的自然码块位置;这项选择直接解释了为什么迭代次数增加时资源几乎不变,而帧时间明显增加。
应用边界也被明确冻结:仓库中的 QPP 表覆盖 188 组 LTE 码块参数,K 从 40 到 6144,RTL 的 K_MAX=6144。它是一个 LTE Turbo 译码引擎,不包含 CRC、码块分段、速率匹配、HARQ 缓冲和完整基带链路。
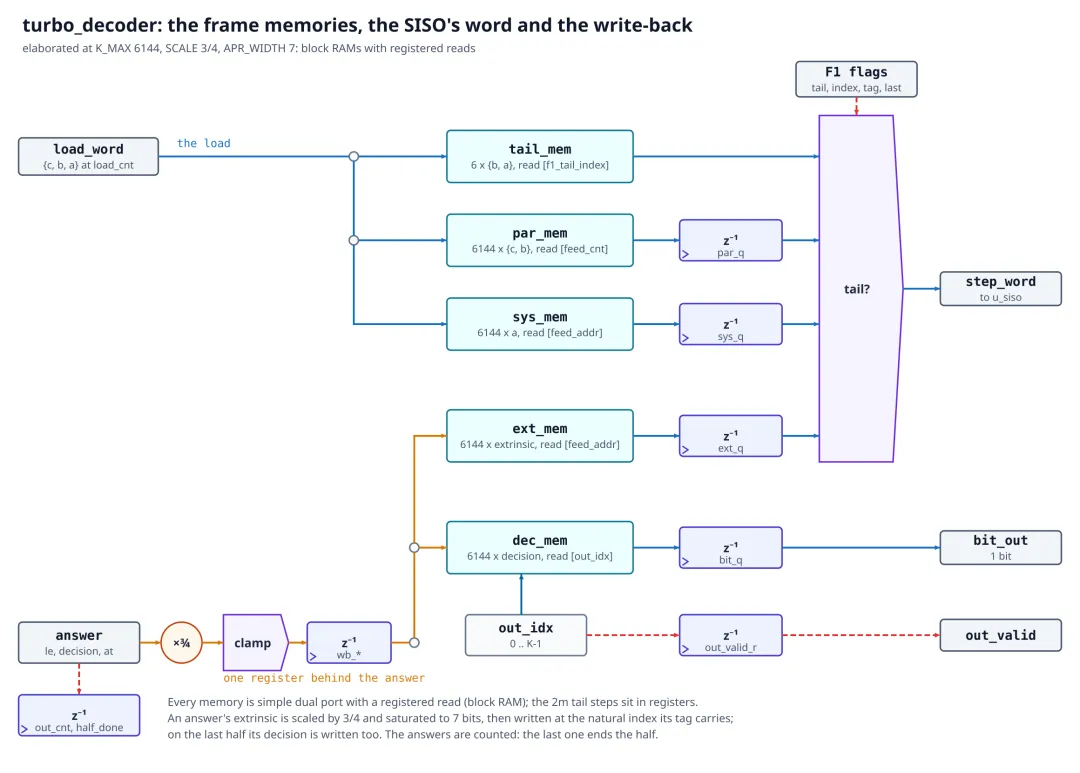
源码绑定的 memory/write-back 微结构:systematic、parity、extrinsic、decision 和 tail memories 组成 SISO 输入;answer 的外信息乘 3/4、饱和、注册后写回,自然序输出从 decision memory 读出。点击图片查看原图。
第二张源码绑定结构图展示帧存储、外信息写回和自然序输出之间的关系。外信息采用 3/4 缩放并限制在 7 bit,这一数值选择随后由 BER 对照实验单独验证。本文不展开地址、流水和位级 RTL 的实现步骤;需要了解如何让 AI 在固定合同下生成、修订并验收 RTL,可回到上一篇文章的有限修订循环和 FIR 实例。
3AI 优化要搜索结构轴,而非代码行
对这样一个译码器,优化不能围绕“少写几个 always block”进行。至少要分开三类轴:
结构轴:复制几套 SISO、是否并行多个 window、存储端口怎样分配。它决定面积、帧占用周期和可达到的吞吐。
调度轴:window 大小、迭代次数、半迭代切换气泡。它既影响状态度量存储,也影响从末输入到首判决的延迟。
数值轴:输入位宽、外信息位宽、缩放和饱和。它影响资源与译码质量,必须同时有误码证据和实现证据。
WINDOW:三个已布线点,不是一个经验判断
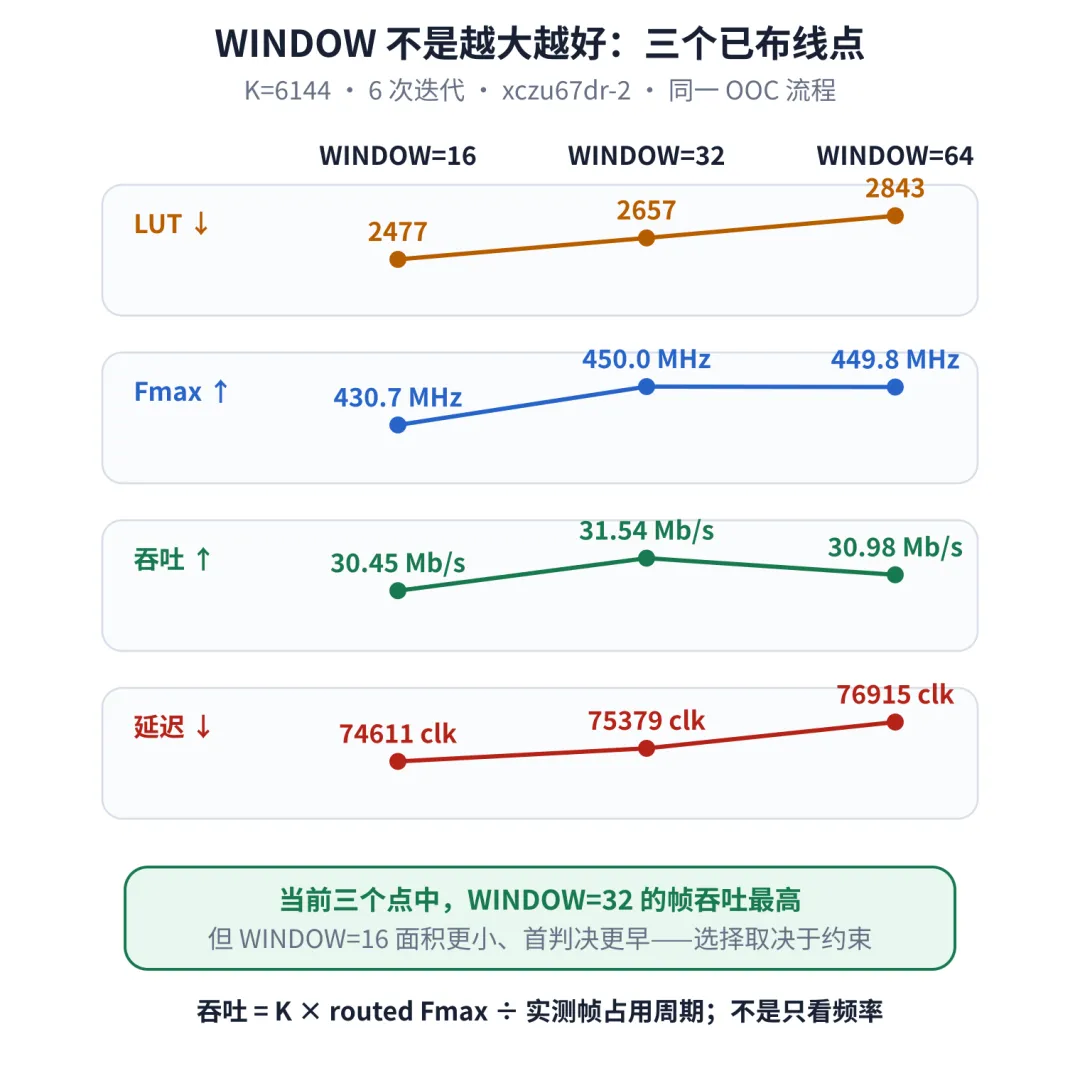
三个已布线点的数据图:WINDOW 16、32、64 的 LUT、Fmax、帧吞吐与首判决延迟;32 的吞吐最高,16 的面积更小且首判决更早。
把 WINDOW 从 16 加到 64,LUT 从 2477 增到 2843,这一项近似单调;但 Fmax 从 430.7 MHz 上升到约 450 MHz 后基本持平,真实帧吞吐则在 WINDOW=32 达到 31.54 Mb/s,再回落到 30.98 Mb/s。首判决延迟从 74,611 增到 76,915 clocks。
所以“window 越大,吞吐越高”不是这个实现的数据结论。当前三个点里,32 是吞吐折中点;如果目标是最小 LUT 或更早首判决,16 反而可能更合适。换器件、换约束、换存储映射后,这个选择还要重测。
吞吐按完整帧计算:K × routed Fmax ÷ measured frame clocks。K=6144、WINDOW=32 时,周期模型在与板级 player 相同的事务驱动下测得一帧占用 87,673 clocks;用 routed Fmax 450.045 MHz 计算得到 31.539 Mb/s。只把频率或某一级流水的 II 当吞吐,会把帧引擎算错几个数量级。
迭代次数:资源几乎不变,帧时间直接增加
因为只有一套 SISO,迭代次数主要改变控制循环次数,不会按 8/6 倍复制算术资源;代价落在帧时间与延迟上。这也是时间复用结构的典型特征。
外信息缩放:必须用 ablation 归因
当前实现把外信息缩放为 3/4。为了确认收益确实来自这一步,记录中保留了 SCALE=4/4 的未缩放 ablation。在 K=512、6 次迭代、5-bit 定点 LLR、BPSK/AWGN 条件下,每个 Eb/N0 点测 150 帧:
这组 600 帧支持一个局部结论:在这组块长、量化、迭代次数和随机样本上,该缩放优于未缩放版本,也低于两个参考的 BER。它不构成任意信道、任意码块上的普遍编码增益证明。AI 可以提出 SCALE=3,但只有对照实验能把收益归因给它。
4同口径比较:赢在哪里,输在哪里
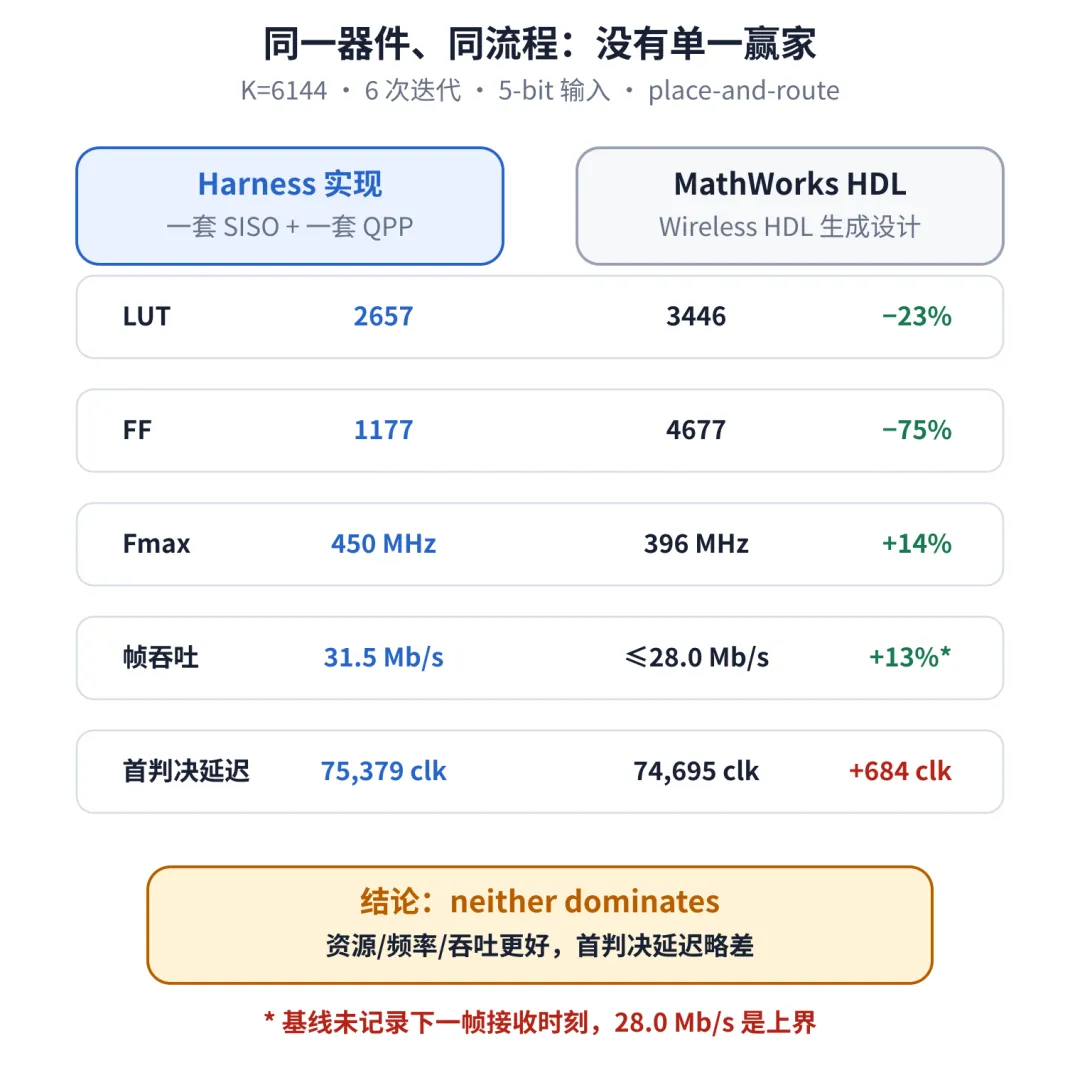
同器件同流程比较:Harness 实现为 2657 LUT、1177 FF、450 MHz、31.5 Mb/s、75379 clocks;MathWorks HDL 为 3446、4677、396、最高 28.0、74695;结论 neither dominates。
一次可以写进结论的比较,至少要把下面六件事锁在一起:
- ▶同一功能问题:K_MAX=6144、6 次迭代、5-bit 输入;
- ▶同一器件:器件型号为
xczu67dr-fsve1156-2-i; - ▶同一实现阶段:两边都完成 place-and-route,不拿综合估计对布线结果;
- ▶同一时序口径:Fmax 只在 setup、hold 都闭合时记录;
- ▶同一吞吐定义:按完整帧占用周期,不用组合路径或流水级 II 代替;
- ▶同一诚实规则:缺失的数据写成上界、下界或无法运行,不由作者补齐。
这套规则也决定了哪些数字不能进入胜负表。AMD 3GPP Mixed Mode Turbo Decoder 在当前机器上因为缺少强制许可证而锁定,没有生成 utilization report;它的状态是 COULD_NOT_RUN,不是 0 LUT,也不是失败。公开的 Altera Turbo IP 数字来自另一器件和另一流程,可以帮助理解多引擎并行架构,却不能与这里的单引擎点组成“谁支配谁”的一行。
对 AI 自动化尤其如此:如果 Agent 既负责找候选,又可以换器件、放宽时钟、改测试、删掉失败点,它几乎总能“优化成功”。真正的自动化要让候选在固定跑道上竞争,而不是让跑道追着候选移动。
5验证闭环:不仅要会通过,还要会拒绝
复杂 RTL 最危险的绿色结果,不一定是假数据,也可能是一个没有能力失败的检查:参考模型和 RTL 共享同一个 bug,测试没有覆盖错误分支,或者 miter 根本没有驱动合法事务。
所以验证链要分层,每一层只回答自己有能力回答的问题。
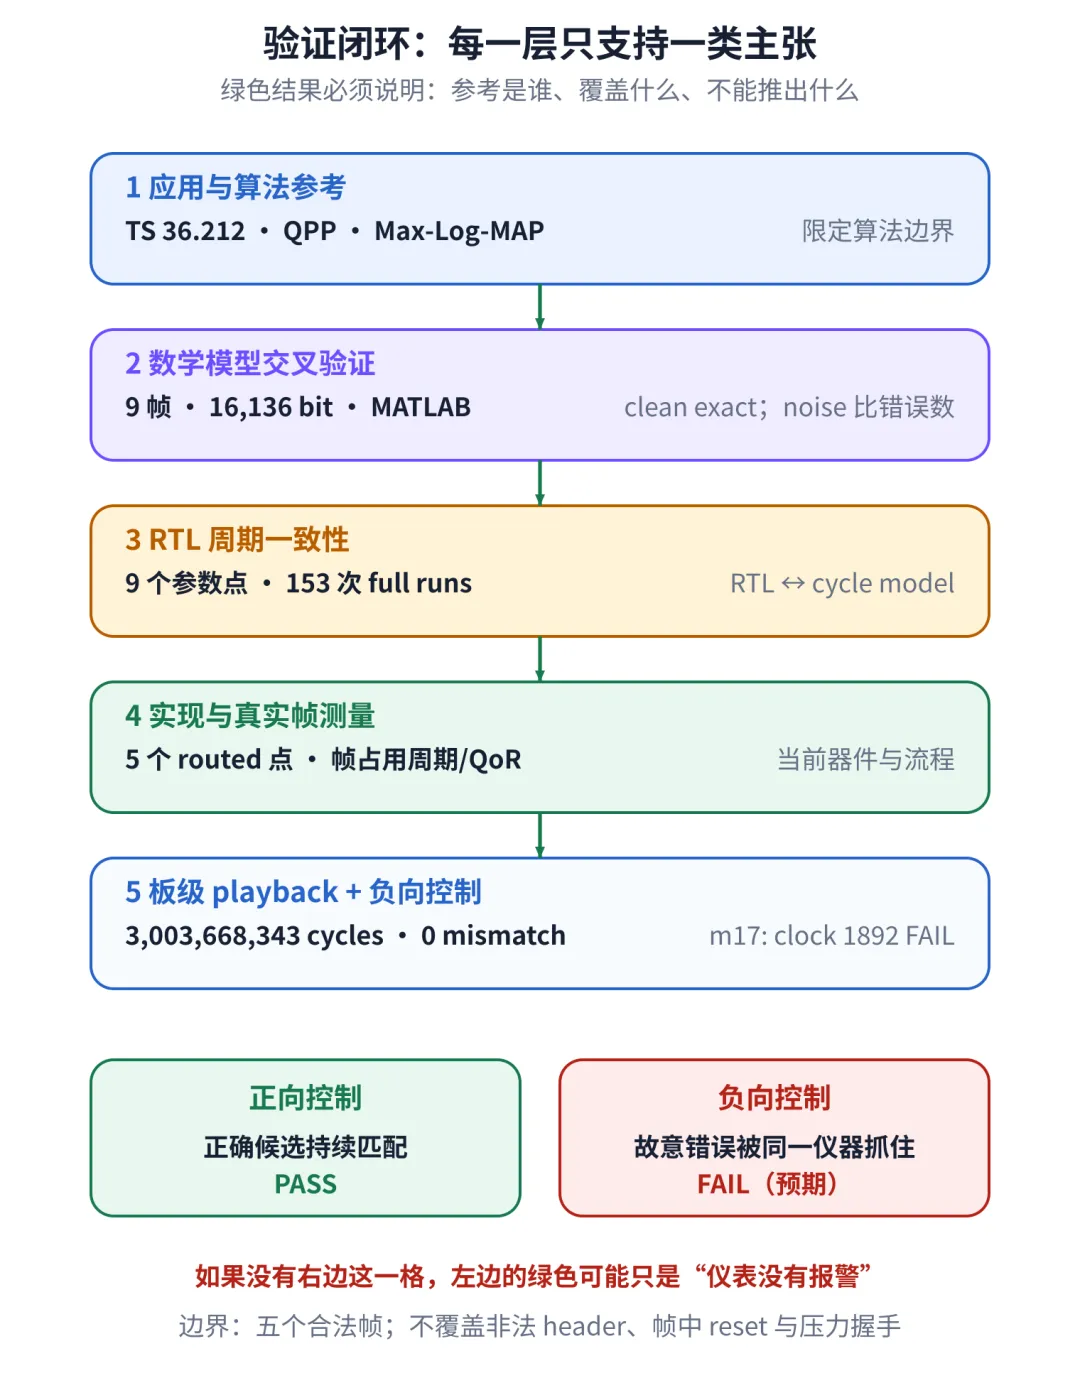
五层验证链:应用算法参考、九帧数学模型交叉验证、九参数点 153 次 RTL full runs、五个 routed points、三十亿周期板级 playback;正向候选 PASS,故意错误 FAIL。
应用参考约束模型,而不是直接约束 RTL
第一层是 3GPP TS 36.212 的 Turbo 编码边界、188 组 QPP 参数与 memory-3 尾比特布局。它告诉我们模型要算什么,却不会证明 RTL 的逐拍行为。
数学模型随后对 9 个由 MATLAB R2026a 生成的参考帧进行 cross-validation,共 16,136 bit。规则不是粗暴地要求所有噪声帧逐 bit 相同:
- ▶干净帧:对 MathWorks HDL 能无误码译出的 3 个帧,模型也必须无误码并逐 bit 一致;
- ▶噪声帧:当前模型使用不同的定点调度和上述外信息缩放,只要求错误数不高于 LTE Toolbox 与 Wireless HDL 参考;
- ▶聚合结果:9 帧合计,模型为 1,782 errors,LTE Toolbox 为 3,117,MathWorks HDL 为 2,995;没有 breach。
这一步支持“数学模型在声明规则下没有劣于参考”,不支持“RTL 已经正确”。
RTL 再对 cycle model 做参数矩阵一致性
第二条桥把模型连接到 RTL。当前 fresh conformance record 覆盖 9 个参数点、153 次 full runs,包括不同 K、WINDOW、迭代次数、输入/外信息位宽,以及一个不同 memory/polynomial 点。它检查周期级输入输出和时序约定,而不是只比较一帧最后的比特串。
RTL 内还有局部形式属性:phase 不能进入非法编码,half counter 不得越界,feeder 只能在 DECODE 阶段运行,输出 walk 只能在 OUTPUT 阶段运行,并覆盖一次完整帧结束。这组约束能快速抓控制错误,但它们只是一组局部不变量,不是完整功能证明。
板级 playback 必须带负向控制
帧引擎不能用普通 LFSR miter 随机喂每个输入口:随机 word 大多不是合法 header,更不是恰好 K+2m 个 step 的完整帧。这里采用 playback reference:两边使用同一个合法帧 player,候选一侧运行 RTL,参考一侧按周期回放 cross-validated cycle model 的输出。
当前 fresh record 覆盖 5 个 golden frames,K 从 40 到 6144,共 8,883 个输入 word、8,848 个 decision;在 ZU67DR 上测得 299.917 MHz,运行 3,003,668,343 cycles,0 mismatch。
只写到这里仍然不够。相同 player、相同 build flow、相同比较器还被用于一个故意错误的候选:展平源码里一个 == 被改成 !=。这个 m17_eq_ne_L1036 变异给出预期的 FAIL,首个差异出现在 clock 1892,累计 56,770,955 mismatches。
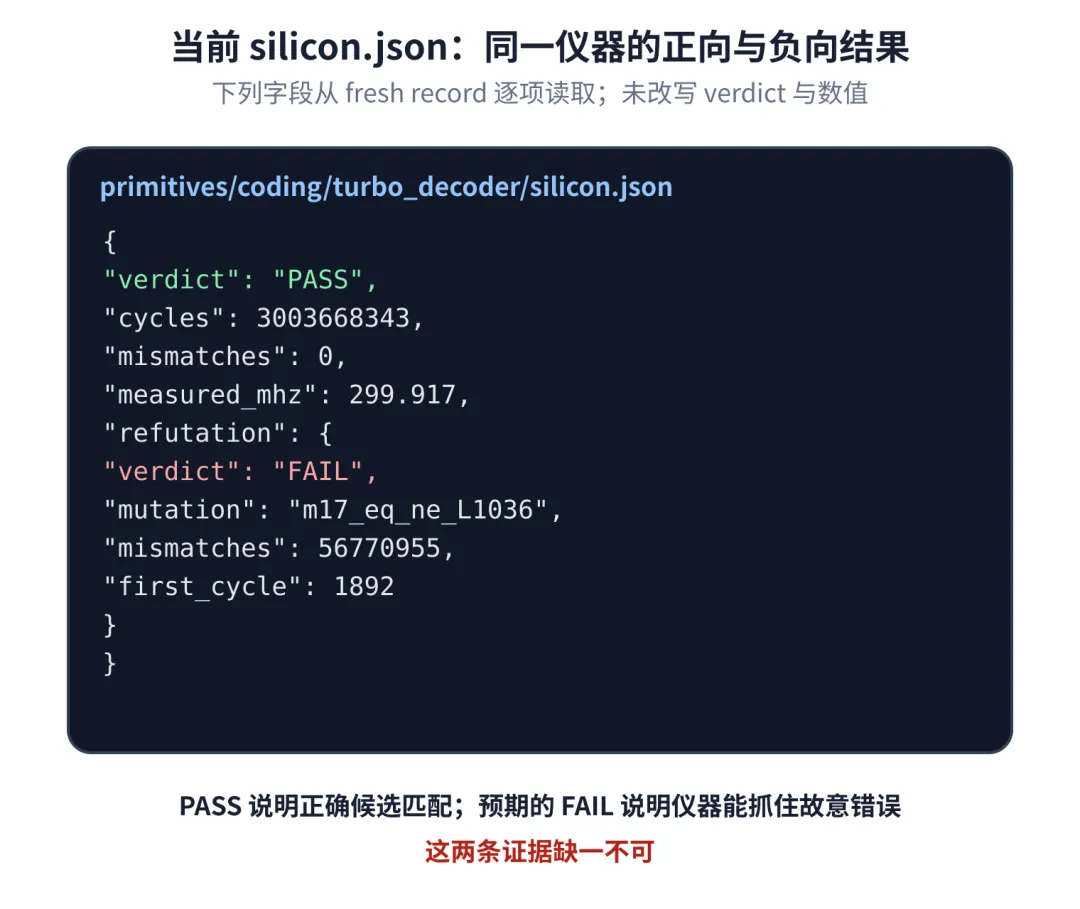
silicon.json 原始字段摘录:PASS,3003668343 cycles,0 mismatch,299.917 MHz;refutation 为 FAIL,mutation m17_eq_ne_L1036,56770955 mismatches,first_cycle 1892。
正向控制说明“正确候选在这些轨迹上持续匹配”;负向控制说明“同一仪器确实有能力发现一个很小的错误”。后者是验证仪器的自检,也是绿色结果可信度的一部分。
这条板级证据的边界也必须保留:它覆盖五个合法帧和对应周期轨迹,不覆盖非法 header、帧中 reset、输入压力下的握手、其他参数点,也不比较 out_valid=0 时没有语义的 bit_out。这些场景由仿真 ladder 和其他门负责,不能用“三十亿周期”把范围放大。
6两天交付,对批量 IP 生产意味着什么
这个案例说明,自动化已经越过了“生成一个能通过简单 testbench 的模块”这一阶段。它处理的是带运行时码块长度、帧存储、迭代调度、定点反馈和数万周期延迟的通信译码器;交付物也从一份 RTL 扩展为架构图、参数点、基线比较、交叉验证、变异检出和板级记录。
速度提升没有依赖放宽标准。初始 forge 未能独立完成 SISO 和 Turbo engine,architect agent 接管后,候选仍需重新经过同一条验证与实现跑道。失败被保留,上界和不可比较项被保留,延迟上的劣势也被保留。
这才是“两天”的工程含义:缩短的是从问题到可验收候选的周转时间,不是省略规格、优化或验证。
这个 LTE Turbo Decoder 案例最值得复用的,不是 2657 个 LUT,也不是三十亿周期。它证明了一条可重复的生产路径:同一套 Harness 可以组织规格、参考、Agent 候选、架构参数、实现测量、验证门禁和证据包,并把失败留在记录里,而不是靠人工拼接一次演示。
因此,批量化生产 IP 的工程条件已经成熟:这里的“生产”指持续生成经过结构优化、分层验证、可追溯的候选 IP 和交付证据包。它不意味着任何新核都能跳过逐核签核;CDC/RDC、异常协议、安全约束、目标器件、客户接口和长期维护仍然必须针对每个 IP 单独闭合。
两天完成一个 LTE Turbo Decoder 的意义也在这里。时间缩短来自可复用的流水线与验收跑道,而不是删掉设计与验证步骤。真正可迁移的是一条纪律:
让 AI 大胆提出候选,让架构轴暴露取舍,让独立证据决定候选能否留下,让负向控制证明裁判真的会说“不”。
如果你希望了解具体怎样使用 AI、怎样划分 Agent 权限、怎样设计一个会停止的修订循环,以及怎样组织可复跑的验收证据,可以继续阅读上一篇AI 做 FPGA 设计,怎样从“能跑”走到“可验收”?上一篇讲方法,这一篇给出方法落到复杂通信 IP 后的结果。
资料来源
- ▶LTE Turbo 编码、QPP 与通道编码边界:
ETSI / 3GPP TS 36.212 Release 18 - ▶Log-MAP 与 Max-Log-MAP 算法背景:
Robertson、Villebrun、Hoeher, ICC 1995 - ▶验证反馈进入 AI-RTL 生成循环的方法背景:
AIvril: AI-Driven RTL Generation With Verification In-The-Loop
文中实现、综合布线、交叉验证、conformance、板级 playback 与 refutation 数字均来自本文对应仓库中的 current raw records;外部资料只用于标准与方法背景。