ARTICLE · 1077229
AI 终于要从屏幕里爬出来了?
AI 终于要从屏幕里爬出来了?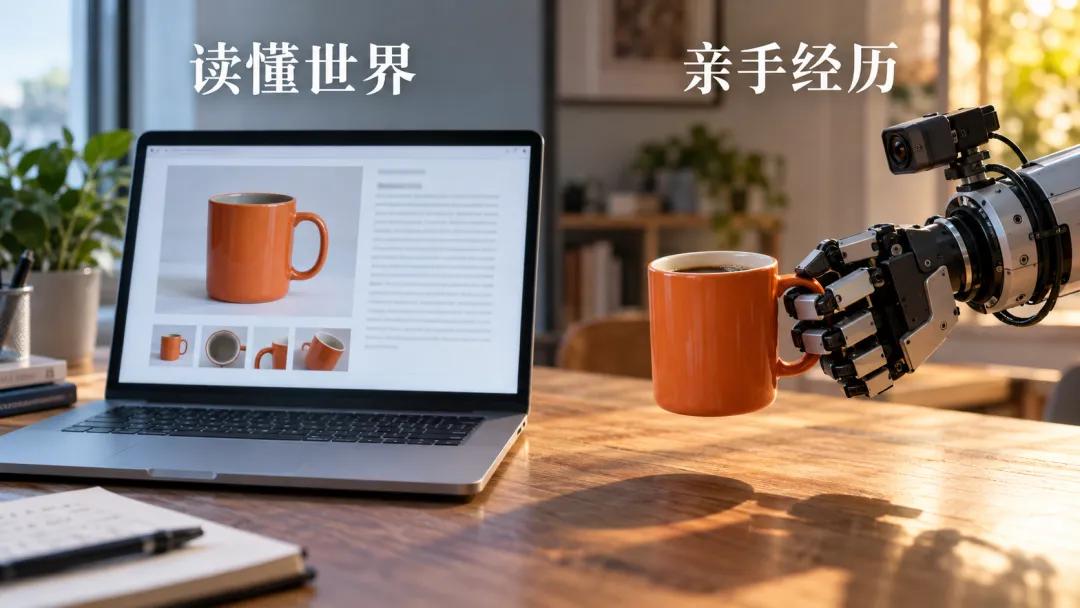
我最近一直有一种很奇怪的感觉。 World Model,Physical AI,Embodied AI,Robotics, 再往下还有 VLA、World Action Model、Spatial Intelligence、Sim2Real…… 这些词我其实都听过,而且单独拎一个出来,好像也都能讲两句。 可一旦把它们放在一起,我脑子里就开始打结。 世界模型和视频生成到底是什么关系?具身智能是不是就等于人形机器人?Physical AI 又是不是 NVIDIA 新造出来的一个营销?Robotics 都存在几十年了,为什么到了 2026 年,突然又成了全 AI 圈最热的方向之一? 我寻思了一下我没寻思明白... 然后最近这几周,一堆新闻又刚好撞在一起。 9 月 1 日,李飞飞创办的 World Labs 发布 Atlas全球首个,多模态世界模型来了,一个从文字、图片、视频和 3D 一起训练的世界模型,目标已经不是单纯生成一段好看的视频,而是生成、重建和模拟一个可以持续存在的三维世界。 9 月 10 日,智元发布 GE-Act 2.0智元发布GE-Act 2.0,首次验证原生世界—动作模型预训练与Scaling路径 | 前沿在线,直接把模型叫做 World-Action Model。他们拿 300 小时、1200 小时、5000 小时一直训到 3 万小时机器人数据,想验证一件很关键的事,机器人模型会不会也有自己的 Scaling Law。 9 月 17 日,Figure 发布 Helix 2.5人形机器人,可以“自主做家务”了,把同一个机器人扔进 30 个它从没见过的真实家庭里,让它收拾客厅、叠毛巾、铺床,不针对这些房间重新采数据,也不临时微调。 9 月 21 日,Boston Dynamics 在现代汽车美国工厂里开了一个专门训练 Atlas 的 Robotics Metaplant Application Center,Atlas 已经开始在真实汽车制造环境里练零件物流和排序。 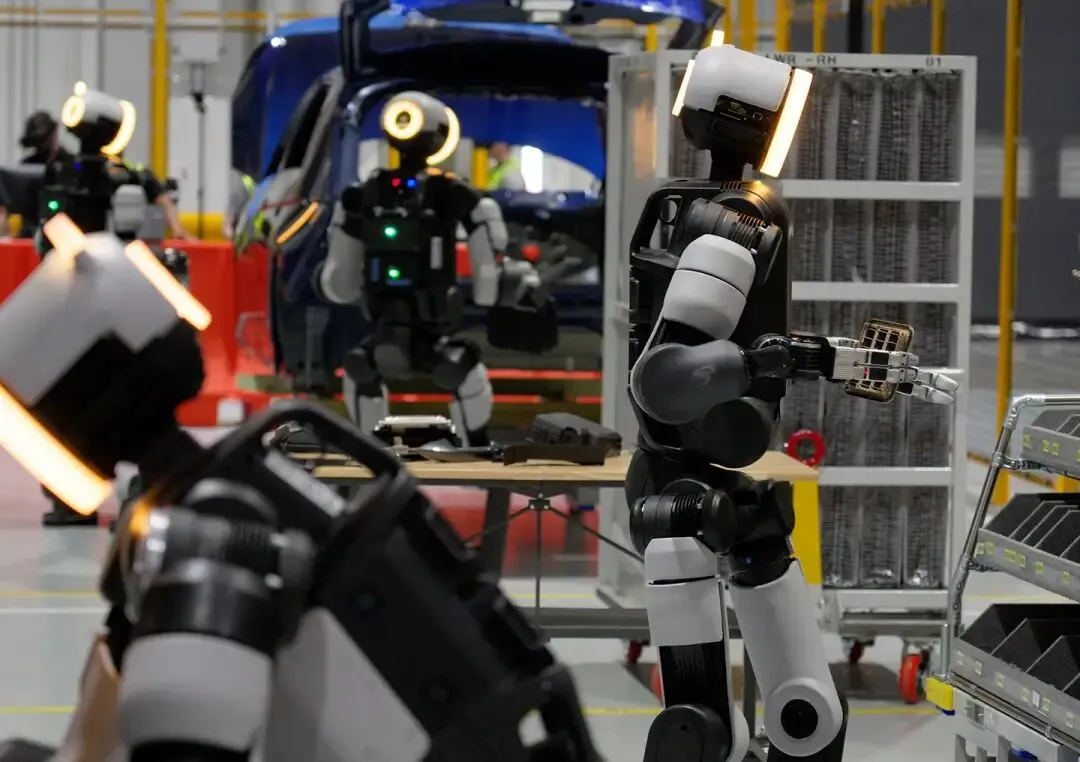
然后昨天,9 月 24 日,国际机器人联合会刚公布最新数据。2025 年全球工厂新增工业机器人已经超过 60 万台,在役总量第一次突破 500 万台。 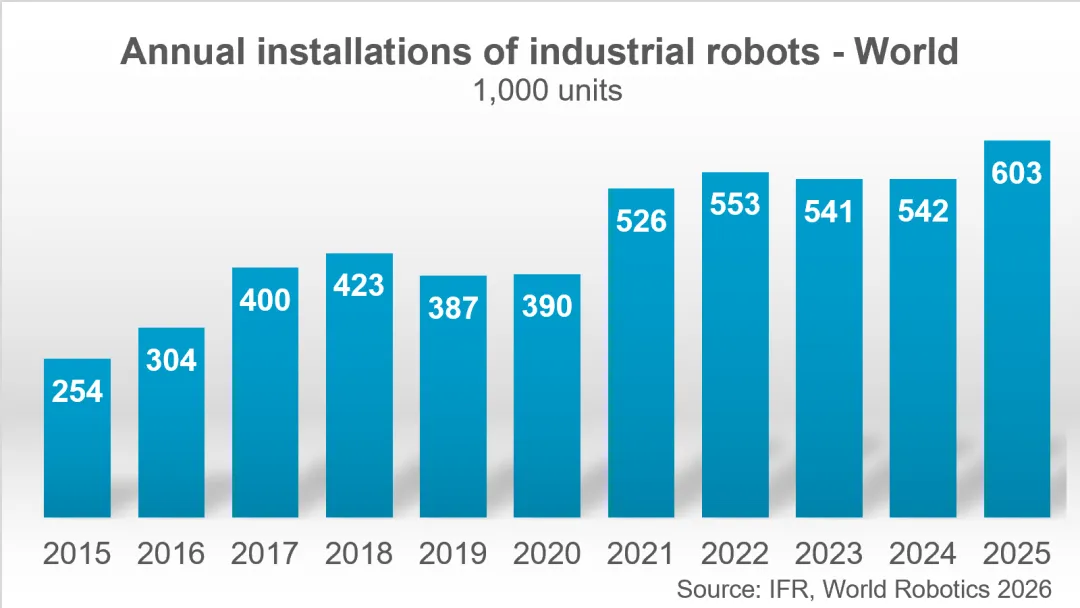
更骚的是,另一边铺天盖地刷屏的人形机器人,2025 年全球面向工业和专业服务场景卖出去的,大概只有 7000 台。 500 万,对 7000。
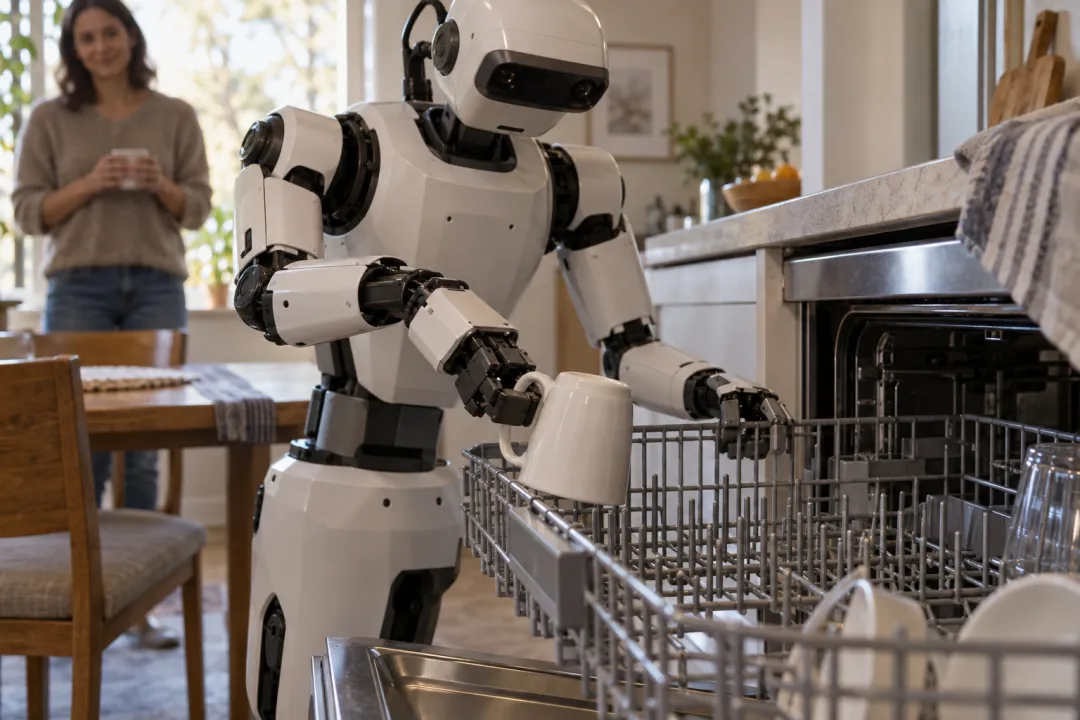
想一个特别简单的场景。 你回家,对机器人说,帮我把桌上的咖啡杯拿去厨房,放进洗碗机。 对于今天的LLM来说,听懂这句话太简单了。 但真让机器人去干,麻烦才刚开始。 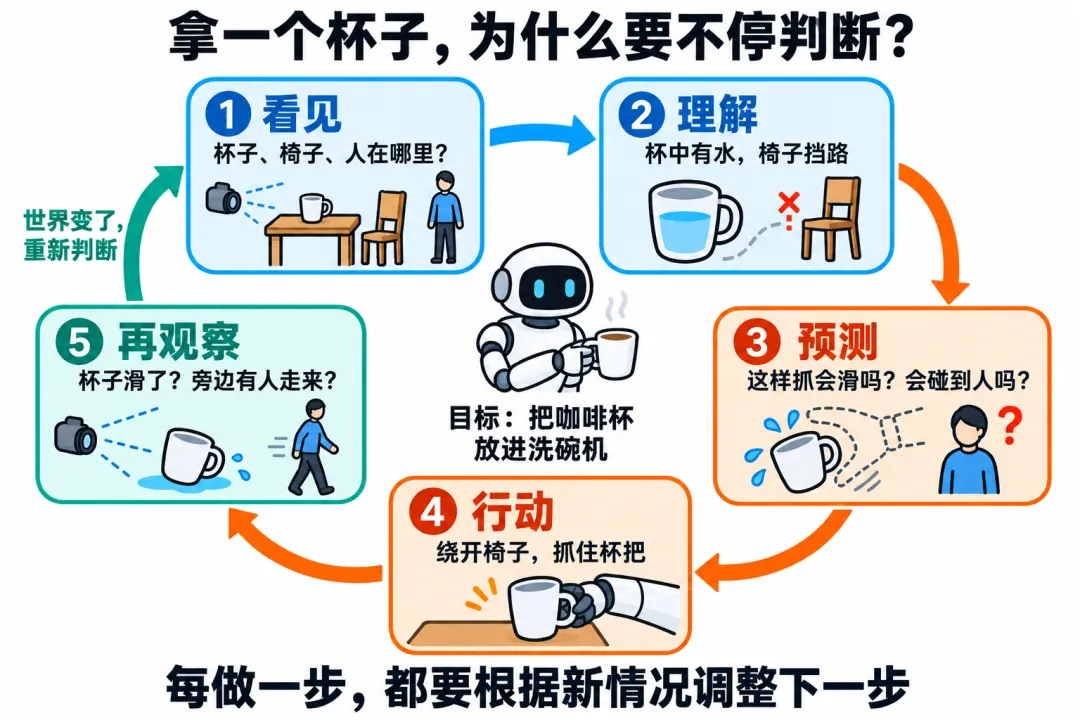
哪个是咖啡?桌子在哪,厨房在哪?地上那把椅子要不要绕?杯子装没装水?手应该抓杯壁还是抓杯把?抓太轻会不会滑,抓太重会不会碎?洗碗机门怎么开?里面哪里还有空位? 更麻烦的是,这些东西不是一次判断完就结束。 机器人走过去以后,视角变了。伸手以后,杯子可能动了。抓起来以后,杯子可能在滑。旁边可能突然走过来一个人。 所以它得不停地循环。 看见世界,理解世界,预测接下来会发生什么,做一个动作,然后重新看世界。 到这里,几个概念其实已经开始自己归位了。 Robotics 管的是整台机器。 机械结构、电机、减速器、传感器、控制器、路径规划、运动控制、操作系统,包括上面的 AI,全都在这个大框里。 所以一个工厂里只会从 A 点焊到 B 点、完全不会跟你聊天的机械臂,当然也是 Robot。 传统 Robotics 最擅长的,是在一个高度确定的世界里,把一件高度确定的事做得极其稳定。 这件事一点都不 low。 相反,IFR 那个 500 万台的数据恰恰说明,真正撑起今天机器人产业的,依然是这些看起来没那么性感的工业机器人。 问题出在,一旦环境开始变化,传统机器人就容易难受。 桌子挪了十厘米,零件换了一个形状,地上突然多了个箱子,任务从「把这个搬过去」变成「把看起来快坏掉的那些箱子挑出来」。 以前很多东西都得工程师重新写。 具身智能想解决的,正是这里。
Embodied AI 里面我觉得最重要的词,其实不是 AI,是 Embodied,是「有身体」。 人类学会这个世界,从来不是坐在一个黑屋子里读完互联网以后再出门。 小孩会推东西,会摔东西,会碰,会抓,会被烫到,会发现一个球滚下坡以后还会继续滚。 动作改变世界,世界再反过来教育身体。 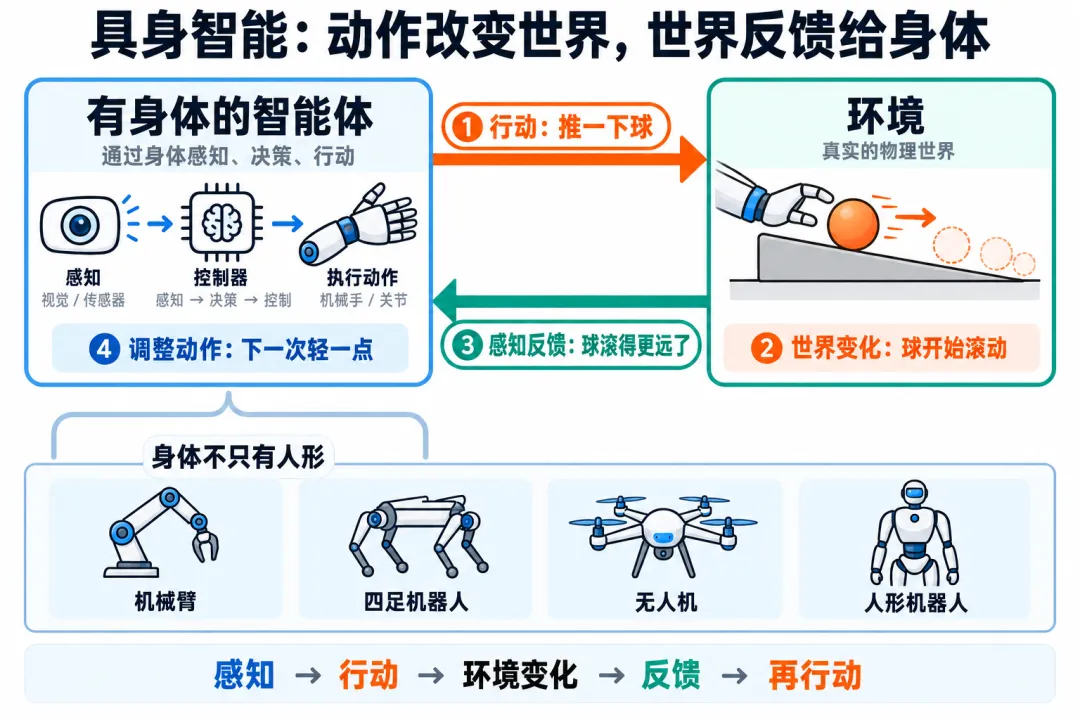
所以具身智能真正迷人的地方,是它把智能从「输入信息,输出答案」,变成了一个闭环。 我做了什么,世界发生了什么,我再根据结果做下一步。 这也是为什么具身智能不等于人形机器人。 机械臂可以具身,四足机器人可以具身,无人机也可以具身。只要智能拥有某种身体,可以通过传感器感受环境,通过执行器改变环境,然后继续学习和行动,这条闭环就成立了。 人形只是其中一种身体。 只不过,它刚好特别适合一个很现实的问题。 我们的世界,是给人造的。 楼梯的高度、门把手的位置、货架的尺寸、厨房的台面、工厂里的工具、汽车装配线的工位,几乎全部默认操作者有差不多一米多高,有两只手,可以站着移动。 如果你不想把整个世界重新装修一遍,那就让机器尽量长得能适应这个世界。 所以我现在再看人形机器人,反而没那么纠结「为什么非得两条腿」。 它最大的意义,很多时候不是模仿人很酷。 是少改环境。
顺着这个再聊 Physical AI。Physical AI 十讲 · 第一讲|为什么 2026是物理 AI 元年 这个词这两年被 NVIDIA 喊得特别响,所以很多人第一次听会觉得,它是不是又一个为了卖 GPU 包出来的新概念。 科技行业太爱造词了,云计算造过,元宇宙造过,Agent 也造了一堆。 但 Physical AI 这个词,我现在反而觉得挺有用。 因为它描述的范围比具身智能更大。 机器人当然属于 Physical AI,但自动驾驶、无人设备、智能工厂里真正能够自主感知和决策的系统,也都可以放进来。 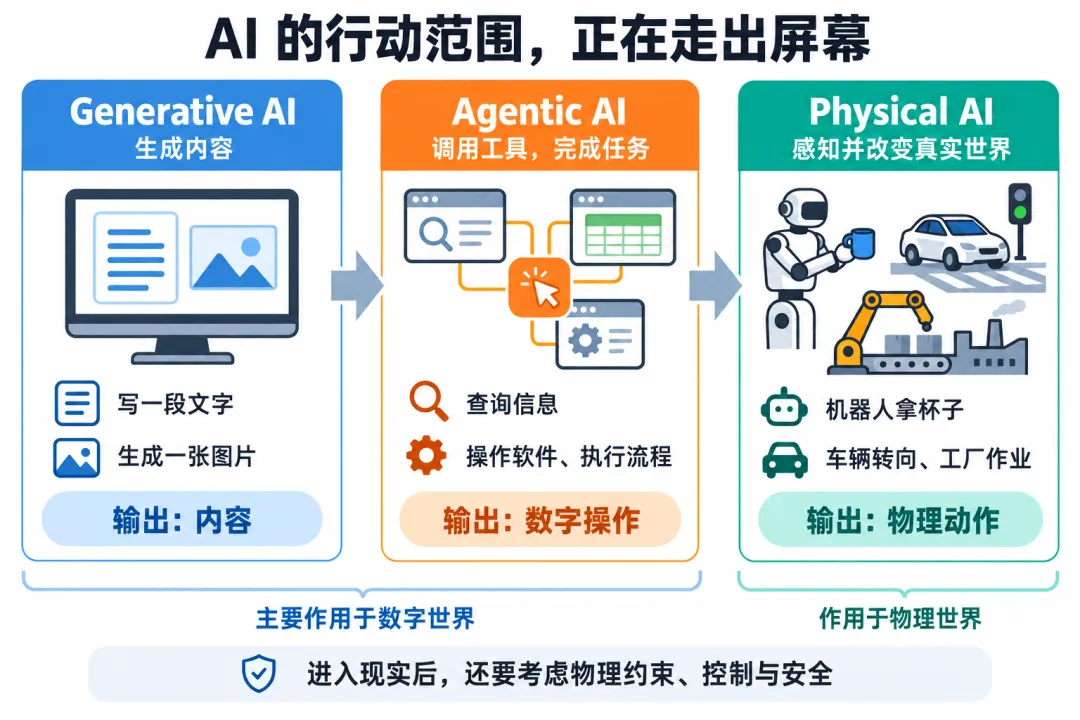
如果 Generative AI 是 AI 在数字世界里生成东西,Agentic AI 是 AI 开始在数字世界里调用工具、操作软件、替你做事,那 Physical AI 往前又迈了一步。 它开始改变真实世界。 这一步非常要命。 ChatGPT 写错一封邮件,你可以撤回。 Seedance 生成错一个镜头,你可以重抽。 一个 70 公斤的人形机器人伸错了手,一辆两吨的车判断错了方向,就不是「再生成一次」的问题了。 所以 Physical AI 真正难的,不是把一个大模型塞进机器人脑袋里。 它得理解空间、时间、物理、因果,还得规划,还得控制,还得安全。 这时候 World Model 就出来了。这是一篇把“世界模型”讲明白的科普级综述!
我以前第一次听世界模型这个词,也觉得特别玄。 后来发现,用最土的大白话理解就行。 就是让 AI 在脑子里有一个「这个世界接下来会怎么变」的模型。 你看见一个杯子放在桌边,普通视觉模型能知道这是杯子。 更强一点的多模态模型能知道,它在桌子边缘。 可如果你真的要伸手去碰它,你需要知道另一件事。 我往右推五厘米,会发生什么。 杯子会移动,会越过桌沿,会失去支撑,会掉下去。 这一下,事情完全不一样了。 AI 不只是识别「现在是什么」,而是在预测「接下来可能发生什么」。 如果再把动作放进去,就是「我做什么,世界会怎么变」。 这也是为什么现在 World Model 和 Robotics 越来越缠在一起。 World Labs 走的是一条特别直观的路线。 Atlas 直接把文字、图像、视频和 3D 放进同一个模型里,学的不只是画面,而是一个空间怎么延伸,东西在哪里,镜头转过去以后后面应该有什么,一个世界怎样保持连续。 我特别喜欢他们一直强调的一个词,Spatial Intelligence。 空间智能物理AI与空间智能:下一个万亿赛道。 因为大语言模型最神奇的地方,是把人类积累了几千年的语言压进了参数里。 世界模型想干的事情更野。 它想把「世界怎么运行」也压进去。 然后你再回头看今年 NVIDIA 的路线,就会发现它几乎已经把牌摊在桌面上了。 5 月底发布的 Cosmos 3NVIDIA的Cosmos 3火了,但企业如何真正用起来?,已经把视觉推理、世界生成和动作预测揉进一个 Physical AI foundation model 里。 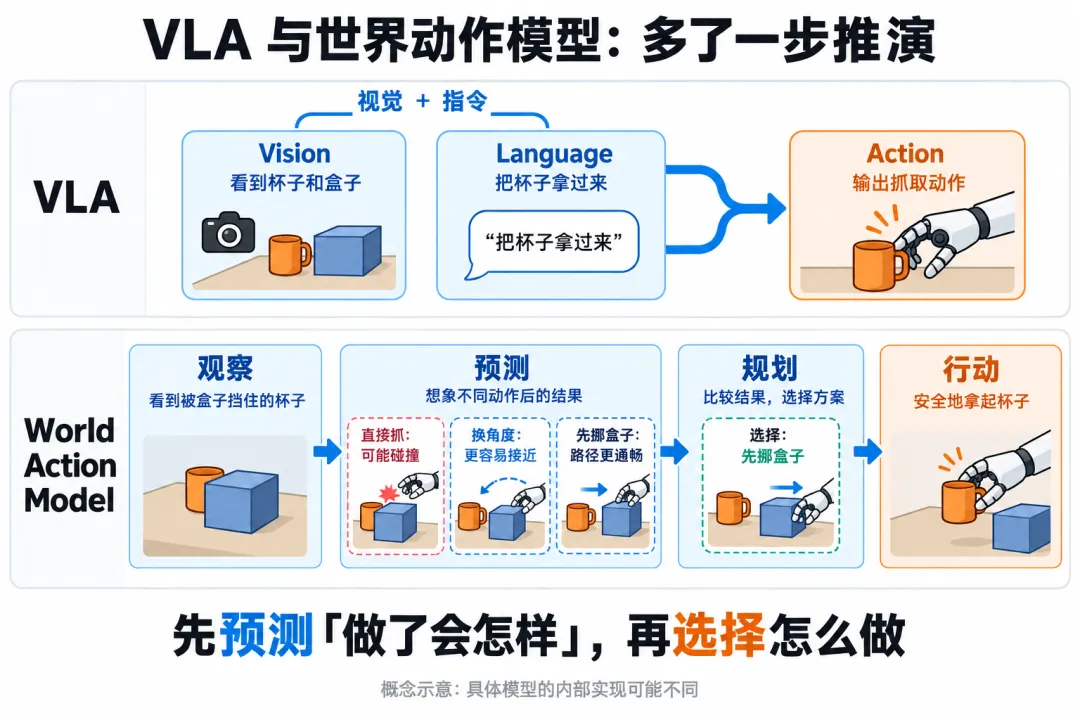
VLA 很好理解,Vision、Language、Action。 我看到了什么,你让我做什么,然后我输出动作。 但 World Action Model 多加了一层特别关键的东西。 它不急着动。 它先想象一下。 如果我从这里抓,会怎样。如果换个角度,会怎样。如果先挪开旁边那个盒子,会怎样。 观察,预测,规划,再行动。 这就有点接近我们平时所谓的「三思而后行」了。
当然,我说接近,是因为现在离真正的人类常识还差得远。 机器人今天最容易骗过人的,是 Demo。 一个精心布置的舞台,一套练过很多遍的动作,一条剪得很顺的视频,真的很容易让人产生一种「卧槽,人形机器人已经来了」的错觉。 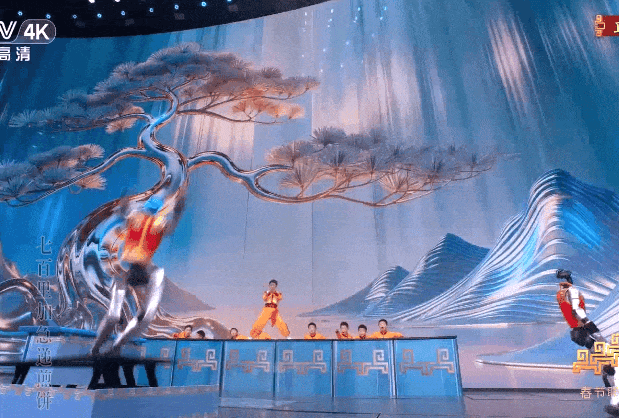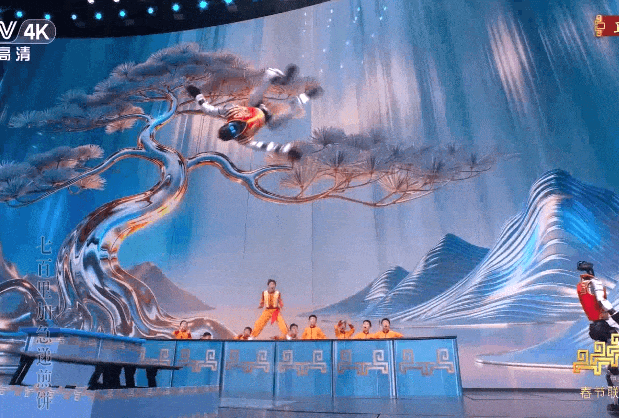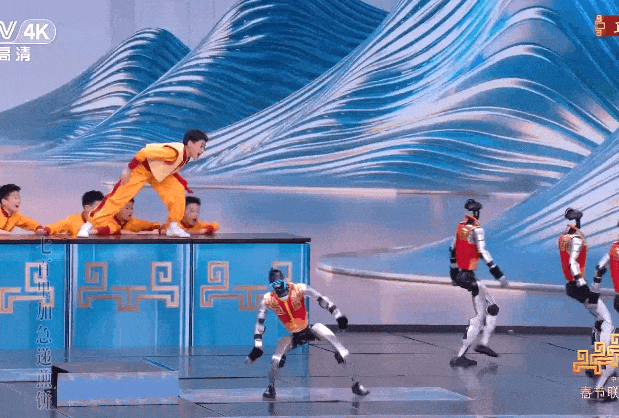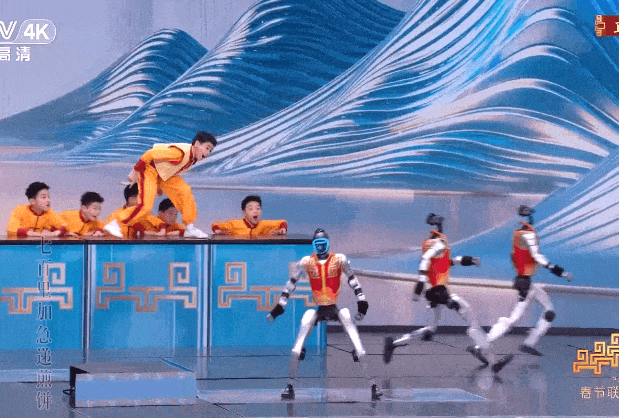
可你把它扔进一个从没见过的家里,让它连续工作 8 小时,今天杯子在左边,明天有人把椅子踢歪了,后天毛巾换了材质,中间它抓空一次还得自己恢复。 这才开始接近真正的生产力。 所以 Figure 这次 Helix 2.5,我反而觉得比再做一次后空翻有意思得多。 他们把机器人放进 30 个没见过的湾区家庭,没有针对这些家庭重新采数据,让同一个模型去收拾客厅、叠毛巾、铺床。 Figure 自己披露的数据里,Index 预训练把零样本成功率从 9% 拉到了 56%。 56% 当然离「放心把家交给它」还远得很。 但这个实验真正有意思的地方,不只是成功率。 是他们发现,把 Index 里的预训练数据不断翻倍,后面的机器人动作预测损失会比较平滑地下降,甚至可以提前预测更大训练 run 的表现。 熟悉LLM的人看到这里应该会有点条件反射。 Scaling Law。 过去几年,整个 AI 行业最值钱的一条经验,可能就是发现语言模型真的可以靠更多数据、更大模型、更多算力,一路 scale 上去。 现在所有做机器人基础模型的人,都在偷偷或者明着问同一个问题。 机器人,也可以吗??? 智元 GE-Act 2.0 干的也是这个。 他们把具身操作数据从 300 小时扩到 3 万小时,模型不是只把旧任务做得更熟,而是开始冒出一些小规模数据时做不了的新能力。智元给出的测试里,可完成任务数量随着数据规模上升,折毛巾、套纸杯、开合笔帽、插花这些更细的操作,也开始出现。 这当然还是厂商自己的研究结果,离「机器人 Scaling Law 已被证明」差得远。 但你会发现,中美几家公司突然都在往一个方向冲。 不是让机器人背更多动作。 是先让它看过更多世界。 这就把问题推到了整个 Physical AI 今天最缺的东西上。 数据。 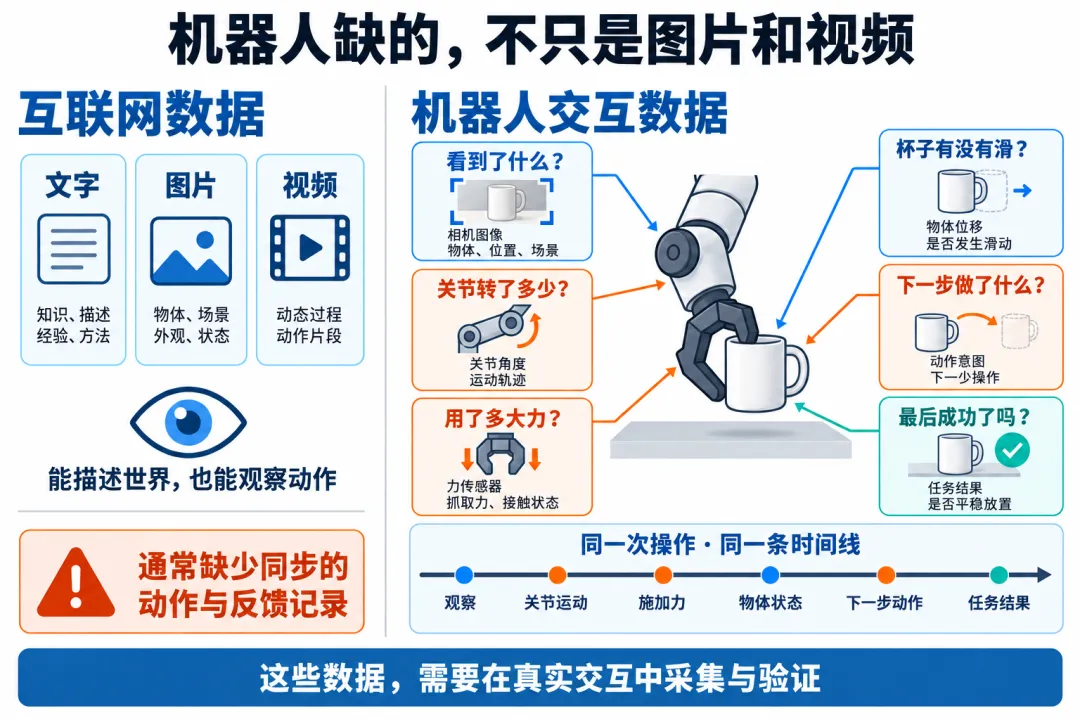
互联网上有几万亿个 token。 有无数图片,无数视频。 可互联网几乎没有「我现在看到什么,我的左手第 17 个关节转了多少度,我用了多少力,这个杯子有没有滑,我下一步做了什么,最终成没成功」这种数据。 机器人真正需要的数据,很多根本不存在于互联网里。 得去现实世界里重新造。 Figure 今年 8 月专门把 Index 推出来,做的就是这件事。他们用真人第一视角行为数据去给机器人预训练。发布时已经有超过 1600 万条视频上传,数据流入速度大约是每秒 30 分钟视频。 你想一下这个画面。 以前训练机器人,是让机器人自己慢慢练。 现在变成全世界的人,拿着相机替机器人「活」。 人打开抽屉,人叠衣服,人端盘子,人收拾房间。 机器人还没真正进你家,先通过人的身体,看了几百万遍人类怎么生活。 这个思路其实挺疯狂的。
另一边则是仿真。 现实数据太贵,那就在虚拟世界里练。 NVIDIA 为什么一边做 Cosmos,一边死磕 Omniverse 和 Isaac。World Labs 为什么又做世界模型,又想让模型去模拟真实世界。 因为一台机器人在现实里摔 10 万次杯子,老板应该会先摔了机器人。 但在仿真里,随便摔。 灯光换一万种,桌子换一万张,摩擦系数随机改,摄像头位置随机变,让机器人把能踩的坑都先在虚拟世界里踩一遍,然后再回现实。 到这里,World Model、Simulation、Synthetic Data、Embodied AI,终于不是四个分散的热词了。 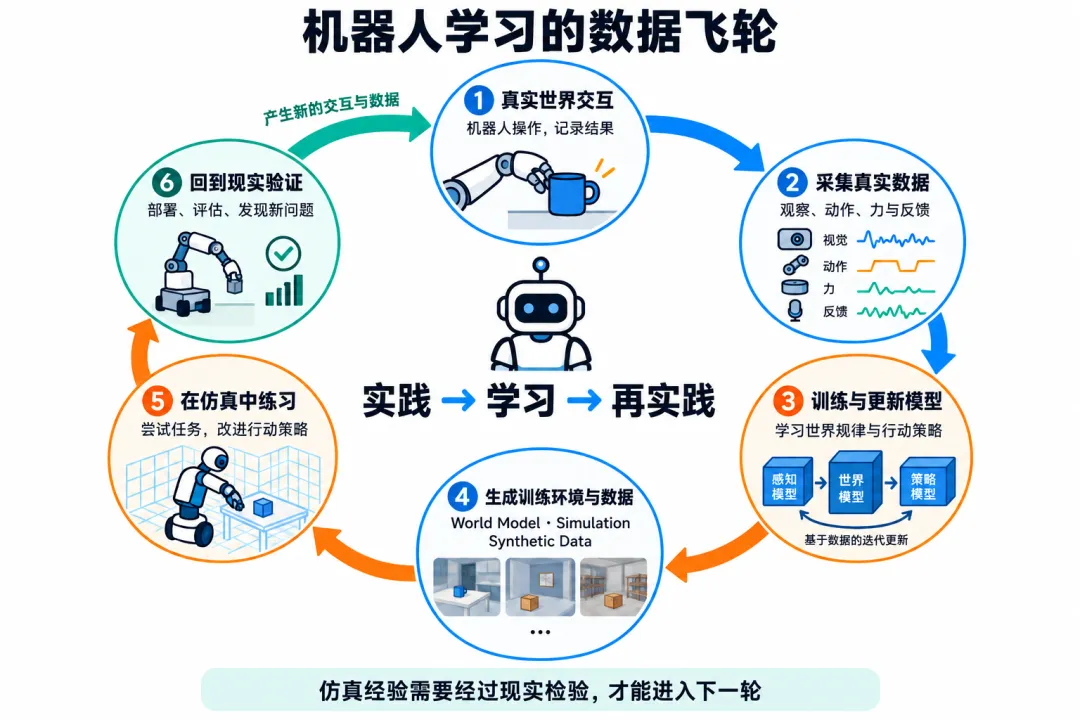
它们开始组成一个飞轮。 真实世界产生数据,数据训练模型,世界模型和仿真器生成更多世界,机器人在里面学习,再回到真实世界工作,然后产生更多数据。 这个飞轮如果真的转起来,才可能出现 Robotics 自己的 GPT 时刻。 说真的,我现在反而没有那么在意哪家公司的人形机器人能跑多快、跳多高了。 这块硬件当然重要,而且非常难。 但 2026 年一个越来越明显的变化,是大家开始从「身体能不能动」转向「脑子能不能泛化」。 Google DeepMind 7 月发布 Gemini Robotics 2时, 刚刚,Gemini Robotics 2发布,Agent方案赢了。强调的就是 whole-body intelligence。不是单独控制一只手,而是让脚、躯干、双臂、视觉一起工作,并尝试把能力适配到不同机器人身体上。 宇树今年也把 UnifoLM-X1-0 放到了自己的机器人制造工厂里测试,试着让机器人参与制造机器人宇树上市后首次演讲,王兴兴谈“让机器人自己写代码进化”。 Boston Dynamics 更直接,Atlas 已经进现代汽车工厂练真实流程了。 这些东西单看,每一条都像公司新闻。 连起来看,味道就完全不一样了。 整个行业正在从「给机器人编程」,慢慢转向「给机器人预训练」。 这两个词只差几个字,背后是完全不同的工业范式。 以前买一台机器人,你要围绕一个任务做集成,写流程,调参数,改产线。 未来大家真正想要的是另一种东西。 一台机器人出厂的时候,就已经像一个受过基础教育的人。 它知道杯子怎么拿,门怎么开,东西会掉,软的东西会变形,人会突然走过来。 到了你的工厂以后,你不是从 0 开始教它。 你只是教它这份工作。 这才是 Foundation Model 真正进入 Robotics 以后最让我兴奋的地方。
兴奋归兴奋,账还是要算。 IFR 的数字摆在那里,全球工厂里已经有 500 万台工业机器人在干活,而 2025 年工业和专业服务场景的人形机器人销量大概只有 7000 台。 这差的不是一点点。 真正的商业化还得回答特别土的问题。 能连续干多?故障一次要多久恢复?一个运维人员能管几台?电池多久换?手坏了多少钱?任务成功率多少?今天 95% 的成功率,连续做 1000 次以后还剩多少?算上折旧、维护、停机以后,到底比人便宜多少? 这些问题特别不性感。 但所有技术革命到头来都得跪下来算账。 我写到这里突然想到一个挺朴素的事。 人类从来不是先拥有一个「纯大脑」,然后某一天决定给它装上一副身体。 我们从出生开始,就是用身体认识世界的。 婴儿不知道什么叫重力。 他只是一次次把东西扔到地上。 不知道什么叫材质。 他只是摸过软的、硬的、烫的、凉的。 不知道什么叫空间。 他只是爬过去,撞到桌角,然后下一次学会绕开。 我们所谓的常识,很大一部分可能从来就不是「知道」出来的。 是活出来的。 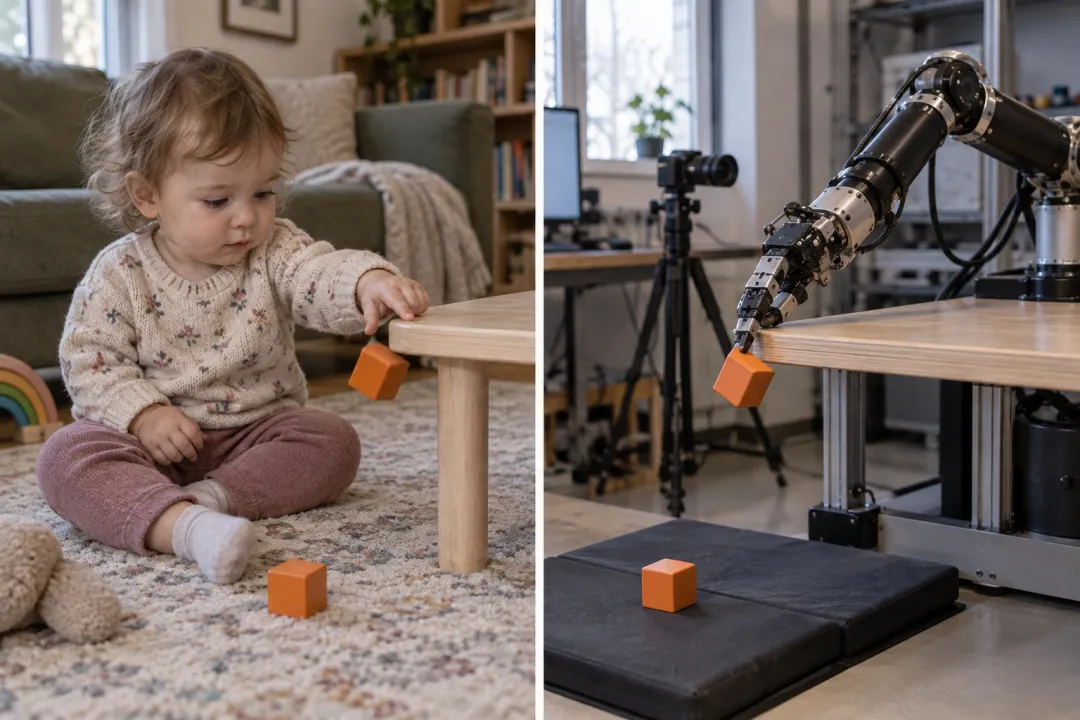
这也是我现在重新理解 Embodied AI 以后,觉得特别有意思的地方。 过去的大模型,把整个人类互联网喂给 AI,让它读了这个世界。 现在 Physical AI 想做的事情,是让 AI 去经历这个世界。 读过一百万句「杯子会掉下来」,和亲手推过一百万次杯子,不是一回事。 而 World Model,就是机器开始尝试把这些经历,变成自己脑子里的那个世界。
所以再回到最开始那几个听起来很乱的词。 Robotics 是身体和整套工程。 Embodied AI 是身体和世界之间不断发生的感知行动闭环。 World Model 是机器脑子里那个可以预测未来的世界。 Physical AI 则是它们汇到一起以后,我们正在试着造出来的那类东西。 一个不只会谈论世界的 AI。 一个真的活在世界里的 AI。 我自己也不知道这条路还要走多久。说实话,现在绝大多数机器人离科幻片里的那种通用智能,差得可能比宣传视频给人的感觉远得多。 但我越来越觉得,过去两年大家盯着 ChatGPT、Claude、Gemini,看 AI 怎么把数字世界一层层吃掉的时候,另一条线已经悄悄开始了。 它从 Token 走向像素,从像素走向空间,从空间走向动作。 再从动作,走进现实。 以前我们问 AI 的问题是:你知道这个世界多少? 以后可能会变成另一句话: 你,敢不敢真的伸手碰一下这个世界?
过去的 LLM,把整个互联网喂给 AI,让它去读这个世界。现在 Physical AI 想做的事情,是让 AI 去经历这个世界。
Atlas现已在佐治亚州萨凡纳附近的Metaplant Application Center接受训练。
图片来源:Boston Dynamics
01 听懂之后
02 身体与智能
03 碰到现实
04 先想,再动
05 数据之争
06 在仿真里练
07 最后得算账