ARTICLE · 1078133
只会做选择题的AI:Jev 能塞进存储主控吗
只会做选择题的 AI:Jev 能塞进存储主控吗
上周末刷到一条消息,说有个新模型比 ChatGPT 快几十上百倍,还号称从不幻觉。做固件的人看到"快"字,脑子里冒出来的念头大概都差不多:到底多快?能不能塞进主控,帮 FTL 做决策?
带着这个问题翻了翻资料。我手上没有 key,没实测过,下面是看完公开资料后的判断。先说结论:进主控,没戏;放在固件团队的开发流程里,它可能比聊天大模型更顺手。
这个模型叫 Jev,TypeSafe 公司 9 月 15 日发布,创始人 Diogo Almeida 之前在 OpenAI,参与过 ChatGPT。它管自己叫 System One 模型,名字取自卡尼曼《思考,快与慢》里的"系统一",也就是快速、凭直觉、不展开推理的那一套。
它和普通大模型差在哪
我们平时用的大模型,干活方式是一个 token 一个 token 往外吐。你问它"这条 log 是什么问题",它边想边写,写完一大段,你还得自己从里面把结论捞出来。有时候捞出来的结论还是编的。
Jev 反过来。你先把题出好,规定答案只能是这几个选项之一。它读完输入,一次前向计算,直接告诉你选哪个,外加一个概率。题型有三种:Choice 是单选,从几个类别里挑一个;Noul 是是非题,给出"是"的概率;Score 是打分,比如 0 到 100 的紧急程度。几道题可以一次并行问完。
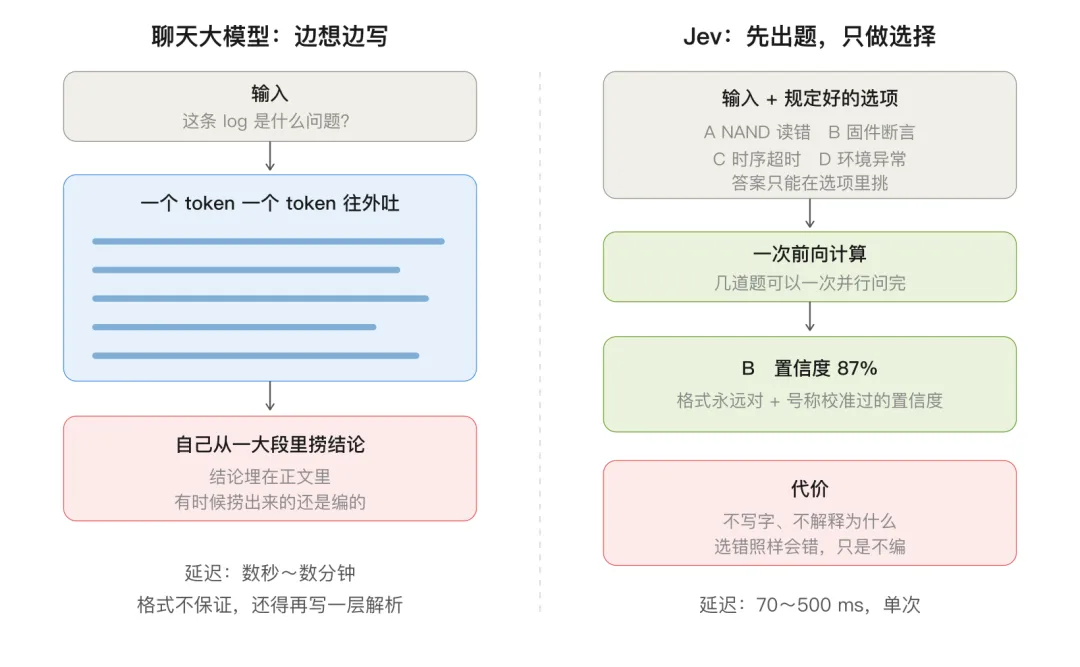
"从不幻觉"这四个字得打个折听。它确实编不出一个不存在的答案,因为答案空间是你划的,但它照样可能选错。它真正能保证的,是格式永远对,外加一个号称校准过的置信度:说 90% 的时候,大概真有九成是对的。
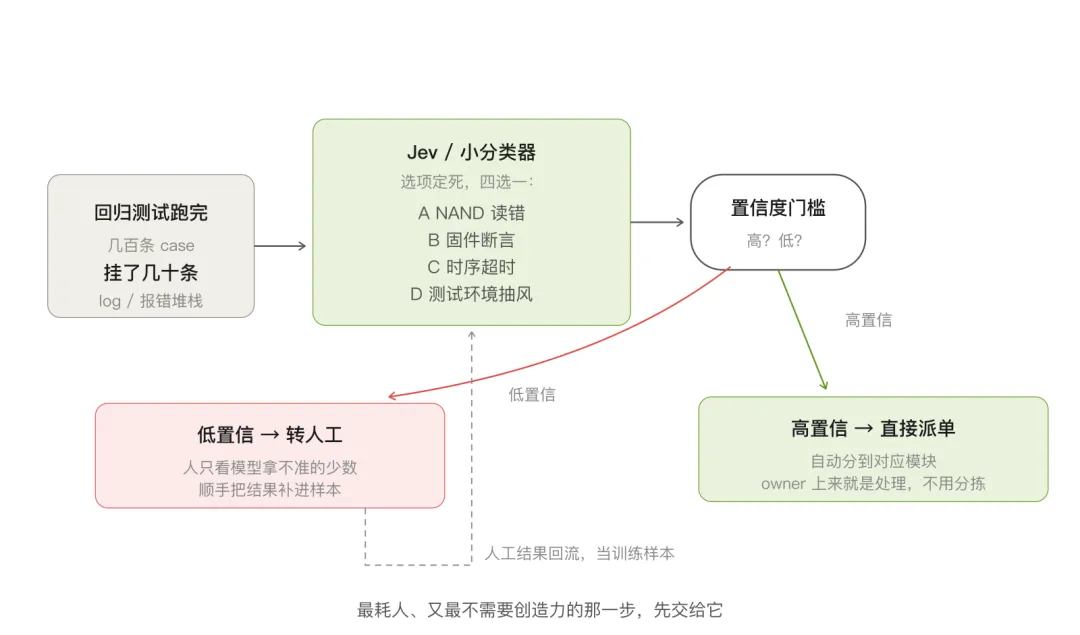
在自动化流程里,这个置信度比答案本身还值钱。你可以设一道门槛,高置信的直接放行,低置信的扔给人。
代价也明摆着:它不写字,也不解释为什么这么选。你没法追问它"凭啥觉得是 NAND 的锅"。
官方给的数据是单次延迟 70 到 500 毫秒,前沿大模型干同样的活要几秒到几分钟;输入每百万 token 0.042 美元,输出不收钱;在他们自己的四类工作流基准上,准确率跟一个顶级大模型基本打平。这些都是厂商自己报的,发布才一周,独立测评还没出来,看看就好。
回到那个问题:能进主控吗
"快"是相对的。70 毫秒对聊天机器人来说是飞快,对固件来说是天荒地老。
把时间尺度摆到一张图上就清楚了。一次 NAND 页读取 tR 在几十微秒量级;FTL 查一次映射表、决定 GC 挑哪个块、读失败后选下一档 retry 电压,留给这些决策的时间通常只有微秒级,甚至更短。Jev 最快的一次调用,也比一次 tR 慢上千倍。
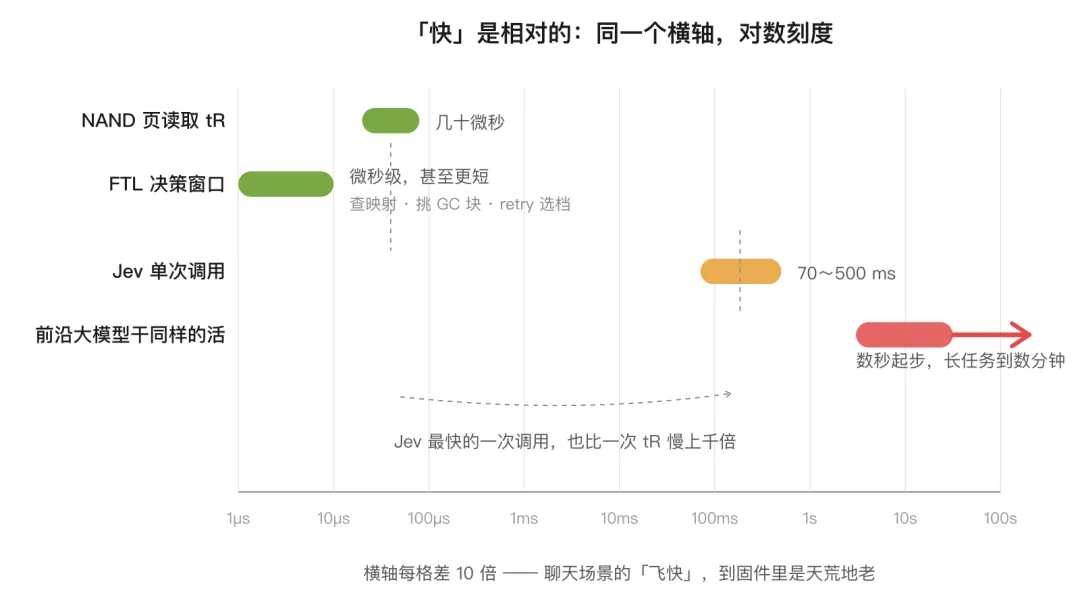
硬件条件就更不用提了。主控上跑的是几颗实时核,SRAM 按 KB、MB 算,没网络,更没 GPU。Jev 是云端 API,权重不公开,本地部署这个选项压根不存在。
所以"用 Jev 做 FTL 策略"这条路,可以直接划掉。
不过它的思路倒挺对固件的胃口。FTL 里本来就全是选择题:这笔写进 SLC 还是直写 TLC?这个块该不该 reclaim?这次读失败,下一步继续重试还是直接上软判决?答案空间都是固定的,而且选错的代价远比答得慢严重。真要在盘里做学习型决策,合理的形态是一个几 KB 的小分类器,离线训好烧进去,输出一个类别加一个置信度。跟 Jev 是同一个方向,尺寸差了好几个数量级而已。
那它能帮固件团队干啥
盘里用不上,盘外的活倒是一大堆。做过固件的都知道,每天花在"分拣"上的时间多到离谱。
第一件是测试失败分诊。回归一跑几百条 case,挂了几十条,第一步永远是分类:NAND 读错、固件断言、时序超时,还是测试环境自己抽风?这一步最耗人,又最不需要创造力。定好四五个类别,让模型先过一遍,高置信的直接派到对应模块,低置信的留给人看,顺手补进样本。
第二件是 bug 路由和查重。新单进来,归 FTL、HIL 还是链路层?是不是跟某张老单重复?严重等级几级?全是选择题。
第三件是给大模型 agent 当门卫。现在不少人拿大模型分析 trace、写脚本,产出能不能直接用,本质上是一道是非题。后面放一个又快又便宜、置信度靠谱的模型把关,比让大模型自己检查自己踏实。
第四件是 patch 风险初筛。这个改动碰没碰掉电恢复、映射表更新这类敏感路径?碰了,就强制多拉一位资深的 reviewer。
这四件事有个共同点:答案空间封闭,量大,单次决策没多少价值,但积少成多特别占人。聊天大模型也能做,就是又慢又贵,还得额外写一层解析,把结论从一大段文字里抠出来。
也得泼点冷水。代码和 log 能不能发到外部 API,在大多数存储公司都是硬杠杠,这关过不去,前面都白说。好在这个思路并不绑死在一家公司身上。发布没几天,GitHub 上就冒出一批开源复刻:有的从头训一个一亿多参数的小模型,有的拿开源大模型加上限定选项和概率校准来模拟。后一种在内网部署个开源模型就能搭,数据不出门。效果如何,得自己拿数据验。
还有一条:它不解释原因。分诊阶段够用,到了定位根因,还得靠人,或者靠会写字的大模型。它是分拣员,替代不了 FA 工程师。
最后说点感受
这两年 AI 圈卷的方向,基本是让模型想得更久、写得更长。Jev 反着走,把"判断"从"生成"里单拆了出来。对工程团队来说,大部分重复劳动恰恰是判断,写作反倒没那么多。
做固件的人对这种思路其实不陌生。我们在主控里写的,本来就是一堆又快又便宜、答案有限的决策器,只不过规则全是人手写的。规则写不完的那部分,现在多了一种可以试试的工具。
谁有兴趣动手:找一个开源复刻,按常见的测试 log 格式造一批样本,在本地搭个分诊器,看看它在固件场景里到底能分对几成。
免责声明:本文内容基于公开报道与公开资料整理,仅代表个人观点,与本人所在单位无关;不涉及任何厂商的非公开参数或商业秘密。文中延迟量级与配图数值均为示意,Jev 相关数据来自厂商公开信息,未经独立验证。本文不构成产品选型或商业建议,如有错漏,欢迎指正。