ARTICLE · 1078579
我花了一个月做实时语音AI助手,踩了7个坑才跑通
我花了一个月做实时语音AI助手,踩了7个坑才跑通受某实时语音对话产品启发,我决定自己动手做一个。从8月中到9月中,整整一个月,291次代码提交,3.8万行代码,最终跑通了。 这篇文章记录踩过的坑,每个都是真实遇到的,不是网上抄的。
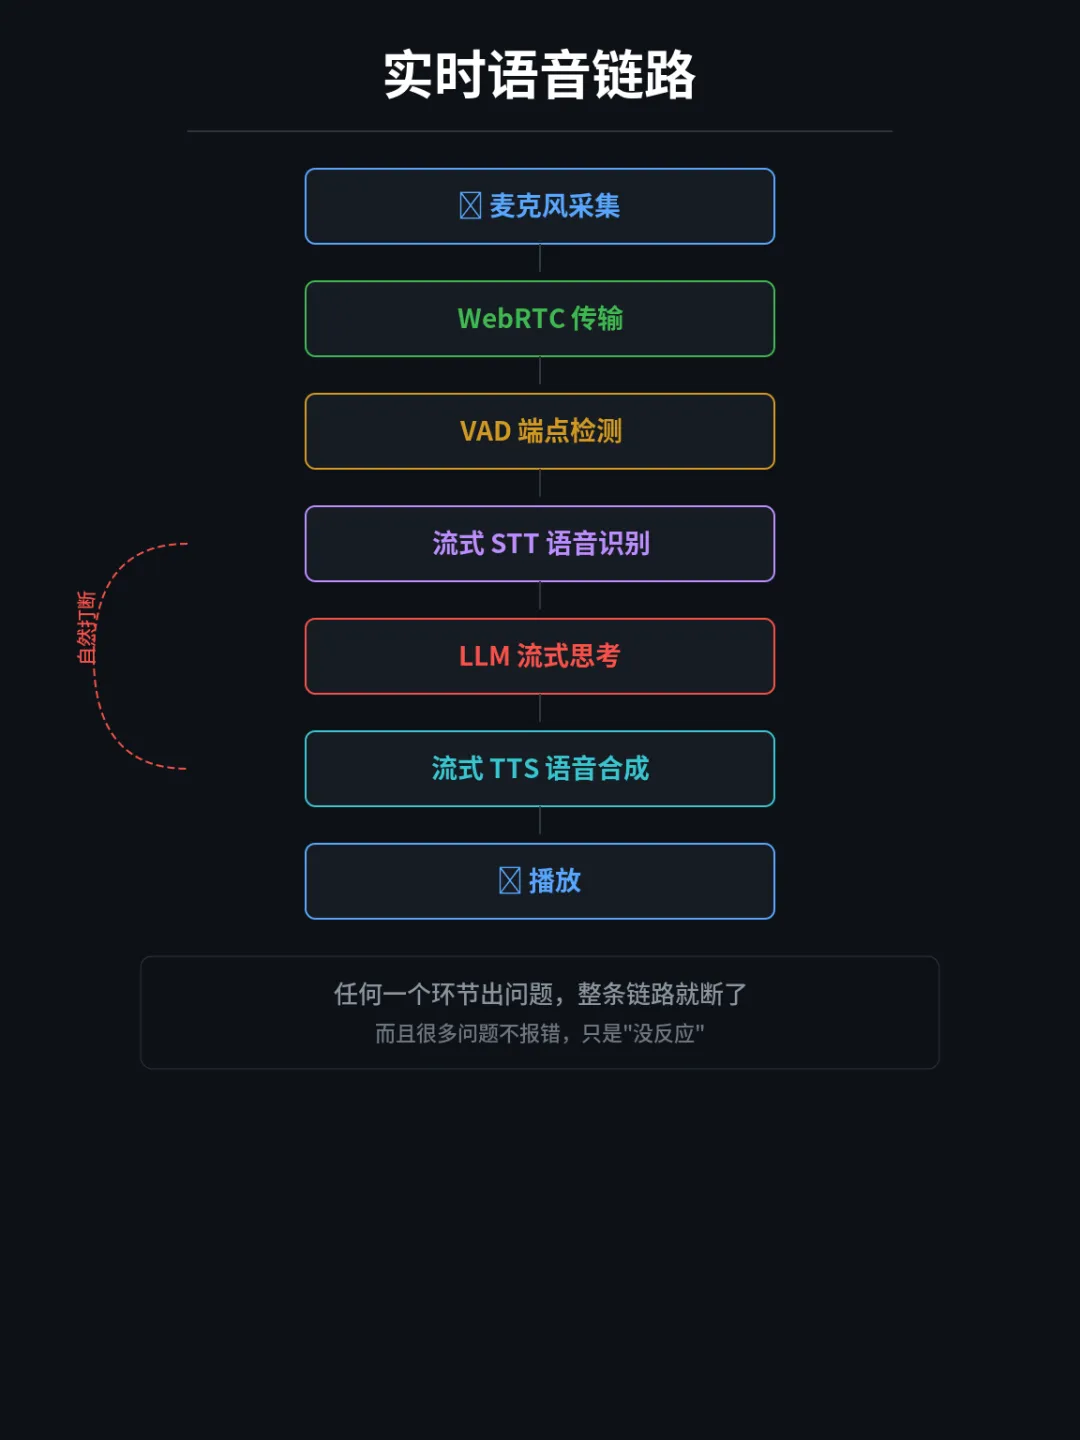
做一个浏览器里就能用的实时语音AI助手:打开网页,说话,AI实时回答,能随时打断。不需要装APP,不需要复杂配置。 技术链路:麦克风采集 → WebRTC传输 → VAD端点检测 → 语音识别 → LLM流式思考 → 语音合成 → 播放。全程可打断。 目标硬件:RTX 3060 6GB / 16GB内存。
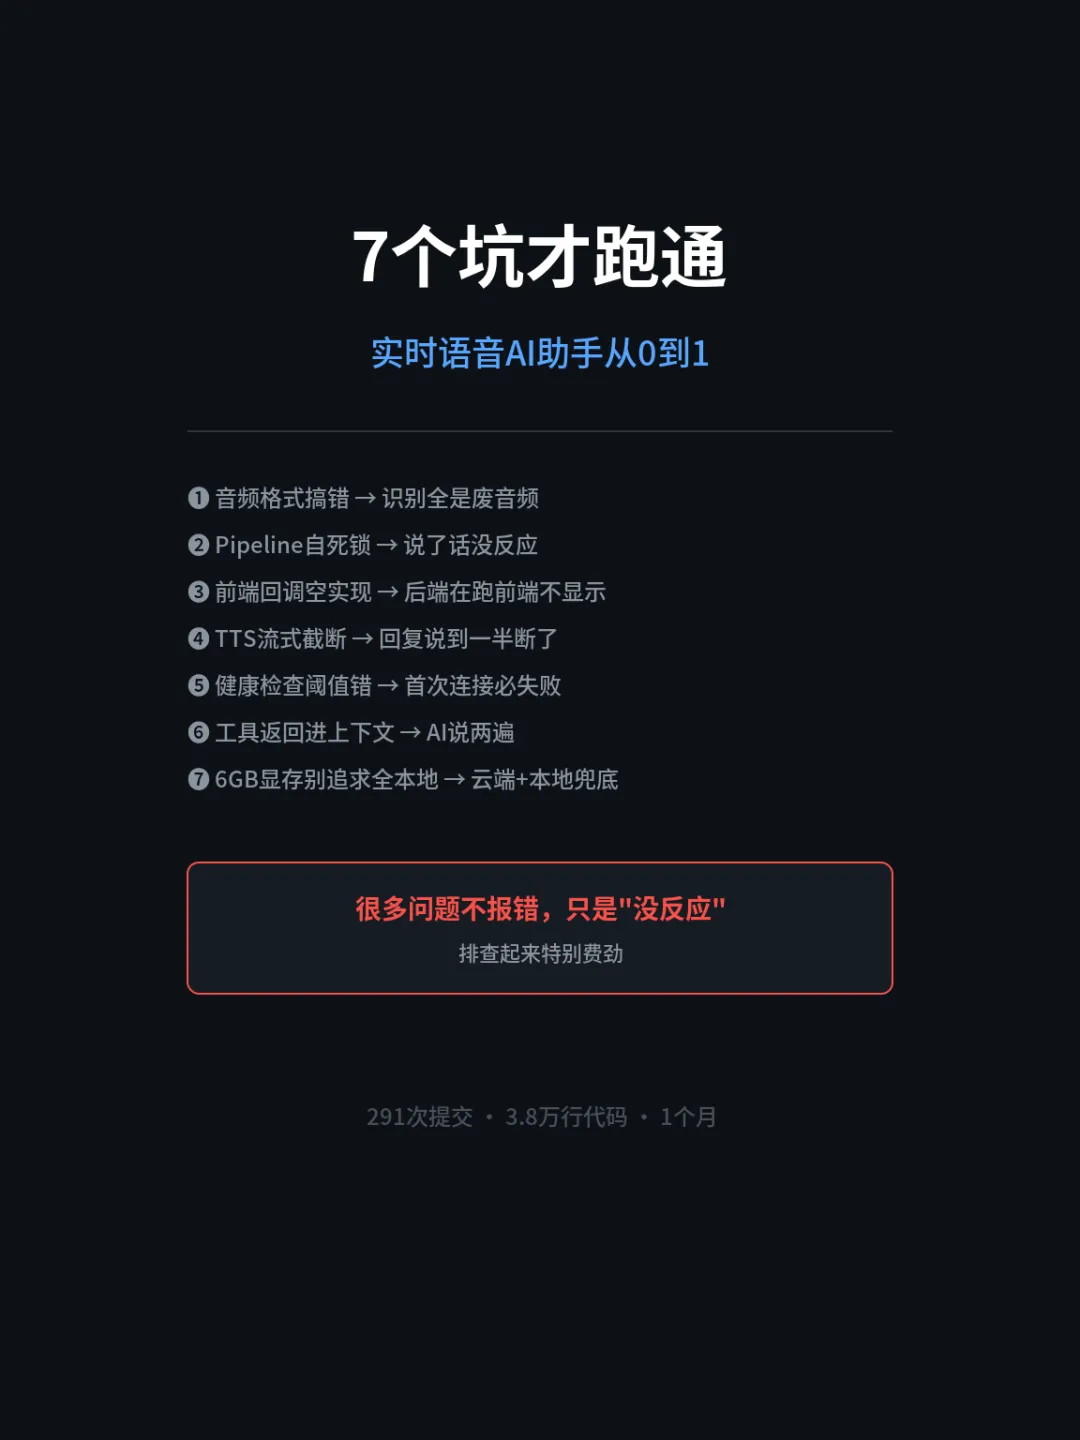
这是最隐蔽的一个坑。 WebRTC传输的音频是int16格式(取值范围-32768到32767),但处理代码里按float32(-1.0到1.0)做了裁剪。结果就是几乎所有样本被裁剪成±1或0,语音识别收到的是严重失真的音频。 现象:代码能跑,不报错,VAD能检测到语音开始,但识别结果要么为空要么乱码。 排查了很久,从VAD参数查到STT接口,最后才发现是音频格式不匹配。改成正确的int16处理后,识别立刻正常了。 教训:音频链路的每一步都要确认格式,int16和float32不能混用。 语音识别检测到语音结束后,触发了"停止监听并开始思考"的事件。但这个事件的处理函数里,直接调用了停止方法,而停止方法内部又去wait当前任务自己。 结果就是:任务A调用停止方法,停止方法wait任务A完成,任务A在等停止方法返回——死锁。2秒后超时被cancel,LLM和TTS根本没启动。 用户看到的现象:说了话,没任何反应,也没报错。 教训:异步任务里不要调用会wait自己的方法。事件消费和状态控制要分离。 这个坑最让人崩溃。 识别结果回调、LLM流式输出回调、状态变化回调,全是空函数(只写了函数名,里面是pass)。WebSocket也只处理了连接/断开的信令,没有处理业务消息。 后端其实在正常运行:识别在工作,LLM在输出,TTS在合成。但前端什么都收不到,所以界面上永远是"等待中"。 排查过程:看后端日志,一切正常。看前端控制台,没有任何消息。最后才发现回调函数是空的。 教训:端到端测试比单元测试重要。每个模块单独测都通过,不代表链路通了。必须从麦克风到扬声器完整跑一遍。 语音合成用的流式接口,每个音频分片到达就立即播放。但分片之间有边界问题,最后一个分片经常不完整,导致回复说到一半就断了。 加了缓冲队列:分片先入队,攒到一定量再播放,同时处理分片边界对齐。之后回复就完整了。 教训:流式输出不是"收到就播",要处理缓冲和边界。 worker的负载阈值设成2.0(CPU超2%判定不可用)。但ASR模型加载预热期CPU常年50%以上。 结果:首次连接必失败,因为预热中的worker被判定为不可用,请求被路由到其他worker,而其他worker也在预热。 改成:预热期不参与负载判断,预热完成后才开始健康检查。 教训:健康检查要区分预热期和稳态,不能用稳态阈值套预热阶段。 AI调用工具执行任务后,工具返回了一个中性的占位文本(比如"任务已完成")。这个文本被当作tool result进入了对话上下文,触发LLM对同一件事做了二次回复。 用户听到的就是:AI先说"任务完成了",然后又说"刚才那个任务已经完成了"。 修复:工具返回值区分"给用户看的"和"给LLM看的",占位文本不进入对话上下文。 教训:工具返回值的设计要考虑对LLM的影响,不是所有返回值都该进上下文。 最初想全本地运行:ASR本地、LLM本地、TTS本地。但RTX 3060只有6GB显存。 实际测试:ASR模型占2.2GB,TTS模型占1.4GB,加起来3.6GB。LLM即使用7B模型量化后也需要4-5GB,总共超过6GB,直接OOM。 最终方案: ASR + TTS本地跑(低延迟,语音交互需要) LLM走云端API(质量好,不占显存) 本地Ollama作为fallback(云端不可用时启用) 教训:消费级显卡不要追求全本地,云端优先+本地兜底是更务实的路线。
最终系统的几个关键设计: Provider中立架构:STT/LLM/TTS三路统一抽象,业务逻辑不绑定具体厂商。内置12个Provider,任何一个挂了自动切换。 可靠性四件套:超时→重试→熔断→降级。每个Provider调用设独立超时,失败自动重试,连续失败N次熔断,熔断后切fallback。 状态机管理对话流程:唤醒→休眠→对话中→打断中,四个状态明确转换条件。不用flag管理流程,避免flag组合爆炸。 自然打断:VAD检测到用户说话就立即停止当前播放和生成,不需要等AI说完。打断结束后自动恢复。 记忆三件套:工作记忆(当前对话)、长期记忆(用户偏好,SQLite持久化)、会话记忆(本次对话摘要)。对话结束后自动提取值得记住的信息。
实时语音不是"调个API"的事。 它是音频链路+状态机+可靠性+前端回调的系统工程。音频格式错了,识别废;Pipeline死锁了,没反应;回调空实现,前端不显示;TTS没缓冲,回复截断。 任何一个环节出问题,整个链路就断了。而且很多问题不报错,只是"没反应",排查起来特别费劲。 但跑通的那一刻,对着浏览器说话,AI实时回答,还能随时打断——那种感觉,值了。
一、项目目标
二、7个坑,每个都印象深刻
坑1:音频格式搞错,识别全是废音频
坑2:Pipeline自死锁,说了话没反应
坑3:前端回调是空实现,后端在跑但前端不显示
坑4:TTS流式输出被截断
坑5:健康检查阈值不考虑预热期
坑6:工具执行完AI说两遍
坑7:6GB显存不要追求100%本地
三、跑通后的架构