ARTICLE · 1082311
零代码文档驱动大模型开发---AI办公助手系列-OCR本地识别-tesseract翻篇到PP-OCRv4
一、项目需求
办公场景里,图片里藏着文字的情况:
• 扫描仪扫出来的 PDF,本质是一张张图片;
• 拍照拍下的通知、合同、白板;
• 别人发来的截图。
这些"图里的字",如果不能把它变成"能搜、能改、能复制的文字",那这份文档在办公软件里就是半残废。所以要做两件事:图片识别文字,以及扫描 PDF 转成可编辑文档。而且全程本地,不上传云端识别。
二、项目功能
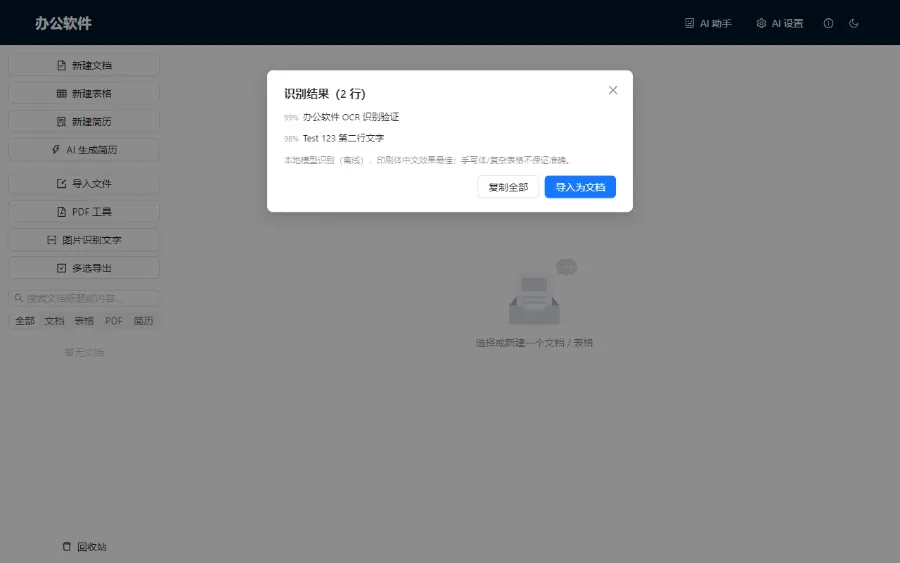
• 图片识别文字:侧栏「图片识别文字」,选中一张图,本地识别出中英文内容,弹窗展示,可复制、可一键导入成文档。
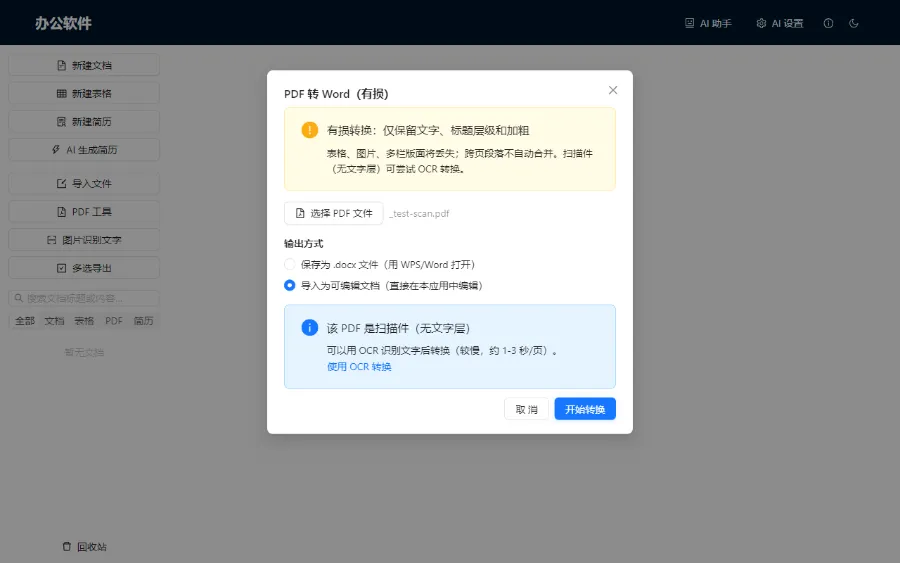
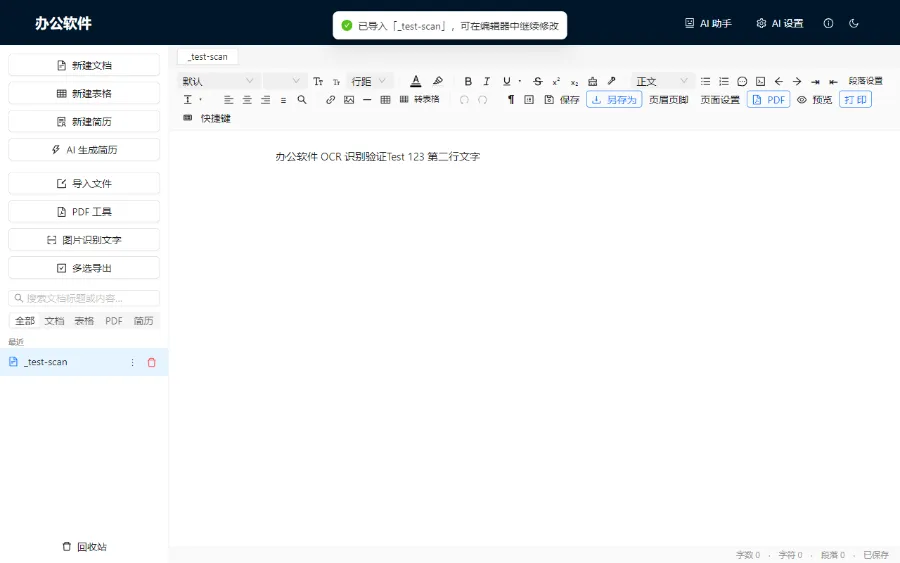
• 扫描 PDF 转 Word:无文字层的扫描 PDF,逐页渲染成图 → 本地 OCR 识别 → 还原成可编辑文档,保留段落结构。
三、藏在功能背后的思维链
决策一:OCR 引擎,为什么从 tesseract 翻篇到 PP-OCRv4?
坑:一开始理所当然选了最出名的 tesseract。结果在 Electron 里,它的 WASM 编译直接卡死,加上它的语言包全在境外 CDN,墙得干干净净。死磕半天,连"识别出第一个字"都没跑通。
解法:换成 PP-OCRv4 的中文识别方案(本地 onnxruntime 推理,模型随 npm 包离线打包)。先用一个小样片实测——中英文混排识别全对,模型加载 1 秒、识别 0.1 秒,再继续往下做。
思维沉淀:选型别迷信"名气",先跑通一个最小验证。 tesseract 名头响,但在你的环境里根本跑不起来。选型的第一标准是"在你这里能不能实测通过",而不是"它有名气"。
决策二:打包原生模块,为什么"能跑"会变成"打不开"?
坑:OCR 依赖的原生模块,开发环境跑得好好的,一打包成安装版就出问题。而且不是一个坑,是连环四个:
1. 模块是纯 ESM,Electron 的 Node 老版本不认 → 得塞进打包产物里;
2. onnxruntime、sharp 这些原生二进制是"传递依赖",打包器不主动管它们 → 得显式声明放外面;
3. 模型文件用 import.meta.url定位,打包后路径全变,而且原生 C++ 读不了 asar 虚拟路径 → 得换成运行时解析 + 路径改写;
4. 一个叫 color-name 的小依赖被嵌套放错位置,导致 color-convert 解析失败 → 得把它 pin 成直接依赖。
解法:一个个踩平,最后把 onnxruntime、sharp 的 DLL、模型文件都正确放进安装包,打包版才真的能识别。
思维沉淀:原生模块真正的坎,在"打包",不在"开发"。开发环境跑通只是第一步,离"用户双击安装版能用"还隔着打包这一大关。每个"能跑"背后,都可能藏着四个"打不开"的坑。
决策三:扫描 PDF 转 Word,OCR 坐标怎么对上?
坑:OCR 吐出来的是"图片像素坐标系"的坐标,而 PDF 用的是"点(point)坐标系",两个不是一回事,而且 y 轴方向还相反。直接拿来用,文字会错位、乱序。
解法:把 OCR 的像素坐标换算回 PDF 点系(乘上 72/dpi 的比例,再把 y 轴翻转),然后复用之前做 PDF 转 Word 的结构算法,把识别出的文字按段落还原。
思维沉淀:坐标系永远要"唯一基准"。这和前面做 PDF 签字时踩的坑一模一样——只要有两个坐标系并存,就一定有换算,有换算就一定有错位。定死一个基准,其它都往它身上换算,才不会再乱。