ARTICLE · 1083816
让AI学会“犯错”:用认知原型模拟不同水平的学生
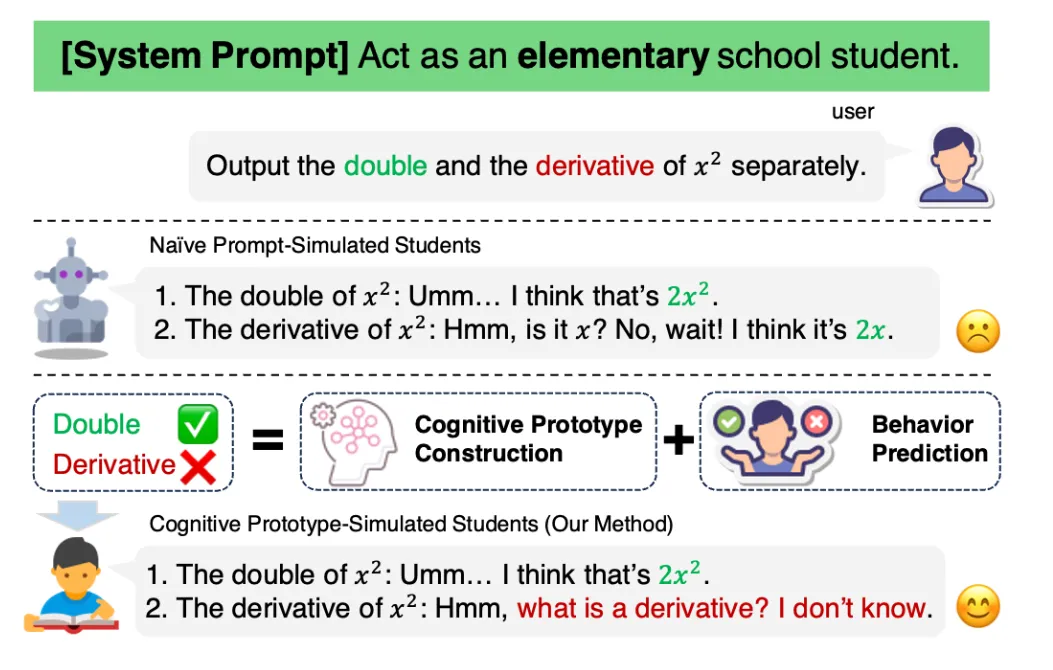
如果让GPT-4扮演一个小学生做数学题,它会输出什么?
大概率是正确答案——因为LLM被训练成“有帮助的助手”,倾向于生成完美回答。但真实的小学生不会做这道题,会犯错,会写出看起来合理但实际错误的答案。
一个无法“犯错”的AI,无法模拟真实的学生。
这篇发表在ACL 2025上的工作,提出了一个无需训练的框架,通过构建学生认知原型,让LLM生成符合不同认知水平的真实行为——包括那些自然的错误。
01. 核心问题:LLM的“助手偏见”
LLM在教育模拟中的一个根本矛盾:它们被训练为提供准确、有帮助的答案,而不是模仿学生学习的细微错误模式。
具体表现:
让LLM扮演小学生回答“x²的导数是什么”,它可能给出正确答案,而不是说“我不知道什么是导数”
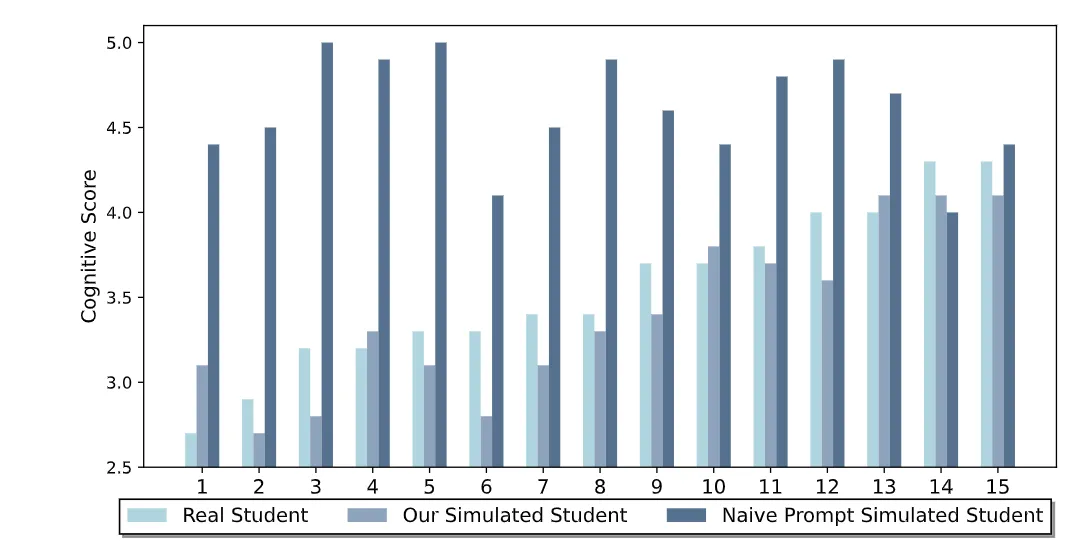
认知分数对比显示,朴素提示模拟的学生认知分数普遍高于真实学生
LLM倾向于高估低能力学生的认知水平,无法复制预期的易错行为
现有解决方案的局限:在错误丰富的数据集上微调LLM可以鼓励生成错误,但风险是嵌入错误知识,可能降低整体性能。更重要的是,这种方法忽略了学生学习的个性化本质——错误应该基于学生的认知状态自适应地引入。
02. 方法框架:三阶段认知原型
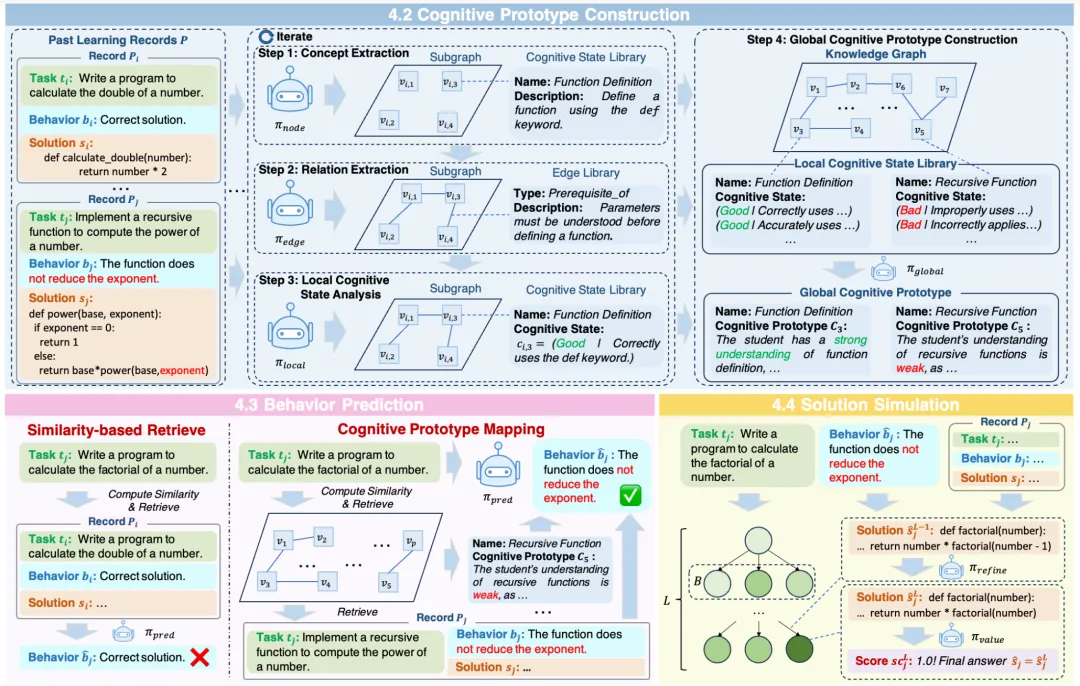
论文提出三阶段框架:
第一阶段:认知原型构建
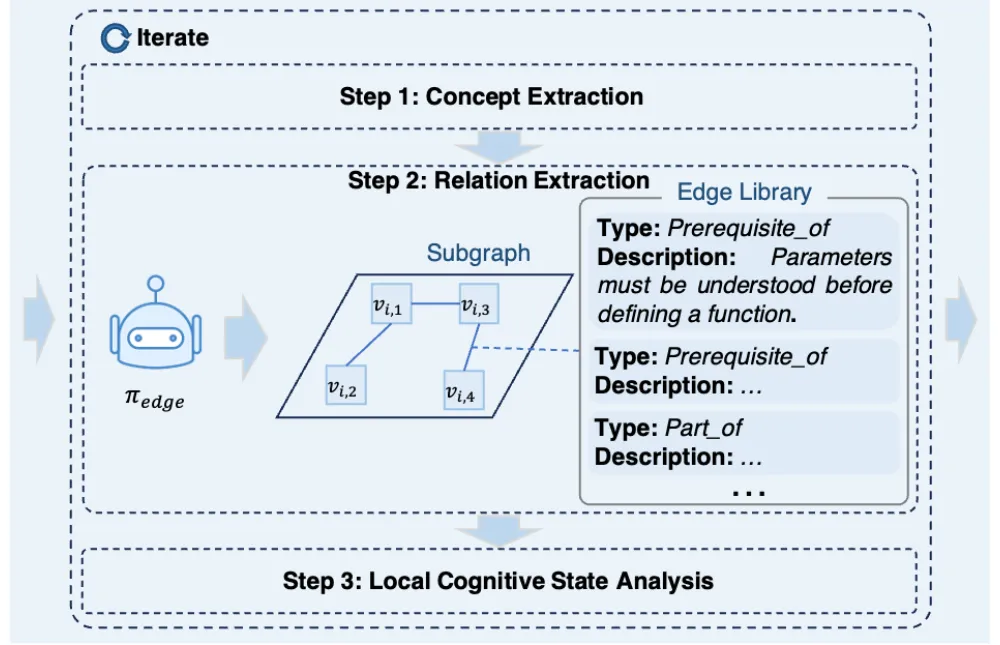
从学生过去的学习记录中,用知识图谱构建认知原型。每条记录被迭代处理,提取知识概念和关系,组织成基于自然语言的知識图谱。
四个关键步骤:
概念提取:用LLM生成任务的高层描述,识别推理策略和高级知识概念
关系提取:定义四种候选关系——Prerequisite_of、Used_for、Hyponym_of、Part_of
局部认知状态分析:评估学生对每个概念的掌握程度,分类为“Good”(无错误)或“Bad”(检测到错误)
全局认知原型构建:基于局部认知状态库,生成学生整体认知状态的总结
第二阶段:行为预测
传统方法检索最相似的任务,但依赖文本相似度,忽略底层知识概念。例如,“计算阶乘”可能检索到“计算两倍”,但两者需要完全不同的知识概念。
论文的方法是将认知原型映射到新任务:生成任务评估的概念描述,与知识图谱节点计算相似度,选择最相关的知识概念,找到包含最多这些概念的过去记录,结合学生的整体认知状态预测行为。
第三阶段:解决方案模拟
基于预测的行为,用束搜索自精炼方法生成一致的解决方案。如果预测行为反映正确方法,解决方案准确解决任务;如果行为表示潜在错误,解决方案应包含与预测行为一致的自然、有意的错误。
算法:初始弱解决方案 → 迭代精炼L步 → 每步采样B个候选 → 价值模型评分 → 选择最高分 → 直到达到阈值或最大迭代。
03. 数据集:Student_100
论文构建了Student_100数据集,来自在线编程平台PTA,包含100名学生的Python编程记录。
关键特征:
每名学生40条过去学习记录 + 10条模拟记录
每条记录包含:任务陈述、学生行为(正确/错误+错误分析)、解决方案(学生写的代码)
10名训练有素的标注者提供详细任务描述和行为分析
仅包含一周内的记录,确保认知状态稳定
学生认知分数分布:用o1-mini对模拟记录中的解决方案评分(1-5分),分布显示学生认知能力有显著差异。
04. 实验结果:模拟准确性和真实性翻倍
在15名学生的子集上,端到端比较6种行为预测方法和3种解决方案模拟方法:
| Prototype Mapping | 最高 | 最高 |
解决方案模拟:束搜索自精炼优于IO和CoT基线。
核心结果:论文方法在模拟准确性和真实性上实现了100%的提升。
人类评估:10名本科生对模拟解决方案评分,论文方法在所有模型设置下都获得更高的人类评估分数。
05. 深入分析:什么因素影响模拟质量
过去学习记录数量的影响:从10条增加到40条,行为预测和解决方案模拟持续改进。40条时行为预测准确率达到0.94。
自精炼迭代和束搜索采样大小:性能随迭代增加而提升,但L超过3后趋于稳定或略降(模型可能过度纠正)。B超过2后增益可忽略。最终选择L=3, B=2。
学生间模拟难度差异:模拟质量与学生认知能力呈正相关。认知能力越高的学生越容易模拟——他们犯错少,生成完全正确的解决方案比生成特定学生的真实错误更容易。
这凸显了准确建模低认知能力学生的挑战:需要模型不仅模拟正确响应,还要模拟合理的、个性化的错误。
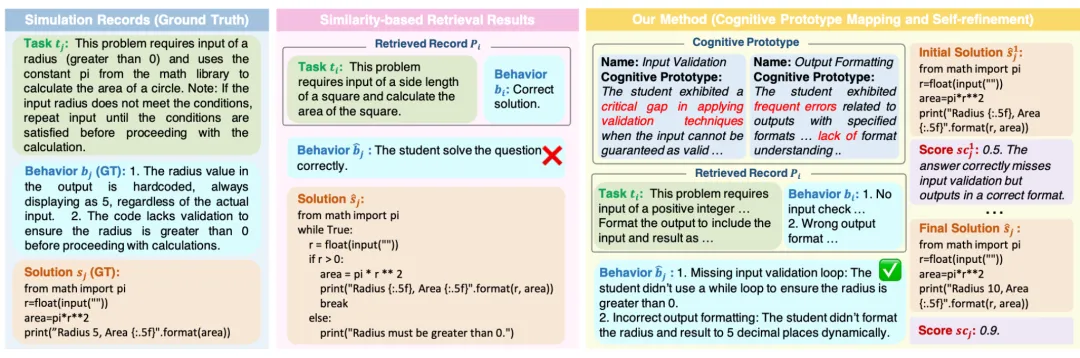
06. 案例研究:相似度检索 vs 认知原型映射
相似度检索失败案例:仅依赖任务陈述的文本相似度,检索到不合适的过去记录,导致模型错误预测学生行为为“正确解决”,生成完全正确的解决方案,与真实学生答案矛盾。
认知原型映射成功案例:将构建的认知原型映射到任务,准确识别学生 struggled 的相关知识概念。通过检索正确的过去记录,模型做出准确的行为预测,明确描述学生可能犯的错误。基于此预测,自精炼过程迭代调整生成的解决方案以反映这些预测错误,最终生成真实、准确的模拟。
07. 对科研人员的启示
✅ 启示一:LLM的“助手偏见”是教育模拟的根本障碍
LLM被训练为提供正确答案,这与模拟学生错误行为的目标直接冲突。如果你在做教育模拟,不要期望LLM自动生成真实的错误——需要显式的方法来引导。
✅ 启示二:认知原型提供可解释的学生状态表示
用知识图谱显式建模学生对每个概念的掌握程度,比隐式神经网络表示更具可解释性,支持更精确的行为预测。显式的、自然语言驱动的框架比隐式参数化知识更适合需要解释和泛化的教育任务。
✅ 启示三:行为预测应先于解决方案生成
直接生成解决方案容易忽略学生的具体错误模式。先预测行为(正确/错误+错误描述),再基于行为生成解决方案,确保一致性和真实性。
✅ 启示四:自精炼需要自评估引导
没有价值模型的自精炼性能下降。迭代改进必须由评估机制引导,确保精炼方向正确。
✅ 启示五:模拟难度与认知能力相关
高认知能力学生更容易模拟。低认知能力学生的模拟是更大的挑战,需要模型生成合理、个性化的错误,而不仅仅是正确答案。
✅ 启示六:编程任务是学生模拟的理想场景
编程任务具有复杂性、多层次性、错误多样性和迭代性,是建模和模拟学生认知状态的理想场景。方法理论上可扩展到数学等其他学科。
08. 局限与未来
当前验证限于编程领域,虽然框架理论上适用于更广泛的教育科目
主要关注文本和行为模式,未显式整合视觉或听觉等多模态信号
需要进一步研究更大规模的学习记录数量
教育数据中的噪声和混杂因素需要因果去偏方法处理
09. 总结
这篇论文的核心贡献是一个无需训练的框架,通过认知原型构建、行为预测和自精炼解决方案模拟,让LLM生成符合不同认知水平的真实学生行为——包括那些自然的错误。
它证明了:LLM的“助手偏见”可以被显式的认知建模克服。 对于AI教育应用,这意味着更真实的学生模拟、更有效的教学策略评估和更可靠的智能辅导系统测试。
让AI学会“犯错”,才能真正理解学习。
参考文献:Wu, T., Chen, J., Lin, W., et al. "Embracing Imperfection: Simulating Students with Diverse Cognitive Levels Using LLM-based Agents." ACL 2025.
项目页面:https://mccartney01.github.io/student_sim