ARTICLE · 1087877
FreeRTOS 流缓冲与消息缓冲源码剖析:主体不用等待链表,也不用关中断的队列
前面系列拆过的每个组件,等待机制全是同一个模式:把等待者登记在某处、让它睡、事件来了叫醒它——队列、信号量、互斥量各挂两条等待链表,事件组挂一条,任务通知干脆不挂——但通知只能一对一。现在问题来了:串口日志要传变长字符串,队列要求定长,一句 8 字节和一句 200 字节的日志要么浪费要么截断;用 DMA 收到的数据帧长度随时在变;音频编解码器吐出来的字节流根本没有"条"的概念。
FreeRTOS V11 给的答案在工程里躺了很久没人动:stream_buffer.c。这个文件最反常的地方在于:它里面没有一条等待链表,主体路径上也没有一个关中断(登记等待句柄的一瞬间除外,见 4.3)——全系列拆到这里,队列家族靠关中断保护,事件组靠挂起调度器保护,流缓冲"不用"。
这篇文章把 stream_buffer.c 拆开,看环形字节流怎么靠"头尾两个索引永不见面"做到零保护、唤醒怎么退化成"一个句柄+一次任务通知"、消息缓冲怎么用 4 字节长度前缀在字节流上切出一条条消息。先让两个实验跑起来——变长日志原样进出、同样 20 字节唤醒次数差 5 倍——再进源码。读完你会发现:流缓冲不是又一个队列,它是任务通知篇的"直改直醒"思想 + 队列篇的数据搬运合起来的产物。
平台:STM32F103RET6(Cortex-M3,标准库)内核:FreeRTOS V11.1.0本工程 configSUPPORT_DYNAMIC_ALLOCATION = 1,configMESSAGE_BUFFER_LENGTH_TYPE = size_t(4 字节),configUSE_SB_COMPLETED_CALLBACK = 0,configUSE_STREAM_BUFFERS = 1(为 0 时 stream_buffer.c 整个文件不编入)——本文按此配置剖析关联阅读:唤醒机制(xTaskNotifyIndexed的 eNoAction 信号用法)在《FreeRTOS 任务通知源码剖析:凭什么比二值信号量快 45%?》拆过;FromISR 红线(VECTACTIVE 断言、优先级 ≥5、尾延迟切换)在《中断里写的第一行 FreeRTOS API 就死机:5 个版本,5 个坑,学透中断管理》拆过
一、概述
1.1 流缓冲是什么
流缓冲是一个环形字节数组 + 头尾两个索引:写者推 xHead,读者推 xTail,两者之间就是有效数据。没有元素长度的概念——写入 7 字节就是 7 字节,读取方要多少给多少,给了你才知道给了多少。
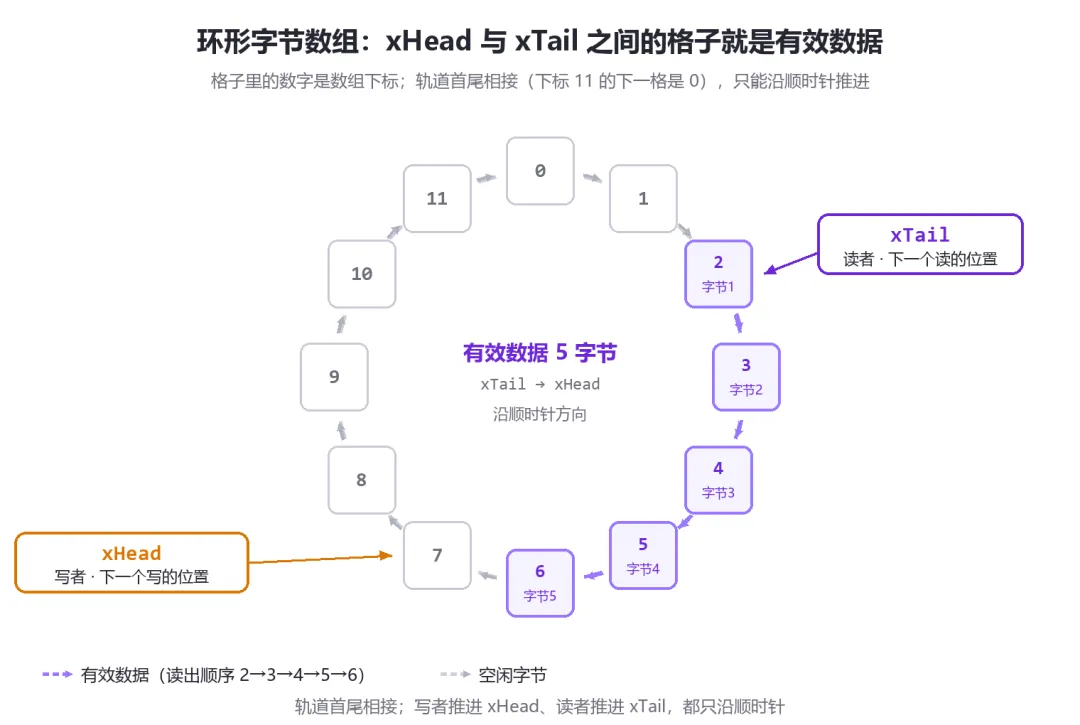
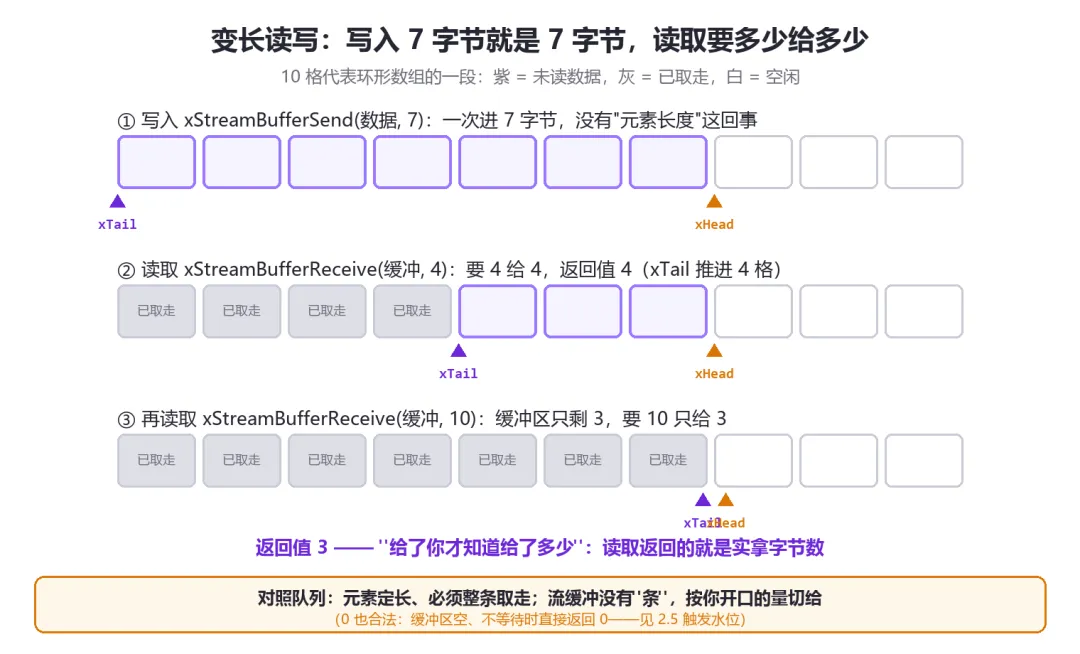
/* FreeRTOS/stream_buffer.c StreamBuffer_t (节选) */typedef struct StreamBufferDef_t{volatile size_t xTail; /* 读索引: 下一个读的位置 */volatile size_t xHead; /* 写索引: 下一个写的位置 */size_t xLength; /* 缓冲区总长(字节数+1, 见4.2) */size_t xTriggerLevelBytes; /* 触发水位: 攒够几字节才叫醒读者 */volatile TaskHandle_t xTaskWaitingToReceive; /* 等数据的任务(注意: 是句柄不是链表!) */volatile TaskHandle_t xTaskWaitingToSend; /* 等空间的任务(同上) */uint8_t * pucBuffer; /* 存储区指针 */uint8_t ucFlags; /* 流/消息/批量缓冲标记 */UBaseType_t uxStreamBufferNumber; /* 追踪编号(configUSE_TRACE_FACILITY=1 时才有) *//* configUSE_SB_COMPLETED_CALLBACK=0:两个完成回调字段本工程不编入 */UBaseType_t uxNotificationIndex; /* 唤醒用的任务通知通道号,默认 0(见4.6) */} StreamBuffer_t;
对照队列家族看结构差异就明白它为什么"轻":
| 变长字节流 | |||
| 两个句柄槽位 | |||
| 各最多 1 个 | |||
| 无 | |||
| 发一次任务通知 |
1.2 消息缓冲是什么
消息缓冲 = 同一个 StreamBuffer_t,加 4 字节长度前缀的装帧协议。xMessageBufferCreate 在 message_buffer.h 里是个宏,转手调的还是流缓冲的创建函数:
/* FreeRTOS/include/message_buffer.h */#define xMessageBufferCreate( xBufferSizeBytes ) \xStreamBufferGenericCreate( ( xBufferSizeBytes ), ( size_t ) 0, sbTYPE_MESSAGE_BUFFER, NULL, NULL )
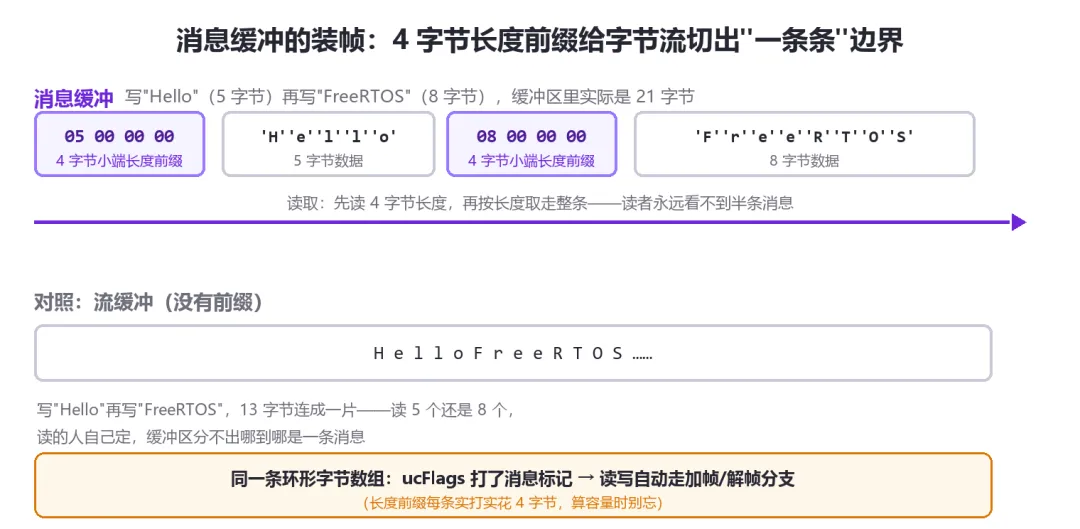
区别只在 ucFlags 打了 sbFLAGS_IS_MESSAGE_BUFFER 标记,之后所有读写函数看到这个标记就走"加帧/解帧"分支:写入时先写 4 字节长度再写数据,读取时先读 4 字节长度再按长度读数据。xMessageBufferSend 也是直通宏(message_buffer.h),一个字节的额外逻辑都没有。(ucFlags 还有第三个标记 sbFLAGS_IS_BATCHING_BUFFER——批量缓冲把触发水位从"攒够才叫醒"升级成"攒够才给读",读者不攒够水位一律阻塞,专为 SendFromISR 高频小写入攒批设计,本文不展开。)
本工程 configMESSAGE_BUFFER_LENGTH_TYPE = size_t,即每条消息开头 4 字节是长度——这个字段能数到的上限就是"约 4GB"(32 位 size_t 最大 2³²−1),实际单条上限是"缓冲区容量 − 4"(100 字节缓冲单条最大 96 字节);若配成 uint16_t,前缀省一半、上限变 64KB。前缀却实打实每条都花 4 字节,计算容量时别忘了。
1.3 API 家族
xStreamBufferCreate(字节数, 触发水位) | ||
xStreamBufferSend(sb, 数据, 字节数, 超时) | ||
xStreamBufferReceive(sb, 缓冲, 字节数, 超时) | ||
xStreamBufferSendFromISR / ReceiveFromISR | ||
xMessageBufferSend / Receive | ||
xStreamBufferNextMessageLengthBytes(mb) | ||
xStreamBufferSetTriggerLevel | ||
xStreamBufferReset | 有人等着就返回 pdFAIL | |
vStreamBufferDelete |
1.4 和队列的定位对比
| 不支持(硬约束) | 不支持(硬约束) | ||
一句话选型:定长且多个生产者 → 队列;变长消息、单读单写 → 消息缓冲;纯字节流 → 流缓冲。
二、使用场景
xMessageBufferSend 整行发送,ISR 里 DMA 搬完再 SendFromISR | ||
xStreamBufferSendFromISR 整帧进缓冲 | ||
| 不该用 |
三、测试场景用例(先跑起来)
两个实验分别演示消息缓冲的整条收发(变长日志行长原样还原)和流缓冲的触发水位(同样 20 字节、两种水位唤醒次数差 5 倍)。
任务规划(2 个任务 + 2 个内核对象——对照任务通知篇的"0 个对象":任务通知把事件写进 TCB 白送,流缓冲回到"按对象收费"的老路,但换来了变长数据能力):
注意这个实验天然满足单读单写:全工程只有 vSbProducer 往两个缓冲里写、只有 vSbConsumer 从两个缓冲里读——这是流缓冲的硬约束(见坑清单第 1 条),不是可选风格。
完整代码
① 声明与参数
#include"FreeRTOS.h"#include"task.h"#include"stream_buffer.h"/* 流缓冲 API */#include"message_buffer.h"/* 消息缓冲 API(注意:是它包含 stream_buffer.h,方向别记反) */#include<stdio.h>#include<string.h>/* strlen *//* 实验参数。注意本工程 configTICK_RATE_HZ=100,1 tick=10ms: *//* pdMS_TO_TICKS(<10) 会被取整为 0——所有延时参数都必须 ≥10ms */#define SBf_LOG_LINES 3 /* 实验一:每轮发 3 行变长日志 */#define SBf_LOG_ROUNDS 2 /* 实验一共 2 轮(6 行) */#define SBf_LOG_PERIOD_MS 500#define SBf_BURST_TIMES 5 /* 实验二:每轮写 5 次 */#define SBf_BURST_SIZE 4 /* 每次写 4 字节,一轮共 20 字节 */#define SBf_BURST_PERIOD_MS 100#define SBf_WATER_HIGH 20 /* 实验二第一轮水位:攒够 20 字节才醒 */#define SBf_ROUND_BYTES ( SBf_BURST_TIMES * SBf_BURST_SIZE )/* printf 任务栈:标准库 printf 栈开销大,128 字容易触发栈溢出钩子,统一给 256 字 */#define SBf_PRINTF_STACK ( configMINIMAL_STACK_SIZE * 2 )/* 两个内核对象:消息缓冲(实验一)+ 流缓冲(实验二) *//* MessageBufferHandle_t 本质就是 StreamBufferHandle_t 的别名(message_buffer.h) */static MessageBufferHandle_t xLogMb = NULL;static StreamBufferHandle_t xStream = NULL;
② 发送方任务A:先跑实验一(变长日志),再跑实验二(5×4 字节+切换水位),循环往复
staticvoidvSbProducer( void *pvParameters ){(void)pvParameters;static const char *pcLines[ SBf_LOG_LINES ] = {"boot ok","sensor ready ch0","voltage 3.27V temperature 26.5C pressure 1013hPa"};uint32_t i, round, k;size_t xLen;uint32_t ulDummy;for( ;; ){/* ---- 实验一:消息缓冲发变长日志,行长随内容变(7/16/48 字节) ---- */for( round = 1; round <= SBf_LOG_ROUNDS; round++ ){for( i = 0; i < SBf_LOG_LINES; i++ ){xLen = strlen( pcLines[ i ] );(void)xMessageBufferSend( xLogMb, pcLines[ i ], xLen,pdMS_TO_TICKS( 100 ) );printf( "任务A:发送 %u 字节日志\r\n", (unsigned int)xLen );vTaskDelay( pdMS_TO_TICKS( SBf_LOG_PERIOD_MS ) );}}vTaskDelay( pdMS_TO_TICKS( 1000 ) ); /* 留时间给消费者收尾打印 *//* ---- 实验二:每轮写 5 次 × 4 字节;第一轮水位 20、第二轮水位 1 ---- */(void)xStreamBufferSetTriggerLevel( xStream, SBf_WATER_HIGH );for( round = 1; round <= 2; round++ ){printf( "任务A:第 %u 轮写入 5×4 字节\r\n", (unsigned int)round );for( k = 0; k < SBf_BURST_TIMES; k++ ){(void)xStreamBufferSend( xStream, &ulDummy, SBf_BURST_SIZE,pdMS_TO_TICKS( 100 ) );vTaskDelay( pdMS_TO_TICKS( SBf_BURST_PERIOD_MS ) );}vTaskDelay( pdMS_TO_TICKS( 1000 ) ); /* 等消费者打印本轮统计 */(void)xStreamBufferSetTriggerLevel( xStream, 1 ); /* 第二轮水位 1 */}/* 一轮结束,回到实验一重新开始 */}}
③ 接收方任务B:两段接收与发送方的两段写入逐条对应
staticvoidvSbConsumer( void *pvParameters ){(void)pvParameters;char pcBuf[ 64 ];uint32_t line, round, woken;size_t xNext, xGot, xTotal;for( ;; ){/* ---- 实验一:整条收变长日志,行长 7/16/48 原样还原 ---- */printf( "\r\n=== 实验一:消息缓冲传变长日志(行长原样还原)===\r\n" );line = 0; /* 已收行数: 收成一行才 +1 */while( line < SBf_LOG_ROUNDS * SBf_LOG_LINES ){xNext = xStreamBufferNextMessageLengthBytes( xLogMb ); /* 只探长, 不消费 */if( xNext == 0 || xNext > sizeof( pcBuf ) - 1 ){vTaskDelay( pdMS_TO_TICKS( 50 ) ); /* 暂时没消息, 歇 50ms 再探 */continue; /* 没收成, 不计数 */}xMessageBufferReceive( xLogMb, pcBuf, xNext, portMAX_DELAY );pcBuf[ xNext ] = '\0';printf( "[LOG] %s\r\n", pcBuf );line++;}/* ---- 实验二:收满 20 字节算一轮,统计从阻塞里被唤醒的次数 ---- */printf( "\r\n=== 实验二:流缓冲触发水位(每轮写入 5×4=20 字节)===\r\n" );for( round = 1; round <= 2; round++ ){woken = 0;xTotal = 0;while( xTotal < SBf_ROUND_BYTES ){/* 请求 20 字节,有多少读多少——返回值是实拿字节数 */xGot = xStreamBufferReceive( xStream, pcBuf, SBf_ROUND_BYTES,portMAX_DELAY );if( xGot > 0 ){woken++;xTotal += xGot;}}printf( "任务B:第 %u 轮被唤醒 %u 次,共收 %u 字节\r\n",(unsigned int)round, (unsigned int)woken,(unsigned int)xTotal );}/* 回到实验一,循环往复 */}}
④ 入口:创建两个对象和两个任务,在 main() 里 vTaskStartScheduler() 之前调用
voidstream_buffer_demo( void ){xLogMb = xMessageBufferCreate( 256 ); /* 实验一:变长日志 */xStream = xStreamBufferCreate( 128, SBf_WATER_HIGH ); /* 实验二:初始水位 20 */xTaskCreate( vSbConsumer, "SbRcv", SBf_PRINTF_STACK, NULL,tskIDLE_PRIORITY + 1, NULL );xTaskCreate( vSbProducer, "SbSend", SBf_PRINTF_STACK, NULL,tskIDLE_PRIORITY + 2, NULL );}
输出符合预期(一轮约 7 秒:实验一 6 行 × 500ms = 3 秒 + 间隔 1 秒 + 实验二两轮各约 1.5 秒,然后循环):
任务A:发送 7 字节日志 ← A(+2) 优先级高,调度器一启动就先打印发送=== 实验一:消息缓冲传变长日志(行长原样还原)===[LOG] boot ok ← 横幅由随后上 CPU 的 B 打印,之后 B 逐行收任务A:发送 16 字节日志[LOG] sensor ready ch0任务A:发送 48 字节日志[LOG] voltage 3.27V temperature 26.5C pressure 1013hPa(第二轮同上,6 行行长 7/16/48 原样进出)=== 实验二:流缓冲触发水位(每轮写入 5×4=20 字节)===任务A:第 1 轮写入 5×4 字节任务B:第 1 轮被唤醒 1 次,共收 20 字节 ← 水位 20:第 5 次写完才醒任务A:第 2 轮写入 5×4 字节任务B:第 2 轮被唤醒 5 次,共收 20 字节 ← 水位 1:每写 4 字节醒一次
用队列做实验一同样的事,要么开 200 字节的定长槽传 7 字节的行(浪费 95%+),要么截断长行——消息缓冲把"行长"从队列的创建期参数变成了运行期数据。
两个实验都跑通了,三个现象进源码前先记下
行长 7/16/48 的三行日志一条不多、一条不少地原样进出——消费者凭什么知道每条到哪结束?(答案:4 字节长度前缀 + 写入的最后一步提交,见 4.8) 水位 20 的那一轮,前 4 次写入期间消费者一直睡着——它睡在哪、谁在第 5 次写入时把它叫醒?(答案:不睡在链表上,睡在任务通知上,见 4.6) 同样 20 字节,两种水位唤醒次数差 5 倍——那 4 次没唤醒的写入,到底省掉了什么?(答案:触发水位挡掉的是 sbSEND_COMPLETED 那次任务通知,见 4.7)
四、源码剖析
4.1 总起:零保护怎么敢
流缓冲的所有"反常"都来自一个设计决定:写者只碰 xHead,读者只碰 xTail,两个索引永不见面。
写路径:查空间(读 xTail 算距离)→ 搬数据到 xHead 附近 → 推进 xHead。全程只写 xHead 和数据区; 读路径:查数据量(读 xHead 算距离)→ 搬数据出去 → 推进 xTail。全程只写 xTail。
写者永远不改读者的字段,读者永远不改写者的字段——没有共享写,自然不需要临界区。这不是新发明,是单生产者单消费者环形缓冲的经典无锁做法;FreeRTOS 的贡献是给它补上了"阻塞等待"和"ISR 安全"两层,用的全是前面篇章拆过的旧零件。
代价就是 1.4 表里那条硬约束:必须恰好一个写者、一个读者。两个任务同时写,两个 xHead 各推各的,数据当场交错损坏。源码里 configASSERT( pxStreamBuffer->xTaskWaitingToSend == NULL )抓的是等待登记的重叠,写本身的重叠它抓不到——那是你自己要靠设计保证的。
用一张图把"各管各的"画出来:
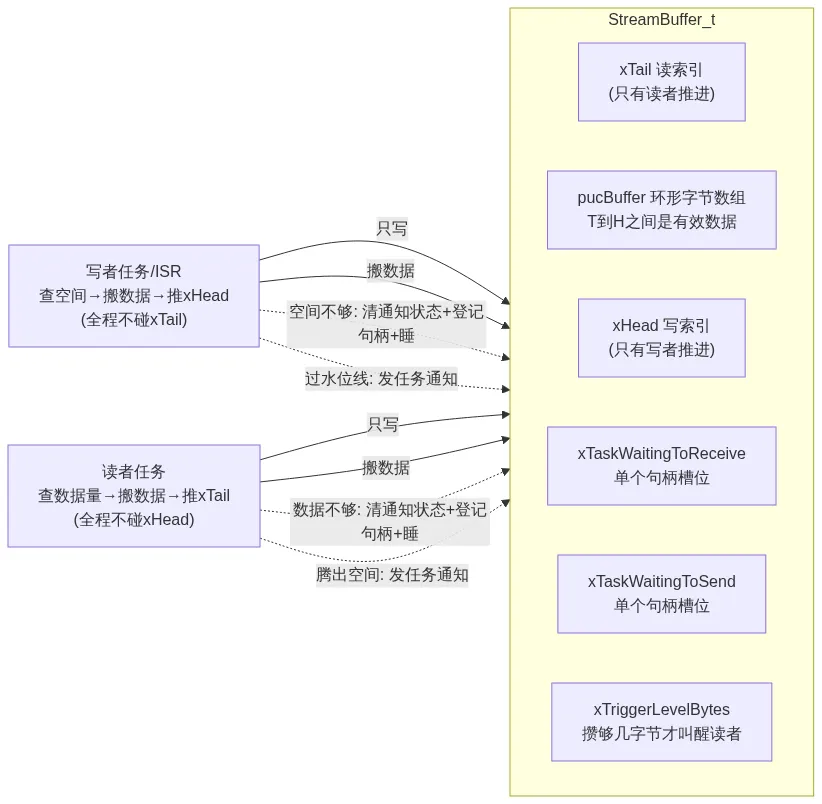
读图就一句话:左右两半互不越界——写者只推 xHead、往数据格写字节、登记 xTaskWaitingToSend;读者只推 xTail、从数据格取字节、登记 xTaskWaitingToReceive。谁也不碰对方的字段,等待和唤醒全靠两个句柄槽位传递。
4.2 创建:一次 malloc,结构在头、缓冲区紧随其后
/* FreeRTOS/stream_buffer.c xStreamBufferGenericCreate (节选) */prvInitialiseNewStreamBuffer( ( StreamBuffer_t * ) pvAllocatedMemory, /* 结构体放在头部 */( ( uint8_t * ) pvAllocatedMemory ) + sizeof( StreamBuffer_t ), /* 存储区紧随其后 */xBufferSizeBytes,xTriggerLevelBytes,ucFlags,pxSendCompletedCallback,pxReceiveCompletedCallback );
结构体和存储区一块 malloc(对比队列:也是一块,queue.c 的做法相同)。好处是 vStreamBufferDelete 一次 vPortFree 完事,不存在"对象活着但存储区没了"的组合状态。ucFlags 是身份标记:sbFLAGS_IS_MESSAGE_BUFFER(消息缓冲)或 0(流缓冲),后面所有读写函数靠它分流。
创建函数里还有个容易被忽略的细节:
/* FreeRTOS/stream_buffer.c xStreamBufferGenericCreate (节选) */if( xBufferSizeBytes < ( xBufferSizeBytes + 1U + sizeof( StreamBuffer_t ) ) ){xBufferSizeBytes++; /* 申请 N 字节, 实际按 N+1 分配 */pvAllocatedMemory = pvPortMalloc( xBufferSizeBytes + sizeof( StreamBuffer_t ) );}
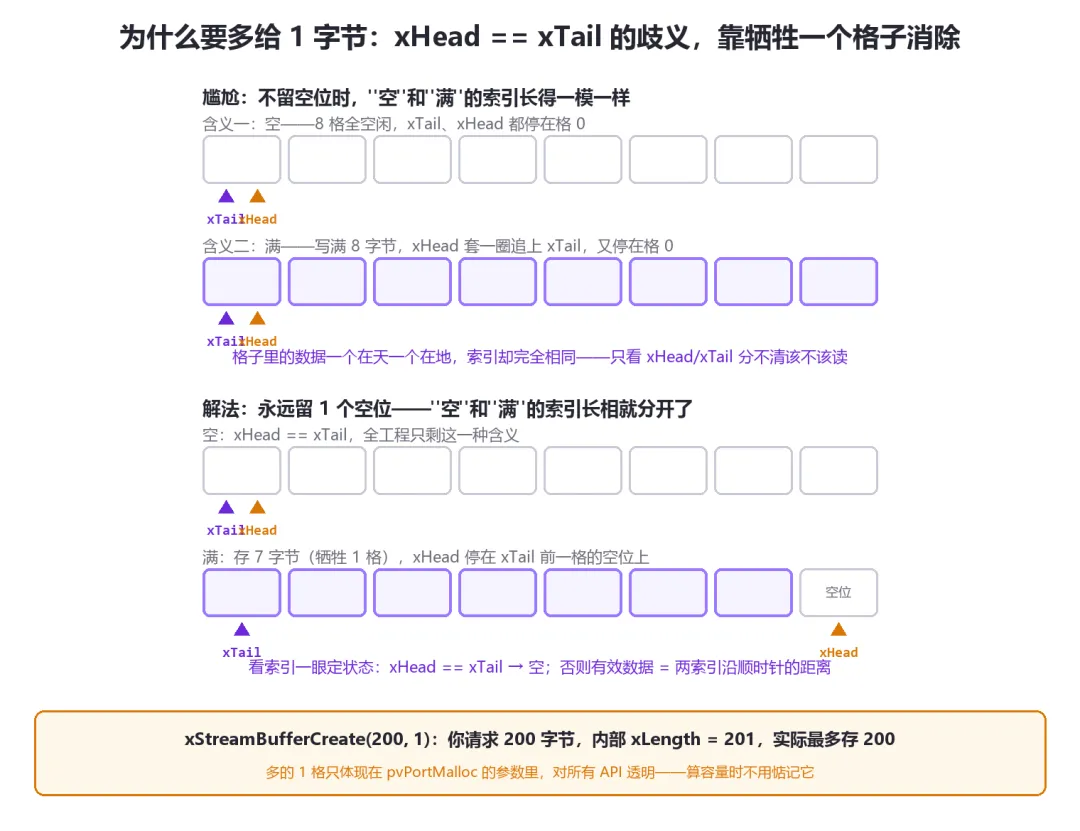
为什么要多给 1 字节?环形缓冲有个天生的尴尬:xHead == xTail 时,你分不清是"空"还是"刚写满转了一圈"。流缓冲的解法是最朴素的那个——牺牲一个格子:有效数据最多 N 字节,永远留至少 1 个空位,"写者没追上读者"和"写者套圈追上读者"就永远不会长得一样。所以你 xStreamBufferCreate(200, 1) 请求 200,内部 xLength = 201,xStreamBufferSpacesAvailable 最多报 200——对用户完全透明,只是看 pvPortMalloc 参数时别疑惑。
4.3 发送:xStreamBufferSend
完整函数一口气读完(stream_buffer.c,trace/覆盖率测试行略去)。五步主干先看图,再进代码——注释里的 ①~⑤ 对应图上位置,跟丢时抬头看图:
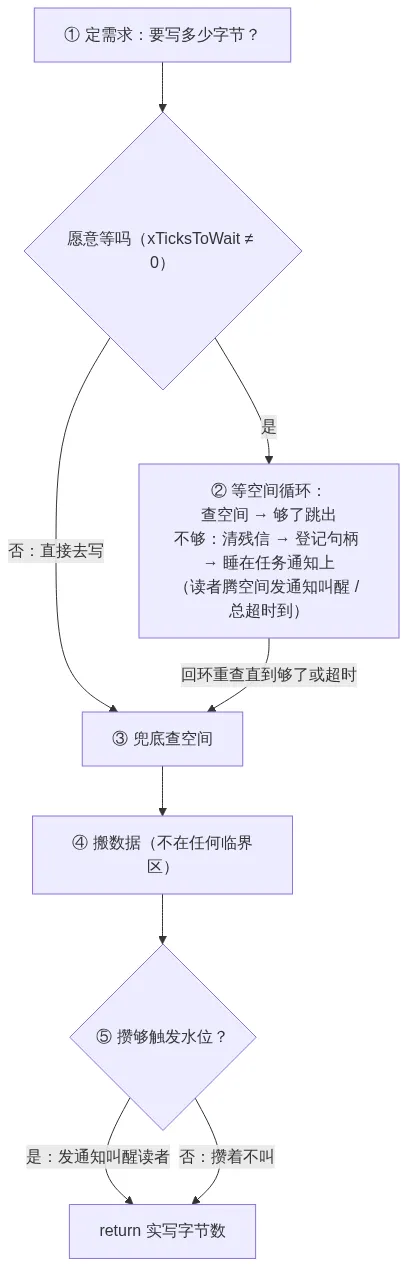
/* FreeRTOS/stream_buffer.c xStreamBufferSend (完整骨架, ①~⑤ 对应上图) */size_txStreamBufferSend( StreamBufferHandle_t xStreamBuffer,const void * pvTxData,size_t xDataLengthBytes,TickType_t xTicksToWait ){StreamBuffer_t * const pxStreamBuffer = xStreamBuffer;size_t xReturn, xSpace = 0; /* xSpace 初始 0: 没进等待循环时靠 ③ 兜底 */size_t xRequiredSpace = xDataLengthBytes; /* 需求 = 要写的字节数 */TimeOut_t xTimeOut;size_t xMaxReportedSpace = 0;xMaxReportedSpace = pxStreamBuffer->xLength - ( size_t ) 1; /* 容量上限: 4.2 的 +1 字节不计入 *//* ---------- ① 定需求 ---------- */if( ( pxStreamBuffer->ucFlags & sbFLAGS_IS_MESSAGE_BUFFER ) != ( uint8_t ) 0 ){xRequiredSpace += sbBYTES_TO_STORE_MESSAGE_LENGTH; /* 消息缓冲: 需求加上 4 字节前缀 */configASSERT( xRequiredSpace > xDataLengthBytes ); /* 需求反而变小 = size_t 加法回绕溢出 */if( xRequiredSpace > xMaxReportedSpace ){xTicksToWait = ( TickType_t ) 0; /* 整条放不下: 等也白等 */}}else{if( xRequiredSpace > xMaxReportedSpace ){xRequiredSpace = xMaxReportedSpace; /* 流缓冲: 需求截断到缓冲大小(允许部分写) */}}/* ---------- ② 等空间: 愿意等才进循环 ---------- */if( xTicksToWait != ( TickType_t ) 0 ){vTaskSetTimeOutState( &xTimeOut ); /* 记下起始时刻: 多轮睡眠共用一个总超时 */do{taskENTER_CRITICAL(); /* 关中断只罩着"查+登记"几行, 不罩睡觉 */{xSpace = xStreamBufferSpacesAvailable( pxStreamBuffer ); /* 用 xTail 现场算空余 */if( xSpace < xRequiredSpace ) /* 放不下: 清残信 → 登记 → 睡 */{/* 睡前清掉先于这次查询到达的通知(唤醒你的那个早已被 wait 消费, 不会是它):*//* 这些信号对应的空间变化已经算进上面这次查询里——*//* 查完还不足, 说明全是过期信号, 不清会被它"假醒"白烧一轮(见 4.6) */( void ) xTaskNotifyStateClearIndexed( NULL, pxStreamBuffer->uxNotificationIndex );configASSERT( pxStreamBuffer->xTaskWaitingToSend == NULL ); /* 单写者红线 */pxStreamBuffer->xTaskWaitingToSend = xTaskGetCurrentTaskHandle(); /* 登记进"等空间"槽位 */}else{taskEXIT_CRITICAL();break; /* 空间够了: 退出循环, xSpace 是刚查的新值 */}}taskEXIT_CRITICAL(); /* 登记完立刻开中断——睡觉不占临界区 *//* 睡在任务通知上(不是睡在链表上!): 读者腾空间时看到槽位里有你, 就朝这个通道发信号 */( void ) xTaskNotifyWaitIndexed( pxStreamBuffer->uxNotificationIndex,( uint32_t ) 0, ( uint32_t ) 0, NULL, xTicksToWait );pxStreamBuffer->xTaskWaitingToSend = NULL; /* 醒了先注销: 下轮重新登记 */} while( xTaskCheckForTimeOut( &xTimeOut, &xTicksToWait ) == pdFALSE ); /* 总超时没到就回环重查 */}/* ---------- ③ 兜底查空间 ---------- */if( xSpace == ( size_t ) 0 ) /* 还是 0: 没进等待循环(非阻塞), 或睡着前最后一次查到的就是 0——重查拿最终空余 */{xSpace = xStreamBufferSpacesAvailable( pxStreamBuffer );}/* ---------- ④ 搬数据(不在任何临界区!) ---------- */xReturn = prvWriteMessageToBuffer( pxStreamBuffer, pvTxData, xDataLengthBytes, xSpace, xRequiredSpace );/* ---------- ⑤ 按水位叫醒读者 ---------- */if( xReturn > ( size_t ) 0 ){if( prvBytesInBuffer( pxStreamBuffer ) >= pxStreamBuffer->xTriggerLevelBytes ){prvSEND_COMPLETED( pxStreamBuffer ); /* 4.6 节那个宏: 发通知唤醒读者 */}}return xReturn; /* 实写字节数: 流缓冲可能被截断, 消息缓冲要么整条要么 0 */}
① 藏着流缓冲和消息缓冲的语义分岔:流缓冲允许部分写入(返回值可能是你请求的字节数减一截),消息缓冲是整条语义(要么整条进去,要么返回 0)。实验一里每行日志"一条不多一条不少",第一道保证就在这。
② 和队列篇的阻塞路径对照着看:队列是"事件项挂链表+状态项挂延时链表"双挂两条链表;流缓冲是"句柄写进槽位+睡在通知上",一条链表都不碰。醒来后 xTaskCheckForTimeOut 判断超时没到就回环重查——和队列醒来重查同一个哲学,条件可能在你睡着和醒来之间已经满足。
③ 里还藏着一个容易被追问的问题:超时退出时 xSpace 是睡着前的旧值,为什么不重查也安全?因为睡着期间空间只增不减——你是唯一写者(② 里那条 configASSERT 红线的另一半好处),只有读者在腾地方,旧值只会低估、不会高估空余。后面的写入拿它判定不会越界:流缓冲按 min(需求, xSpace) 截断着写,消息缓冲按"xSpace >= xRequiredSpace 才落笔"(4.8 的 prvWriteMessageToBuffer 第一行判断就是它)。
④ 请特别注意:搬数据的prvWriteMessageToBuffer完全不在临界区里——写者只动 xHead 和数据区,没人跟它抢(见 4.1)。全函数唯一的关中断就是 ② 里"查+登记"那几行——全系列阻塞 API 里,这已经是数一数二的短临界区。
4.4 接收:xStreamBufferReceive
接收是发送的镜像(stream_buffer.c),只看两处不对称:
/* FreeRTOS/stream_buffer.c xStreamBufferReceive (节选) */if( ( pxStreamBuffer->ucFlags & sbFLAGS_IS_MESSAGE_BUFFER ) != ( uint8_t ) 0 ){xBytesToStoreMessageLength = sbBYTES_TO_STORE_MESSAGE_LENGTH; /* 消息缓冲: 门槛是 4 */}else{xBytesToStoreMessageLength = 0; /* 流缓冲: 有 1 字节就算有数据 */}
等待条件是 xBytesAvailable > xBytesToStoreMessageLength——消息缓冲最少要有"前缀 + 1 字节数据"才构成一条完整消息,等不到这个量就不算有消息,继续睡。注意这个门槛不是在防"读到半条消息":写侧用局部 xNextHead 最后一步才提交 xHead(见 4.8),读者根本看不到写了一半的消息——它就是消息的定义本身:消息缓冲读走的永远是整条,凑不齐一条就等于没东西可读。
另一个不对称:接收侧的等待没有 do-while 回环——睡一次,醒来重查一次,有数据就读,没数据(被虚假唤醒)就返回 0。超时管理由 xTaskNotifyWaitIndexed 的超时参数一次完成。为什么发送侧要回环、接收侧不用?因为发送侧的需求("要放下 X 字节")可能随读者只读走一部分而部分满足,接收侧的需求("有数据就行")一旦满足就直接满足。
4.5 存取内核:两段 memcpy 的回绕搬运
环形缓冲的搬运经典写法——任何一次读写最多拆成两段 memcpy:
/* FreeRTOS/stream_buffer.c prvWriteBytesToBuffer (节选) */staticsize_tprvWriteBytesToBuffer( StreamBuffer_t * const pxStreamBuffer,const uint8_t * pucData, size_t xCount, size_t xHead ){/* 第一段: 从 xHead 写到缓冲区末尾 */xFirstLength = configMIN( pxStreamBuffer->xLength - xHead, xCount );( void ) memcpy( ( void * ) ( &( pxStreamBuffer->pucBuffer[ xHead ] ) ),( const void * ) pucData, xFirstLength );/* 第二段: 放不下就回绕到开头写剩余的 */if( xCount > xFirstLength ){( void ) memcpy( ( void * ) pxStreamBuffer->pucBuffer,( const void * ) &( pucData[ xFirstLength ] ), xCount - xFirstLength );}xHead += xCount;if( xHead >= pxStreamBuffer->xLength ) { xHead -= pxStreamBuffer->xLength; }return xHead; /* 注意: 返回新位置, 不直接改字段(4.8 有原因) */}
数据量计算是无符号回绕减法,绕一圈也不会算错。prvBytesInBuffer 回答的问题是:现在缓冲里堆着多少没读走的有效数据——就是 xTail 沿顺时针走到 xHead 的距离。4.3 ⑤ 的水位判断(prvBytesInBuffer >= xTriggerLevelBytes)、4.4 的"够不够一条消息",用的都是它。
/* FreeRTOS/stream_buffer.c prvBytesInBuffer */xCount = pxStreamBuffer->xLength + pxStreamBuffer->xHead;xCount -= pxStreamBuffer->xTail; /* 无符号回绕安全 */if( xCount >= pxStreamBuffer->xLength ) { xCount -= pxStreamBuffer->xLength; }return xCount; /* 没套圈(xHead>xTail): 差值被多加了一圈, 减掉; 套圈(xHead<xTail): 结果本来就对, 不动 */
难处在套圈的时候:xHead − xTail 直觉上是负数,而 size_t 是无符号类型,减不出负数——直接减会下溢成天文数字。所以先加一整圈再减,保证够减。拿 xLength=9(下标 0~8,容量 8)推演两种情况:
套圈那行是关键:2−7 直觉上是 −5,无符号数算不出 −5,先加 9 变成 4,一步到位。代价是没套圈那行多加了一整圈,所以第三行 if 再减回去。先加一圈防下溢,多加了再扣回来,两种情况统一成一套算术,没有分支陷阱。
这也是 4.2 那"+1 字节"在这里的回报:写者永远追不平读者,这个减法的结果天然落在 [0, xLength) 里,不需要任何满/空状态位。
prvReadBytesFromBuffer 是同款镜像:两段 memcpy + 推进 xTail。
4.6 等待登记与唤醒:从链表退化成一个句柄
队列家族用链表登记等待者,是因为等待者数量任意。流缓冲的单读者单写者约束把这个问题砍到了最简:等读的人最多一个,等写的人最多一个——那要什么链表,两个变量就够了。
volatile TaskHandle_t xTaskWaitingToReceive; /* 等数据的任务: NULL=没人等 */volatile TaskHandle_t xTaskWaitingToSend; /* 等空间的任务: NULL=没人等 */
登记动作发生在准备睡之前(临界区里,见 4.3 的等待循环),清空动作发生在醒之后。唤醒侧拿到句柄直接发通知:
/* FreeRTOS/stream_buffer.c sbSEND_COMPLETED 宏 (缺省实现, 节选) */vTaskSuspendAll();{if( ( pxStreamBuffer )->xTaskWaitingToReceive != NULL ){( void ) xTaskNotifyIndexed( ( pxStreamBuffer )->xTaskWaitingToReceive,( pxStreamBuffer )->uxNotificationIndex,( uint32_t ) 0,eNoAction ); /* 只当信号用, 不带值 */( pxStreamBuffer )->xTaskWaitingToReceive = NULL;}}( void ) xTaskResumeAll();
看清楚这里面的熟悉零件:xTaskNotifyIndexed(..., eNoAction)——任务通知篇拆过的机制,只是把通知值当二值信号使。联系通知篇的结论"通知是改变量等",流缓冲是通知的第三种用法:值不动,只动通知状态(ucNotifyState 的"收到过通知"标记本身就是一个信号量)。
为什么这段要 vTaskSuspendAll 包着?读句柄+发通知+清句柄三步不能被切开——虽然"最多一个等待者"让竞争窗口比链表小得多,但写者和读者同时操作同一个 xTaskWaitingToReceive 槽位(一个在登记,一个在唤醒)仍可能错过。挂起调度器保证任务侧原子,中断侧用 taskENTER_CRITICAL_FROM_ISR 的 FromISR 版宏(sbSEND_COMPLETE_FROM_ISR)。
任务通知的唤醒信号还有一个坑:通知可能在你"还没睡下"的时候就到了。流缓冲用的是通知篇讲过的标准解法——睡前先清通知状态:
/* FreeRTOS/stream_buffer.c xStreamBufferSend 等待循环内 (发送侧等待) */( void ) xTaskNotifyStateClearIndexed( NULL, pxStreamBuffer->uxNotificationIndex );/* 然后才登记句柄、才去 xTaskNotifyWaitIndexed 睡 */
顺序是铁的:查空间 → 清通知状态 → 登记句柄 → 睡,清状态和登记包在同一个关中断临界区里(4.3 的等待循环 ② 看完整代码)。如果通知在你睡前就到了(清完状态之后、睡下之前),通知状态会被重新置起,xTaskNotifyWaitIndexed 一进去发现状态已置、立即返回——唤醒不丢。这和队列篇"醒来回环重查"是同一个问题的两种解法:队列靠睡醒后重查,流缓冲靠睡前清状态。
对照三大家族的唤醒,流缓冲是最短的路径:
队列: xTaskRemoveFromEventList——摘链表节点、双摘、挂就绪链表;事件组: while遍历整条等待链表逐个判定;流缓冲:查一个句柄、发一次通知、清槽位。固定三步的量级,这就是它敢号称比队列轻的物理原因——没有链表操作,唤醒成本与等待者数量无关(反正最多一个)。
4.7 触发水位:攒够了再叫
xTriggerLevelBytes 是流缓冲独有的节能设计:写入后数据量不到水位线,不叫醒读者。
/* FreeRTOS/stream_buffer.c (节选) */if( prvBytesInBuffer( pxStreamBuffer ) >= pxStreamBuffer->xTriggerLevelBytes ){prvSEND_COMPLETED( pxStreamBuffer ); /* 到水位才唤醒 */}
实验二第 1 轮(水位 20)就是这个判断的现场:写者前 4 次各写 4 字节,数据量 4/8/12/16 都够不到 20,prvSEND_COMPLETED 一次都没执行——省掉的就是那一次次任务通知+唤醒调度;第 5 次写完数据量 20,一次唤醒把 20 字节全交给消费者。水位换成 1,5 次写入就是 5 次唤醒——同样的数据量,5 倍的唤醒开销。默认水位是 1(创建时传 0 会被强制改成 1)——每写 1 字节就叫醒一次读者。字节级唤醒风暴,就是坑清单第 3 条的来源;DMA 收帧场景把水位设成帧长,攒够一整帧才醒,这是流缓冲配 DMA 的正确姿势。
最后把"读者睡、写者醒"的完整时序串起来,对照队列篇的双挂双摘看差异:
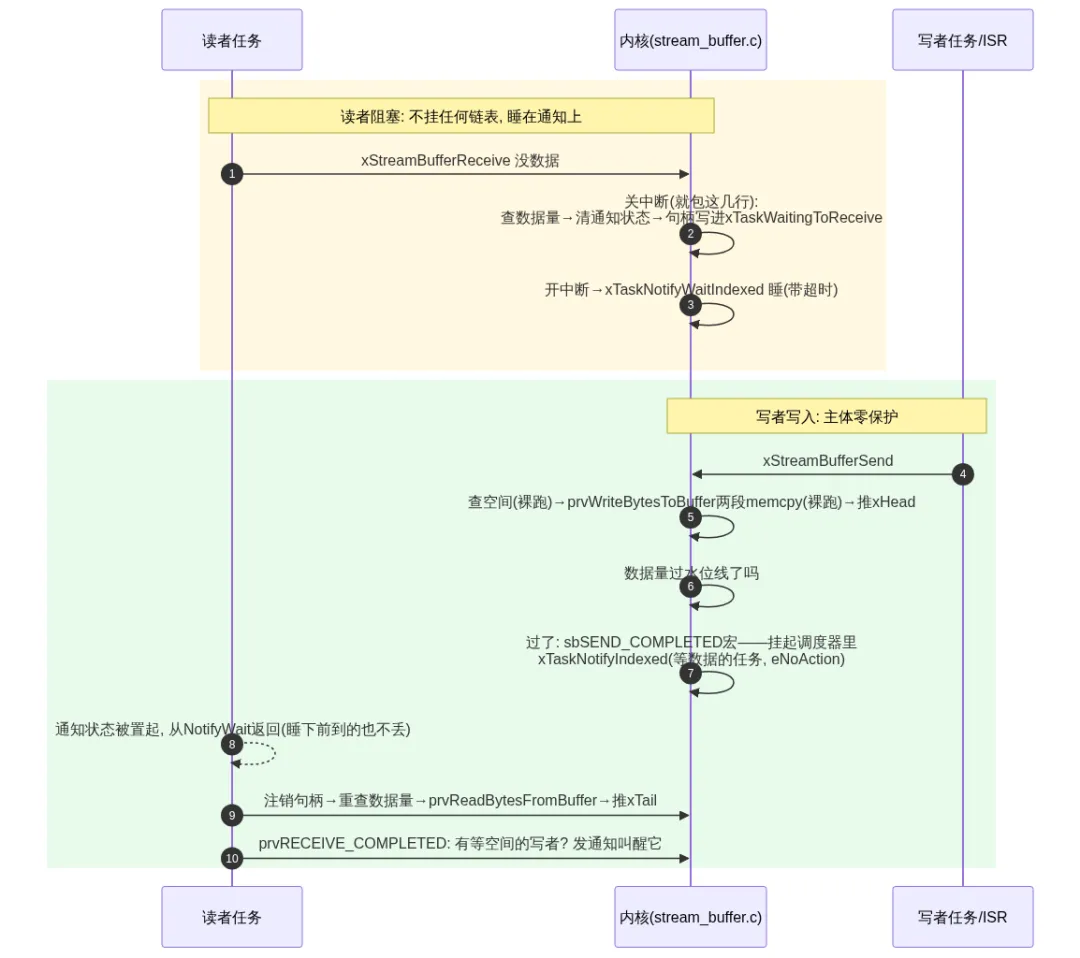
和队列篇的唤醒对比就一行字的差别:队列是摘链表节点挂就绪链表,流缓冲是对一个句柄发一次任务通知——后者连调度器的就绪链表都不直接碰(通知内部会做),这也是它"轻"的全部秘密。
4.8 消息缓冲的加帧解帧:为什么读者永远看不到半条消息
加帧在 prvWriteMessageToBuffer:
/* FreeRTOS/stream_buffer.c prvWriteMessageToBuffer (节选) */size_t xNextHead = pxStreamBuffer->xHead; /* 先存在局部变量里! */if( xSpace >= xRequiredSpace ){/* 先写 4 字节长度前缀——写进的是局部推进的 xNextHead */xNextHead = prvWriteBytesToBuffer( pxStreamBuffer, ( const uint8_t * ) &( xMessageLength ),sbBYTES_TO_STORE_MESSAGE_LENGTH, xNextHead );}if( xDataLengthBytes != ( size_t ) 0 ){/* 数据写完, 最后一步才提交: 把推进完毕的 xNextHead 写回 xHead 字段 */pxStreamBuffer->xHead = prvWriteBytesToBuffer( pxStreamBuffer, ( const uint8_t * ) pvTxData,xDataLengthBytes, xNextHead );}
精妙在 xNextHead 这个局部变量:前缀和数据都写完,才把最终位置一次性提交给xHead(这就是 4.5 里"返回新位置、不直接改字段"的原因)。读者判断"有没有消息"靠 xHead - xTail——提交之前,读者视角缓冲区里什么都没多,即使写一半时读者恰好来查。消息的"原子可见性"不靠锁,靠最后一步提交。实验一里三行日志"一条不多一条不少"的第二道保证就在这。解帧在 prvReadMessageFromBuffer:先读 4 字节前缀拿到长度,按长度读数据,推进 xTail——和加帧对称。
4.9 FromISR 路径:不睡觉,只搬货+发通知
xStreamBufferSendFromISR 没有等待循环——ISR 里不许睡:
/* FreeRTOS/stream_buffer.c xStreamBufferSendFromISR (节选) */xSpace = xStreamBufferSpacesAvailable( pxStreamBuffer ); /* 查空间 */xReturn = prvWriteMessageToBuffer( ... ); /* 放得下多少写多少 */if( xReturn > ( size_t ) 0 ){if( prvBytesInBuffer( pxStreamBuffer ) >= pxStreamBuffer->xTriggerLevelBytes ){prvSEND_COMPLETE_FROM_ISR( pxStreamBuffer, pxHigherPriorityTaskWoken );/* 内部: taskENTER_CRITICAL_FROM_ISR 里 xTaskNotifyIndexedFromISR —— 中断篇的老规则 */}}
三件事值得点破:
ISR 版没有关中断的主体——查空间、搬数据裸跑(写者只动 xHead,_ISR 版当然也是写者),关中断只裹唤醒宏那几行,而且用的是 taskENTER_CRITICAL_FROM_ISR(中断篇讲过的 BASEPRI 保存恢复版);空间不够直接部分写入/返回 0,不在 ISR 里等——空间等读者腾出来,ISR 只管把能放的放下; 唤醒走 xTaskNotifyIndexedFromISR+pxHigherPriorityTaskWoken,规则和队列篇的 FromISR 完全一致:返回 pdTRUE 你就portYIELD_FROM_ISR。
和中断篇的红线对照:流缓冲的约束一条没破——ISR 只调 FromISR 版本、优先级 ≥5 才许调、切换交给尾延迟。它只是把"队列的 FromISR 版"做得更薄了。
五、踩坑清单
- 多写者/多读者直接数据损坏
:单读单写是硬约束, configASSERT只能抓等待登记的重叠,两个任务同时写不会触发任何断言,数据静默交错。多个生产者?老实用队列; - 消息缓冲空间不够时返回 0 且不等待
:整条消息放不下( 数据+4 > 总容量),xTicksToWait直接被清零——你以为它会阻塞等空间,其实它立即失败。整条语义:消息缓冲不做部分写入; - 默认触发水位 1 是唤醒风暴
:字节流场景每写 1 字节叫醒读者一次,读者醒来发现就 1 字节、处理完继续睡——CPU 全花在睡醒之间。按业务粒度设水位(帧长、行长),实验二就是对照现场; - 接收缓冲区小于消息长度 → 消息卡死在流里
: prvReadMessageFromBuffer读出前缀发现你给的缓冲区装不下整条,返回 0 且不推进 xTail——消息永远留在缓冲区,下次读还是它,每次都返回 0、空转拿不到。防法:第三节实验一那样先xStreamBufferNextMessageLengthBytes探长度; xStreamBufferReset有等待者时返回 pdFAIL:有人阻塞在上面就不许清空——清了的话等待者的等待就悬空了。返回值必须检查; - 消息缓冲的真实容量要减前缀
: xMessageBufferCreate(100)一条消息最大也就 100-4=96 字节(4.2 的 +1 空位内核自己申请,不用你扣),规划容量时每条消息按"数据+4"记账; - ISR 里只能用 FromISR 版
:中断篇的红线原封不动适用于流缓冲——非 FromISR 版在 ISR 里调用同样触发 VECTACTIVE 断言,优先级 ≥5 才许调。
六、总结
把流缓冲放回系列的坐标系里:
- 结构上,它是"环形字节数组+两个索引+两个句柄槽位"——全家族唯一没有等待链表的阻塞组件;- 保护上,它把临界区压缩到登记等待的几行——写者只推 xHead、读者只推 xTail 的设计让主体路径零保护;- 唤醒上,它就是任务通知的"信号用法"(eNoAction,值不动状态动)——通知篇的直改直醒在这里找到了正式编制;- 变长能力上,消息缓冲用 4 字节前缀+最后一步提交 xHead,在字节流上切出原子可见的消息——锁都没用就做到了。
系列选型口诀至此完整:队列传定长数据、信号量管计数、队列集选成员、事件组算逻辑、通知一对一最快、流缓冲装变长流。下一个自然的问题留给收官:这些组件创建时 pvPortMalloc 的那块内存,heap_4 到底怎么管的——那是系列最后一块拼图。
— 写在最后 —
如果这篇文章对你有帮助,欢迎点赞、在看、转发三连支持,这是我持续更新的最大动力。
有问题欢迎在评论区指出,我都会认真看。
点个关注不迷路,更多硬核技术剖析持续更新中,下期再见。