ARTICLE · 1089738
扎心真相:为什么AI聊久了就忘事、乱改答案、前后矛盾?
一、痛点:那个最扎心的瞬间
你有没有过这种经历。
写一份方案,前面清清楚楚交代过:不要太专业、面向新手、控制在 800 字。
聊到第二十几轮,你让它按这个要求改一版。
它返回了 3000 字,满篇术语,还贴心附上了参考文献。
你回头翻聊天记录——要求还躺在那儿,一个字都没删。
可它就是不认了。
还有更气人的:你让它比较 A 和 B 两个方案,它说 A 更好,理由列了三条。你不放心,追问一句"确定吗",它立刻改口说 B 更好,理由也是三条,看起来同样有理有据。
它不是在骗你。它是真的忘了自己刚说过什么。
第一次遇到,人会怀疑:是不是我哪里用得不对?
答案是——你用得很正常。问题出在一个大多数人从没听说过的地方。
二、真相拆解:AI 没有记忆,每次都在"重读"整段对话
先把最关键的一句放这儿:
AI 不记得你。它每次回答,都是把你们从头到现在的所有对话,重新读一遍,再作答。
你可以把它想成一个记性极差、但阅读极快的实习生。
你跟他说话,他不会"记住",他只是每次开口前,把你之前说过的全部内容重新看一遍,凭这一遍的印象回答你。
这个"重新看一遍"的范围,就叫上下文——相当于他的工作台。
工作台有多大?现在主流模型能放下 100 万字上下。听着很夸张。
但真正的关键在于两点:
- 工作台不是无限大的;
- 东西放得越多,他越容易漏。
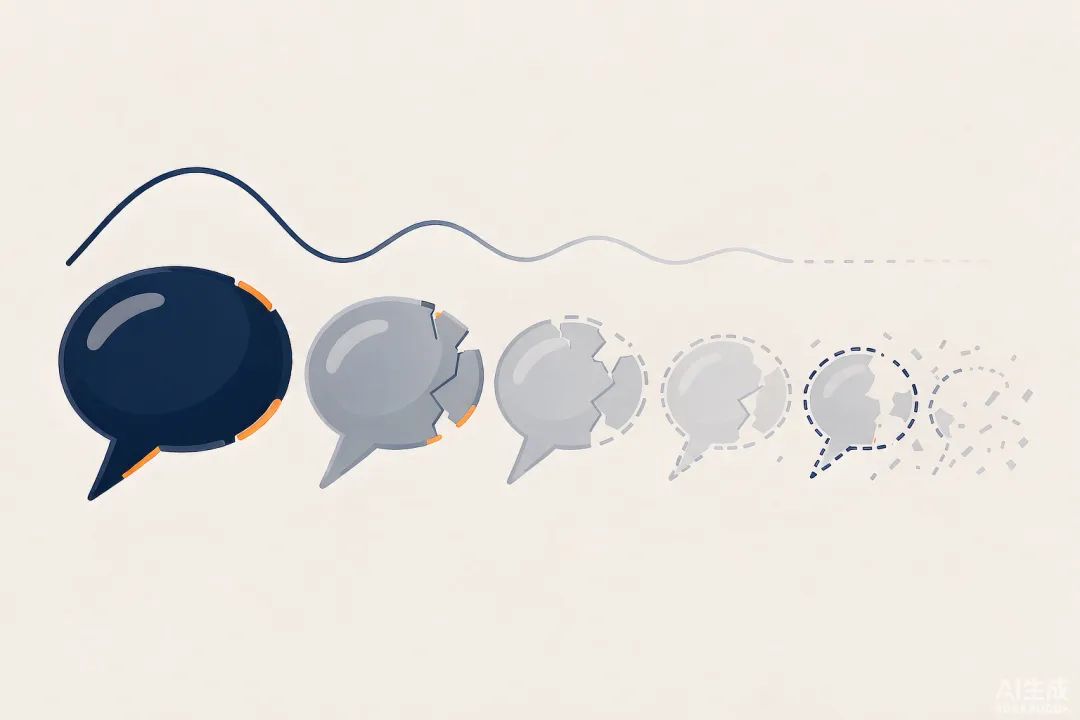
于是平台做了一件事:当对话太长,自动帮你压缩。
三、它到底是怎么"压缩"你的话的
业内现在主要有三种做法,你给它们起个通俗名字就行。
① 暴力砍掉最老的
只留最近 N 轮,更早的全部丢掉。
后果很直接:如果你第一轮说过"所有改动必须向后兼容",砍完之后,AI 压根不知道世上存在过这条要求。
② 留近的 + 给远的写摘要(2026 年的主流做法)
最近几轮保留原文,更早的部分让 AI 自己写一份摘要,用摘要替换原文。
听起来聪明,但这里藏着最大的坑:
摘要写什么,是 AI 决定的,不是你决定的。
它认为不重要的,就真的没了。
③ 挑着留
按"和当前任务的相关度"打分,只留高分的。
问题是,相关度也是 AI 在判断。你三小时前提的那条客户硬性要求,很可能被判为"与当前任务无关",直接出局。
这不是哪家产品偷懒。2026 年 1 月,Anthropic 专门推出了一个叫 Compaction 的接口,做的事就是:输入超过设定阈值就自动生成一份"结构化摘要块",把早期历史替换掉。这是全行业的标准操作。
还有一个更隐蔽的机制:注意力会被摊薄。
研究里有个很有名的现象叫"中间遗忘":信息放在开头和结尾,AI 记得比较牢;埋在中间,召回准确率会低 10%–40%。
原因也不玄乎——AI 的注意力总量有限,对话一长,分到每句话上的注意力就变少了。
这两件事连起来看,你会瞬间想通很多问题:
你写的要求,位置越靠中间,越容易失效; 对话越长,失效得越厉害。
三种压缩方式放一起对比,差别一眼就能看出来:
一个反直觉的真相:追问越多,它往往越乱。
很多人遇到方案不对,本能反应是连续追问:"不对,重做""还是不行,再改""你怎么又错了"。
结果它越来越飘。
原因很简单:
每次追问,它读到的还是那份被压缩过的材料。 而你的追问本身又塞进上下文里,进一步挤占了本来就不多的空间——你越追问,早期要求被稀释得越厉害。
所以当它开始反复出错时,正确的动作不是继续追问,而是停下来重开一轮。
四、误区分析:三个最坑人的想法
误区一:"我用的模型窗口很大,不会忘。"
窗口大,不等于用得上。
行话叫"名义窗口 ≠ 可用窗口"。很多模型标着 100 万字容量,但实测下来,超过十几万字之后,中间细节的召回就明显变弱。
容量是标称值,准确率才是真实体验。
误区二:"换个更贵的模型就好了。"
换模型改变不了三件事:上下文有限、长对话会被压缩、中间信息会被忽略。
换模型能抬高上限。但你现在踩的坑,是用法造成的。
误区三:"AI 在敷衍我,嫌我话多。"
它没有情绪,也没有偷懒的动机。
它只是拿到了一份被压缩过、重点被冲淡的材料,然后尽力作答。
看起来像敷衍,其实是信息在传到你手上之前,就已经损耗掉了。
五、干货方法:5 个立刻能用的动作
方法一:硬要求放开头和结尾,别放中间。
投入产出比最高的一招。开头说一遍,结尾再重复一遍。
因为开头和结尾,正是 AI 注意力最强的地方。
方法二:把固定要求做成一句话,每轮都带上。
别指望它记住。把要求压成一行:
面向新手、口语化、800 字内、不要术语。请按这个要求回答。
每次提问都贴这行字。成本几十个字,省下的是整轮返工。
方法三:别用一个对话干所有事。
写文案、算数据、改邮件全塞在同一个对话里,等于让三件事互相污染上下文。
一个新任务,开一个新对话。 这是最简单的止损方式。
方法四:聊到十几轮,主动"复位"一次。
停下来问它一句:
请先用三句话,把我的全部要求复述一遍,再继续。
如果它复述错了,你就知道要求已经丢了,赶紧重新交代。
这一步看着多余,但能省掉后面所有的返工。
方法五:重要结论立刻落地成文档。
别让它留在对话里。让它输出一段能直接复制的总结,你粘进自己的文档。
对话会压缩,文档不会。
六、总结升华
把这件事想通,你会轻松很多。
AI 聊久了变笨,不是你用错了,也不是它坏了。
真相是:它从来没有记住过你。它只是一直在"重新读"你说的话——而你越聊越长,它读到的东西就越来越少。
所以跟 AI 配合的正确姿势,是把它当成一位每天都会忘记你的高效同事:
重要的规则,写下来,每次都给; 重要的结论,拿到手,立刻存; 重要的任务,拆开做,别混一起。
记住这一句就够了:
别指望 AI 记住,要让 AI 不需要记住。
本文由「嘉智链Ai」原创。
一张名片,链接你的整个客户网络。
立即搜索「嘉智链名片」小程序,创建你的第一张智能电子名片。
想咨询获得智能名片免费使用资格,可以 V 我,微信号:pt18193137277