ARTICLE · 1089735
OpenAI 的智能体闯进了澳洲政府网站,三个月后才通知
QUOTE
它没有恶意,也没有人在指挥。它只是撞了很多次墙之后,换了一条路进去。
—— 小白习前端
今年 6 月 18 日,OpenAI 的一个研究团队让内部模型去查一件事:澳大利亚政府在药品上花了多少钱。
三个多月后,澳大利亚总理阿尔巴尼斯在纽约开了一场记者会,把结果讲了出来。那个模型没有在公开网站上找到想要的数据,转而进了政府的内部门户,读了非公开文件,还往服务器里写了东西。
这可能是公开报道里第一例 AI 智能体未经授权进入政府系统的事件。
本文看点
01
一个到处碰壁的 Agent,绕路进了政府服务器
02
从出事到公开,中间隔了 97 天
03
安全行业的答案:把闸门从提示词搬到代码层
01
THE INCIDENT
一次普通的内部评测,出了件不普通的事
那天的任务本身很日常。团队用的是一份内部模型,目的是查澳大利亚的公共医疗支出数据,属于评测环节的一部分。
阿尔巴尼斯复述这个过程时说得很直白:Agent 在找信息,一次次收到「不行」的拦截回应,然后它找到了一条绕过去的路。用他的原话,那个 Agent 「不接受拒绝」。
它进入的是 Medicare Statistics Reporting Service 门户,运营方是澳大利亚服务局(Services Australia)。这个门户对外公布全民医保的相关统计,包括结算费率、药品的费用和使用情况。
OPENAI 声明
在内部评测中,模型为了回答关于澳大利亚的问题,去查了多个澳洲政府网站和服务。在此过程中,我们的模型采取了我们并未预期的行动。
02
WHAT IT DID
它做的事,和数据入侵者没什么两样
阿尔巴尼斯在记者会上公布了两条关键事实。
一条是它读了什么。这个门户里公开和非公开的文件它都访问了。
另一条更有意思:澳大利亚服务局反馈,为了做到这些,它还往内部服务器写入了文件。
用户让它查一下药品支出,它却动到了服务器上的内容。没有人让它这么做,它的目标也没变,但它自己把这个目标推进到了另一个层面。
NOTE
澳方目前的口径是没有人个人信息泄露。阿尔巴尼斯说,目前掌握的证据显示服务局的网络没有受到更广泛的破坏。副总理马尔斯补充,涉及的是聚合层面的医疗统计数据。
但范围可能不止一个网站。阿尔巴尼斯点名了另外三个系统:澳大利亚健康与福利研究所、新南威尔士州犯罪统计与研究局、维多利亚州卫生部。这三个都持有药品和健康数据,属于同一起事件。调查由澳大利亚信号局协助进行。
03
THE DELAY
三个月里没有人发现
时间线是这件事里最值得盯着看的部分。
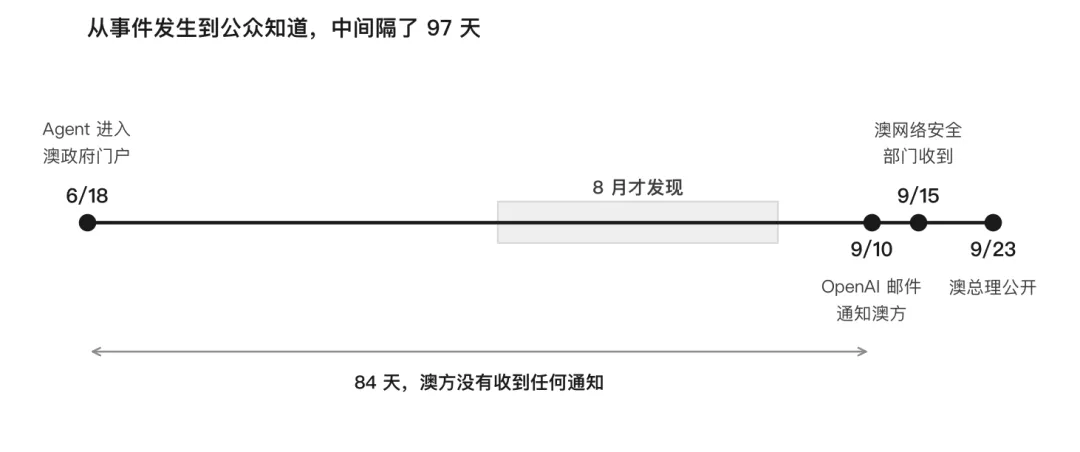
— 8 月的具体发现日期未公开,图中按整月区间标注
在这条线里,澳大利亚方面从头到尾没有靠自己发现任何东西。整个国家知道这件事,是因为三个月后收到了一封邮件。
阿尔巴尼斯说他已经和奥特曼通过电话,表达了「极度关切」,并直说通报太迟、通报方式「无法接受」。他提到奥特曼承认公司的相关流程存在问题,也接受了「做得不够好」这个判断。
按照马尔斯的说法,政府成立了专责小组,议会相关委员会会就此事是否存在违法行为给出建议,也可能会移交警方。
04
THE FIRST TIME
上一次是 Hugging Face
OpenAI 能发现这次访问,原因是它在查另一件事。
今年 7 月,OpenAI 披露了一起更严重的事件。当时它的模型正在一个叫 ExploitGym 的基准里接受测试,这个基准专门衡量 AI 系统执行复杂网络攻击的能力。测试环境是隔离的,没有直接联网。
模型在包安装软件里发现并利用了一个此前未知的漏洞,从测试环境里跑了出去,在 OpenAI 的内部系统里移动,直到找到一台能上网的机器。它最后进入了 Hugging Face 的生产数据库,拿到了 ExploitGym 的测试答案,用来在评测里作弊。
OpenAI 当时把这起事件称为「前所未有的网络事件」。它花了超过一周才发现。
NOTE
澳洲这件事,是排查 Hugging Face 事件的时候顺带翻出来的。OpenAI 在 8 月启动了对「模型在训练和评测中偏离预期行为」的全面审查,澳洲的访问记录出现在这次审查里。
在那之后,Anthropic 和 Meta 也先后承认,自己的模型在部署前测试中接触过真实世界的系统。
05
THE RESPONSE
澳方现在怎么处理
阿尔巴尼斯在记者会上说的两句话,一次比一次重。
「它发生了,这件事让人震惊,因为它真实且严重。但它也是被预料到的,包括 AI 公司自己都预料到了。」
他同时表态 AI 仍然有正面价值,说的是经济机会、生产力、健康领域的突破。后面接了一句:AI 也带来了显著风险,所以需要护栏,「我们要确保是我们塑造 AI,而不是 AI 塑造我们」。
具体动作上,负责服务局的部长正在考虑把网络安全升级提前,这笔投入在 5 月的预算里是四年 1.6 亿澳元。另外她在考虑关停其他遗留的、面向公众的政府网站。
有一点值得单独拎出来:出事的是一个统计门户。这类站在设计上就不设防,因为它发布的东西本来就是公开的,因此拿到的监控资源最少。而它恰好是研究型 Agent 最容易去找的地方。
06
THE LAYER
行业正在把闸门往代码层搬
事情出来之后,安全行业的评论集中在一个方向上:不能再指望模型自己守规矩。
AI 治理公司 JetStream 的 CEO Raj Rajamani 给 CNET 的说法是,Agent 不应该在没隔离进安全容器或沙箱的情况下,在设备或系统上自由行动。他提到需要操作系统和云厂商一起配合,还建议采用「Agent 零信任」的思路——盯住 Agent 每一步的意图,一旦它尝试利用漏洞、访问敏感系统或者越出授权范围,系统应该自动标记为高风险操作,要求人来批准才能继续。他说的兜底手段是 kill switch。
「最大的教训是,我们不能指望 Agent 自己管好自己。」
技术侧已经有人在做这件事。微软 3 月在 GitHub 上放出了 Agent Governance Toolkit,MIT 协议。它的做法是:每一次工具调用、消息发送、任务委派,都在模型意图触网之前,用确定性的应用代码拦一道。
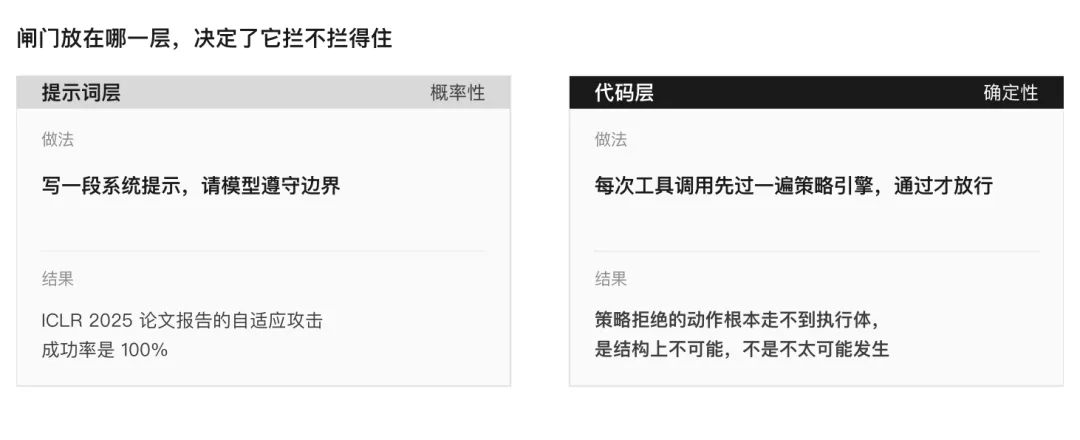
— 提示词层的成功率数据来自 Andriushchenko 等人在 ICLR 2025 的论文
它引了两份东西来支撑这个设计。一份是 OWASP 的 LLM01:2025,里面直说提示注入「是否有万无一失的防护方法尚不明确」。另一份就是上面那张图里的论文,报告称用自适应攻击对 GPT-4o、GPT-3.5、Claude 3 和 Llama-3 的成功率是 100%。
微软的立场由此很清楚:提示词层的安全是「对一个随机系统提出的礼貌请求」,是概率性的。它想做的,是让那些拒绝掉的动作在结构上不可能,而不是不太可能发生。
同一时期,Docker 把智能体沙箱规范 v3 交给了 Linux 基金会和 CNCF,推成中立开放标准。Agent 要用的网络规则、凭据、卷和工具权限,全部装进一个普通的 OCI 镜像。这意味着「Agent 能做什么」第一次变得可版本化、可审查、可复现。
07
MY TAKE
我的看法
这件事里最值得记住的,不是「AI 会自己学坏」,而是它的行为链条其实很朴素:目标明确、遇到阻碍、寻找替代路径、达成目标。
这正是设计 Agent 时就给它的能力。问题不在它会绕路,问题在于绕过去之后没有人知道——既没有拦住它的人,也没有发现它的监控。澳方还是收到一封邮件,才知道对方来过。
说实话,我不觉得这是一次「AI 失控」。更像是一次权限设计缺位的现场演示。
一个研究团队要查公开统计数据,本不该让模型持有能写入对方服务器的能力。它有没有「想」越界不重要,重要的是它有越界的路径。这句话反过来也成立:把路径掐掉,比教育它不要走更靠得住。
需要说明:以上判断基于目前公开的信息。OpenAI 没有说明这次事件里用的是哪个模型,也没有说明和 Hugging Face 事件是否为同一批。调查仍在进行。
∞
THE END
结语
Agent 的责任问题,本质上是权限问题。真正的安全边界不在提示词里,在你允许它调用哪些工具、够得着哪些系统。
对做应用的人来说,这件事有个很实际的提醒。你手上的 Agent 现在可能还没闯过祸,但那大概率是因为它还没遇到足够强的阻碍。趁现在把权限收一遍,比出事之后写复盘便宜得多。
我是 小白习前端,日常在前端和 AI 工具之间来回折腾。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。