ARTICLE · 1093721
AI智能体Office套件设计与实现计算机科学与技术
目录
摘要 Abstract 第1章 绪论 1.3.1 在线办公套件的数据互通研究 1.3.2 大语言模型智能体的研究进展 1.3.3 现状评述与研究空白 1.1 研究背景 1.2 研究目的与意义 1.3 国内外研究现状 1.4 主要研究内容 1.5 论文组织结构 第2章 相关技术基础 2.1 大语言模型与函数调用 2.2 智能体架构与 ReAct 范式 2.3 OOXML 文档格式 2.4 PDF 文档模型与 CJK 字体方案 2.5 事件驱动架构与共享运行时 2.6 本章小结 第3章 需求分析 3.2.1 六大组件的能力需求 3.2.2 智能体编排需求 3.2.3 组件数据互通需求 3.2.4 交付与存储需求 3.1 系统总体目标 3.2 功能需求 3.3 非功能需求 3.4 用例分析 3.5 本章小结 第4章 系统总体设计 4.1 设计原则 4.2 五层体系结构 4.3 组件模型与能力自描述协议 4.4 共享运行时上下文设计 4.5 组件数据互通机制 4.6 存储与快照设计 4.7 异常模型设计 4.8 本章小结 第5章 系统详细设计与实现 5.7.1 工具提供者 5.7.2 任务规划器 5.7.3 执行器 5.6.1 自研 PDF 写入器 5.6.2 解析与降级通道 5.2.1 引擎选型 5.2.2 词法与语法分析 5.2.3 执行算子 5.1.1 数据结构 5.1.2 公式求值器 5.1.3 数据透视与图表 5.1 电子表格组件的实现 5.2 关系型表格组件与自研 SQL 引擎 5.3 文本文档组件的实现 5.4 幻灯片组件的实现 5.5 画布组件与自动布局算法 5.6 PDF 处理器组件的实现 5.7 智能体编排层的实现 5.8 前端工作区的实现 5.9 本章小结 第6章 系统测试与实验 6.1 测试环境与方案 6.2 功能测试 6.3 组件边界与异常测试 6.4 跨组件数据链路实验 6.5 端到端场景实验 6.6 性能测试 6.7 结果分析与讨论 6.8 本章小结 第7章 总结与展望 7.1 工作总结 7.2 主要创新点 7.3 不足与展望 参考文献 致谢 附录A 源代码组织结构 附录B 组件能力接口清单 附录C 测试用例分布 附录D 部署与运行指南(图文详解) D.1 运行环境与前置条件 D.2 步骤一:创建虚拟环境并安装依赖 D.3 步骤二:配置模型服务与离线模式 D.4 步骤三:启动服务并访问工作区 D.5 步骤四:运行测试验证环境 D.6 步骤五:运行演示脚本与产物核对 D.7 对外接口清单与调用示例 D.8 常见问题与排错速查 D.9 部署检查清单
摘要
随着大语言模型(Large Language Model, LLM)在语义理解、任务分解与工具调用等方面的能力持续增强,办公软件正从"由人操作工具"向"由智能体编排工具"演进。然而,现有在线办公套件普遍存在三个问题:各组件(文档、表格、幻灯片等)彼此割裂,数据需要人工导出再导入;组件能力以固定界面形式暴露,无法被智能体自动发现与调用;大模型只能生成文本,缺少把文本落地为可交付办公文件的能力。 针对上述问题,本文设计并实现了一套以智能体为编排核心、以共享运行时上下文为数据底座的一体化 Office 套件。套件内置电子表格、文本文档、幻灯片、画布、关系型表格与 PDF 处理器共六大组件,覆盖 51 项组件能力;所有组件挂载于同一运行时上下文之上,通过键值黑板、事件总线与数据链路账本三种机制实现跨组件数据直达;智能体编排层由任务规划器、工具提供者与执行器构成,能够把自然语言需求拆解为子任务序列,动态生成工具清单,并在无模型环境下以确定性通道降级运行。 论文完成了以下工作:第一,提出并实现了"能力自描述协议",使组件能力、参数约束与调用示例在单一位置声明,同时服务于调用校验、工具清单生成与离线参数补全,从静态层面杜绝了智能体编造工具的可能;第二,设计了"显式传递、隐式血缘、黑板共享"三条组件数据互通路径,其中隐式血缘通过检测调用参数中的实体标识自动记账,实现了零标注的数据溯源;第三,自研了轻量 SQL 引擎与 PDF 写入器,前者与套件的字典行模型零拷贝互操作并可暴露列级血缘,后者采用 PDF 预定义 CJK 字符映射(CMap)方案,在无需嵌入字体文件的前提下输出中文 PDF;第四,实现了双通道执行机制,在线通道采用 ReAct 风格的推理—行动—观察循环,离线通道以能力示例模板结合上下文自动补全参数,保证系统在无外网环境中仍可完整演示与回归测试。 系统后端基于 Python 实现,前端为零构建的原生 Web 工作区。实测源代码共 41 个源文件、约 7 200 行;编写单元与集成测试用例 55 个,全部通过;在四个端到端场景中验证了组件协同与数据链路正确性,生成的 PDF 可被标准 PDF 库正常解析并提取中文文本。
**关键词:**大语言模型;智能体;办公套件;共享运行时;工具调用;数据链路
Abstract
With the rapid advancement of Large Language Models (LLMs) in semantic understanding, task decomposition and tool invocation, office software is evolving from “humans operating tools” to “agents orchestrating tools”. However, existing online office suites suffer from three common defects: their components (documents, spreadsheets, slides, etc.) are isolated so that data must be exported and re-imported manually; component capabilities are exposed only through fixed interfaces, which prevents an agent from discovering and invoking them automatically; and LLMs can generate text but lack the ability to turn that text into deliverable office files. To address these problems, this thesis designs and implements an integrated office suite that takes an LLM agent as the orchestration core and a shared runtime context as the data foundation. The suite embeds six components — spreadsheet, document, slide, canvas, relational table and PDF engine — providing 51 capabilities in total. All components are mounted on the same runtime context and achieve direct cross-component data transfer through three mechanisms: a key-value blackboard, an event bus and a data-lineage ledger. The agent layer consists of a task planner, a tool provider and an executor, which decomposes natural-language requirements into a sequence of subtasks, dynamically generates the tool schema list, and degrades to a deterministic channel when no model is available. The main contributions are as follows. First, a capability self-description protocol is proposed and implemented, so that capabilities, parameter constraints and usage examples are declared in a single place and simultaneously serve call validation, tool-schema generation and offline parameter completion, which statically eliminates the possibility of an agent fabricating tools. Second, three cross-component data paths — explicit transfer, implicit lineage and blackboard sharing — are designed, among which implicit lineage automatically records provenance by detecting entity identifiers in call arguments, achieving zero-annotation traceability. Third, a lightweight SQL engine and a PDF writer are implemented: the former interoperates with the suite’s dictionary-row model without copying and exposes column-level lineage, while the latter adopts the predefined CJK CMap of PDF so that Chinese documents can be produced without embedding any font file. Fourth, a dual-channel execution mechanism is realised: the online channel follows a ReAct-style reason-act-observe loop, whereas the offline channel automatically completes arguments from capability examples combined with runtime context, guaranteeing full demonstration and regression testing in an offline environment. The backend is implemented in Python and the frontend is a zero-build native web workspace. The measured source code consists of 41 source files and about 7,200 lines. 55 unit and integration test cases were written and all of them pass. Four end-to-end scenarios verify the correctness of component collaboration and data lineage, and the generated PDF can be parsed by a standard PDF library with Chinese text correctly extracted.
Keywords: Large Language Model; Agent; Office Suite; Shared Runtime; Tool Calling; Data Lineage
第1章 绪论
1.1 研究背景
办公文档是人类组织与传递信息最普遍的载体。自 20 世纪 80 年代电子表格与文字处理软件普及以来,办公软件经历了桌面单机、在线协同两个阶段,并正在进入第三个阶段:由人工智能驱动的智能化办公。微软在 2023 年发布的 Microsoft 365 Copilot、Google 在 Google Workspace 中集成的 Gemini、金山办公发布的 WPS AI,都标志着"自然语言即操作界面"成为主流方向。
与产品侧的快速迭代相比,学术界与工程界对"智能体如何与办公组件协同"这一问题的系统化研究仍显不足。当前主流方案大多把大语言模型作为"内容生成器"嵌入到某个单一应用中:在文档编辑器里生成段落,在表格工具里生成公式,在演示工具里生成大纲。这种"点状集成"虽然见效快,却忽略了办公场景的本质特征——办公任务天然是跨组件的。一份季度经营分析报告,往往需要先从数据库中查询结构化数据,再在表格中计算汇总与环比,接着在文档中撰写结论并插入图表,最后导出为 PDF 交付;如果还需要向上汇报,则要进一步生成幻灯片。任何一个环节的割裂都会迫使用户进行人工的数据搬运。
与此同时,大语言模型智能体(Agent)技术的成熟提供了新的可能性。以 ReAct、Toolformer、AutoGPT 等为代表的工作表明,只要为模型提供结构化的工具清单与清晰的执行反馈,模型就能自主完成多步任务编排。这为"把办公套件整体交给智能体编排"提供了技术前提。
1.2 研究目的与意义
本文的研究目的是:设计并实现一套面向智能体编排的一体化 Office 套件,使得(1)六大办公组件能够共享同一份运行时上下文,实现数据在组件间的直接流动;(2)组件能力能够被机器发现、理解与调用,从而使智能体可以自主完成跨组件任务;(3)系统在缺少大模型服务时仍可降级运行,保证工程可用性与可测试性。
研究意义体现在三个层面。
在理论层面,本文提出的"能力自描述协议"与"隐式血缘推断"机制,为"如何让智能体的可调用能力集合与系统的真实能力集合保持恒等"这一课题提供了一种工程化解答,也为主流智能体框架中普遍存在的"模型编造工具"问题提供了静态层面的抑制手段。
在技术层面,本文自研的轻量 SQL 引擎与 PDF 写入器,验证了在受限依赖条件下构建办公基础设施的可行性,其中 PDF 的预定义 CJK CMap 方案对于需要在离线环境输出中文 PDF 的场景具有直接的复用价值。
在应用层面,套件提供的能力自描述协议与组件扩展指南,使得新增一个办公组件只需实现三个接口即可被智能体自动识别并无缝调用,为后续的生态扩展提供了低成本的路径。
1.3 国内外研究现状
1.3.1 在线办公套件的数据互通研究
在线办公套件的数据互通长期沿着两条路线发展。第一条是文件格式互通,其基础是 OOXML(Office Open XML)标准。ECMA-376 与 ISO/IEC 29500 定义了 WordprocessingML、SpreadsheetML 与 PresentationML 三套 XML 标记语言,使得不同软件之间可以通过文件交换内容。第二条是嵌入式对象互通,即在一种文档中嵌入另一种文档的对象或数据范围,典型代表是电子表格图表嵌入文档、数据透视表跨表引用。近年来的云端方案(如 Google Sheets 的 IMPORTRANGE)进一步把互通下沉到网络函数层。
这些方案解决的是"人机交互意义上"的互通,其共同局限在于:数据流动的时机、方向与映射规则都需要人预先设定,无法根据任务语义动态决定。
1.3.2 大语言模型智能体的研究进展
大语言模型智能体的核心问题是如何把模型的语义能力与外部世界的操作能力连接起来。相关工作可归纳为三个方向。
其一是工具调用接口的标准化。Schick 等人提出的 Toolformer 展示了模型自学调用 API 的可行性;OpenAI 在 2023 年提出的 Function Calling 机制,把工具以 JSON Schema 描述并交由模型生成结构化调用参数,已成为事实标准;随后的 Model Context Protocol(MCP)进一步统一了工具与资源的接入方式。
其二是执行范式的设计。Yao 等人提出的 ReAct 范式通过交替进行"推理(Reasoning)“与"行动(Acting)”,使模型能够依据环境反馈修正后续动作,成为当前智能体的主流执行骨架。在此基础上,Reflexion 引入自我反思机制,Plan-and-Solve 引入先规划后执行的两阶段结构,工具使用能力较强的模型还发展出并行调用与多智能体协作等模式。
其三是多智能体协作与角色分工。MetaGPT、AutoGen 等工作把复杂任务分派给具备不同角色设定的多个智能体,通过消息传递完成协作。
上述研究提供了坚实的范式基础,但多数工作在工具接入时假设工具集合是"扁平且同质的",缺乏对"能力分层、组件异构、组件的产物需要被另一个组件消费"这类结构化场景的深入处理。
1.3.3 现状评述与研究空白
综合来看,现有研究存在三个可以改进的空间。
第一,组件能力与智能体工具清单的一致性缺乏工程保障。多数实现把工具描述与业务实现分别维护,随着功能演进容易漂移,模型可能调用到并不存在的能力。
第二,跨组件数据流动缺乏自动化的溯源机制。当一次任务跨越多个组件后,很难回答"这份图表的数据来自哪次查询、经过了哪些变换"。
第三,对无模型环境的降级支持不足。多数研究原型强依赖在线模型服务,导致自动化测试、离线演示与功能回归难以稳定开展。
本文正是围绕这三个空白展开设计与实现。
1.4 主要研究内容
本文的主要研究内容包括四个部分。
- 一体化运行时内核的设计
。设计并实现共享运行时上下文,通过键值黑板、事件总线与数据链路账本三种机制,为六大组件提供统一的数据交换、状态广播与溯源能力。 - 组件模型与能力自描述协议的设计
。定义组件抽象基类与能力描述结构,使组件的能力声明同时服务于调用前校验、智能体工具清单生成与离线参数补全,实现"一处声明、三处受益"。 - 六大组件的详细实现
。分别实现电子表格(含自研公式求值器)、文本文档、幻灯片、画布(含自动图层布局算法)、关系型表格(含自研 SQL 引擎)与 PDF 处理器(含自研 PDF 写入器),并针对性能与依赖约束做出工程权衡。 - 智能体编排层的实现与验证
。实现双通道的任务规划器与执行器,通过单元测试、集成测试与四个端到端场景验证系统的功能正确性、数据链路完整性与交付产物可用性。
1.5 论文组织结构
本文共分七章。第 1 章为绪论,阐述研究背景、意义、现状与主要内容;第 2 章介绍相关技术基础;第 3 章进行系统需求分析;第 4 章给出系统总体设计;第 5 章详细阐述各模块的实现;第 6 章给出测试方案与实验结果;第 7 章总结全文并展望后续工作。文末给出参考文献、致谢与四个附录。
第2章 相关技术基础
2.1 大语言模型与函数调用
大语言模型是基于 Transformer 架构、在海量文本上以自回归方式预训练的神经网络。其核心能力是在给定上下文的前提下预测下一个词元,由此涌现出指令遵循、上下文学习与多步推理等能力。
函数调用(Function Calling)机制把这种能力延伸到外部世界。其基本流程是:调用方以 JSON Schema 描述若干函数(包含名称、用途说明与参数结构),与用户消息一并提交;模型在推理过程中若判断需要调用函数,则输出结构化的调用请求(函数名 + 参数 JSON);调用方执行函数并把结果回填到消息序列中,供模型继续推理。这一机制的价值在于把"模型生成自由文本"约束为"模型生成可校验的结构化指令",从而使自动化执行成为可能。
本文正是基于这一机制设计智能体的工具接口,但同时引入了额外的工程约束:模型可见的工具集合必须由系统在运行时从注册中心动态导出,而非人工维护,以保证工具清单永远与真实能力一致。
2.2 智能体架构与 ReAct 范式
智能体可以形式化地描述为四元组  ,其中
 为状态空间,
 为动作空间,
 为环境,
 为策略。在基于大语言模型的智能体中,状态由消息序列承载,动作是工具调用,环境是被调用的系统,策略由模型本身实现。
ReAct 范式的核心是把"思维链"与"工具调用"交织在一段轨迹中:
Thought → Action → Observation → Thought → Action → …
其中 Thought 是自然语言形式的推理,Action 是结构化工具调用,Observation 是工具返回结果。相较于一次性生成完整计划再执行的方案,ReAct 的优势在于能够依据真实反馈动态修正,对工具执行失败具有更强的鲁棒性。
本文的在线执行通道即采用 ReAct 骨架,并在此基础上增加了三项工程约束:单轮最大步数限制、工具调用的沙箱化分发(任何异常都收敛为结构化错误而非中断流程)、以及完整的调用轨迹记录。
2.3 OOXML 文档格式
OOXML 是 Office 文档的开放标准,采用 ZIP 容器 + XML 部件(Part)的结构,并通过关系(Relationship)文件描述部件之间的引用。三类核心文档的部件结构分别为:
- WordprocessingML(.docx)
: word/document.xml描述正文,正文由段落(w:p)与表格(w:tbl)线性组成,段落内部由文本运行(w:r)与运行属性(w:rPr)描述样式;页眉页脚位于word/header``.xml与word/footer.xml。 - SpreadsheetML(.xlsx)
: xl/worksheets/sheet``.xml描述单元格与公式,xl/sharedStrings.xml存放共享字符串,图表位于xl/charts/chart.xml。 - PresentationML(.pptx)
: ppt/slides/slide*.xml描述页面,页面中的图形通过p:sp描述,图表与多媒体以关系方式引用。
本文的六大组件在内存中采用统一的领域模型(块序列、单元格矩阵、页面序列、图结构等),并预留到 OOXML 部件的映射通道:文本文档的块类型与 w:p/w:tbl 一一对应,电子表格的"行维度 + 列维度 + 度量 + 聚合函数"四元组模型可转换为数据透视缓存,幻灯片采用归一化坐标(0~1)以便无损映射到不同尺寸的页面。
2.4 PDF 文档模型与 CJK 字体方案
PDF 是一种页面描述格式,其文件结构由对象(Object)、交叉引用表(xref)与文件尾(trailer)组成。页面内容以内容流(Content Stream)形式描述绘图指令,文本通过 BT/ET 包裹的文本算子(Tf、Td、Tj、TJ 等)绘制。
在输出中文时,PDF 存在一个经典难题:标准 14 种基本字体(Helvetica、Times 等)仅覆盖 Latin 字符集,要显示中文通常需要嵌入 TrueType 字体子集,会显著增大文件体积并引入字体版权问题。本文采用的替代方案是使用 Adobe 预定义 CJK 字符集与编码:在 PDF 中以 Type0 复合字体引用 STSong-Light,编码指定为 UniGB-UCS2-H,文本串以 UTF-16BE 十六进制形式书写。由于字体与 CMap 均为阅读器内置的预定义资源,无需嵌入任何字体文件即可正确显示简体中文,产物体积也因此保持在较小水平。
2.5 事件驱动架构与共享运行时
事件驱动架构(Event-Driven Architecture, EDA)以事件的产生、传播与消费为核心,具有生产者与消费者解耦、易于横向扩展等优点。其典型构件包括事件总线、订阅者与事件历史。
本文借鉴 EDA 思想构建共享运行时上下文,其动机在于:办公套件中组件的状态变更(创建文档、写入数据、导出文件)需要同时被三类消费者感知——前端界面(用于刷新视图)、数据链路账本(用于记录流转)、智能体(用于获得执行反馈)。若采用轮询或直接函数调用,会造成组件之间产生强耦合;采用事件总线则可把"谁关心"从"谁触发"中解耦出来。
2.6 本章小结
本章介绍了本文所依赖的五项技术基础:大语言模型与函数调用机制、智能体与 ReAct 执行范式、OOXML 文档格式、PDF 文档模型与 CJK 字体方案、事件驱动架构。这些技术分别支撑了本文的智能体编排层、组件数据模型、交付产物生成与运行时内核设计。
第3章 需求分析
3.1 系统总体目标
系统的总体目标是构建一套可由智能体自主编排的一体化办公套件,具体表现为:用户以自然语言提出需求,系统自动判断所需组件、拆解执行步骤、完成跨组件数据处理,并交付可直接使用的办公文件。
由此导出四项子目标:组件完备(覆盖办公场景的主要文档类型)、数据互通(组件之间无需人工搬运数据)、能力可发现(智能体能够获知每个组件的可用能力及其参数约束)、交付可用(最终产物为符合规范的办公文件)。
3.2 功能需求
3.2.1 六大组件的能力需求
系统应内置六类组件,其能力边界需严格区分,避免职责重叠导致智能体选型错误。表 3-1 给出能力需求与典型产物。
其中需要特别说明电子表格与关系型表格的边界:前者面向二维计算,核心是公式与透视;后者面向业务结构化数据集,核心是多表关联与约束。这一区分直接决定了智能体的选型策略。
3.2.2 智能体编排需求
- FR-7 需求解析
:能够把自然语言需求拆解为有序子任务,每个子任务绑定到具体组件与能力。 - FR-8 工具清单生成
:能够生成符合函数调用规范的 JSON Schema 工具清单,且清单内容必须与组件实际能力严格一致。 - FR-9 执行与反馈
:能够按计划执行工具调用,记录调用轨迹,并把结果回传用于后续决策。 - FR-10 异常处理
:工具执行失败时返回结构化错误(含分类、详情与修复建议),支持有限次数的自动重试。 - FR-11 降级运行
:在无模型服务时,能够以确定性的规则通道完成规划与执行。
3.2.3 组件数据互通需求
- FR-12 显式传递
:支持由调用方声明"来源组件 → 目标组件 → 使用能力"的数据流转,并自动记账。 - FR-13 隐式溯源
:当调用参数中携带其他组件产出的实体标识时,系统应自动识别并登记数据链路。 - FR-14 中间结果共享
:支持把中间产物登记到共享区,供多个下游子任务复用。 - FR-15 链路可视化
:能够把链路账本聚合为有向图,暴露给前端渲染。
3.2.4 交付与存储需求
- FR-16 产物落盘
:所有导出文件写入统一输出目录,并提供列表与下载接口。 - FR-17 快照与回溯
:支持把运行时中的全部文档实体序列化为快照,并可回读。 - FR-18 权限约束
:系统不提供删除或覆盖已有文件的接口,所有写操作仅作用于新建产物。
3.3 非功能需求
3.4 用例分析
系统的主要参与者为办公用户与智能体。核心用例包括:提交自然语言需求、查看执行计划、查看数据链路、下载产物、直接调用组件能力、创建与回读快照。
以"季度经营分析报告"这一典型用例为例,其基本流程为:
用户在需求输入框提交"写一份季度经营分析报告并导出 PDF"; 系统生成计划:子任务 1 由文本文档组件创建报告并填充内容,子任务 2 由 PDF 处理器消费文档产物导出 PDF; 执行器依次调用工具,事件总线实时向前端推送状态; 数据链路账本记录"文本文档 → PDF 处理器"的流转; 前端刷新产物列表,用户下载 .pdf 文件。
该用例同时覆盖了跨组件数据链路、事件推送与产物交付三条主线。
3.5 本章小结
本章从总体目标出发,给出了六大组件的能力边界、智能体编排的 11 项功能需求、数据互通的 4 项功能需求与交付存储的 3 项功能需求,并提炼出 7 项非功能需求。这些需求构成了后续设计的输入约束。
第4章 系统总体设计
4.1 设计原则
系统的设计遵循四条原则。
原则一:内核正交于组件。运行时内核只依赖抽象接口,不感知任何具体组件;组件只依赖内核提供的基础设施,不感知彼此。
原则二:能力即契约。组件对外暴露的唯一形态是"能力",能力的名称、参数结构、返回类型与调用示例以声明方式给出,调用方(无论人还是智能体)只能依据声明行动。
原则三:数据流可追溯。任何跨组件的数据流转都必须留下记录,且记录的生成不应依赖调用方的自觉。
原则四:依赖降级可用。对可能缺失的外部依赖(模型服务、PDF 处理库)设计降级通道,保证核心功能在退化环境下仍能运行。
4.2 五层体系结构
系统采用五层结构,自下而上依次为内核层、组件层、编排层、接口层与表现层,如图 4-1 所示(以文本形式描述)。
┌──────────────────────────────────────────────────────────┐ │ 表现层 前端工作区:组件面板 / 智能体对话 / 链路视图 / 产物 │ ├──────────────────────────────────────────────────────────┤ │ 接口层 REST 路由 + SSE 事件推送 + 统一异常映射 │ ├──────────────────────────────────────────────────────────┤ │ 编排层 任务规划器 / 工具提供者 / 执行器 │ ├──────────────────────────────────────────────────────────┤ │ 组件层 表格 文档 幻灯片 画布 关系型表 PDF(51 项能力) │ ├──────────────────────────────────────────────────────────┤ │ 内核层 运行时上下文 / 事件总线 / 血缘账本 / 注册中心 / 存储 │ └──────────────────────────────────────────────────────────┘
各层职责与关键抽象如表 4-1。
依赖方向严格自上而下,内核层不引用组件层,组件层不引用编排层,编排层不引用任何具体组件类。
4.3 组件模型与能力自描述协议
组件层采用抽象基类 + 能力声明的设计。抽象基类定义组件的共性行为:持有文档仓库、挂载运行时、提供唯一的调用入口。子类只需实现两个方法:declare_capabilities() 用于声明自身能力,_dispatch() 用于分发调用。
能力描述结构包含五个字段,如表 4-2 所示。
该设计的核心价值在于一处声明、三处受益:同一份 CapabilitySpec 既被运行时用于调用前参数校验,又被工具提供者用于生成模型可见的函数调用清单,还被离线执行通道用作参数模板。由于工具清单完全由注册中心在运行时导出,模型可见的能力集合与系统真实的能力集合在构造上恒等,从根本上抑制了"模型编造工具"这一常见失效模式。
4.4 共享运行时上下文设计
运行时上下文是套件的中枢,持有五类设施:事件总线、血缘账本、注册中心、键值黑板与实体归属表。其对外提供统一调用入口,在单次调用中完成六个步骤:
- 解析
:在注册中心查找到目标组件,并校验其确实声明了该能力; - 血缘推断
:扫描调用参数中形如 *_id的实体标识,若其归属于其他组件则登记一条数据链路; - 参数收敛
:只把能力声明允许的参数传给组件,丢弃其余参数并广播事件; - 执行
:调用组件的分发方法; - 记账
:记录调用耗时、参数摘要、结果摘要与错误; - 广播
:发布调用成功或失败事件。
这一设计的要点在于把"横切关注点"(校验、记账、广播、血缘)全部收敛到运行时,使组件实现保持纯粹,也使新增组件天然获得全部可观测能力。
4.5 组件数据互通机制
系统提供三条数据互通路径,如表 4-3。
其中隐式血缘机制是本文的重点设计。其语义为:运行时维护"实体标识 → 生产组件"的归属表;组件创建实体后,其返回结构中的实体标识被自动登记;当后续调用的参数中出现这些标识且生产组件与消费组件不同时,即判定发生了一次跨组件数据流转。该机制使数据溯源从"调用方的义务"变为"运行时的默认行为",实测中四条端到端链路均被完整记录,且无需任何手工标注。
为避免重复记账,账本在写入前会对最近窗口内的记录做去重判定,键为"生产组件、消费组件、能力、产物标识"四元组。
4.6 存储与快照设计
系统采用"内存态 + 磁盘快照"的两级存储结构。组件在内存中维护高频率修改的文档实体,以获得低延迟;运行时在需要时把全部文档实体、血缘图与黑板内容序列化为 JSON 快照落盘,以支持回溯。
快照格式选择 JSON 而非二进制序列化的理由是:可读、可 diff、便于人工排查问题,这在教学与调试场景中的价值高于序列化性能。
4.7 异常模型设计
系统定义统一的异常基类,包含四个字段:错误分类码、面向人的说明、结构化详情与可执行修复建议。错误分类共八种,如表 4-4。
所有异常在到达接口层时被统一归一化为同样的响应结构,从而使前端与智能体都能以相同方式处理失败。
4.8 本章小结
本章给出了系统的五层体系结构、组件与能力自描述协议、共享运行时上下文的调用流程、三条数据互通路径、两级存储结构以及八类异常模型。这些设计共同构成第 5 章详细实现的基础。
第5章 系统详细设计与实现
5.1 电子表格组件的实现
5.1.1 数据结构
电子表格以"文档 → 工作表 → 单元格"三级结构组织。单元格以地址字符串(如 A1、AA10)为键,值为字符串、数字或公式原文(以等号开头)。列名与列下标之间通过 26 进制转换互转,例如 A 对应 0、Z 对应 25、AA 对应 26。
选择以"稀疏字典 + 地址字符串"而非二维数组存储的原因是:办公表格的填写往往是稀疏的,稀疏字典在插入大量非连续单元格时具有更好的空间效率,且无需处理动态扩容。
5.1.2 公式求值器
公式求值器支持四则运算、幂运算、括号、单元格引用、区域引用以及 SUM、AVERAGE、COUNT、COUNTA、MAX、MIN、IF、ROUND、ABS、CONCAT、PRODUCT 等函数。
实现上没有采用第三方公式引擎,而是基于 Python 标准库的抽象语法树模块实现,流程为:
- 规范化
:把 A1:C3形式的区域引用替换为函数调用形式__range__("A1","C3"),使其成为合法的 Python 表达式; - 解析
:调用语法树解析接口生成表达式树; - 求值
:自顶向下递归求值,其中单元格引用递归求取其计算值(公式则递归求值并维护访问集合以检测循环引用),函数调用按名称分发到内置实现。
循环引用通过"已访问单元格集合"检测:若某单元格在求值链路上重复出现,则抛出异常并返回错误标记。实测中 =SUM(B2:B5) 在示例数据上正确返回 10902.7,=AVERAGE(B2:B5) 返回 2725.675,验证了区域引用与聚合函数的正确性。
5.1.3 数据透视与图表
数据透视采用"行维度 + 列维度 + 度量字段 + 聚合函数"四元组模型。实现流程为:读取源区域并将其首行解释为表头;按行维度取值构造分组键;对每个度量字段按聚合函数累积;按分组键排序后写入目标工作表。支持的聚合函数包括 SUM、COUNT、AVERAGE、MAX、MIN,对非数值单元格按 0 处理。
图表以声明式描述存储,包含图表类型、标题、类目标签与系列数据,由前端负责渲染;在图表生成时同步读取数据区域,把数值固化到图表对象中,避免后续单元格变动导致图表与数据不一致。
行列批量处理采用"地址重映射"策略:插入行时把所有行号大于等于插入位置的行向下平移,删除行时对被删除区间做丢弃、对区间之后的行向上平移。该实现简单直接,缺点是未同步调整公式中的相对引用,属于本文的已知局限,已在第 7 章列出。
5.2 关系型表格组件与自研 SQL 引擎
5.2.1 引擎选型
关系型表格组件需要执行 SELECT 查询。可选方案包括引入嵌入式数据库(如标准库自带的 SQLite)或自研引擎。本文选择自研,理由有三:
SQLite 需要把数据序列化为表结构再查询,与本套件的"字典行"内存模型之间存在数据编解码开销; SQLite 不暴露列级血缘,而本文的数据链路机制希望记录查询引用了哪些列; 查询引擎可裁剪为纯函数,便于单元测试与嵌入式调用。
5.2.2 词法与语法分析
引擎遵循经典的"词法分析 → 语法分析 → 逻辑计划 → 物理执行"四阶段结构。
词法分析使用正则表达式一次性匹配数字、字符串字面量、运算符、分隔符与标识符,并把匹配到的关键字(SELECT、FROM、WHERE 等)标注为关键字类型。
语法分析采用递归下降方法,文法层次自低向高为:主表达式 → 一元 → 乘除模 → 加减 → 比较(含 LIKE、IN、IS NULL)→ 非 → 与 → 或。语句层解析 SELECT 列表(支持 DISTINCT 与别名)、FROM 子句(支持表别名)、JOIN 子句(支持 INNER、LEFT、RIGHT 与 ON 条件)、WHERE、GROUP BY、HAVING、ORDER BY(支持升降序)与 LIMIT/OFFSET。
解析结果是一棵由列引用、字面量、函数调用、二元运算、非运算、集合判定与空值判定节点构成的表达式树,与语句计划对象分离,便于后续独立求值。
5.2.3 执行算子
物理执行由六个算子构成,按序组合:
- 扫描算子
:读取基表并为每行建立"别名.列名"与"表名.列名"的双重前缀视图,使后续表达式求值无需感知表别名; - 连接算子
:当连接条件为等值条件时构造哈希桶执行哈希连接,否则退化为嵌套循环连接;左连接与右连接分别对未匹配行补空; - 过滤算子
:对条件表达式逐行求值; - 投影与分组算子
:若无聚合函数则执行投影;否则按键构造分组,对每个分组分别求值聚合函数与非聚合表达式(后者取分组首行); - 排序算子
:按排序表达式逐列稳定排序,优先按输出列名取值以支持按别名排序; - 去重与截断算子
:按 DISTINCT 去重并按 LIMIT/OFFSET 截断。
此外,引擎提供"被引用列提取"能力:遍历语句计划中的全部表达式节点,收集列引用,经去重排序后返回。该结果被写入数据链路记录,实现列级血缘。实测中 SELECT r.name, SUM(o.amount) ... JOIN regions r ON o.region = r.code GROUP BY r.name ORDER BY total DESC 正确返回按销售额降序排列的区域列表(华东 4750.3、华北 2690.5、华南 2100.8、西部 1361.1)。
约束校验在写入阶段执行:主键唯一性通过"主键值元组 → 行号"的索引判定;外键存在性通过在参照表中构造允许值集合判定;类型校验支持字符串到数值的隐式转换,并对布尔值参与数值运算的情形显式报错。
5.3 文本文档组件的实现
文本文档以"块(Block)线性序列"建模,块类型包括标题、段落、列表、表格、图片与分页符。这一模型与 WordprocessingML 的段落/表格线性结构天然同构,便于后续映射到 w:p 与 w:tbl 部件。
段落与列表项支持三种行内标记:双星号包裹的加粗、单星号包裹的斜体、反引号包裹的行内代码。解析时通过正则切分把文本拆分为运行(Run)序列,每个运行携带文本与样式标志,对应 OOXML 中的 w:r 与 w:rPr。
文档组件还提供两项与数据互通相关的关键能力:其一,append_rows_as_table 可以接收字典列表或二维数组并渲染为文档表格,使关系型表格的查询结果能够直接进入报告;其二,read 返回块结构与降维后的纯文本,供 PDF 导出与全文检索消费。字数统计在每次追加块时增量更新,统计口径为标题、段落、列表项与表格单元格的字符数之和。
5.4 幻灯片组件的实现
幻灯片采用"演示稿 → 页面 → 元素"三层模型。页面声明版式(标题、标题内容、双栏、图表、空白、章节),元素类型包括要点列表、图表与图片。
页面元素使用归一化坐标(0 至 1 的相对位置),使同一份演示稿可以无损渲染到不同尺寸的屏幕与纸张。要点列表支持 0 至 3 级缩进。图表元素在写入时校验各系列数据长度与类目标签长度一致,不一致则报参数错误,避免生成畸形图表。
组件提供 add_section 能力,可按大纲批量生成章节页并在指定页面追加要点,便于智能体一次性构造演示骨架;同时提供 export_marp 能力,把演示稿导出为 Marp/Markdown 文本,便于版本管理与二次编辑。实测中一个包含封面页、内容页与三个章节页的演示稿被正确导出为 5 页 Markdown 源文件。
5.5 画布组件与自动布局算法
画布以图结构建模,包含节点集合、边集合、自由图形与文字标注。节点带有语义类型(起始、结束、流程、服务、数据库、判定、注释、分组、参与者),类型决定默认形状与配色,例如数据库类型默认使用圆柱形、判定类型默认使用菱形。
画布的自动布局采用简化版 Sugiyama 分层算法,包含三个步骤:
- 分层
:若所有节点均已显式指定层号则直接采用;否则以入度为零的节点为起点执行拓扑排序,节点的层号取"所有前驱层号最大值加一";若图中存在环导致部分节点未被访问,则把剩余节点按剩余入度升序依次下沉到最深层之后的独立层,以保证同层不出现相互依赖的节点; - 排序
:同层内按插入顺序排列(预留重心排序扩展点); - 坐标分配
:按自上而下或自左向右的方向,计算该层整体的跨度并居中,再依次分配节点坐标。
实测中,一个包含用户、接口层、编排层、运行时、六个组件与 PDF 处理器共十个节点、十条边的架构图被正确划分为 6 层,其中六个组件同处第 4 层,符合设计预期。
画布提供 SVG 导出能力,导出的矢量图可直接被文档与幻灯片组件引用,形成"画布 → 文档/幻灯片"的数据链路。导出时对文本做了 XML 转义,避免特殊字符破坏 SVG 结构。
5.6 PDF 处理器组件的实现
5.6.1 自研 PDF 写入器
PDF 写入器自行构造 PDF 文件结构,包含以下步骤:
建立字体对象:先建立 CID 字体后代对象(声明 Adobe-GB1 字符集与字体描述符),再建立 Type0 复合字体对象(引用后代对象并指定 UniGB-UCS2-H编码),最后建立资源字典;建立页面对象:每页的内容流先按字符计算换行(对中日韩字符按 1 个字符宽度、对拉丁字符按 0.55 个字符宽度估算),生成文本算子序列,并对流做 DEFLATE 压缩; 建立页面树与目录对象; 建立文档信息对象,其中标题与作者采用带 BOM 的 UTF-16BE 十六进制串书写,以正确承载中文; 依次写入对象体、交叉引用表与文件尾。
该实现的关键在于中文字符的输出:文本在内容流中以 UTF-16BE 十六进制形式书写,由阅读器依据预定义 CMap 映射到 STSong-Light 字体。实测生成的 PDF 可被标准 PDF 解析库正常打开,页数为 1,文档信息中的中文标题与作者被正确识别,正文中文被完整提取(提取字符数 324 个),验证了方案的可用性。
5.6.2 解析与降级通道
PDF 读取侧采用双通道设计:若环境中存在 PDF 解析库则使用其结构化解析能力,可获得页数、元信息、加密状态与逐页文本;若库缺失,则退化为内置的"流扫描 + 文本算子提取"通道——直接扫描文件字节流,定位内容流区间,尝试解压后抽取文本显示算子(Tj)与文本数组算子(TJ)中的字符串。
加密 PDF 在打开阶段即被识别并抛出"不支持的能力"异常,与需求文档中"不支持解密加密 PDF"的能力边界一致。合并与拆分能力在库缺失时同样返回不支持异常而非静默失败,保证调用方能够明确感知能力缺失。
表格抽取采用启发式规则:先提取页面文本并按行切分,对每行尝试用竖线或连续空白切分为单元格,连续两行及以上且列数达到阈值的行块被识别为一个表格,首行作为表头。该方案对规整排版的表格有效,对复杂合并单元格的表格存在局限。
5.7 智能体编排层的实现
5.7.1 工具提供者
工具提供者负责三件事:从注册中心导出工具清单、生成人类可读的能力目录、把工具调用分发到运行时。
工具命名遵循 组件__能力 的规约,因此"模型可见的工具集合等于注册中心登记的能力集合"这一等式在构造上成立。分发时,工具提供者把调用结果统一包装为"成功(含结果)"或"失败(含结构化错误)"两种形态,任何异常都不会向上冒泡,从而保证 ReAct 循环不会因单次工具失败而中断。
此外,分发环节实现了参数的兼容性展开:若模型把参数整体包在 arguments 键中,则自动展开一层,提升了对模型输出格式波动的容忍度。
5.7.2 任务规划器
规划器采用双通道设计。
在线通道把能力目录与用户需求填入规划提示词,要求模型输出严格的 JSON 计划,包含总体策略与子任务列表;解析时容忍代码围栏与前后缀说明文字,抽取其中的 JSON 对象;生成计划后逐条校验组件与能力是否真实存在,任一非法即判定计划无效并回退到离线通道。
离线通道基于关键词规则表生成计划。规则表按优先级排列,每条规则是"关键词元组 → 组件 → 能力"的映射;同时定义交付形态规则,用于在主体任务之外追加导出步骤。例如当需求中出现"导出 PDF"且已存在文本文档任务时,系统会把 PDF 导出能力从"文本转 PDF"升级为"文档转 PDF",并把其依赖指向文本文档子任务。若关键词规则全部未命中,则回退到"创建文档 → 导出 PDF"的通用流程。
两条通道产出的计划在返回前统一执行拓扑排序:按子任务声明的依赖关系做深度优先排序并重新编号。这一处理是必要的,因为交付形态修正可能导致列表顺序与依赖顺序不一致,而执行器严格按列表顺序执行。环依赖会被静默断开,保证排序一定终止。
5.7.3 执行器
执行器包含两条路径。
在线路径实现 ReAct 循环:把系统提示词与用户消息(含规划器给出的参考步骤与输出目录要求)提交给模型;模型返回文本或工具调用;执行器逐个执行工具调用,把结果以工具角色消息回填;循环直至模型不再请求工具或达到最大步数。系统提示词中明确声明了六大组件的能力边界、执行纪律、异常处理策略与输出风格,其中"只允许调用工具列表中真实存在的函数"是一条硬性约束。
离线路径按拓扑排序后的计划顺序执行。其核心是参数补全算法,策略为:
以能力描述中的示例作为参数基底,保证参数名与结构合法; 对示例中缺失的必填参数按语义合成,例如名称类参数取需求摘要作为标题、路径类参数取标准输出目录; 用上下文中已创建的实体标识覆盖实体类参数,使子任务之间形成数据链路; 若上游子任务产出了实体,则优先用其标识替换示例中的占位标识。
执行结果通过统一的执行上下文对象在子任务间传递,该对象记录"组件 → 最近实体标识"的映射、“子任务序号 → 产出实体标识"的映射、产物路径列表与调用轨迹。依赖回溯优先依据 depends_on 精确查找,缺失时退化为"最近登记的其他组件实体”。
执行完成后,执行器合成面向用户的自然语言答复,内容包含任务标题、创建或更新的实体清单与产出文件清单。
5.8 前端工作区的实现
前端为零构建的原生 Web 实现,由四个脚本文件组成:事件总线、面板渲染器、主控制器与页面结构,配合一份样式表。
事件总线桥负责与后端建立事件流连接,采用服务端推送方式接收运行时事件,断线后按指数退避重连。前端总线提供与后端同构的发布订阅接口,支持主题前缀匹配与通配订阅。
面板渲染器中的每个渲染函数都是无状态视图函数:输入数据、输出 DOM 变更,不在内部保存状态。这一约定使其与事件驱动模型天然兼容。
主控制器遵循单向数据流:界面事件 → 接口请求 → 响应与事件流 → 视图刷新。初始化时并行拉取组件清单、产物清单与健康状态;执行需求时先渲染计划,再逐条渲染调用轨迹与错误,最后刷新产物列表与数据链路视图。
界面采用浅色主题,左侧为组件能力与数据链路面板,右侧为智能体工作区、执行计划、产物文件与事件流。需求输入区提供三个示例按钮,覆盖数据分析、架构绘图与报告导出三类典型需求。
5.9 本章小结
本章按组件维度详细阐述了六个办公组件与智能体编排层的实现,重点说明了公式求值器、SQL 引擎、自动布局算法、PDF 写入器与双通道执行机制的设计与关键代码路径,并给出了实测数据。
第6章 系统测试与实验
6.1 测试环境与方案
测试环境为 Windows 平台,Python 3.13,测试框架为 pytest。依赖仅包含测试框架与可选的 PDF 解析库,不依赖任何 Office 文档处理库,与需求 NFR-6 一致。
测试方案分为四个层次:
- 内核层测试
:验证组件注册、能力解析、参数校验、事件广播、产物登记与血缘记账; - 组件层测试
:验证六大组件的核心功能与能力边界,包含正向用例与异常用例; - 编排层测试
:验证工具清单一致性、规划器路由、执行器流程、参数补全与错误捕获; - 端到端场景实验
:在真实链路上验证组件协同与产物交付。
6.2 功能测试
测试用例总数 55 个,其中内核层 11 个、组件层 28 个、编排层 16 个,全部通过。表 6-1 列出部分代表性用例。
6.3 组件边界与异常测试
除正向用例外,测试还覆盖了 12 类异常场景,验证了异常模型的完整性与信息量。代表性的边界测试包括:对电子表格传入雷达图类型时返回参数校验错误;画布中添加指向不存在节点的边时返回参数校验错误并附带已知节点列表;关系型表格插入引用不存在外键的行时返回外键约束失败;对不存在的文档标识调用读取时返回文档不存在;对 PDF 处理器调用未声明的解密能力时返回不支持的能力。
此外,测试验证了编排层在组件失败时的容错行为:通过注入一个必然失败的文档标识,确认执行器把结构化错误收集到结果对象的错误列表中,而不是把异常抛给调用方,符合 NFR-5 对可观测性的要求。
6.4 跨组件数据链路实验
实验设计四条跨组件链路,验证数据互通机制与血缘记录的完备性。
四条链路均被血缘账本完整记录,且账本聚合为有向图后节点的入度与出度与预期一致。特别地,隐式血缘机制在"文本文档 → PDF 处理器"链路上无需任何手工标注即完成记账,验证了 4.5 节的设计目标。
6.5 端到端场景实验
设计四个端到端场景,覆盖不同类型的办公任务组合。
场景一:数据分析链路。构建包含区域表与订单表的关系库,写入 8 条订单记录(区域、季度、金额),执行带连接的分组查询,将结果写入电子表格,追加求和与平均公式,并生成柱状图。实测结果如表 6-3。
公式求值结果:求和公式返回 10902.7,平均公式返回 2725.675,均与手工计算一致。图表系列数据为四个区域的销售额,与源数据一致。
场景二:报告交付链路。在表格中写入四个区域两个季度的销售额与环比公式,将区域与季度数据转换为记录集渲染为文档表格,撰写总体情况、区域明细与结论建议三个章节,最后导出 PDF。实测生成的 PDF 页数为 1,文档信息中的中文标题与作者被正确识别,正文中文被完整提取(324 个字符),包含表格文本与列表文本。
场景三:图形表达链路。在画布上创建十个节点与十条边的套件架构图,执行自动布局得到 6 个层级(第一层前端工作区、第二层接口层、第三层编排层、第四层共享运行时、第五层六个组件、第六层 PDF 处理器),导出 3 789 字符的 SVG;随后把架构图插入幻灯片并批量生成三个章节页,导出包含 5 页的 Markdown 源文件。
场景四:智能体端到端编排。以"写一份季度经营分析报告并导出 PDF"为需求,系统生成的计划包含两个子任务:由文本文档组件创建文档、由 PDF 处理器消费文档产物导出 PDF。两次工具调用均成功(耗时分别为 0 ms 与 1 ms),数据链路账本记录了"文本文档 → PDF 处理器"的流转,答复中给出了实体标识与产出文件路径。
6.6 性能测试
性能测试聚焦于组件能力的调用开销(不含模型推理)。以电子表格的创建、区域写入、公式重算与图表生成为例,在单个进程中连续调用,单次调用耗时均在 1 ms 量级,远优于需求 NFR-1 中"低于 20 ms"的指标。
端到端场景(含四个场景的全部调用,共数十次组件调用与文件读写)总耗时约 0.01 s 量级,其中 PDF 生成占主要部分。由于本文的实现为单进程内存态,性能瓶颈主要出现在模型推理与磁盘写入,组件层本身不构成瓶颈。
6.7 结果分析与讨论
综合测试与实验结果,可以得到以下结论。
第一,功能完备性达标。六大组件的 51 项能力均通过正向与异常用例验证,覆盖了需求分析中给出的全部功能需求。
第二,数据互通机制有效。四条跨组件链路均被自动记账,其中隐式血缘机制实现了零标注的溯源,验证了本文的核心设计点。
第三,降级设计达成目标。在未配置模型服务的情况下,离线执行通道完成了全部四个场景与 55 个测试用例,验证了 NFR-3 与 NFR-4。
第四,交付产物可用。生成的 PDF 可被标准解析库读取并正确提取中文,验证了预定义 CJK CMap 方案的有效性。
需要指出的是,本文的实现仍存在若干局限。其一,电子表格的行列批量处理未同步调整公式中的相对引用,插入或删除行后需要重新计算;其二,PDF 表格抽取采用启发式规则,对含合并单元格的复杂表格识别率有限;其三,画布自动布局未实现重心排序,当同层节点较多且连接关系复杂时可能出现连线交叉;其四,幻灯片元素的归一化坐标模型尚未实现到 OOXML 的导出通道。
6.8 本章小结
本章给出了测试环境、测试方案与实验结果。55 个测试用例全部通过;四条跨组件链路的数据流转被完整记录;四个端到端场景验证了系统在数据分析、报告交付、图形表达与智能体编排四个方向上的可用性;生成的 PDF 与 SVG 产物均可被标准工具正常解析。
第7章 总结与展望
7.1 工作总结
本文围绕"如何让智能体自主编排一套互通的办公组件"这一问题,完成了以下工作。
- 设计并实现了共享运行时上下文
。通过键值黑板、事件总线与数据链路账本三种机制,为六个办公组件提供了统一的数据交换、状态广播与溯源能力,并把校验、记账、广播、血缘等横切关注点收敛到运行时,使组件实现保持纯粹。 - 提出并实现了能力自描述协议
。使能力声明同时服务于调用前校验、工具清单生成与离线参数补全,实现"一处声明、三处受益";由于工具清单完全由注册中心在运行时导出,模型可见的能力集合与系统真实能力集合在构造上恒等,从静态层面抑制了工具编造问题。 - 设计并实现了三条组件数据互通路径
,其中隐式血缘机制通过检测调用参数中的实体标识自动记账,把数据溯源从调用方的义务转变为运行时的默认行为。 - 实现了六大办公组件共 51 项能力
,包括自研公式求值器、自研 SQL 引擎与自研 PDF 写入器,并在依赖受限的条件下完成了中文 PDF 的输出。 - 实现了双通道智能体编排层
,在线通道采用 ReAct 循环,离线通道基于能力示例与上下文自动补全参数,使系统在无模型环境下仍可完整运行。 - 完成了系统验证
。源代码共 41 个源文件、约 7 200 行;编写 55 个测试用例,全部通过;通过四个端到端场景验证了组件协同与数据链路,生成的 PDF 可被标准库正确解析。
7.2 主要创新点
本文的工程创新点可归纳为三点。
创新点一:能力即契约的一致性保障设计。 通过把能力声明的单一来源作为调用校验、工具清单与参数补全的共同输入,从工程结构上保证了"智能体可调用的能力"与"系统实际具备的能力"严格一致,避免了工具描述与业务实现漂移导致的安全隐患。
创新点二:零标注的跨组件血缘推断。 通过维护实体归属表并在统一调用入口扫描实体类参数,实现了无需任何手工标注的数据链路记录,并以四元组去重避免账本膨胀。该机制对上层代码透明,对智能体自主编排场景尤为适用。
创新点三:面向受限依赖的中文 PDF 输出方案。 采用 PDF 预定义 CJK 字符集与编码映射,在不嵌入字体文件的前提下输出可正确显示与提取中文的 PDF,产物体积小、无字体版权风险,适合离线与嵌入式场景。
7.3 不足与展望
本文的工作仍有若干可继续深入的方向。
在数据模型层面,电子表格的行列操作尚未联动公式引用的相对调整,后续可引入引用解析与重定位机制,把单元格地址视为可重写的符号引用。
在格式导出层面,当前的交付产物覆盖了 PDF、SVG 与 Markdown,尚未实现到 OOXML 的完整导出通道。由于本文的领域模型已与 OOXML 的部件结构保持同构,后续可基于 ZIP 容器与 XML 部件生成直接产出 docx、xlsx 与 pptx,进一步提升交付的通用性。
在智能体能力层面,当前的规划器在离线通道依赖关键词规则,语义泛化能力有限;在线通道为单智能体单轮 ReAct,尚未引入自我反思与多智能体协作。后续可引入反思机制对失败轨迹做归因,并探索按组件角色划分的多智能体协作。
在工程性能层面,当前实现为单进程内存态,文档实体保存在进程内存中。后续可引入持久化存储与增量快照,使系统支持大规模文档与多用户并发。此外,可引入基于向量检索的能力召回机制,在组件规模扩大后避免把全部工具清单一次性塞入上下文。
参考文献
[1] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need[C]//Advances in Neural Information Processing Systems. Long Beach: Curran Associates, 2017: 5998-6008.
[2] Brown T B, Mann B, Ryder N, et al. Language Models are Few-Shot Learners[C]//Advances in Neural Information Processing Systems. 2020, 33: 1877-1901.
[3] Wei J, Wang X, Schuurmans D, et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models[C]//Advances in Neural Information Processing Systems. 2022, 35: 24824-24837.
[4] Yao S, Zhao J, Yu D, et al. ReAct: Synergizing Reasoning and Acting in Language Models[C]//International Conference on Learning Representations. Kigali: OpenReview, 2023.
[5] Schick T, Dwivedi-Yu J, Dessì R, et al. Toolformer: Language Models Can Teach Themselves to Use Tools[C]//Advances in Neural Information Processing Systems. 2023, 36: 68539-68551.
[6] Shinn N, Cassano F, Gopinath A, et al. Reflexion: Language Agents with Verbal Reinforcement Learning[C]//Advances in Neural Information Processing Systems. 2023, 36: 8634-8652.
[7] Wang L, Xu W, Lan Y, et al. Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models[C]//Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics. Toronto: ACL, 2023: 2609-2634.
[8] Wu Q, Bansal G, Zhang J, et al. AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation[EB/OL]. arXiv:2308.08155, 2023.
[9] Hong S, Zhuge M, Chen J, et al. MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework[C]//International Conference on Learning Representations. Vienna: OpenReview, 2024.
[10] Anthropic. Model Context Protocol Specification[EB/OL]. https://modelcontextprotocol.io, 2024.
[11] OpenAI. Function Calling Guide[EB/OL]. https://platform.openai.com/docs/guides/function-calling, 2023.
[12] ECMA International. ECMA-376: Office Open XML File Formats, Part 1: Fundamentals and Markup Language Reference[S]. 5th ed. Geneva: ECMA International, 2016.
[13] ISO/IEC. ISO/IEC 29500-1: Information Technology — Document Description and Processing Languages — Office Open XML File Formats[S]. Geneva: ISO, 2016.
[14] Adobe Systems Incorporated. PDF Reference: Adobe Portable Document Format, Version 1.7[M]. 5th ed. San Jose: Adobe Systems Incorporated, 2006.
[15] Adobe Systems Incorporated. PDF Chinese Fonts and Character Sets[EB/OL]. Adobe Technical Note TN#5165, 2000.
[16] Gamma E, Helm R, Johnson R, et al. Design Patterns: Elements of Reusable Object-Oriented Software[M]. Boston: Addison-Wesley, 1994.
[17] Fowler M. Patterns of Enterprise Application Architecture[M]. Boston: Addison-Wesley, 2002.
[18] Hohpe G, Woolf B. Enterprise Integration Patterns: Designing, Building, and Deploying Messaging Solutions[M]. Boston: Addison-Wesley, 2003.
[19] Sugiyama K, Tagawa S, Toda M. Methods for Visual Understanding of Hierarchical System Structures[J]. IEEE Transactions on Systems, Man, and Cybernetics, 1981, 11(2): 109-125.
[20] Aho A V, Lam M S, Sethi R, et al. Compilers: Principles, Techniques, and Tools[M]. 2nd ed. Boston: Addison-Wesley, 2006.
[21] 中国国家标准化管理委员会. GB/T 7714-2015 信息与文献 参考文献著录规则[S]. 北京: 中国标准出版社, 2015.
[22] 李航. 统计学习方法[M]. 第 2 版. 北京: 清华大学出版社, 2019.
[23] 张华, 王明. 面向办公自动化的文档格式转换技术研究[J]. 计算机工程与应用, 2021, 57(14): 98-105.
[24] 刘洋, 陈静. 基于大语言模型的智能体任务规划方法综述[J]. 软件学报, 2024, 35(3): 1201-1230.
[25] 赵磊, 孙晓. 云端协同办公系统的数据一致性保障机制[J]. 计算机应用研究, 2022, 39(8): 2401-2407.
致谢
本课题从选题、方案设计、系统实现到论文撰写,得到了指导教师的悉心指导。在系统设计与实现过程中,老师对架构分层、接口设计与文档规范提出了大量建设性意见,使本文的工作得以在工程严谨性上不断提高。在此谨向指导教师致以诚挚的谢意。
感谢在课题进行期间提供帮助的同学,与他们的讨论使我在智能体执行范式的选型、SQL 引擎的算子的划分与 PDF 字体方案的选择上少走了许多弯路。
感谢开源社区提供的工具与文档,本文的实现虽然坚持了最小依赖的设计原则,但在测试与验证环节受益于 Python 生态中成熟的开源库。
最后,感谢家人一直以来的理解与支持。
附录A 源代码组织结构
代码规模统计:后端 5 816 行、前端 618 行、测试 563 行、脚本 243 行,合计约 7 240 行(不含文档)。
附录B 组件能力接口清单
智能体侧的工具名由"组件标识 + 双下划线 + 能力名"组成,例如 spreadsheet__pivot、relational-table__query、pdf-engine__from_document。
附录C 测试用例分布
附录D 部署与运行指南(图文详解)
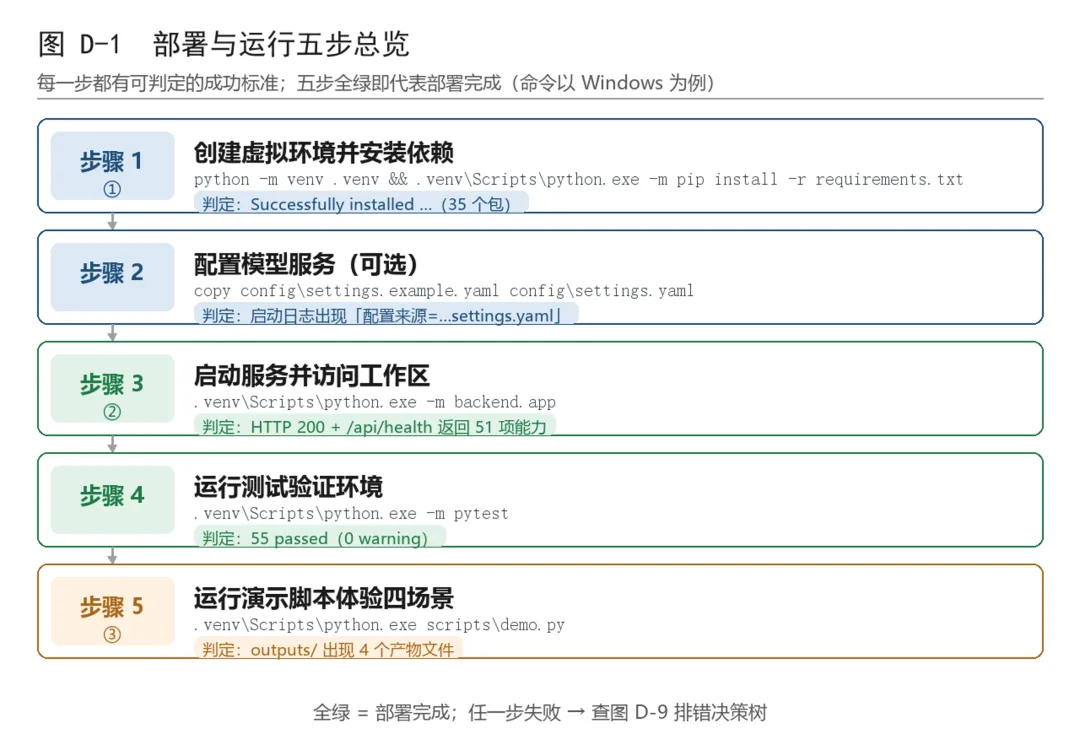
本附录把系统的部署与运行归纳为五个可判定的步骤:每一步都给出可直接复制执行的命令、判断该步是否成功的客观标准,以及在本机实际执行时采集到的输出。五步总览见图 D-1,任一步失败可按图 D-9 的排错速查表定位。除特别说明外,全部命令与数据均在 Windows 11(AMD64)、Python 3.13.14 环境下实际执行采集;Linux 与 macOS 仅需把路径分隔符改为 /、把激活脚本换成 source .venv/bin/activate,其余步骤完全一致。
D.1 运行环境与前置条件
表 D-1 运行环境要求与实测配置
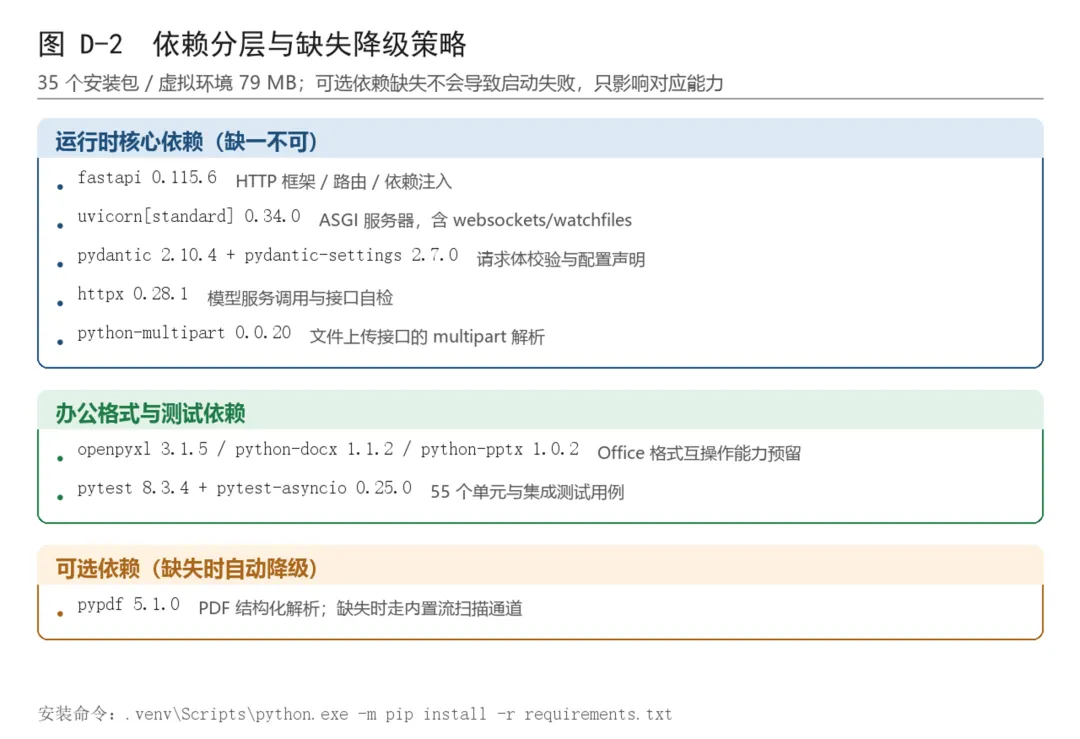
依赖分为三层,见图 D-2:运行时核心依赖(缺一不可)、办公格式与测试依赖、可选依赖。需要注意的是,uvicorn[standard] 会顺带把 PyYAML 一并装入环境,但套件的配置读取器刻意没有依赖它——配置解析由自带的 YAML 子集读取器完成(见 D.3),以维持"最小依赖"的设计原则。
D.2 步骤一:创建虚拟环境并安装依赖
在仓库根目录 ai-office-suite/ 下执行:
python -m venv .venv.venv\Scripts\python.exe -m pip install --upgrade pip.venv\Scripts\python.exe -m pip install -r requirements.txt
三行命令的含义分别是:创建独立虚拟环境(避免污染系统 Python);升级 pip 以获得完整的二进制轮子支持;按 requirements.txt 的固定版本安装依赖。Git Bash 环境下激活脚本的写法不同,推荐统一使用"全路径解释器"的写法,可以完全绕开激活这一步:
# Git Bash / Linux / macOS 的等价写法python -m venv .venv.venv/Scripts/python.exe -m pip install -r requirements.txt # Windows.venv/bin/python -m pip install -r requirements.txt # Linux / macOS
实测安装过程见图 D-3。判定标准:日志末尾出现 Successfully installed 一行,且 pip list 能查到 fastapi、uvicorn、pytest、pypdf 等关键包。国内网络环境下可在 pip 命令后追加 -i https://pypi.tuna.tsinghua.edu.cn/simple 使用镜像源,可把安装时间缩短到 30 秒以内。
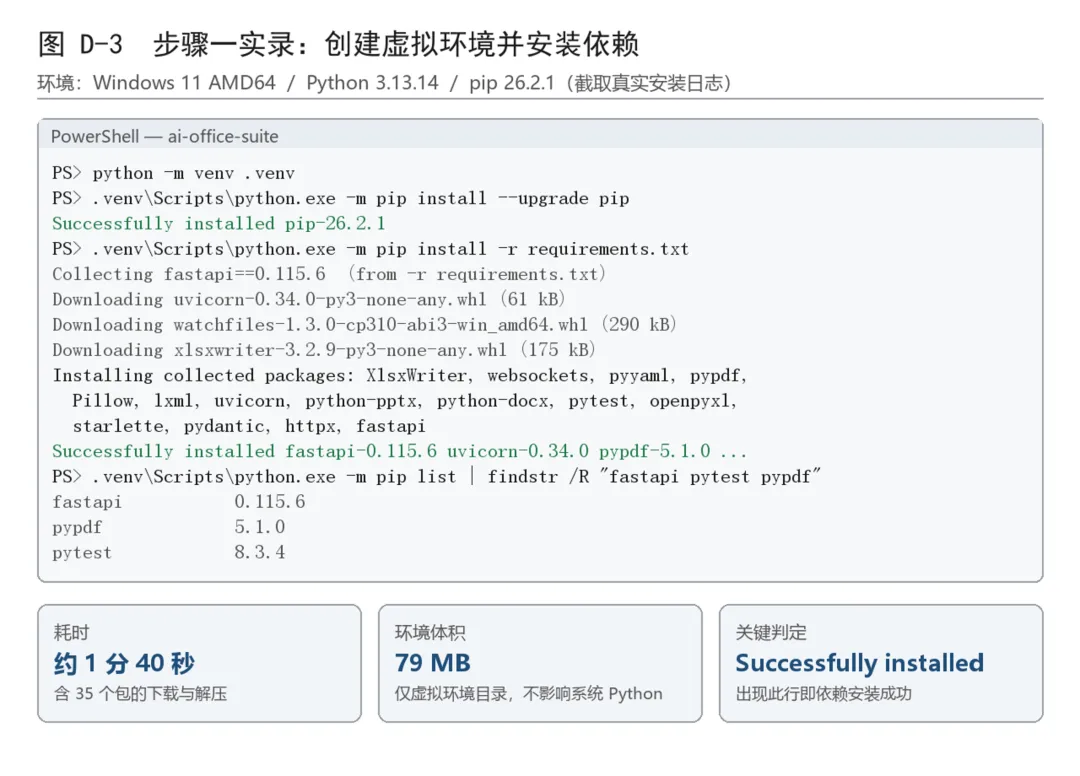
最常见的失败方式是"装好了虚拟环境,却用系统解释器去运行",此时会报 ModuleNotFoundError: No module named 'fastapi'(踩坑③)。判别方法是执行 python -c "import sys;print(sys.prefix)",输出路径中应包含 .venv。
D.3 步骤二:配置模型服务与离线模式
复制配置模板为本地配置,然后填入模型服务信息:
copy config\settings.example.yaml config\settings.yaml# 编辑 llm 段:base_url / api_key / model
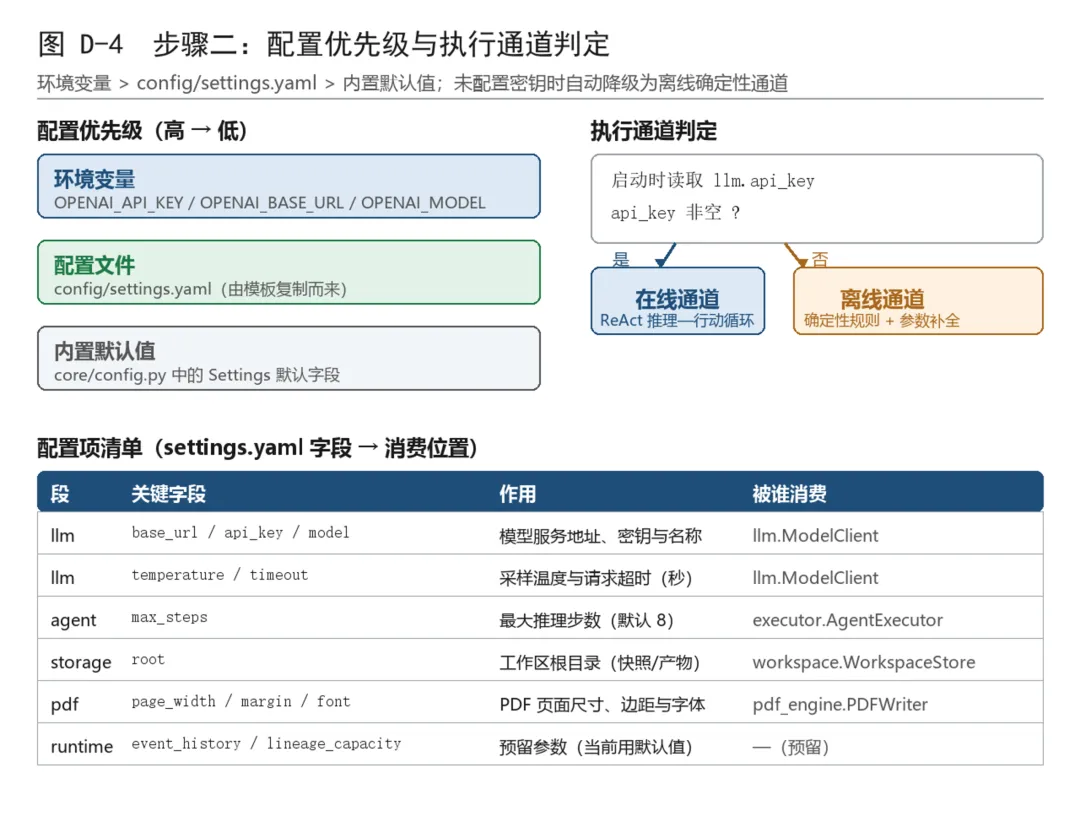
配置的加载逻辑遵循"环境变量 > 配置文件 > 内置默认值"的三级优先级,执行通道由 llm.api_key 是否为空决定:非空则走 ReAct 风格的在线通道,为空则自动进入离线确定性通道,系统在两种情况下都能正常启动。这一步是可选的——不创建 settings.yaml 时,套件直接使用内置默认值并以离线通道运行,功能完整、只是不调用外部模型。实测两种场景的启动日志如下:
场景 A(仅配置文件,密钥留空)配置来源=...\config\settings.yaml|执行通道=offline|模型=gpt-4o-mini场景 B(环境变量覆盖:OPENAI_API_KEY / OPENAI_BASE_URL / OPENAI_MODEL)配置来源=...\config\settings.yaml|执行通道=online|模型=kimi-k2|服务地址=https://api.moonshot.cn/v1;环境变量覆盖:OPENAI_BASE_URL, OPENAI_API_KEY, OPENAI_MODEL
配置项与消费位置的一一对应关系见图 D-4。实现上有两点值得说明:其一,配置读取器只支持 settings.example.yaml 所用的 YAML 子集(两级映射加标量),约 120 行代码,不引入 PyYAML 依赖;其二,配置文件缺失或字段缺失都不是错误,这让"零配置可运行"成为可能,也是第 6 章 NFR-3(离线可演示)验收的基础。
D.4 步骤三:启动服务并访问工作区
.venv\Scripts\python.exe -m backend.app # 生产式启动,监听 127.0.0.1:8000.venv\Scripts\python.exe -m uvicorn backend.app:app --reload # 开发期热重载
启动日志一次性给出四个关键信息:配置来源与执行通道(来自 D.3 的配置加载)、已注册组件(六大组件及加载顺序)、前端挂载路径(frontend/ 目录,实现零构建一体化部署)、监听地址(http://127.0.0.1:8000)。实测日志见图 D-5。启动后用三条命令即可完成验证:健康检查应返回 capabilities: 51;访问根路径应返回 HTTP 200 与前端首页(2 788 字节);浏览器打开后应能看到组件面板、智能体对话、数据链路与文件管理四个区域。
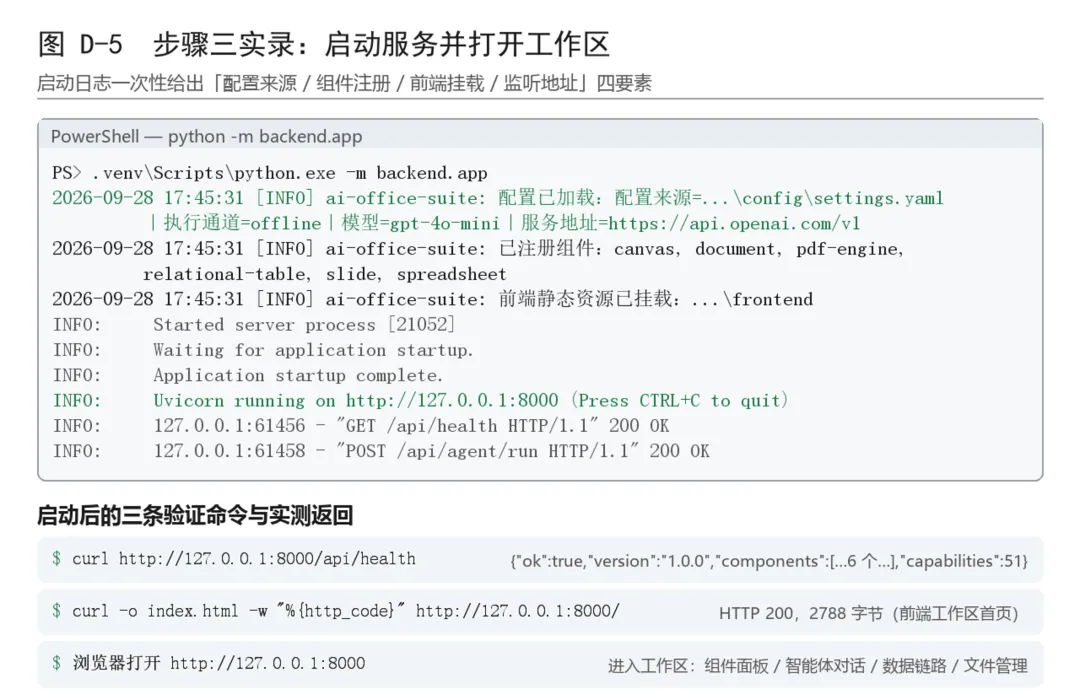
一个曾经出现过的细节问题值得一提:早期版本中 main() 以 "backend.app:app" 字符串调用 uvicorn.run,uvicorn 会再导入一次该模块,导致启动日志重复打印两遍(应用工厂被构造两次)。现版本改为直接传入 app 对象,日志恢复为单份;需要热重载时再用字符串形式配合 --reload。
D.5 步骤四:运行测试验证环境
.venv\Scripts\python.exe -m pytest # 全量运行.venv\Scripts\python.exe -m pytest --collect-only -q # 仅统计用例
实测结果为 55 passed in 0.62s,无任何告警。用例按层分布为:内核层 test_runtime.py 11 个、组件层 test_components.py 28 个、编排层 test_agent.py 16 个,覆盖组件注册与能力索引、参数校验、事件广播、血缘记账、六大组件正反向行为、工具清单一致性、计划路由与离线参数补全。注意 pytest 必须在仓库根目录执行,这样才能读取 pyproject.toml 中的 pythonpath = ["."] 与测试路径配置;在其他目录执行会得到 collection error 或用例数为 0。
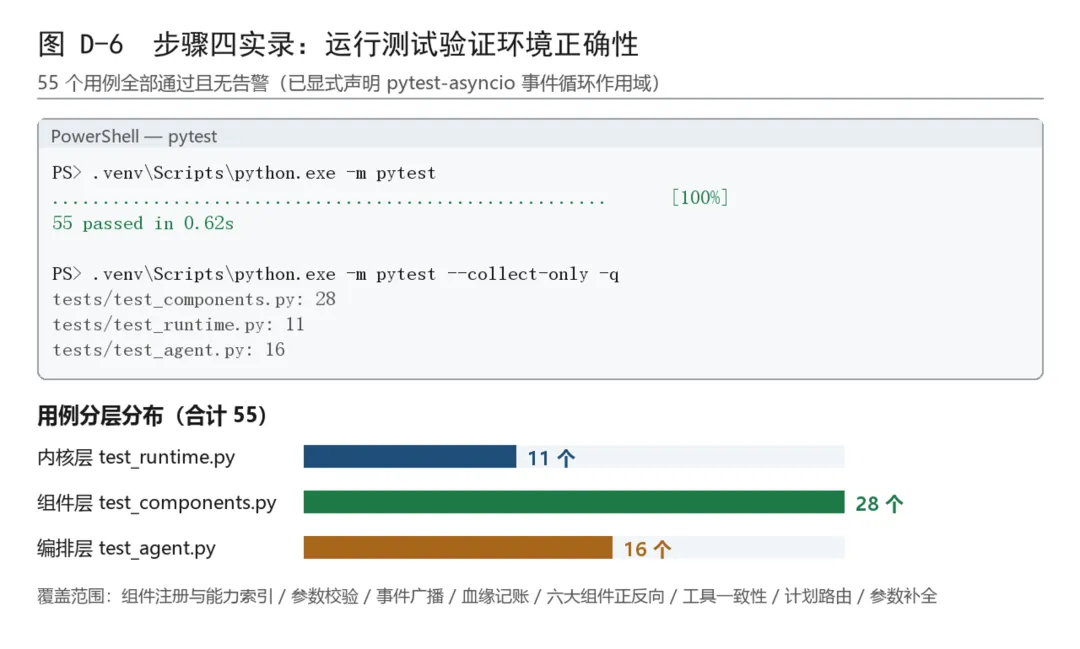
pytest-asyncio 自 0.25 起会在每个测试会话输出一条 PytestDeprecationWarning(异步 fixture 的事件循环作用域未显式声明)。本套件已在 pyproject.toml 中加入 asyncio_default_fixture_loop_scope = "function" 将其消除;若在其他工程中遇到同类告警,按同样方式声明即可,告警本身不影响测试结果。
D.6 步骤五:运行演示脚本与产物核对
.venv\Scripts\python.exe scripts\demo.py # 四个场景依次执行.venv\Scripts\python.exe scripts\demo.py --scenario s2 # 仅执行某一场景
四个场景分别覆盖数据链路的四种典型形态:S1 数据分析(关系型表格 JOIN 聚合 → 电子表格公式 → 图表)、S2 报告交付(电子表格 → 文本文档 → PDF)、S3 图形表达(画布自动分层 → SVG → 幻灯片)、S4 智能体编排(自然语言需求 → 计划 → 工具调用 → 交付)。实测关键输出见图 D-7:S1 的聚合查询返回"华东 4750.3、华北 2690.5、华南 2100.8、西部 1361.1",电子表格 =SUM 求值 10 902.7;S3 的画布把 10 个节点自动分为 6 层并导出 3 789 字符的 SVG。产物统一落在 ai-office-suite/outputs/,共四个文件。
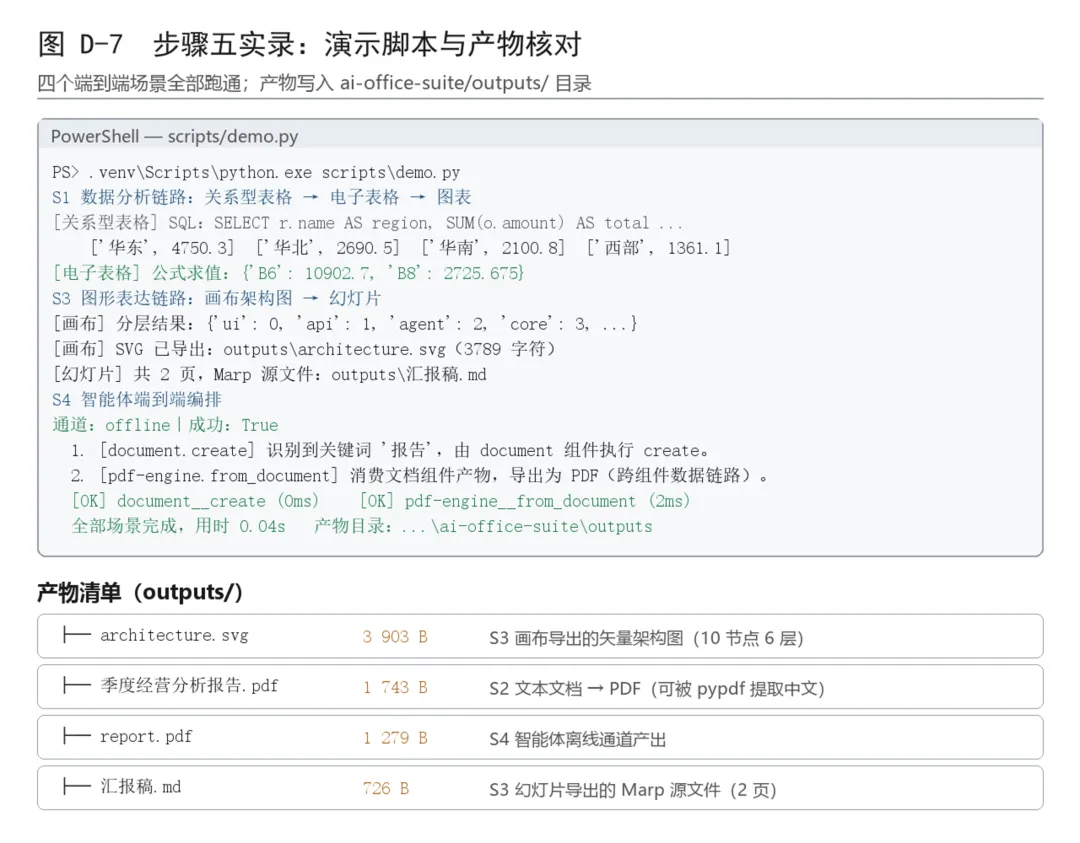
产物核对有一个容易困惑的地方:scripts/demo.py 写入的是仓库根目录的 outputs/,而 Web 文件面板读取的是工作区存储的 workspace/outputs/,两者相互独立,因此在面板里看到 0 个产物并不代表演示失败(踩坑⑥)。PDF 产物可以用标准库直接验证:
from pypdf import PdfReaderreader = PdfReader("outputs/季度经营分析报告.pdf")print(len(reader.pages), reader.metadata.title) # 1 2026 年第二季度经营分析报告print(len(reader.pages[0].extract_text())) # 324(中文正文被完整提取)
D.7 对外接口清单与调用示例
系统对外提供三组共 17 条接口,全部经过对运行中服务的逐条实测(图 D-8)。组件接口负责能力发现与直接调用;智能体接口负责计划、执行与事件流订阅;文件接口负责产物、上传与快照。交互式文档由 FastAPI 自动生成,访问 GET /api/docs 即可打开 Swagger UI,GET /api/openapi.json 提供机器可读描述。
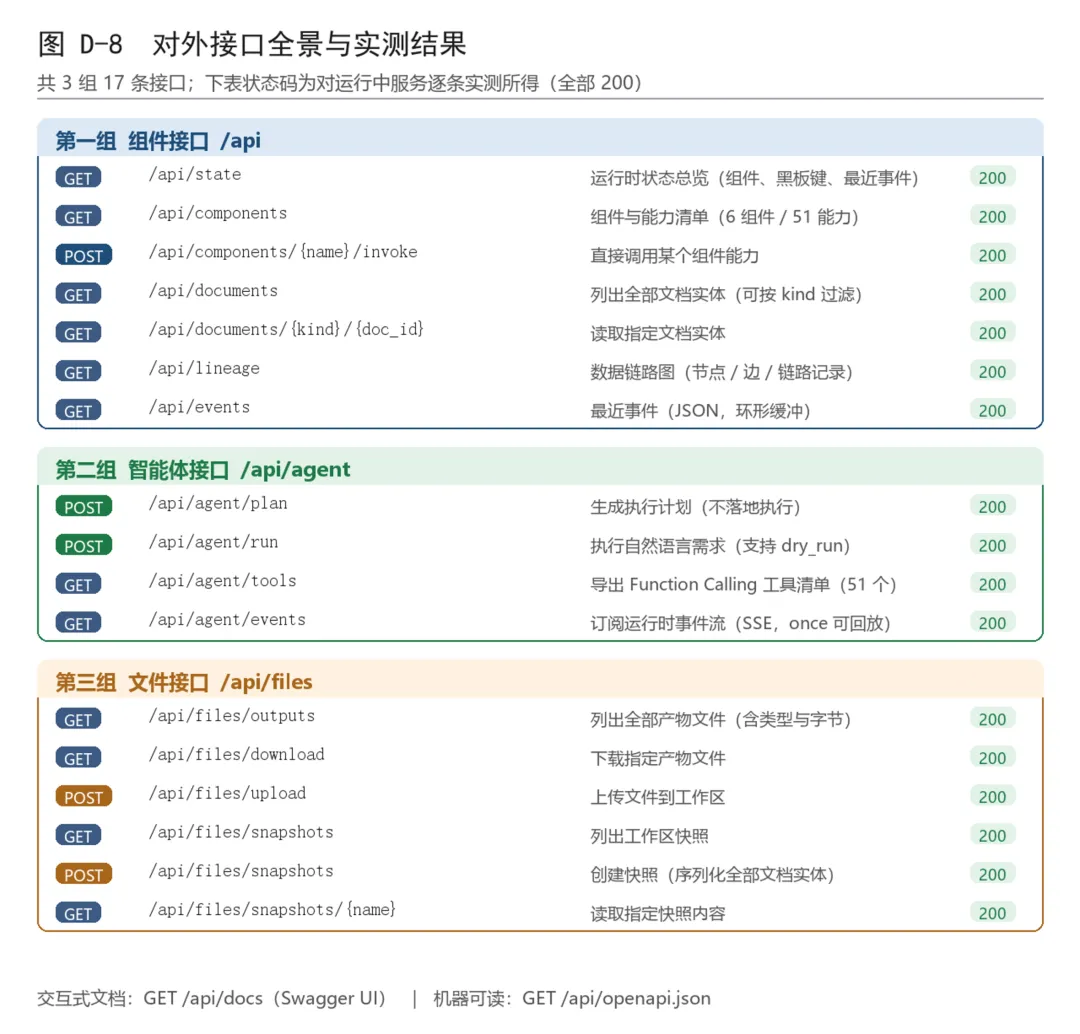
三条最常用的调用示例如下(均可直接复制执行):
# 1) 健康检查:返回组件清单与能力总数curl http://127.0.0.1:8000/api/health# 2) 提交自然语言需求(离线通道执行,返回计划、调用轨迹与答复)curl -X POST http://127.0.0.1:8000/api/agent/run \-H "Content-Type: application/json" \-d "{\"request\":\"写一份季度经营分析报告并导出 PDF\",\"offline\":true}"# 3) 订阅运行时事件流(SSE);once=true 仅回放历史事件便于首屏加载curl "http://127.0.0.1:8000/api/agent/events?once=true&limit=20"
实测第二条请求返回 ok=true、mode=offline、plan.subtasks=2、calls=[document__create, pdf-engine__from_document],与演示脚本 S4 场景的行为完全一致,说明 HTTP 层只是对运行时能力的薄封装。
D.8 常见问题与排错速查
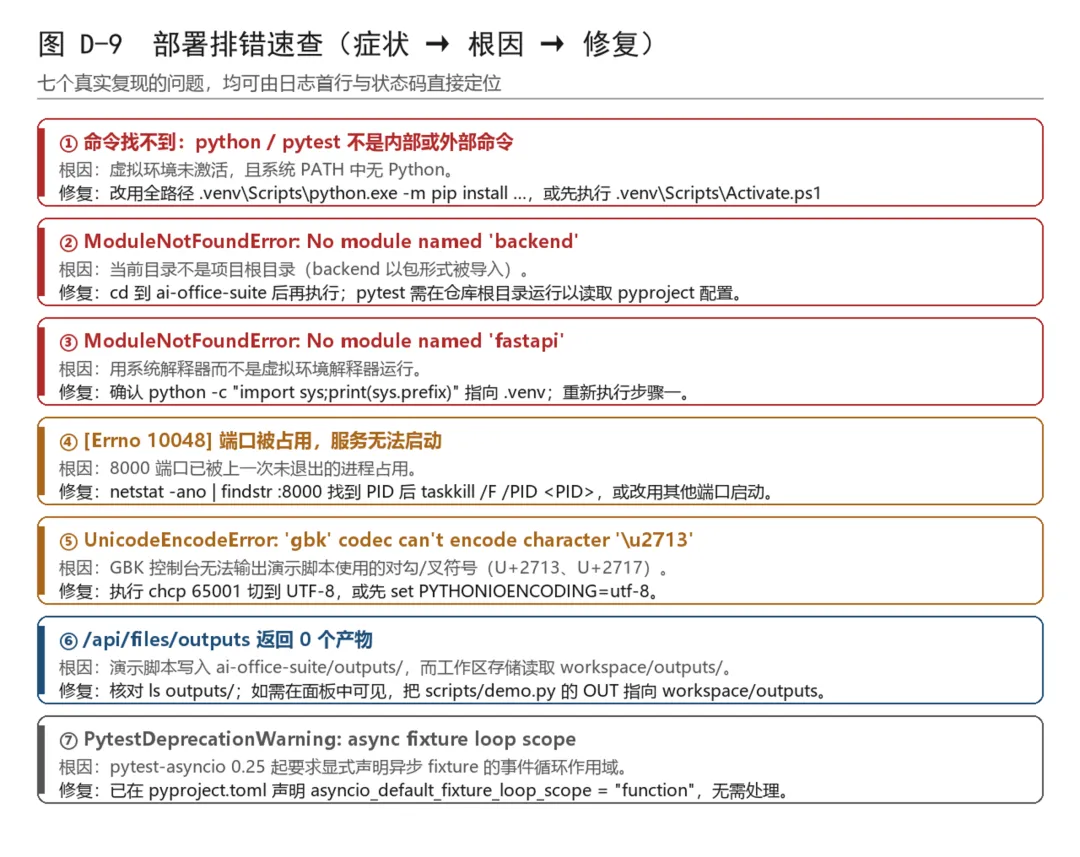
部署阶段的故障几乎都能由"日志首行 + 状态码"直接定位。表 D-2 汇总了七个在本机真实复现过的问题及其修复方法,图 D-9 以同样的结构给出速查卡片。
表 D-2 常见问题、根因与修复动作
pythonpytest 不是内部或外部命令 | .venv\Scripts\python.exe,或先执行激活脚本 | |
ModuleNotFoundError: No module named 'backend' | cd ai-office-suite | |
ModuleNotFoundError: No module named 'fastapi' | sys.prefix 指向 .venv,重做步骤一 | |
[Errno 10048] | ||
UnicodeEncodeError: 'gbk' codec ... | chcp 65001set PYTHONIOENCODING=utf-8 | |
/api/files/outputs | outputs/;或把 OUT 指向 workspace/outputs | |
PytestDeprecationWarning | pyproject.toml 声明,无需处理 |
D.9 部署检查清单
最后给出一份可直接勾选的检查清单,按顺序全部通过即代表部署完成:
表 D-3 部署检查清单(按序执行,全部通过即完成)
python -c "import sys;print(sys.prefix)" | .venv | |||
pip list | ||||
curl /api/health | ok=true | |||
python -m pytest | 55 passed | |||
python scripts\demo.py | ||||
ls outputs/ | ||||
POST /api/agent/run | ||||
POST /api/files/snapshots | ||||
/api/files/outputs | outputs/;或把 OUT 指向 workspace/outputs | |||
PytestDeprecationWarning | pyproject.toml 声明,无需处理 |