ARTICLE · 1094961
新Mac mini说AI快了4倍,整理文档也能快4倍吗?
新Mac mini说AI快了4倍,整理文档也能快4倍吗?
看到“AI性能最高提升4倍”,很容易在心里算一笔账:以前做一份材料要20分钟,新电脑是不是5分钟就够了? 先别急着这么算。 苹果9月22日的新Mac mini上市公告,确实用了M6机型“最高4倍AI性能”的表述,脚注列出了对比的上一代M4配置。这是特定条件下的官方性能主张,不是所有软件、所有任务的统一提速承诺。苹果公告 对准备买机器的人,真正值得问的是:我的时间,到底花在哪一步? 拿“把一批PDF整理成汇报”来说,前后至少有几件事:把文件读进来,识别扫描页里的文字,把内容交给模型,再生成报告。 最后还得由你核对日期、金额和引用,改掉不合适的表达。 模型生成快了,并不代表扫描识别、网络传输和人工核对都会按同样比例变快。其他环节也可能受新硬件影响,但要各自测,不能拿一个倍数替它们作保证。 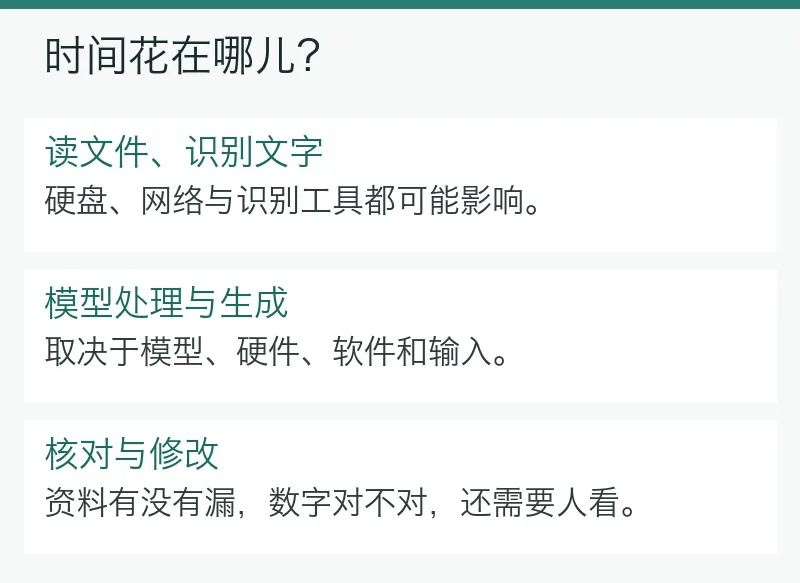
如果文件在NAS上,读取速度可能还受网络影响。如果文档交给云端模型处理,响应时间还受服务端和连接状况影响。电脑换新,不会让远端服务器按你的芯片型号重新排队。 看评测时,特别留意它测的是哪一个时间。 一种是点发送后,到第一个字出现,等了多久。另一种是文字开始出来以后,每秒能生成多少。还有一种,是从提交材料到拿到可用文件,总共用了多久。 苹果的Mac mini产品页就把LM Studio的首个token时间列为一项比较指标。它能反映等待体验,但不能直接替代整项工作的总耗时。 模型、输入长度、量化方式、软件版本不同,结果也可能不同。不要把产品页上的某项倍数,直接乘到自己每天做的所有事情上。 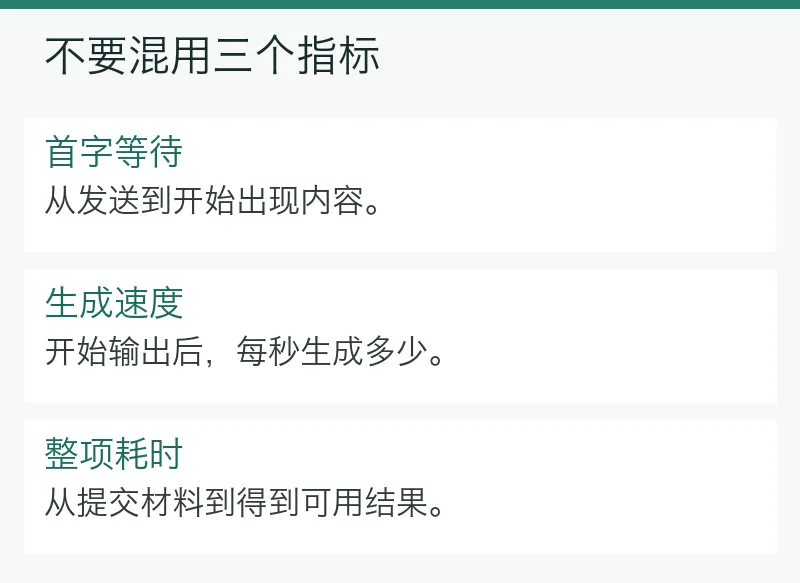
首个字更快出来,当然有价值。每天反复问几十次的人,体感可能很明显。只是“更快开始回答”和“这份工作提前完成”,中间还有一段距离。 下面是为了说明算法的假设,不是新Mac mini的实测。 一项工作原来要10分钟,其中8分钟花在其他环节,模型计算占2分钟。假设只有模型部分变快,速度变成原来的4倍,2分钟就缩短为0.5分钟。 总耗时变成8.5分钟,省了1.5分钟,也就是15%。整体速度约为原来的1.18倍,不是4倍。 反过来,如果10分钟里有8分钟都在等模型,按同样假设,总耗时会变成4分钟,收益就大得多。 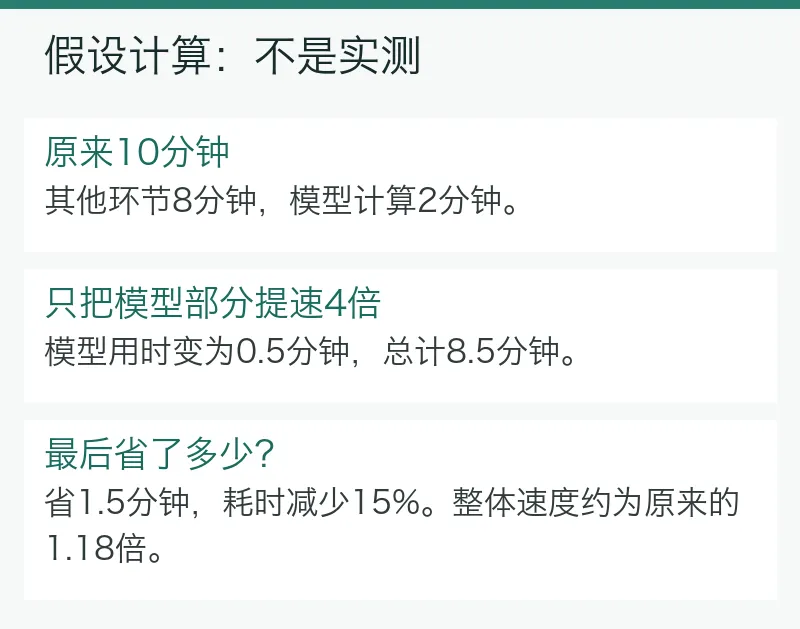
同一项硬件提升,两个人的感受可能完全不同。一个人主要等计算,另一个人主要改答案,这不奇怪。 不要拿一句“你好”判断一台电脑值不值。选一份你真的会处理、又不敏感的材料,比如一份周报或产品说明。 记录三个时刻:提交任务、开始出字、文件完成。另记自己检查修改花了多久。跑三次,保留每次结果,别只挑最快的一次。 第一次启动还可能包含模型加载。把首次运行和已经加载后的运行分开记,才知道自己每天的实际等待在哪里。 对比新旧机器时,材料、模型文件、量化版本、上下文设置和软件版本尽量一致。用新电脑上的小模型去比旧电脑上的大模型,结论没有多少购买参考价值。 还要看结果是否达到同一要求。一个输出500字,另一个输出2000字;一个漏了表格,另一个保留完整,都不能只比秒数。 没有新机可测也没关系。先在旧机上记录一次,就能发现最慢的是哪一步。带着具体材料问评测者,比问“这个配置跑AI快不快”更容易得到有用答案。 你经常跑本地模型,大部分时间确实在等待推理,且目标软件能利用新硬件,升级值得进一步比较。 你需要的模型在现有内存里装不下,也值得看更合适的配置。但那是容量问题,不应只盯着速度倍数。能否装下,还要考虑上下文和其他程序占用。 如果你主要用网页AI,或者每次只偶尔改一小段文字,先别把“最高4倍”当成必须换机的理由。看看现有电脑能否完成,再决定这点等待值多少钱。 本文没有两代Mac mini的同条件实机成绩,不给“实际只快多少”的结论。它要解决的是另一件事:让你读懂性能数字,而不是替任何一代机器站队。 新电脑可以让一部分工作更快。买之前先知道自己每天在等什么,这笔钱才花得明白。 AI前哨局
电脑在忙,不一定都是模型在算
“开始回答快”,和“回答完快”不同
算一个例子,就容易明白了