ARTICLE · 1101822
AI Agent_9 AI 推理与规划(Reasoning & Planning)
一、先区分两个概念
推理(Reasoning):从已知推出未知 —— 理解、逻辑、数学、因果判断。
示例:"如果明天下雨,出门就要带伞;天气预报说明天下雨,所以我要带伞。"(三段论)
规划(Planning):为达成一个目标,安排一串有序的动作。
示例:"明天出差:①6:50 起床 → ②7:20 看天气(下雨就带伞)→ ③7:40 打车去车站 → ④提前 10 分钟到站"(任务分解 + 排序 + 条件分支)
两者的关系:规划本身也是推理的产物 ——"目标分解、步骤排序、风险评估" 都是推理活动;反过来,推理常常服务于规划(每一步行动前都要 "想")。一句话:推理是 "想",规划是 "做事的蓝图"。
二、大模型为什么 "会" 推理:底层机理
大模型训练时只学一件事 —— 预测下一个词。那 "解数学题" 的能力从哪来?三个机理:
- 语言里沉淀了逻辑结构
:语料里有海量 "因为… 所以…"、"如果… 那么…"、数学算式、代码、论文论证。模型在 "预测下一个词" 的过程中,把这些逻辑连接的模式 "压" 进了参数。它不是 "懂逻辑",而是 "极其擅长续写逻辑连贯的文本"—— 但对多数任务来说,这已经足够有用。 - "快思考" 与 "慢思考"
:类比诺贝尔奖得主卡尼曼的理论 —— - 系统 1(快思考)
:直接给答案,靠模式匹配("青岛是山东的省会"); - 系统 2(慢思考)
:把推理过程一步步写出来,靠分解与计算(鸡兔同笼列算式)。 大模型两种都能做,关键在于提示词 / 机制是否触发 "慢思考"。 - 推理的本质是 "分解"
:一步 "大跳跃" 预测很容易错(模型要同时算对很多事);拆成多步 "小步走" 后,每一步都是局部简单预测,错误率大幅下降。这是所有推理技术的共同内核。
三、推理方法谱系:从 "快思考" 到 "慢思考"
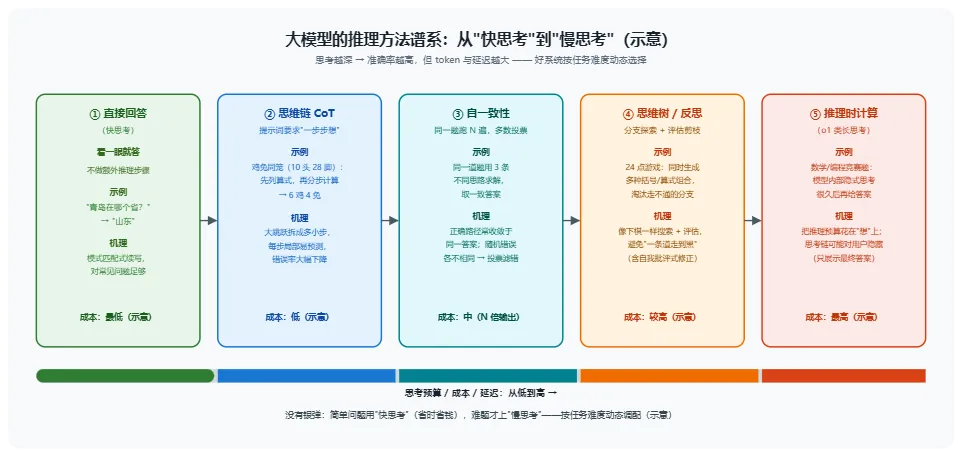
逐个方法展开(示例 + 机理):
① 直接回答—— 快思考。靠模式匹配续写,成本最低,适合常识问答。机理:参数里 "压" 着高频关联,一步续写就够。
② 思维链 CoT(Chain-of-Thought)—— 最常用的 "慢思考"。
示例:鸡兔同笼 —— 问 "共 10 头 28 脚,各几只?",提示词加 "让我们一步步想",模型输出:"假设全是鸡:20 脚;比 28 少 8;每换一只兔多 2 脚;8÷2=4 → 4 兔 6 鸡。" 机理:把 "一步大跳跃"(直接猜 6/4)拆成 4 个 "小步走"(假设→对比→换算→结论),每步都是局部简单预测,出错概率相乘后大幅降低。这是所有推理技术的地基。
③ 自一致性(Self-Consistency)—— 用 "多次采样 + 投票" 过滤随机错误。
示例:同一道逻辑题,让模型用 3 种不同思路各答一次,2 个答案一致就采用。 机理:正确路径往往收敛到同一个答案;随机错误则 "各错各的"。少数服从多数,把单次的运气成分抹平。成本约 N 倍输出。
④ 思维树 ToT(Tree of Thoughts)与反思—— 真正的 "搜索式" 推理。
示例:24 点游戏(1、3、4、6 凑 24),模型同时生成多种 "算式分支",给每个分支打分,淘汰走不通的,必要时回退重试。 机理:像下棋一样在 "思路空间" 里搜索 + 评估 + 剪枝,而不是一条道走到黑。自我反思(Reflexion)也是同一家族 —— 先生成答案,再让它自己检查、挑错、重写(示例:写完代码后自查 bug)。
⑤ 推理时计算(Test-Time Compute,o1 类长思考)—— 把 "思考预算" 内建进模型。
示例:竞赛级数学题,模型在内部生成大量推理步骤(可能对用户隐藏),"想" 够了再给答案。 机理:训练时教会模型 "该想多久、怎么想";推理时按题目难度动态投入更多计算 —— 本质是把 CoT、反思等技巧从提示词层面搬进了模型内部。成本最高,但对难题提升最明显。
四、规划方法谱系:从 "拆任务" 到 "边做边想"
推理解决 "怎么想",规划解决 "做什么、按什么顺序做"。核心循环是计划 → 执行 → 观察 → 反思 → 修订:
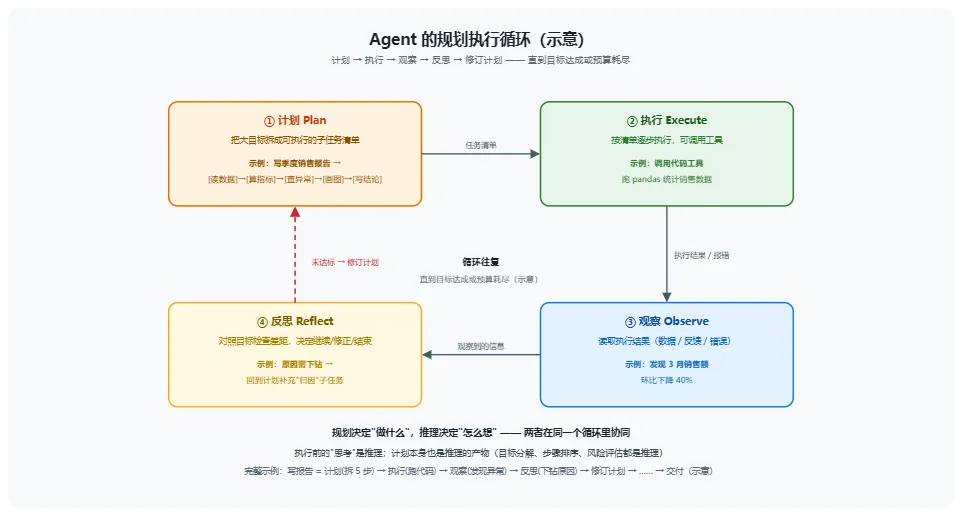
规划方法谱系表:
| 任务分解 | |||
| ReAct | |||
| 分层规划 | |||
| 反思循环 | |||
| 搜索式规划 | |||
| 工具辅助规划 |
五、推理 vs 规划:区别与联系
在 Agent 里它们合体:每一步 "执行前想清楚"= 推理;"决定接下来做哪步"= 规划;"做完检查对不对"= 反思(既是推理也是规划的修正)。
六、成本权衡:什么时候该 "慢思考"
慢思考不是免费午餐,成本 = token 消耗 + 延迟 + 出错风险。
- 简单问题
("青岛是哪个省"):用快思考 —— 上 CoT 反而浪费、还可能想偏; - 中等难题
(数学应用、逻辑题):用 CoT—— 性价比最高; - 难题
(竞赛题、长链推理、代码调试):用自一致性 / 反思 / 长思考 —— 值得多花钱; - 工程实践
:好系统会按任务难度动态调配(简单请求走快模型,复杂请求自动升级到慢思考模型)。
七、常见失败模式(新手必看)
- 编造推理(幻觉式步骤)
:模型会 "算出" 看似完整但错的步骤 —— 它优化的是 "像推理",不是 "真正确"。缓解:关键步骤交给工具(计算器、代码)验证。 - 规划失控
:循环不终止(同一个错误反复试)、跑偏(忘记原始目标)、工具滥用(每步都调工具)。缓解:给 Agent 设 "最大步数 / 预算"、定期回顾目标(反思环节)。 - 上下文膨胀
:超长思维链占满窗口,反而把有用的信息挤掉。缓解:思考过程精简、及时清理。 - 过度思考
:简单问题也长篇大论,浪费钱和时间。缓解:分级路由。
八、实际价值
- 复杂任务的质量上限
:推理决定 "能不能想对",规划决定 "能不能做完"—— 两者是 Agent 从玩具走向生产力的关键; - 应用场景
:科研(长链推理)、编程(调试 + 重构)、数据分析(计划 - 执行 - 归因)、决策支持(多方案推演)、游戏 / 搜索(规划 + 模拟); - 行业趋势
:o1 类 "推理模型" + Agent 类 "规划执行" 正在合流 —— 未来的 AI 系统 = 会推理的大脑 + 会规划的调度器 + 会执行的工具。
一句话总结:推理是把 "一步大跳跃" 拆成 "多步小步走"(CoT、自一致性、思维树、长思考),规划是按 "计划→执行→观察→反思" 排布行动序列(任务分解、ReAct、PDCA);两者在同一个循环里协同,就是 AI 从 "会聊天" 到 "会办事" 的全部秘密。理解这条主线,你就能读懂市面上任何 "会思考的 AI" 产品在做什么。