ARTICLE · 1103635
杨植麟:AI的规模化定律|AI百人谈
杨植麟:AI的规模化定律|AI百人谈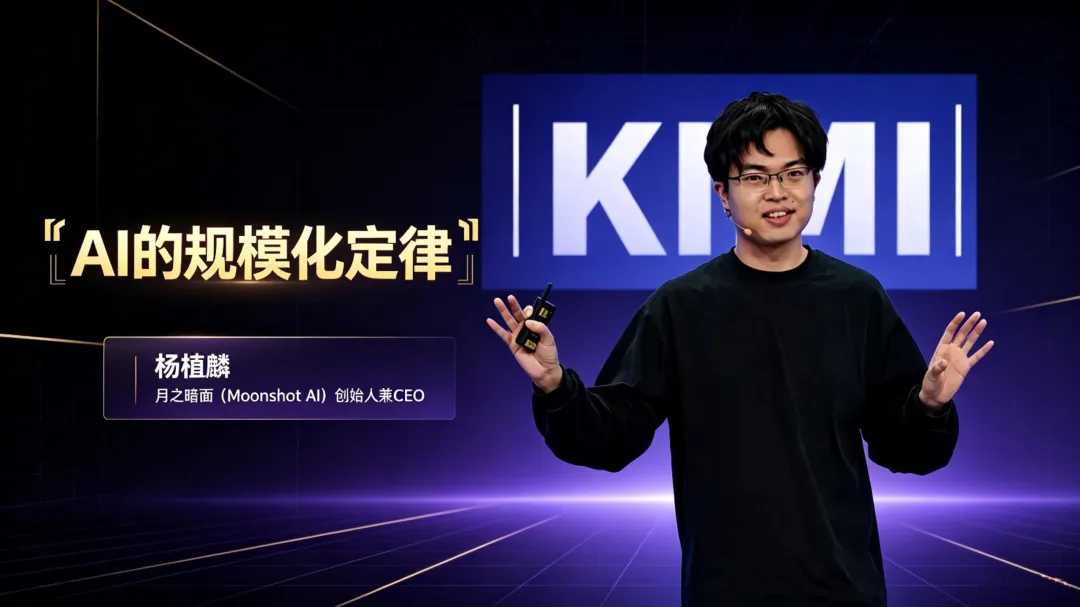
很多人谈AI,谈应用、谈商业、谈伦理,这些都很重要。 但月之暗面(Moonshot AI)创始人兼CEO杨植麟的视角更朴素:先把智能本身做上去。智能的上限没有打开之前,后面的一切都是空中楼阁。 过去七八十年,机器学习研究了很久,唯一被反复验证work的东西,其实就是scaling law——放大数据、参数、算力这些生产要素,智能就会增长。这不是信仰,是经验事实。 月之暗面在这条路上走得很激进。去年7月,发布Kimi K2,这是中国首个万亿参数的开源基座模型;今年1月K2.5,首次引入智能体集群能力;4月的K2.6,已经支持300个子智能体并行完成复杂任务;前两个月发布的Kimi K3,参数规模达到2.8万亿,是目前全球开源模型中参数量最大的。 训练这样的模型不是坦途。K3从第一天训练到最终产出,整个周期花了接近两年时间——从土地、电力、数据中心、芯片,到上层算法,一层层推进。中间哪怕一次训练失败,就要回退几个月重新再来。这需要极为扎实的验证体系和理论保障。 很多人问杨植麟,开源模型凭什么跟闭源硬碰硬?在Artificial Analysis的榜单上,K3拿到了开源权重模型有史以来的最高排名。这是规模化定律在开源路线上的兑现:开源没有降低我们的上限,反而因为生态的参与,让上限更高了。 规模的另一面是效率。世界上总Token量是有限的,如果只靠堆量,很快会碰到天花板。所以杨植麟在追求规模的同时,一直在攻克Token效率难题。 通过两代模型的改进,杨植麟实现了一个Token产生的智能,约等于原来五个Token产生的智能。杨植麟给笔者打了个比方:就像一个聪明的同学,看一本书等于别人看五本书,所以你能学得更多,智能上限就更高。 这也是杨植麟做“长上下文”的初衷。公司创立之初,杨植麟就有一个判断:lossless long context is everything——AI-Native产品的终极价值是提供个性化的交互,而无损长上下文是实现这一点的基础。模型的微调长期不应该存在,用户跟模型的交互历史,就是最好的个性化过程。历史上每一代技术,本质上都是在提升context length。如果你有10亿的context length,今天看到的问题可能都不是问题。 Token不只是成本,更是产出。杨植麟认为,Token消耗在未来可能将直接意味着GDP产出——谁消耗的Token越多,谁的经济就越活跃。在智能体时代,这就是新的GDP算法。 规模的尽头是什么? 杨植麟的答案是:深度推理。 大模型的竞争,不在于记住多少知识,而在于能不能解决复杂问题。过去Scaling Law的本质,是让模型把题库背下来,考试时凭记忆拼出最像正确答案的答案;而下一个Scaling Law,叫Reinforcement Learning Scaling——让模型自己刷题、自己打分、自己改错,把每次怎么错的、怎么改对的,都记成自己的经验。 2024年11月,K0-Math发布,第一次把这条路线摆到台前。当时很多人觉得这个判断太超前,不到两年,它已经成为现实。K3的"视觉闭环"正来自于此:模型可以从零写一个能在浏览器里探索的3D开放世界游戏,地形、光影、玩法逻辑全由模型自己完成;也能剪一支自己的发布预告片,从56段原始素材里挑片段、帧级对齐节拍。 模型解决复杂问题的另一条路,是智能体集群。智能体集群是模型规模化扩展的新维度——不是单点智能的堆叠,而是把复杂任务拆解成并行子任务,让一群智能体分工协作。K2.5首次引入AI分身集群,最多同时调度100多个分身、处理1500个步骤;到K2.6,已经支持300个子智能体并行。杨植麟从GTC开始就判断出下一代模型将从单个Agent走向可动态生成的Agent集群。这不是产品的包装,而是模型能力的自然延伸。 有件事很多人不理解:为什么一家创业公司,愿意把最强的模型权重开源? 几百年来,商业世界最本能的选择是隐藏优势、建壁垒、收许可费。但杨植麟选择反着来——花一年多时间把刀锋磨到最锋利,然后把它递给了所有人,包括明天的对手。今年7月27日,K3权重正式开源,全球任何角落的开发者,都可以通过一个链接获得它。 开源对杨植麟而言,从来不只是商业策略,而是人格选择。我们应该学习OpenAI的技术理想主义——如果所有人都觉得你正常,你的理想是大家都能想到的,它对人类的理想总量没有增量。 在GTC 2026上,杨植麟把Kimi的技术路线完整公开:Transformer时代沿用近十年的地基——优化器Adam、注意力机制、残差连接——全部给出替代方案,并全部开源。KDA混合线性注意力让百万token长文本的解码速度快了6.3倍,Attention Residuals把训练效率提升了约25%,额外成本不到2%。 一个开放的生态,最终会跑赢封闭的孤岛。未来五年,中美AI不会出现单方面的完胜,而是闭源与开源两条差异化赛道并行的格局:美国依托算力积淀守住闭源基座,中国凭开源路线、长上下文底层创新与海量产业场景,实现局部领跑。取胜的核心不在堆砌算力参数,而在底层算法。 当然,这条路不是一路高光。2024年,Kimi靠长文本和激进的投放快速出圈,Q4投流规模高达5.3亿元。但2025年1月,DeepSeek R1横空出世,几乎一夜之间改写了行业格局。那段时间,杨植麟有时每天起床都感觉公司好像要挂了。 他做了两个当时看起来反常识的决定: 很多人给杨植麟贴标签,说他是中国的某某。但杨植麟觉得,做中国的某某不太成立——中美行业土壤并不相同,应当站在全球视角做长期技术攀登。2025年底,杨植麟在内部信里把超越Anthropic列为公司最重要的目标。杨植麟从不回避这组对标:既然要做AGI,就要以世界顶尖为基准。 杨植麟把做模型比作爬雪山:有点像开车在路上,前面有延绵的雪山,但你不知道里面是什么,你在一步一步往前走。有人问过杨植麟,爬到哪了?他说,还在爬那座雪山。 也许有一天会发现,这座雪山没有尽头。 为什么叫"月之暗面"? 这个名字来自平克·弗洛伊德的那张专辑,也来自杨植麟对未知的态度:月亮的背面,你平时是看不见的,它比较未知,所以想去探索未知。 这种探索欲,可能从高中就注定了。杨植麟在人生格言栏里写过四个字:Just for fun。读热能工程时,因为看到小说里程序员深夜写代码的场景,杨植麟转入计算机系;在清华大学组过摇滚乐队;后来去卡内基梅隆读博士,苹果开出了很好的条件,杨植麟拒绝了——如果不尝试一下创办自己的公司,以后肯定会后悔。 今天,杨植麟团队做核心算法研究的同学,平均年龄只有20多岁,很多人还没有毕业,就已经做出了世界前沿的模型和架构改进。AI领域变化极快,几乎每个月都有新模型出现,这需要年轻人去适应。 杨植麟坚信,未来10到20年的AI发展浪潮中,年轻人将成为最主要的驱动力。很重要的一个点是持续学习,不断摸索模型最新的边界在哪里。 谈到价值观时,杨植麟希望月之暗面能成为一家结合OpenAI技术理想主义和字节所展现的商业化哲学观的公司——完全不关心商业价值,你很难真的做出一个伟大的产品;但只有商业没有理想,也走不到AGI。 AI会如何影响普通人的生活? 大概率会让生活变得更好,有更多的人不需要为了钱去工作,可以去发挥创造力,做更多有创造性的事情。这个世界上有很多重复的工作,可以被AI直接抽象掉;AI也在一定程度上普惠化,让更多人用上最前沿的能力。 AGI和产品对杨植麟来说不是手段和目的的关系,两个都是目的——一个不足够关心用户的公司,最终可能也没法实现AGI。 创业者最大的陷阱不是失败,是所有人都觉得你赢了。 这一行没有永远的王座,只有下一场还没开始的战争。杨植麟一直在爬那座雪山,不知道尽头在哪里——而这正是他认为最有意思的地方。 
合作咨询请联系金砖财经团队 
做AI公司,最难的是什么?
坚持一件简单的事——持续训练更大的模型,用更多的数据、更多的参数、更多的算力去训练。这个领域最重要的规律,是规模化定律,可以认为是AI的第一性原理。
01/
规模化定律:AI的第一性原理
02/
Token效率:让每一度智能更密
03/
深度推理与智能体集群:从"记住"到"解决"
04/
开源:把武器送给对手
05/
至暗时刻与那座雪山
一是彻底放弃C端流量内卷的打法,all in基座模型研发——前一年烧了7亿多换来的流量优势,被杨植麟亲手砍掉; 二是在DeepSeek抢占深度思考制高点之后,杨植麟去抢占Agent的制高点,成为国内最接近Anthropic技术范式的玩家之一。
06/
年轻人与探索未知
07/
技术理想主义与商业哲学观
·END·
梅兰芳文化会客厅·外滩T3空间,是大更新时代由金砖财经发起,联合梅兰芳文化研究院等多家机构共同打造的场景化交易平台。金砖财经将十余年的品牌积淀汇聚于此,聚焦“资本、资产、梅兰芳IP及创意运营”三大领域,提供“场景+流量+工具”价值服务。