ARTICLE · 1108331
同一个错连犯 4 夜:NAS 上 AI 助手的事故记录本
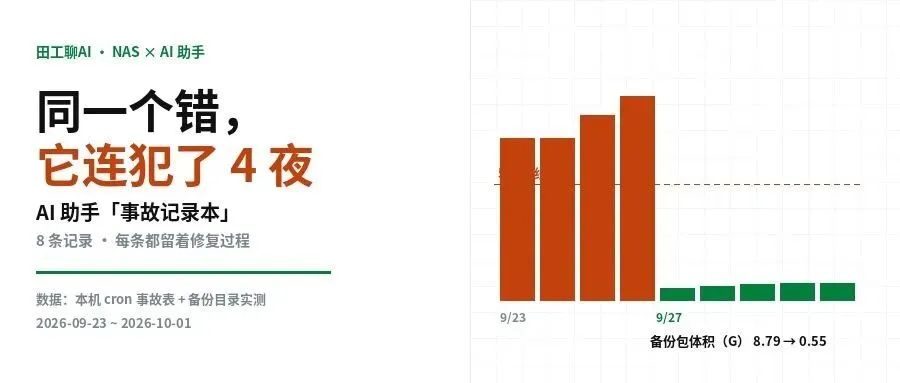
封面:8.79 G → 0.55 G。同一件事,我让它连报了 4 夜
先说一个我这两个月最有体会的结论:自动化真正危险的地方,不是它会出错,而是它出错的时候,没人知道。
这不是道理,是我自己账上的事。我在这台 NAS 上养着一个 AI 助手,它每天替我在固定时间干活。为了知道我有没有被它坑,我给它记了一本账 —— 每一次失败都单独留一条记录,带时间、带任务名、带错误原文、带输出文件的位置。
截至今天早上,这本账上是 8 条。其中 4 条,是同一个错误在连着 4 个夜里重复报。今天不写它多能干,就翻这本账给你看。
9 月 23 日 03:40:第一条报警来了
凌晨 3 点半,一个每天跑的定时备份任务启动了。40 分钟后它报错退出,我收到的是这么一句:
⚠️ 备份异常膨胀:data-20260923-033045.tar.gz = 7G(红线 5G)
红线是我自己设的,5 G。它是这么想的:一个只装配置、技能、记忆、会话和状态库的备份包,正常就该是几百兆;一旦超过 5 G,说明有不该进去的东西混进去了,先报警再说。
报警里还顺手附了「data 目录下最大的 5 项」,帮我定位:工作区 9.5 G、运行时环境 6.6 G、岗位配置 1.7 G、工具目录 540 M、状态库 301 M。看到这个我当时就知道问题不在备份坏了,而在我的排除清单写得太松。
9/24、9/25、9/26:同一个错,连报 4 夜
接下来的三天夜里,同一条任务、同一个 job_id,又报了三次。体积分别是 7 G、8 G、8 G。事故账上多了三行,内容几乎一模一样。
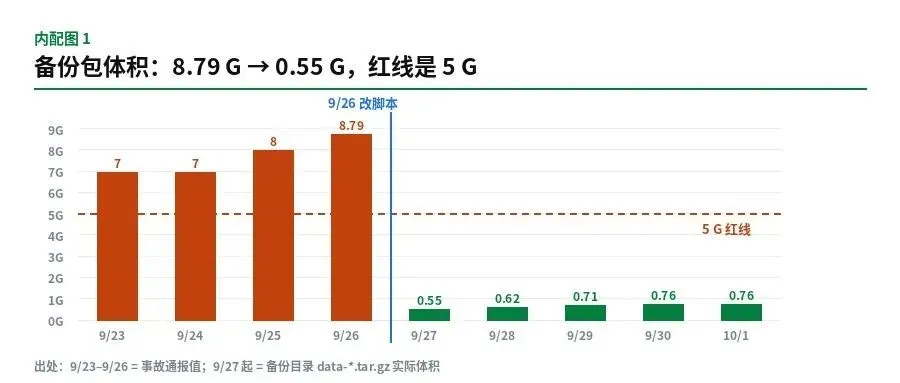
9/23–9/26 是报警通报值;9/27 起是备份目录里实际文件的体积。9/26 下午改完脚本,第二天夜里就掉到了 0.55 G
这里我要老实承认一件事:报警发出来了 4 次,前三次我只是「知道了」,没有去查。账本记下了这件事——同一个错误在账上留了 4 行,不是因为问题复杂,是因为有人在拖。
9/26 14:40:把两个真因挖出来
真正动手查的那天下午,我挖出来的是两个问题,而且第二个才是连报 4 夜的元凶。
第一个真因:体积——我把不该备份的东西也备份了。
这个毛病 9 月 20 日就犯过一次:模型文件和虚拟环境曾把快照从 1.8 G 顶到 20 G,当时加了一批排除。9 月 26 日又加了一批,原则重新定死一句话:只备份「重装之后下载不回来」的东西——配置、技能、记忆、知识库、会话、状态库。至于工作区素材、下载目录、渲染中间件、运行时、成片,全部排掉,因为这些东西要么能重新下载,要么早就单独交付到别的地方了。
第二个真因:报错被我自己丢掉了。
原脚本里,tar 的错误输出被重定向到了 /dev/null —— 也就是扔进黑洞。结果就是:脚本退出码非零,报警也发了,但「到底为什么失败」在日志里查不到。这才是它连报 4 夜还敢再来一次的原因。
真相是一行权限问题:监控服务留下的字节码缓存目录权限不对,tar 读到它返回 2,整次备份就被判失败。报错不看一眼,就永远只能看到一个「失败」。
那次改动一共动了三处,我把它们列出来,因为这三处才是下面所有内容的起点:
改完当天手工重跑了一次:8.79 G → 0.55 G,缩到大约十六分之一。
9/27 起连续 5 夜没再响
从 9 月 27 日开始,这条任务的输出文件状态变成了「silent」——意思是它跑了、一切正常、没什么要说的(这个任务的设计是没事不吭声,有事才喊)。五天分别是 0.55、0.62、0.71、0.76、0.76 G,全都远在 5 G 红线下面。
但我记住的不是「修好了」这三个字,而是那个下午翻出来的一句话:先让失败留下原因,再谈修不修得掉。
9/29 23:30:这一次失败,谁都没收到
就在我以为这条线已经顺了的时候,账本上又多了新的一行,而且这一行才是整本账里最该警惕的:Script not found: scripts/media_index_night.sh
任务到点了,去执行指定的脚本,发现脚本不在那个路径上。这行记录的「状态」字段不是「已报警」,而是「仅检测到」——因为这条任务的投递目标是本机:它会失败、会记账,但不会通知任何人。半夜挂掉的活,就这么安静地躺在那里。
第二天夜里它跑通了,状态是正常的静默输出。也就是说:这类失败,你不主动翻账,就一辈子不会知道。
9/30 17:30 和 21:00:任务建了,脚本没写
同一天下午和晚上,两条「提醒任务」也各留了一行失败:到点去执行,脚本不存在。这两条是我当时临时建的一次性提醒任务——任务记录先建好了,脚本却根本没落下。该提醒的时候没人提醒,那个时间点的数据就是没拿到,补不回来。
这两条任务现在已经停用了。但它们贡献了一条我认为最实用的纪律:建任务和写脚本不是一件事,得把顺序反过来——脚本先在盘上,任务后建;建完立刻干跑一次,看到它真的跑出结果,才算建完。
9/28 10:35:唯一一条「报了错、当晚就重写」的
还有一条是数据提醒任务的脚本自己返回了非零。它的处理速度反而是账本里最快的:当晚 22 点多把脚本重写了一遍。这条没什么戏剧性,但它和上面几条放在一起,正好凑出这本账的三类成因。
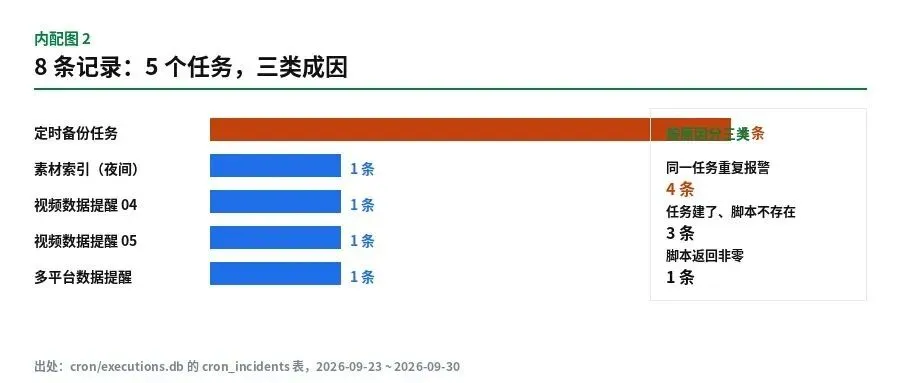
8 条记录,5 个任务,三类成因。最多的一类不是「代码难」,是「同一个错没被追」
这本账是怎么记的
说清楚它不是什么,比说清楚它是什么更重要:它不是一个很聪明的系统,没有模型在分析我的故障。它只是两个数据库表加一条纪律。
有意思的是「首次出现」和「最近出现」这两个字段。同一件事连报 4 夜的时候,账本上是 4 行独立的记录,而不是 1 行被覆盖——它不会帮你把事情「合并掉」,所以赖不掉。
顺手说一句现在的运行量:这台机器上挂着 37 个定时任务,其中 10 个是「看护型」的(盯着服务在不在、数据有没有正常同步)。前几天我统计过一个不到 10 小时的时间窗,执行记录是 1001 条、失败 0 条——看起来一切正常,而这些正常里本来就该包含「能证明它正常」的东西。
三条跟机器无关的教训
写到这儿,我发现这三条换任何一台机器、任何一套自动化都成立,跟用不用 AI 没关系:
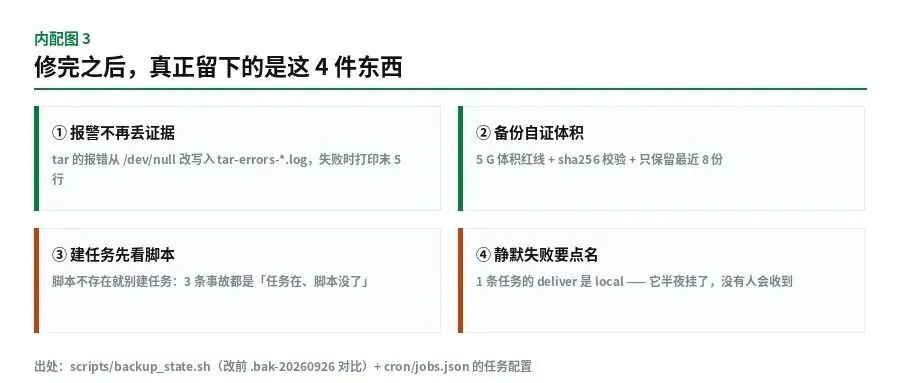
修完之后真正留下的四件东西:留证据、设红线、先脚本后任务、静默失败要点名
它救不了什么(这节也留着)
账本记得再清楚,也有它做不到的事,我把边界写下来:
想给自己的机器也弄一本,三步就够
不用 AI、不用数据库专家,如果你手上也有一台 24 小时开着的机器在跑定时任务,按这三步来:
一句话总结
自动化跑得越久,这本故障账越值钱 —— 因为它记的不是你多能干,是你曾经在哪摔过、以及同一处有没有摔第二次。
我把它放在那儿,不是为了有一天证明它从没出过错,而是为了下次再出事的时候,我能三十秒内答上来:什么任务、几点、为什么、修没修。
👆 关注「田工聊AI」——工程人用 AI 的真实经验:真机实测、真实价格、真踩过的坑。