ARTICLE · 1115730
5python之pdf文件解析
写在前面的话
挺着吧。昨天去密云送媳妇孩子,让老妈清静清静。先是去安河桥北地铁站接上媳妇小姨及表妹,再去密云,堵车,两个多小时到,到了之后,吃点饭就去捡栗子,直到晚上七八点回到家。回来之后,还没吃口饭,老妈又开始了,说:七十多了还受你媳妇的气,紧接着就是历数九年来带孩子的辛苦,再者就是买房子带你舅的钱,你还要,一点面子不给我,你这些年挣的钱呢,买不起房子别买啊。我忍不住说:我舅比我大吧,他这些年挣的钱呢,要一万块钱都没有。老妈说:你舅家孩子上学不花钱吗,吃喝,穿衣啥都是贵的,他光挣不花呀。我说:对呀,各家有各家难,我两个孩子,还要还房贷,他们也上学,也穿衣,是不是也要花钱,再者我就是问一下,有就有,没有先欠着。老妈接着又拉回和媳妇的冲突上面,一说很长时间,各种脏话。我说妈你看电视吧,我不吃了,我去休息一下。老妈说不愿意我在这,我回去,我这辈子不来了,说好的打你媳妇一顿,给我出气,出的呢,娶个媳妇卖个儿,一点都不假。老人上年纪了,糊涂了,享受了老人带孩子的辛苦付出,现在糊涂了,就要有更多的包容,挺着吧。
[90+200]-------底部有张生活照片
关键词:python、ragflow、解析代码、关注进度
一、pdf文件解析(三级)
描述:现在解析过程中遇到一个错误,需要处理一下。现在处理的方式是逐行解析代码,马上也解析完了,继续吧。
开工:
第一步:解析代码(四级)
20250810周日时间段:14:36-16:00先看一段,如下:
    chunking_config = DocumentService.get_chunking_config(doc["id"])
    for task in parse_task_array:
        hasher = xxhash.xxh64()
        for field in sorted(chunking_config.keys()):
            if field == "parser_config":
                for k in ["raptor", "graphrag"]:
                    if k in chunking_config[field]:
                        del chunking_config[field][k]
            hasher.update(str(chunking_config[field]).encode("utf-8"))
        for field in ["doc_id", "from_page", "to_page"]:
            hasher.update(str(task.get(field, "")).encode("utf-8"))
        task_digest = hasher.hexdigest()
        task["digest"] = task_digest
        task["progress"] = 0.0
注:parse_task_array,如下:
[{
'id': '74e7555875b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 0,
'to_page': 12
}, {
'id': '75875bde75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 12,
'to_page': 24
}, {
'id': '7633b6ea75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 24,
'to_page': 36
}, {
'id': '76b7928a75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 36,
'to_page': 48
}, {
'id': '77178b5475b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 48,
'to_page': 60
}, {
'id': '777a220075b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 60,
'to_page': 72
}, {
'id': '7809e6a675b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 72,
'to_page': 84
}, {
'id': '78b2689e75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 84,
'to_page': 96
}, {
'id': '79f4b95075b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 96,
'to_page': 108
}, {
'id': '7affa43675b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 108,
'to_page': 120
}, {
'id': '7bbd3a2875b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 120,
'to_page': 132
}, {
'id': '7c92f51475b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 132,
'to_page': 144
}, {
'id': '7d79041e75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 144,
'to_page': 156
}, {
'id': '7e60745c75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 156,
'to_page': 168
}, {
'id': '7f276f4475b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 168,
'to_page': 180
}, {
'id': '7fceeb0c75b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 180,
'to_page': 192
}, {
'id': '806ece7475b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 192,
'to_page': 204
}, {
'id': '811b6d7875b111f081b62fc8c7ee96d4',
'doc_id': 'fc6719a6738011f080ce0242ac140006',
'progress': 0.0,
'from_page': 204,
'to_page': 213
}]
注:代码解析截图如下:
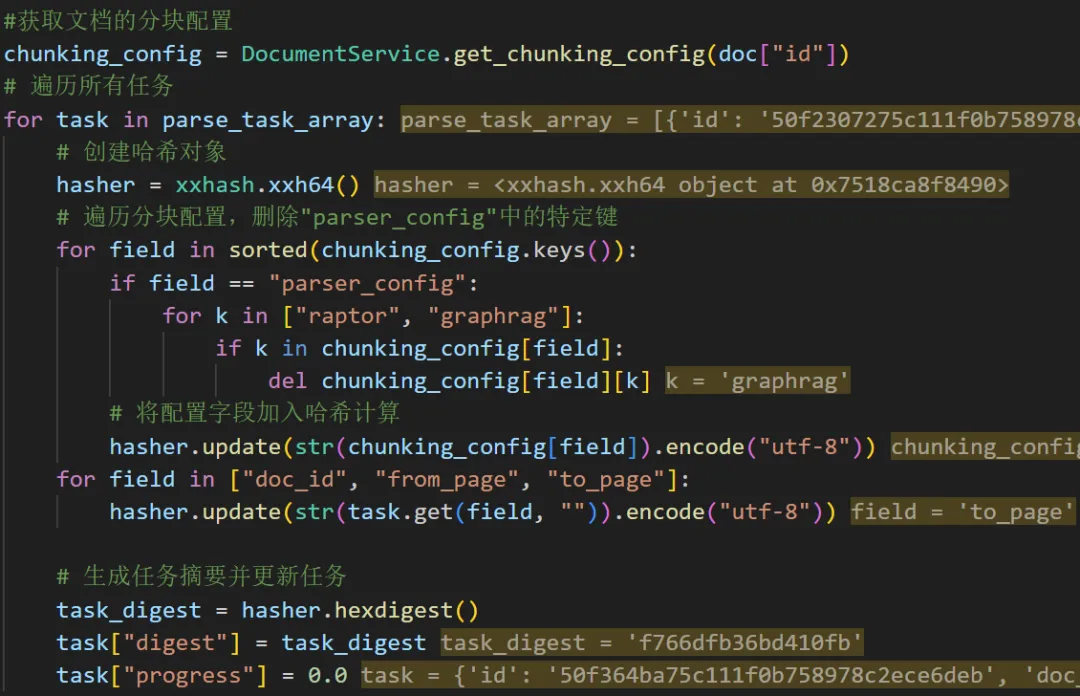
图5a-1
注:接着往下看。
第二步:任务存库(四级)
20250810周日时间段:16:19-17:00看一段代码,如下:
    prev_tasks = TaskService.get_tasks(doc["id"])
    ck_num = 0
    if prev_tasks:
        for task in parse_task_array:
            ck_num += reuse_prev_task_chunks(task, prev_tasks, chunking_config)
        TaskService.filter_delete([Task.doc_id == doc["id"]])
        chunk_ids = []
        for task in prev_tasks:
            if task["chunk_ids"]:
                chunk_ids.extend(task["chunk_ids"].split())
        if chunk_ids:
            settings.docStoreConn.delete({"id": chunk_ids}, search.index_name(chunking_config["tenant_id"]),
                                         chunking_config["kb_id"])
    DocumentService.update_by_id(doc["id"], {"chunk_num": ck_num})
注:注释截图如下:
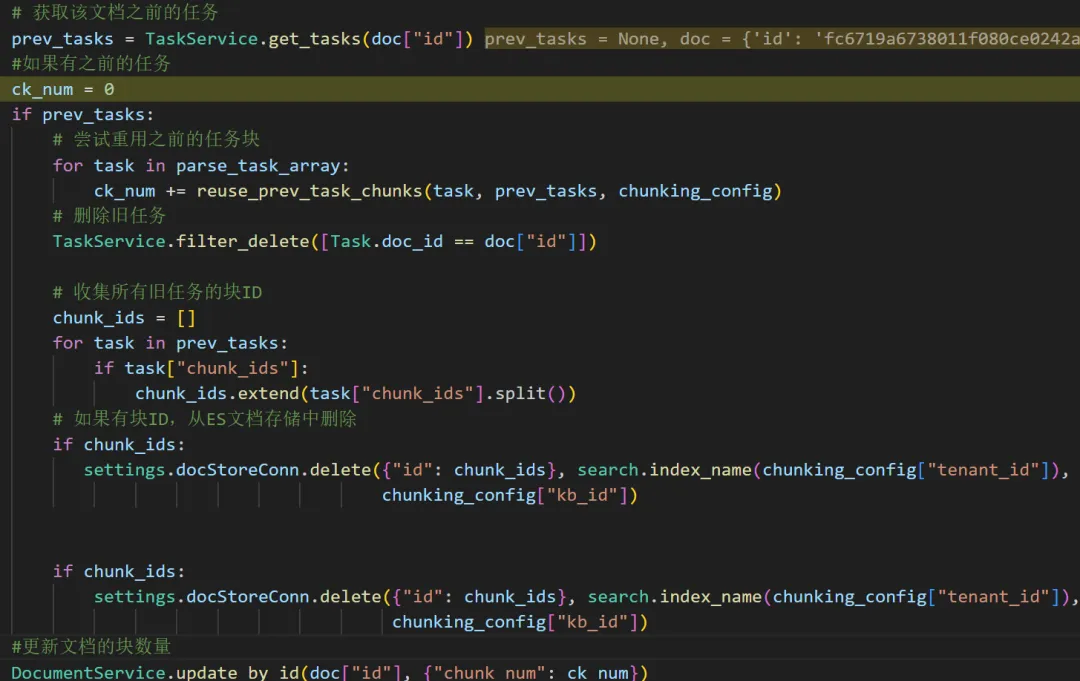
图5a-2
注:这个主要是处理解析文档之前的解析,如果存在就接着解析,类似断点续传。
接着,再看一段,如下:
bulk_insert_into_db(Task, parse_task_array, True)
DocumentService.begin2parse(doc["id"])
unfinished_task_array = [task for task in parse_task_array if task["progress"] < 1.0]
for unfinished_task in unfinished_task_array:
assert REDIS_CONN.queue_product(
SVR_QUEUE_NAME, message=unfinished_task
), "Can't access Redis. Please check the Redis' status."
注:逐行解析版本,截图如下:
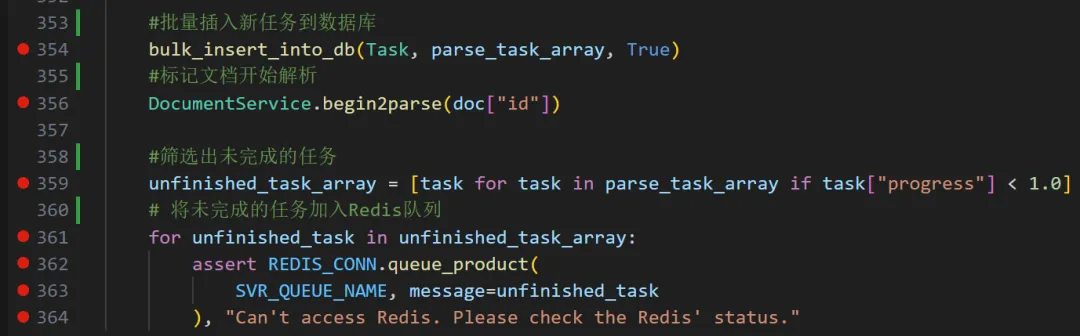
图5a-3
注:把未完成的任务插到redis中,接下来,看下那个错误列表是从哪里来的。
第三步:错误列表(四级)
20250810周日时间段:18:16-17:00现在解析报错,有个错误列表,看下是哪里出错了,写个测试用例吧,如下:
def test_run(client,login_header):
"""
测试文件解析
"""
json_data = {
"doc_ids": ["f22dfe844c0511f0861b6a7693be1e5d"],
"run": 1,
"delete": True
}
response = client.post("/v1/document/run",
json=json_data,
headers={
**login_header
})
assert response.status_code == 200
# json = response.json()
#assert json['code'] == 0
print(f"response:{response}")
# print(f"response.data:{response.data}")
json = response.json
print(f"json:{json}")
# assert json['code'] == 0
注:换一下doc_ids,运行一下,看看效果,如下:
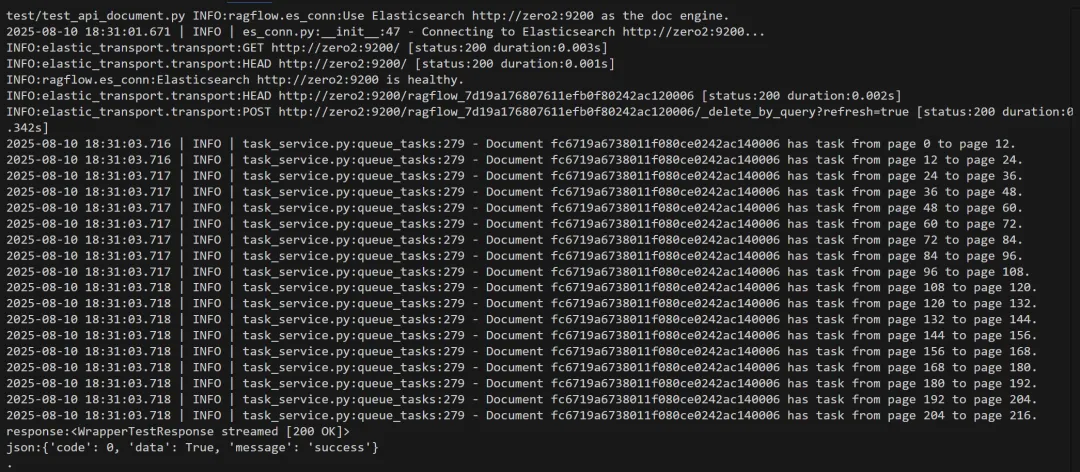
图5a-4
注:任务建成了,看下这18个小任务都解析成功没,先查下表。结果如下:
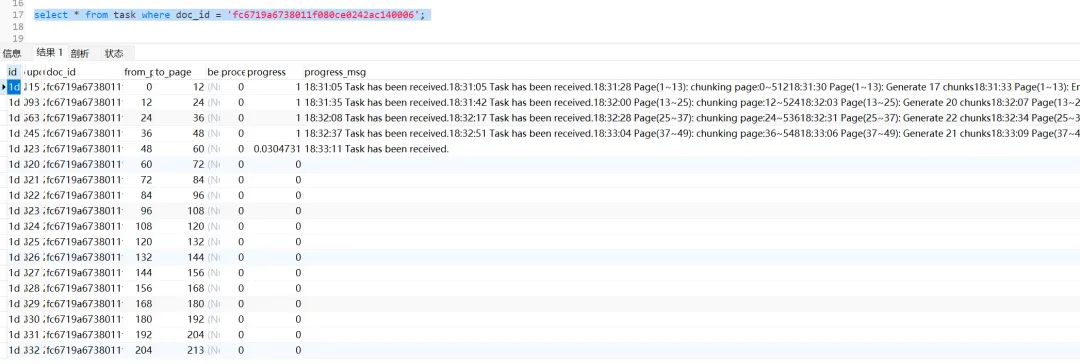
图5a-5
注:从截图来看,已解析成功四个,还有14个,关注下这个列表,看哪里出错了。
第四步:关注进度(四级)
20250810周日时间段:18:38-19:00看一个完成的,日志如下:
18:35:22 Task has been received.
18:35:46 Page(97~109): chunking page:96~608
18:35:50 Page(97~109): Generate 26 chunks
18:35:50 Task has been received.
18:35:53 Page(97~109): Embedding chunks (3.45s)
18:35:56 Page(97~109): Done (2.60s)
18:36:16 Page(97~109): chunking page:96~608
18:36:19 Page(97~109): Generate 26 chunks
18:36:22 Page(97~109): Embedding chunks (3.58s)
18:36:24 Page(97~109): Done (1.53s)
注:我在想,以上的日志是哪里打印出来的,在代码里搜索一下。找到了,代码如下:
def reuse_prev_task_chunks(task: dict, prev_tasks: list[dict], chunking_config: dict):
    idx = 0
    while idx < len(prev_tasks):
        prev_task = prev_tasks[idx]
        if prev_task.get("from_page", 0) == task.get("from_page", 0) \
                and prev_task.get("digest", 0) == task.get("digest", ""):
            break
        idx += 1
if idx >= len(prev_tasks):
return 0
prev_task = prev_tasks[idx]
if prev_task["progress"] < 1.0 or not prev_task["chunk_ids"]:
return 0
task["chunk_ids"] = prev_task["chunk_ids"]
task["progress"] = 1.0
if "from_page" in task and "to_page" in task and int(task['to_page']) - int(task['from_page']) >= 10 ** 6:
task["progress_msg"] = f"Page({task['from_page']}~{task['to_page']}): "
else:
task["progress_msg"] = ""
task["progress_msg"] = " ".join(
[datetime.now().strftime("%H:%M:%S"), task["progress_msg"], "Reused previous task's chunks."])
prev_task["chunk_ids"] = ""
return len(task["chunk_ids"].split())
注:看一个报错的解析,如下:
18:39:07 Task has been received.
18:39:28 Task has been received.
18:39:32 Page(181~193): chunking page:180~692
18:39:35 Page(181~193): Generate 14 chunks
18:39:38 Page(181~193): Embedding chunks (3.16s)
18:39:39 Page(181~193): Done (1.07s)
18:39:58 Page(181~193): chunking page:180~692
18:40:00 Page(181~193): Generate 14 chunks
18:40:03 Page(181~193): Embedding chunks (3.15s)
18:40:05 Page(181~193): Done (1.42s)
18:39:40 Task has been received.
18:40:01 Page(193~205): chunking page:192~704
18:40:03 Page(193~205): Generate 12 chunks
18:40:06 Task has been received.
18:40:07 Page(193~205): Embedding chunks (3.50s)
18:40:08 Page(193~205): Done (1.20s)
18:40:34 Page(193~205): chunking page:192~704 [Canceled]
18:40:34 [ERROR]handle_task got TaskCanceledException [Canceled]
18:40:25 Start Graph Extraction
18:40:25 Task has been received.
18:40:27 [ERROR]Fail to bind LLM used by Knowledge Graph: invalid literal for int() with base 10: ''
18:40:27 [ERROR][Exception]: invalid literal for int() with base 10: ''
注:页数193-205,看着没啥问题啊,接下来,分析下解析程序。
第五步:分析解析程序(四级)
20250810周日时间段:19:16-21:00先看一段代码,如下:
idx = 0
while idx < len(prev_tasks):
prev_task = prev_tasks[idx]
if prev_task.get("from_page", 0) == task.get("from_page", 0) \
and prev_task.get("digest", 0) == task.get("digest", ""):
break
idx += 1
注:看了一下,逐行解析如下:
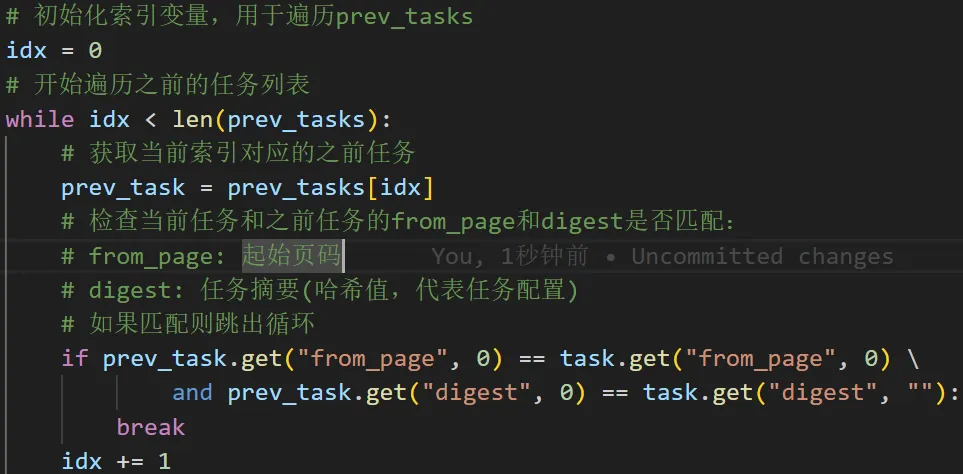
图5a-6
注:接下来,再看一段,如下:
if idx >= len(prev_tasks):
return 0
prev_task = prev_tasks[idx]
if prev_task["progress"] < 1.0 or not prev_task["chunk_ids"]:
return 0
task["chunk_ids"] = prev_task["chunk_ids"]
task["progress"] = 1.0
if "from_page" in task and "to_page" in task and int(task['to_page']) - int(task['from_page']) >= 10 ** 6:
task["progress_msg"] = f"Page_qhz({task['from_page']}~{task['to_page']}): "
else:
task["progress_msg"] = ""
task["progress_msg"] = " ".join(
[datetime.now().strftime("%H:%M:%S"), task["progress_msg"], "Reused previous task's chunks."])
prev_task["chunk_ids"] = ""
return len(task["chunk_ids"].split())
注:逐行解释,截图如下:
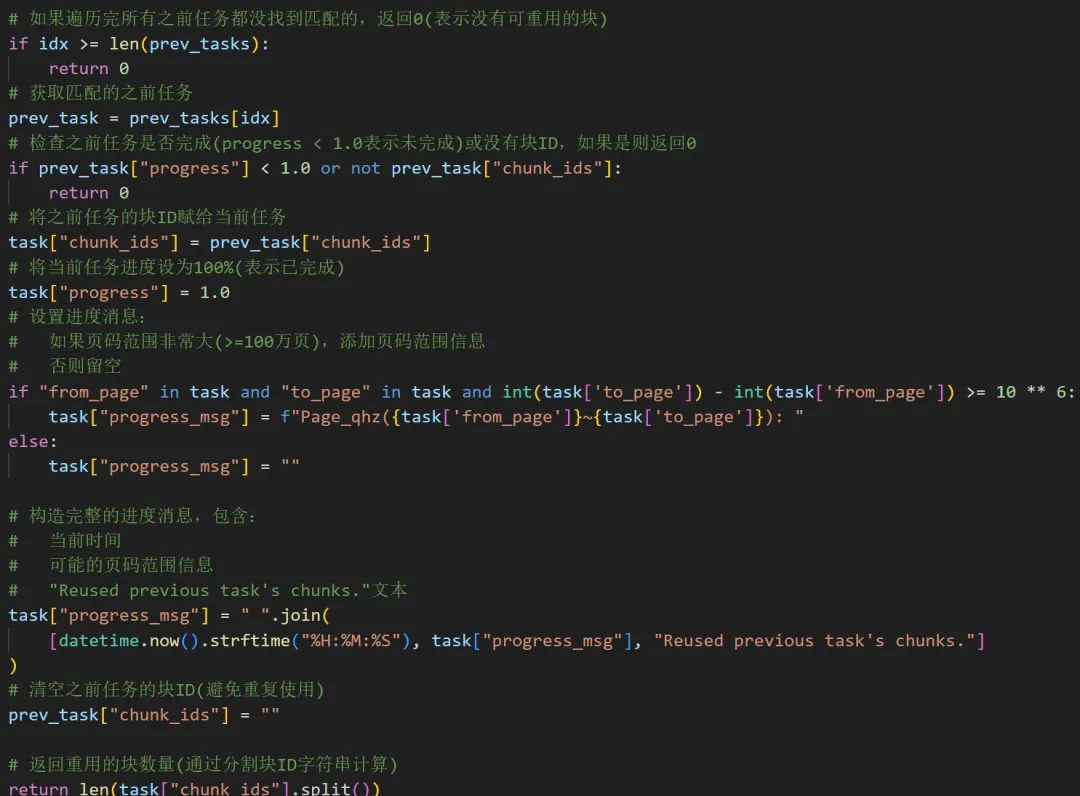
图5a-7
注:这个主要是重用的chunks,总结如下:
这个函数的核心逻辑是:
在当前任务的之前任务列表中,寻找配置和页码范围都匹配的已完成任务
如果找到,则重用其文本块(chunks),避免重复处理
返回重用的块数量,如果没有可重用的则返回0
二、生活照片
拍摄于2021年4月19日,16:50:51,给大宝拍的写真照,当时大宝三岁四个月。和老人是没啥道理可讲的,仔细分析老妈的话,各种漏洞,老妈七十多了,就像一台电脑运行七十多年,有问题是正常的,一台七十多年的电脑,可能就淘汰了,但老妈不是电脑,是我的人生来处,我需要更多的包容与关心,骂就骂吧,闹就闹吧,但我不会按她的指令来。之前劝她时,确实说过,妈,你别生气,你和她吵架,都怪她,哪天我打她一顿,给您出出气。老妈当真了,总记着这事,但时代变了,上一代,孩子不好好学,卡卡揍,和媳妇吵架了,能动手绝不动嘴。但现在呢?孩子以教育为主,媳妇以讲道理为主,并且这次也不怨媳妇,老妈气冲冲的质问媳妇,为啥买房不叫我,自己做主。媳妇说:我们俩的事,你就别管了。接着话越说越多,就吵起来了。如果像老妈说的,我出手胖揍一顿,离婚分孩子,老妈回家带个孩子,孩子会幸福吗,老妈出气了,开心吗。之前,我一个表姐,在婆家受气了,表哥知道后,纠集一帮人,去表姐婆家,大打出手,给表姐出气。人家公婆都挨了打,男的直接离婚,孩子也不要了,这些年表姐一个人带孩子没少辛苦。所以,现在不是打架的时代了,老妈还是要尽量哄,日子还是要向前过。
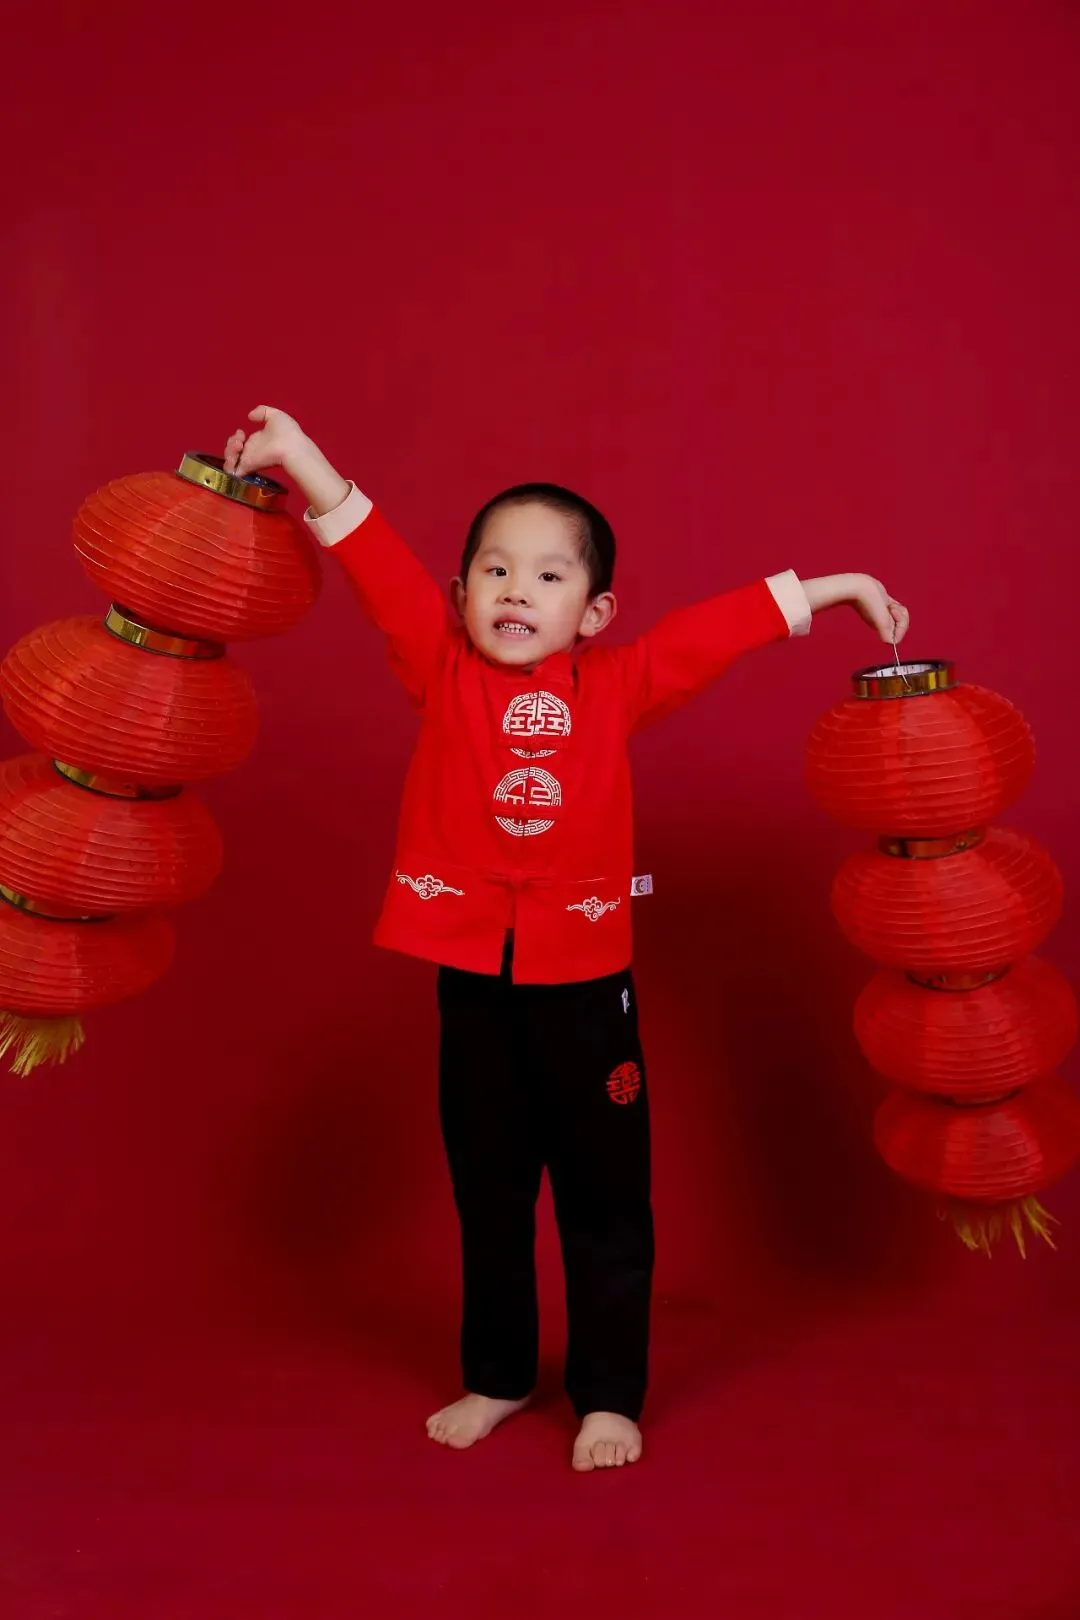
图5b-1
《本文完》