ARTICLE · 1116038
149k Stars!这个插件让 AI 编程助手偷懒,代码量直接砍半,token节省22%
架构文摘,每天分享一个实用开源项目
上周我让 Claude Code 给管理后台加个日期筛选。它的操作是:装 flatpickr,写一个 wrapper 组件,引一份样式表,再发来三百字分析——关于时区处理,我建议……。我一个日期输入框,它给我上了个工程。
这个场景每个用 AI 辅助写代码的人都不陌生:agent 不是不会写,是写太多。装没必要装的库、建没必要建的组件、讨论没必要讨论的时区。代码越写越多,review 精力被榨干,token 账单节节攀升。
刚好国庆放假有很多时间逛GitHub热榜,发现上面有个项目,把这件事做成了 methodology:让 agent 像团队里那位最懒的资深工程师一样思考你给他看五十行代码,他一句话不说,删掉四十九行,留下一行,能跑。
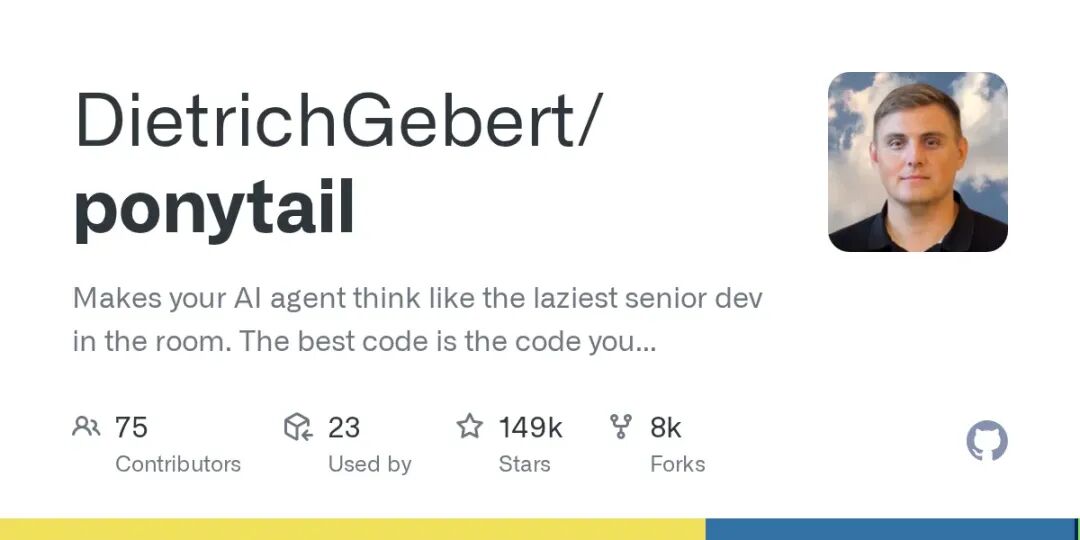
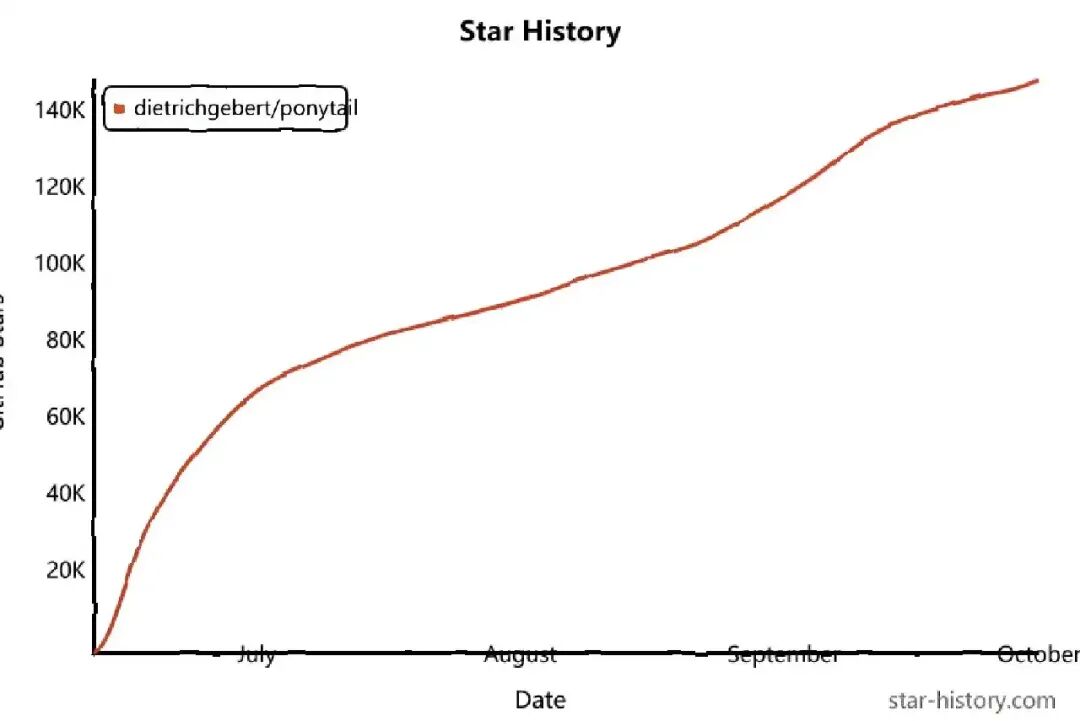
它叫 Ponytail。上线仅仅三个多月,Star 冲到 149,291,日均增长近一千六。
一句话定位
Ponytail 是给 AI coding agent 装的懒人开关:一套 skill + hooks + 命令集,把最懒资深工程师的决策方式写成 agent 可执行的规则——能不写的代码绝不写,能复用的绝不重写,能一行搞定的绝不拆三个文件。MIT 开源,JavaScript 实现,20 个主流 agent 通用。
和传统 prompt 技巧的区别在于:它不是一句请少写点代码,而是一条带优先级的决策阶梯 + 生命周期钩子,每轮对话强制注入,还配了同类里唯一一份诚实到自我打脸的 agentic benchmark。
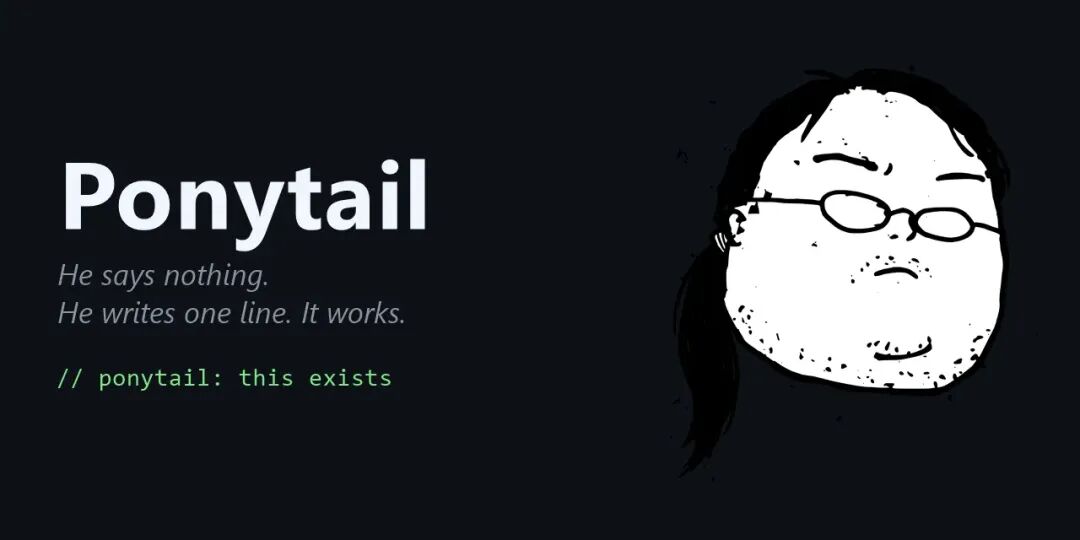
官方那张社交预览图把气质拿捏得很准:大佬沉默地立在右边,左边一行绿字注释——// ponytail: this exists。这就是整个项目的哲学:写代码之前,先问这个东西需不需要存在。
三大核心亮点
亮点 1:7 级阶梯——agent 版的能买就不造
写代码之前,agent 按这个顺序自问,停在头一个能撑住的梯级:
1. 这东西需要存在吗? → 不需要:跳过(YAGNI)2. 代码库里已经有了吗? → 有:复用,别重写3. 标准库能做吗? → 能:用标准库4. 平台原生特性呢? → 有:用原生特性5. 已装的依赖能做吗? → 能:用依赖6. 一行能搞定吗? → 能:就写一行7. 都不行 → 才写「能跑的最小实现」同样是日期选择器,走完阶梯的输出是:
<!-- ponytail: 浏览器原生就有 --><inputtype="date">从组件库工程到一行 HTML,这就是梯级的威力。关键在于顺序:先问要不要存在,再问要不要自己写——多数过度工程死在第 1 级,而多数重复造轮子死在第 2 级。
亮点 2:诚实 benchmark——真实 agent 改真实仓库,还自我打脸
这是它和同类 skill 拉开差距的地方。官方的测量方式是:真实 headless Claude Code 会话,编辑真实的开源仓库(tiangolo 的 full-stack-fastapi-template,FastAPI + React),12 个 feature 任务、每组跑 4 遍(n=4)、用 Haiku 4.5,对比无 skill 的基线 agent。
结果(vs 无 skill 基线):
| ponytail | -54% | ||||
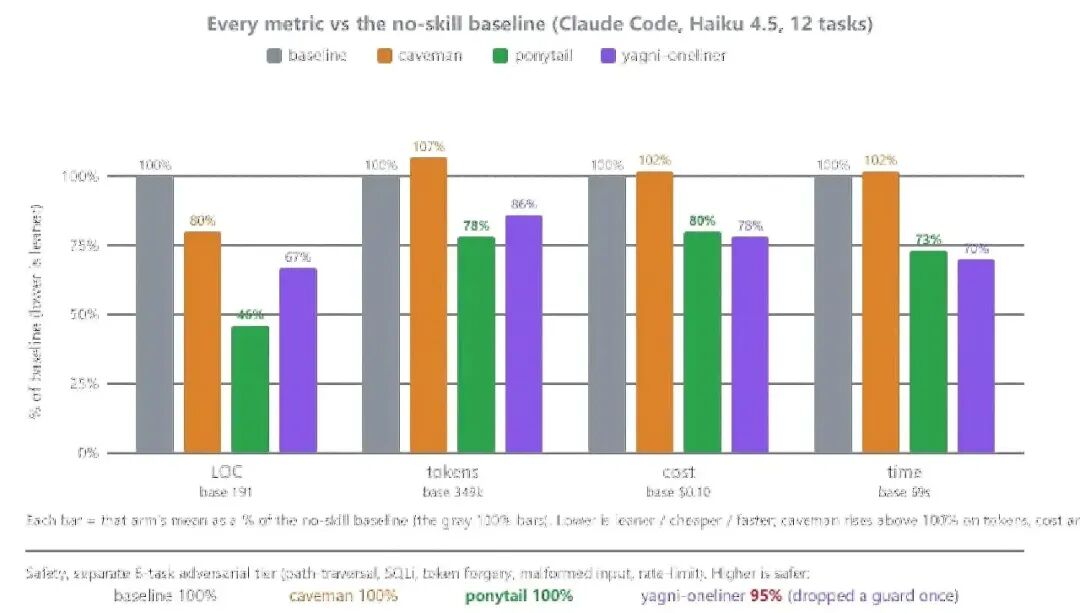
三个细节见功力:
-54% 是 12 个任务的平均值,在 agent 真正过度建设的场景(日期选择器)砍到 -94%,在代码本就精简的场景接近 0——它不是无脑删,是精准打在过度工程上。 对照组设计狠:裸的YAGNI+一行流prompt 也能砍代码省成本,但 6 项对抗安全任务(路径穿越、SQL 注入、token 伪造等)里掉了一次防护——一刀切地省,省掉的是安全。ponytail 是唯一每项指标全降 + 安全满分的组。 自我打脸:更早的 single-shot 基准曾宣传省 80-94% 代码,社区 issue #126 指出裸模型基线会用废话凑行数、口径不公平,官方直接把旧数据撤进折叠栏,标注那是单任务上限,不是平均值。
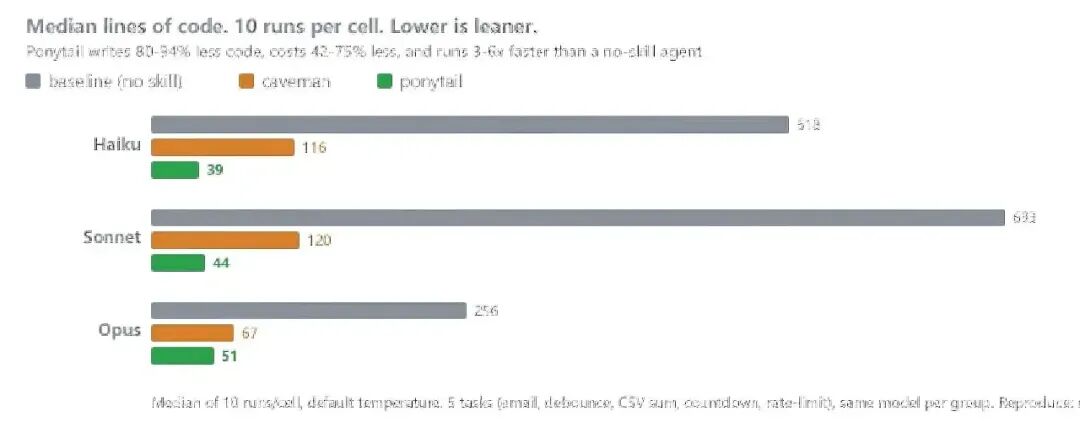
一个开源方法论项目,benchmark 真实、可复现(官方给了 promptfoo 配置)、被质疑后主动降口径——这在 skill 赛道里找不出第二个。
亮点 3:安全永不上砍减清单 + 20 个 agent 一套规则
阶梯是懒,但有底线:信任边界校验、数据丢失处理、安全、可访问性,永远不在砍减清单上。规则原文写得很清楚——代码变少是因为必要,不是因为golf。
接入面则是铺满式:Claude Code、Codex、GitHub Copilot CLI、Gemini/Antigravity CLI、OpenCode、Devin、Grok Build、Cursor(hooks)、Qoder、Hermes、CodeWhale、Swival、OpenClaw 等 20 个 agent 各有官方安装路径;连没插件机制的(Jules、Amp、JetBrains Junie)也能靠仓库自带的 AGENTS.md 指令模式兜底。一次方法论,全家 agent 受益。
为什么一句 prompt 干不成这件事
旧方案缺陷:prompt 是建议,不是机制
你大概试过在系统提示里写请遵循 YAGNI 原则,尽量少写代码。效果差的原因有三层:
单次注入:prompt 只在会话开头出现,长对话里权重被稀释; 无强制时机:模型知道该少写,但生成时没有一道关卡逼它先做存在性判断; 不可度量:你不知道这句话到底省了多少,全凭感觉。
Ponytail 的解法:skill 定规则 + hooks 卡时机
Ponytail 拆成三件套:
规则本体:把阶梯压成紧凑的规则文本,每轮注入到活跃上下文——不是会话开头一次性,是每轮都注入,且通过 Agent 工具派生的子 agent 也会继承(可以按 agent 类型做作用域排除,比如只读搜索型子 agent 可以豁免)。 生命周期钩子:Claude Code / Codex / Cursor 上以两个极小的 Node.js 钩子挂进会话生命周期,负责模式标记与注入,这是「每轮强制」能落地的机制保障。 命令集: /ponytail调四档强度(lite/full/ultra/off),/ponytail-review只审当前 diff 返回一份「可删清单」,/ponytail-audit扫全仓库,/ponytail-debt把你推迟的ponytail:标记收割成台账防止以后再说变成永远不做,/ponytail-gain直接展示基准记分板。
两个容易被忽略的设计判断
阶梯跑在理解之后。规则原文特意强调:agent 得先读这次改动涉及的代码、追一遍真实流程,再选梯级——懒的是产出,不是理解。这避免了为了少写而瞎删。 规则是只写任务需要的,不是最少 token。作者明说了副作用边界:在遵守阶梯的模型上,成本和延迟下降是副产品;但一个爱在思考 token 上纠结的 terse 推理模型,可能反向开销——README 点名 GPT-5.5 就是这个反例。这个诚实程度,同样罕见。
安装与配置
以 Claude Code 为例,官方原话:这是 Ponytail 一辈子会让你费的最大力气。
/plugin marketplace add DietrichGebert/ponytail/plugin install ponytail@ponytail注意两条命令要分两次发送,一条装不上。装完即可用,无需任何配置文件。
其他主力 agent:
# Codexcodex plugin marketplace add DietrichGebert/ponytailcodex plugin add ponytail@ponytail# GitHub Copilot CLIcopilot plugin marketplace add DietrichGebert/ponytailcopilot plugin install ponytail@ponytail# OpenCode:opencode.json 里加一行{ "plugin": ["@dietrichgebert/ponytail"] }前置条件只有一个:node 必须在 PATH 上(插件要跑两个 Node 生命周期钩子;Nix/nvm 用户注意要在宿主 shell 里可见)。
常用操作三件套:
/ponytail ultra——官方注释:当代码库个人恩怨式地得罪了你(全仓库极限砍减);/ponytail-review——review 当前 diff,拿回一份可删清单;PONYTAIL_DEFAULT_MODE=full环境变量或~/.config/ponytail/config.json设默认档。
卸载也干净:/plugin remove ponytail 一条命令(模式标记文件会留一个小状态,README 坦白了路径)。
团队落地方案
1. 团队改造思路
把 Ponytail 当团队级的代码产出约束层接入,而不是个人玩具:规则统一(全员同一套阶梯)、强度分级(新库用 full、遗留系统用 lite)、边界明确(安全与可访问性清单不动)。适配场景是团队已普遍使用 Claude Code / Codex 等 agent 写业务代码、且被「agent 产出膨胀」拖慢 review 的现状。
2. 部署方案
三种层级按需选:插件级(Claude Code / Codex / Copilot CLI 全员装插件,团队自动同版本);规则级(把仓库 AGENTS.md 复制进各项目根目录,零插件依赖,Windsurf / Cline / Qoder 等自动读取);配置级(PONYTAIL_DEFAULT_MODE 或全局 config.json 统一默认档)。建议:插件级为主、AGENTS.md 兜底,保证没有 agent 被规则漏掉。
3. 业务系统集成
把命令塞进既有流程:MR/PR 阶段跑 /ponytail-review,把可删清单贴进 review 评论,专治 agent 产出膨胀;里程碑节点跑 /ponytail-audit 清理全仓库历史过度工程;/ponytail-debt 的台账接进迭代会,让「推迟项」有去处。基准可复现(官方提供 promptfoo 配置和 benchmarks/results 全量数据),有条件的团队可以用自己的仓库复测一轮再定强度档。
4. 团队规范定制
规则文本是紧凑的纯文本 skill,可以直接在其上叠加团队规范:把安全与可访问性永不上砍减清单扩展成团队自己的不可砍清单(如鉴权中间件、审计日志);按子 agent 类型配置规则作用域(只读检索型 agent 豁免,写码型 agent 全量注入);对外交付项目可锁定 lite 档,内部工具放开 full/ultra。
真实适用场景
agent 过度工程受害者:日报里的date picker 事件高频复现者,装上先救 review 精力; token 成本敏感的团队:-22% token、-20% 成本在大规模 agent 使用下是实打实的账单减免; 遗留系统维护:老代码库最怕 agent 重写轮子,第 2 级代码库已有→复用就是为它设计的; AI 工程化团队:想要一个可度量、可复现、可审计的产出约束方案,而不是口头约定。
不适合的也说清楚:从零手写核心算法、需要大量新建文件的绿地项目,阶梯的收益会小很多——它治写太多,不治不会写。
优缺点与避坑
核心优势:方法论可执行、同类唯一诚实 agentic benchmark(真实仓库 + n=4 + 可复现 + 被质疑后主动降口径)、安全边界清晰、MIT 零成本、20 agent 覆盖。
局限:
本质是 prompt/skill 方法论,效果依赖模型遵守度。README 自述 terse 推理模型会在思考 token 上反向开销,GPT-5.5 实测成本反而上升——换模型要重测; 少写有业务边界:复杂业务逻辑被阶梯误伤的风险存在, /ponytail-review的删清单必须人工过目,不能闭眼采纳;更新节奏放缓:最近提交停在 2026-09-14,issue 区 open_issues 319,响应速度需观察; 同赛道拥挤:与 superpowers、ECC、i-have-adhd、caveman 同属 skill 方法论赛道,同质化明显(README 倒是很直白:与 caveman 正交——一个管说、一个管写,可以叠加用)。
落地避坑:
别在 GPT-5.5 上默认开:思考 token 反向开销,先跑 /ponytail-gain看自家模型实测;复杂业务先人工复核删清单:阶梯砍的是模板式过度建设,业务特有逻辑的判断仍是人; Node 不在 PATH 会静默失效:Nix/nvm 环境装完先验证钩子真的挂上了; ultra 档别用于对外项目:极限砍减适合内部工具,交付项目锁 lite。
最后说几句
AI 写代码的下一步竞争力,可能不在让模型更能写,而在让它更克制。Ponytail 把老工程师那句你写下的每一行代码都是负债做成了机器可执行的阶梯,还配了份敢自我打脸的标准——149k Star 投的其实就是这个票。
开源地址:
https://github.com/DietrichGebert/ponytail
关注【架构文摘】,每天分享一个实用开源项目
本号持续更新实用有趣的开源项目。如果你不想逐篇翻阅往期文章,可以直接关注公众号【架构文摘】,在后台留言与号主互动交流。
如有收获,点个赞+转发+推荐,诚挚感谢