ARTICLE · 1116486
AI Agent 到底是什么?先看懂它怎么完成一件事
让 AI 帮忙算一份收入报表,它可以给你计算方法,也可以读取数据、查询汇率、调用计算工具,最后把结果交回来。
同样是“帮我算一下”,这两种处理方式,差别在哪里?
理解 AI Agent,我觉得先把这件事讲清楚,比记住一堆框架名字更有用:接到任务以后,谁决定下一步,谁真正执行,执行结果又交给谁?
01
先把 Agent 的三个部分分清楚
理解现代大模型 Agent,可以先用这个公式:
Agent = LLM + 上下文 + 工具。
LLM 就是大语言模型,负责理解任务、作出判断。例如收入表里有美元、欧元和英镑,模型需要判断:这些金额要先统一币种,才能相加。
但模型需要知道各季度收入,也需要知道有哪些工具能用。这些决策时可见的信息,就是上下文。
查询汇率、执行计算,则需要工具来完成。模型生成调用请求,外围程序执行工具,再把结果交回来。
用一个简单的类比:模型像大脑,上下文像眼睛,工具像手脚。这个类比帮助咱们记住分工,具体实现还是要看各部分之间怎么传递信息。
尤其要分清,模型决定调用工具,和工具真正执行,是两件事。
模型可以提出“查询欧元兑美元汇率”的请求,真正去访问数据源的是工具。让模型学会使用工具,也不等于把汇率查询服务装进了模型里。
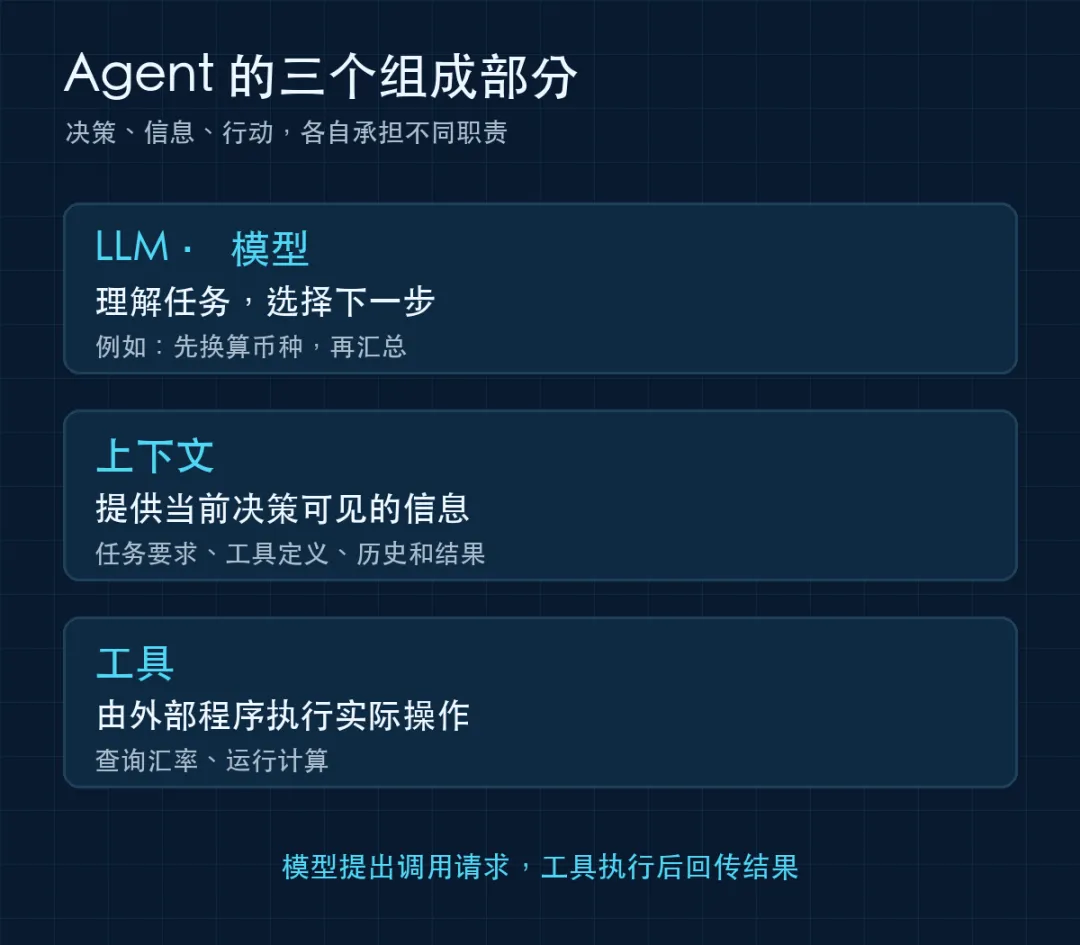
机制示意|模型决策,上下文提供信息,工具执行操作
02
上下文,包括它这一步能看到的所有信息
上下文这个词,容易让人想到聊天记录。对于 Agent,它的范围更大。
沿着收入汇总这个任务看,至少有几类信息需要交给模型:
系统提示词:规定怎样处理任务,例如金额统一成美元。
工具定义:告诉模型有哪些工具、各自做什么、参数怎么填。
用户消息:包含收入数据和用户的要求。
模型回复:记录之前的回答、调用请求等内容。
工具结果:返回查到的汇率或算出的金额。
系统里接好了一个工具,模型还得看到它的用途和调用方式,才有依据选择它。比如查询汇率的工具,需要说明输入什么币种、返回什么数据。只有一个含糊的名字,模型就容易用错。
工具结果同样重要。查完汇率以后,需要把结果送回模型,让它知道这一步得到了什么,接下来该做什么。
所以设计上下文时,不能只考虑提示词写得好不好,还要考虑:当前这一步需要哪些信息,这些信息有没有真正送到模型面前?
03
Agent 是怎样一步步完成任务的
三个部分分清以后,再看它们怎么配合。
以多币种收入汇总为例,先假设数据已经给齐,目标也明确:统一成美元,再计算总额。
模型首先判断,有些金额需要换算,于是生成汇率查询的工具调用请求。程序执行查询,把结果追加到上下文里。
下一轮,模型看到了换算结果,判断现在可以汇总了,再请求计算工具处理这些数字。
程序返回计算结果,模型据此组织回答。如果查询失败,或者数据还不够,后续步骤就需要根据返回信息调整。
这里有一个不断重复的过程:
思考 → 行动 → 观察结果 → 再决定下一步。
这就是 ReAct 循环。ReAct 由 Reasoning 和 Acting 组成,分别对应推理与行动;实际运行时,还需要观察行动返回的结果。
“思考”可以理解为模型判断下一步怎么做,并不意味着系统一定要向用户展示完整的内部推理。
每一轮的消息和工具结果逐步积累,形成执行轨迹。模型再次被调用时,可以根据这段轨迹判断任务进展。前面得到的汇率,会成为后面计算的依据。
这里的“自主”,也有明确范围:模型在系统提供的信息和行动能力内选择下一步。它能访问什么、能执行什么,仍然取决于外部程序和权限。
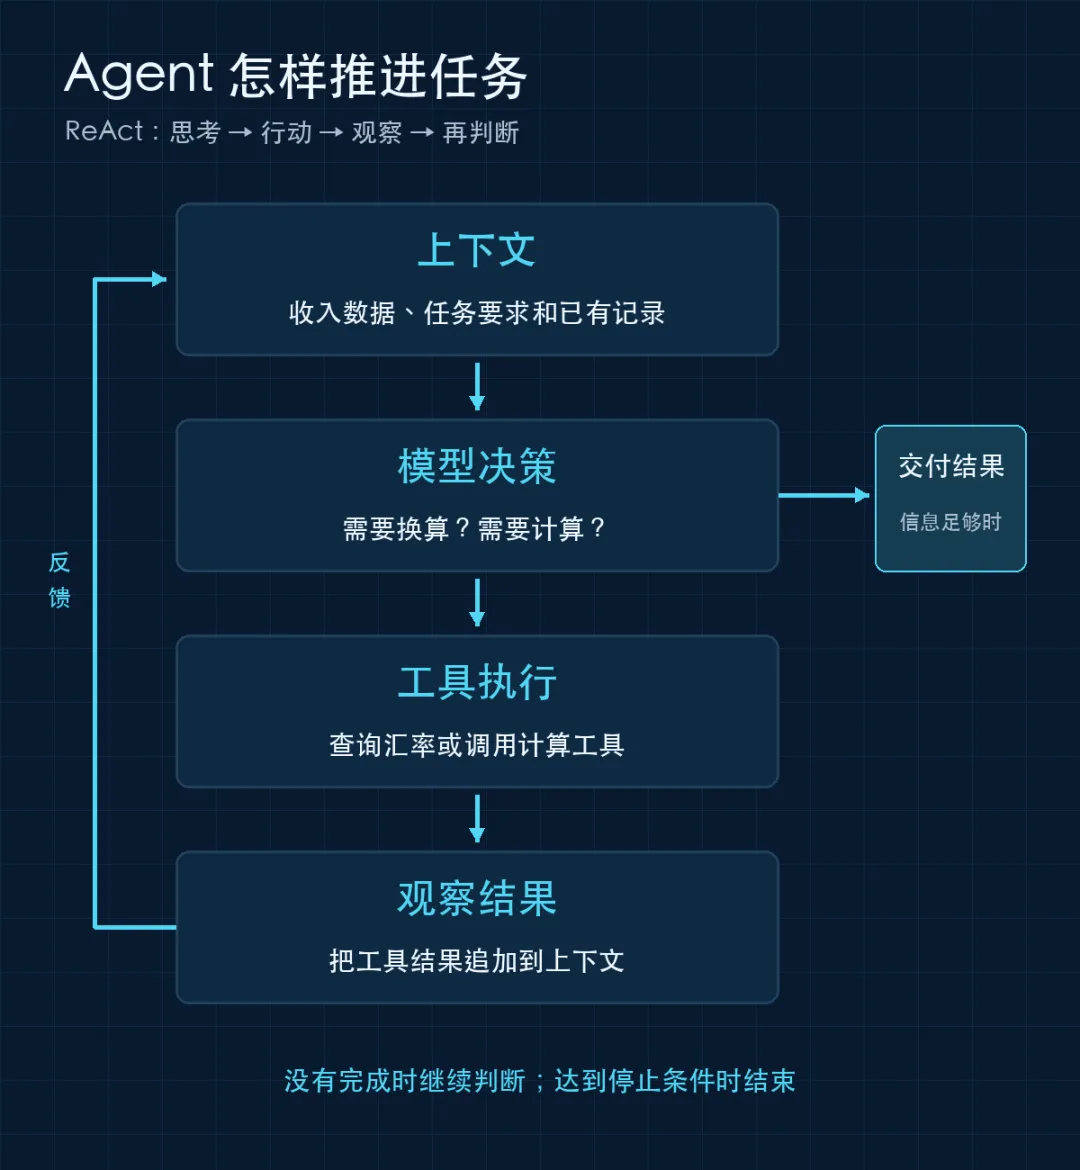
机制示意|工具结果回到上下文,成为下一轮判断的依据
04
执行记录多了,就等于它学会了吗
看到这里,可能会有一个疑问:Agent 每次都能参考前面的结果,是不是用得越多,就会自己变聪明?
要看这些经验保存在哪里。
本轮上下文里有一个示例,模型可以参考它处理后续任务。这叫上下文学习;推理时并没有因此修改模型权重。下一次调用如果不再提供这段信息,也不能默认它仍然记得。
如果把经验整理进知识库,或者把一段流程写成可重复调用的工具,后续任务就有机会继续使用。经验保存在模型之外,这属于外部化学习。
再进一步,通过监督微调、强化学习等后训练方式,可以改变模型参数,调整模型本身的行为。
这几种方式的成本、更新速度和适用场景都不同。先知道它们的区别就够了,后面再分别展开。
回到报表任务,即使查到了汇率、算出了总额,汇率来源是否可靠、计算结果怎样检查、失败后重试几次,仍然需要进一步设计。
下一篇接着第一章往下讲:围绕模型的工程程序,也就是 Harness,怎样让这套运行过程更可靠。