ARTICLE · 1122697
AI让你变"差不多"了吗:当工具样样精通,人该怎么保持竞争力
一百年前胡适写了个"差不多先生",一百年后 AI 差点把他变成了所有人
1924 年,胡适写了篇《差不多先生传》。
差不多先生赶火车迟到两分钟,反倒纳闷火车为什么非得急着开走;他常把"十"字写成"千"字,理由是两者左右不过差了一小撇;病重时他请来兽医王大夫,而不是给人看病的汪大夫——反正都姓王,何必分那么清楚。弥留之际他断断续续念叨:活人同死人,也差不太多。
胡适写它,是讽刺一种"凡事只要过得去就行"的国民毛病。一百年过去,这个毛病没被治好,它被技术实现了。
10 月 3 日,36 氪神译局编译了一篇文章,标题叫《欢迎来到"差不多"世界》。里面有一句话,值得每个天天用 AI 的人停下来想三分钟:
AI 没有缩短你变强的过程,它直接把这个过程中途短路了。
你为了拿到一个"还过得去"的结果所付出的挣扎越少,你就越不可能长出独立拿到这个结果的底层能力。
01 先说清楚一件事:什么叫"Stockfish 时刻"
Stockfish 是目前最强的国际象棋引擎之一。它代表的不是"AI 比人强",而是一个更彻底的临界点:
在某个领域里,AI 已经登峰造极,人类的介入不但加不了分,反而会拖累产出质量;任何想跟它掰手腕的人,都注定惨败给一种自己既无法理解、也无力解释的力量。
注意后半句——"无力解释"。这才是最要命的部分。过去人类输给高手,还能复盘、还能学一招;现在你输给一个说不清为什么这么下的东西,你连偷师都偷不到。
绝大多数领域还没走到这一步。但很多行业已经出现了它的"低配版":外行甚至专业从业者,看一眼提示词生成的结果,耸耸肩说一句"害,差不多了",然后欣然笑纳。
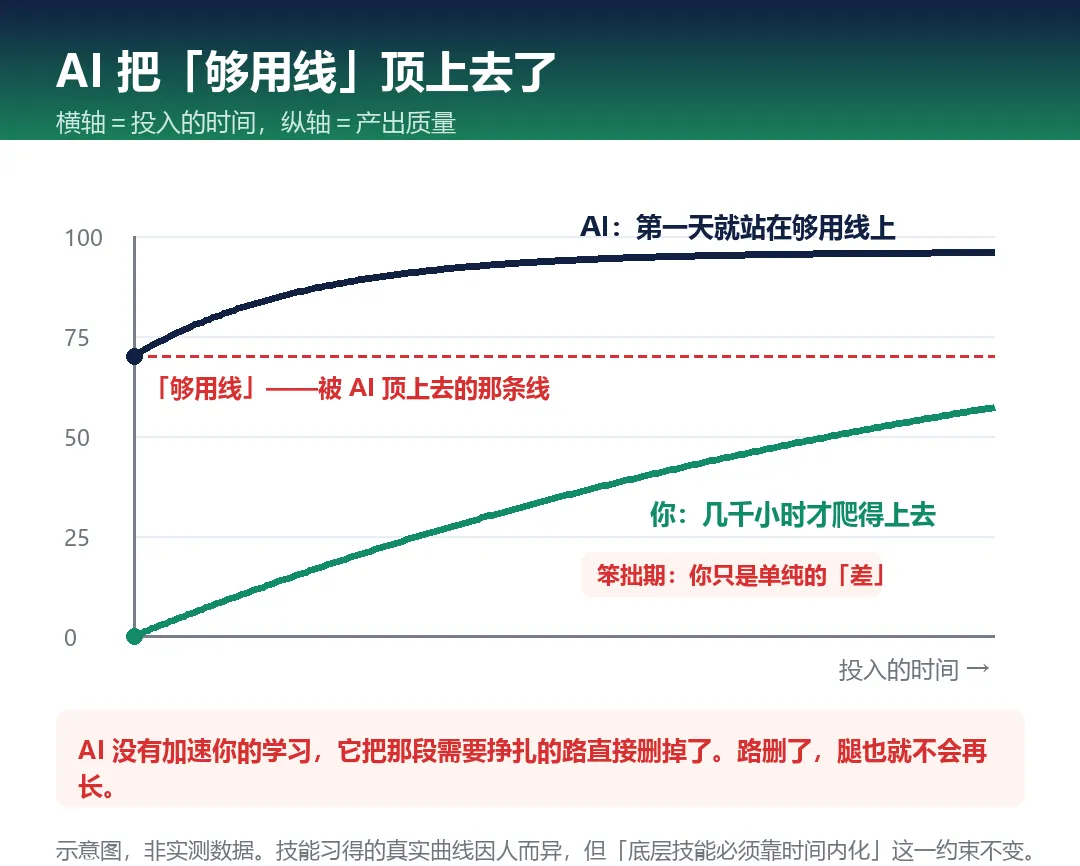
这张图里真正的问题不是 AI 太高
而是那条"够用线"。一旦"够用线"被 AI 顶上去,人类那条需要几千小时才能爬上去的曲线,就永远失去了起步的理由。
02 三个场景,看看你中了几条
"差不多世界"不是预言,它已经是日常。
写代码
原文里引用了一位程序员的自述,我看完愣了一下:
注意"诡异"这个词。他不是高兴,也不是愤怒,是一种说不清的失落——因为消失的不是效率,是一部分他自己。
写东西
皮尤研究中心的数据:ChatGPT 发布之后上线的网站里,超过 三分之一 带有明显的 AI 写作痕迹。道歉信、请愿书、公关稿、周报——文体还在,人味没了。
以前这些东西写得也未必多好,但它们是从某个人的脑子里流出来的,带着他的偏见、节奏和破绽,也顺带磨了他的笔。现在,我们正淹没在一堆连"作者"自己都懒得读第二遍的文字糊糊里。
画图
原文作者自己承认:他从 AI 画图诞生的第一天就在用,也没打算停。但他清楚代价——他的绘画造诣会永远停在极低的水平。他不会形成个人风格,也拿不出支撑那种风格的技术素养。抽走工具,他绝大部分的视觉产出归零。
这就叫"差不多艺术":看起来像,实际不是。而它的存在,意味着每一个像他这样抄近路的人,都不可能真正成为艺术家。
03 本质:几千小时的门槛,AI 让你绕过去了,也让你长不出来了
想把任何一门技能磨到准专家级,都需要几百到几千小时。这个过程漫长、挫败,而且充满难堪——因为起步阶段你不只是"差不多",你是实实在在的"差"。
聪明也跳不过去。自称"极客学习狂"的 Max Deutsch 做过一系列速通实验,终极目标是用一个月学会"像计算机一样下棋",然后挑战当时的世界棋王卡尔森。
结果一个月后如期对弈,溃不成军。
为什么?因为在那些没人愿意投入超过几小时的领域,速成法确实管用——练套魔术在路人面前露一手,在听众一句不懂的情况下讲外语,恶补某个冷门话题的皮毛好在饭局上接得上话。但国际象棋不是。这个领域里,一个天赋极高的业余爱好者绞尽脑汁迸出的最深洞察,深度也不过相当于特级大师漫不经心扫一眼棋盘。
哪怕是 Math Academy 这类用认知科学优化学习路径的工具,能把学数学概念的速度提到 4 倍甚至 10 倍,你也没法在一两个月里速通整个数学体系——因为数学有成千上万个细分技能点,层层递进,底层必须练成不用想就能反应的本能。
关键在这里
AI 给的"捷径"和"加速"是两码事。加速是让你更快爬完那段路;捷径是把那段路直接删掉。路删了,腿也就不会再长了。
04 悖论:越用越不会,越不会越要用
这才是"差不多世界"最阴的地方——它是一个会自我加固的循环。
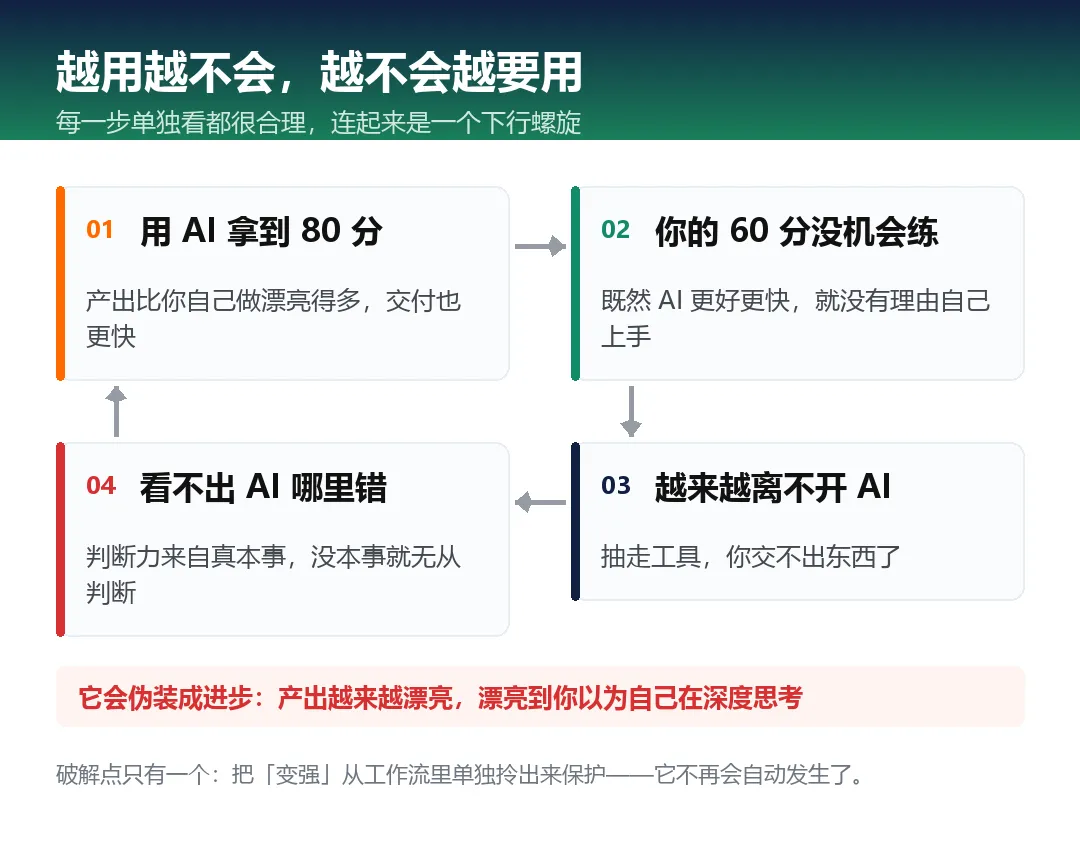
你用 AI 拿到 80 分的产出 → 你自己 60 分的能力没机会练 → 你越来越只能靠 AI → 你没有能力判断 AI 给的对不对 → 你更不敢自己来。越依赖工具,越没机会练成真本事;越没真本事,越依赖工具。
而且这个循环会伪装成进步:你的产出看起来越来越漂亮,漂亮到你几乎产生自己正在深度思考的幻觉。就像刷了一堆科普视频之后,你以为自己真的懂了。
05 这不是危言耸听,已经有体检报告了
《经济学人》最近刊出一张基于中国校园 AI 应用调查的图,结果触目惊心:在不少班级里,平时作业成绩和期末考试成绩呈负相关。
一学期下来,平时作业做得越漂亮的学生,期末考得越砸。
你可以说这是学生咎由自取。但《高校内幕》报道过布朗大学的一个课堂:59 名学生里有 56 人在作弊。当一个班只有一个人作弊,那是学生的问题;当 96% 的人都在作弊,那是评估体系出了问题。
同样的病也在成人世界蔓延。原文作者运营一份公开投稿的 newsletter,最近遇到一种新现象:顶着光鲜头衔的教育界人士,署着真名,发来一眼假、漏洞百出的 AI 生成稿。
作者的吐槽很扎心
问题不在于他们用了 AI,甚至不在于他们隐瞒不报,而在于那些稿子空洞无物、充斥程式化的语言癖病——根本算不上好文章。可悲的是,它已经"足够好"到让堂堂教育专家心甘情愿把自己的名字和这堆文字糊糊绑在一起。
06 破局:AI 真正拿不走的四件事
既然工具不可逆,问题就变成:在一个人人都能调用 80 分 AI 的世界里,什么还值钱?
① 提出真问题
AI 最擅长回答问题,最不擅长判断哪个问题值得回答。需求背后真正的诉求是什么?两个互相冲突的目标该保哪一个?这件事值不值得做?——问题定义错了,答案再漂亮也是废纸。
② 跨域判断
AI 在既有规则里优化,人类负责把 A 领域的经验搬到 B 领域。你踩过的坑、见过的客户、熬过的周期,这些没法被训练语料穷举。行业 know-how 在 AI 时代不是贬值了,是更稀缺了——因为调用 AI 的能力人人平等,判断往哪儿用的能力不是。
③ 验证结果
这是最残酷的一条:你要能看出 AI 哪里错了,前提是你本来就懂。资深开源开发者的随机对照研究里有个反直觉的发现——用 AI 后完成任务的时间反而增加了约 19%,而这些开发者主观上仍认为自己变快了。因为读、查、验同样花时间,而"看起来很对"的代码,最费眼睛。
④ 长期积累出的直觉
那些练成了本能反应的东西——一眼看出数据不对、一句话听出对方在绕、一秒判断这个盘面不能碰。它们无法被提示词调用,只能被时间养出来。而它们恰恰是你唯一能用来给 AI 兜底的东西。
还有第五项,原文没写但必须补上
责任。AI 不能签字、不能背锅、不能坐牢。所有产出最终要有人署名、有人承担后果——而"能负责"这件事,天然要求你真的懂自己在交出什么。
07 三个动作:给不想变"差不多"的人
道理讲完了,给能立刻执行的。
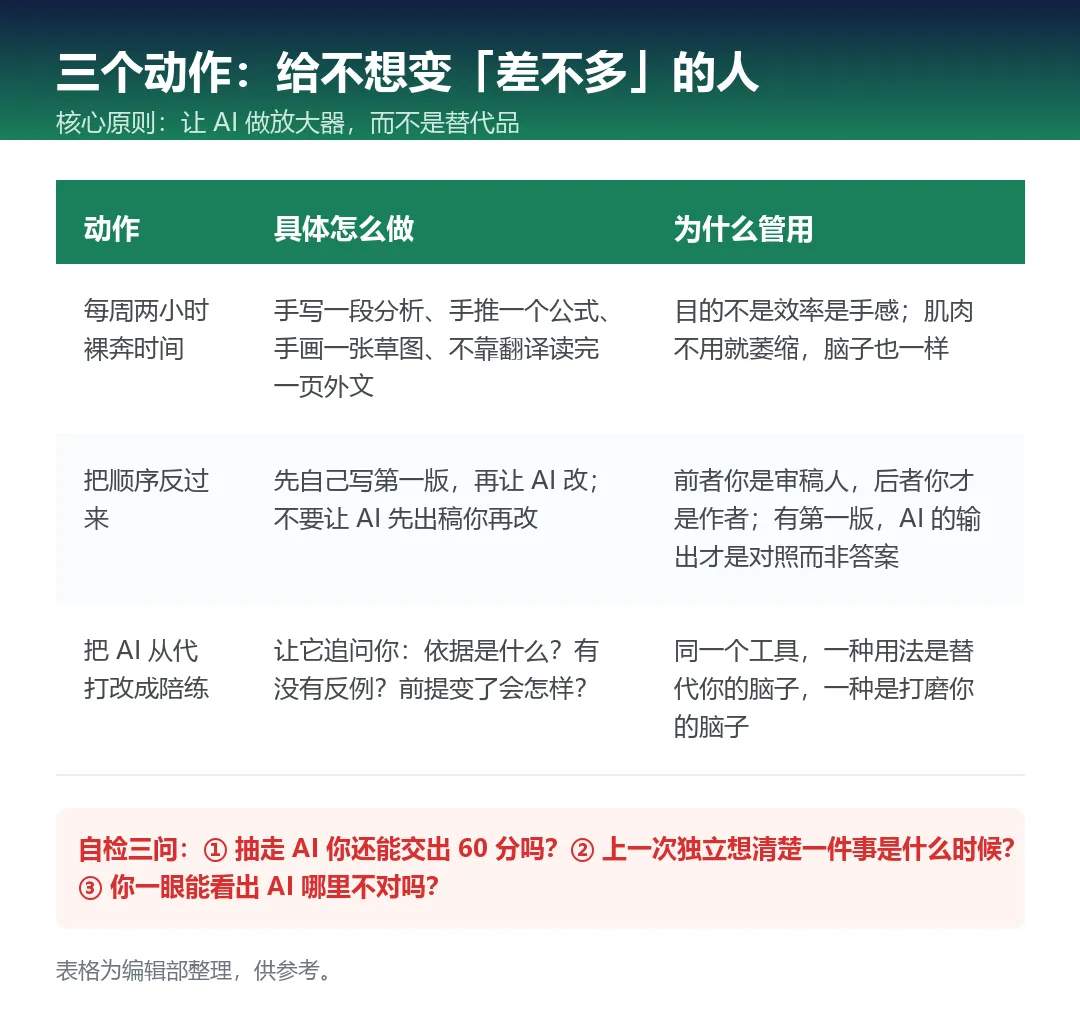
动作一:每周留两小时"裸奔时间"
挑一件你会做、但 AI 做得更快的事——手写一段分析、手推一个公式、手画一张草图、不用翻译软件读完一页外文。目的不是效率,是维持手感。肌肉不用就萎缩,脑子也一样。
动作二:把顺序反过来
绝大多数人的流程是"AI 先出稿 → 我改"。改成"我先把自己的想法写出来 → 再让 AI 改"。差别不在成品质量,在于:前者你是审稿人,后者你才是作者。有了自己的第一版,AI 的输出才是"对照",不是"答案"。
动作三:把 AI 从代打改成陪练
别再让它替你写。让它追问你:这个结论的依据是什么?有没有反例?如果前提变了会怎样?让它来挑你的逻辑漏洞,而不是替你填空白。同样一个工具,用法反过来,一个是替代你的脑子,一个是打磨你的脑子。
最后,三个自检问题
① 如果现在抽走所有 AI 工具,我还能交出 60 分的东西吗?② 我上一次独立地把一件事想清楚,是什么时候?③ AI 给我的这段输出,我能一眼看出它哪里不对吗?
写在最后
一百年前,胡适笔下的差不多先生是个笑话。一百年后,我们发明了一台机器,能让所有人都活成差不多先生,还觉得自己挺好的。
问题从来不是"AI 会不会取代你"。问题是:当 AI 让你不再需要变强之后,你还会变强吗?
工具越强,越要把"变强"这件事从工作流里单独拎出来保护。因为它不再会自动发生——过去你写十篇稿子就变强了,现在你写一百篇,也可能只是把同一句提示词重复了一百遍。
国庆假期还有几天,正好适合想这个。别急着学新工具,先想想:哪件事,是你这辈子都不打算外包出去的?