ARTICLE · 1125154
查不了的条件,AI 助手却给出“0 个客户”:Shopify 怎样教它说“不”
查不了的条件,AI 助手却给出“0 个客户”:Shopify 怎样教它说“不”
作者:魏新宇
GitHub Repo: david-share(https://github.com/david-xinyuwei/david-share)
相关目录: 深度学习与训练专题(https://github.com/david-xinyuwei/david-share/tree/master/Deep-Learning)
内容范围: 训练、微调、强化学习与推理实践;目录下已有 LLM 强化学习训练、Multi-LoRA 适配器、LoRA 作用层对比等专题。本文尚未单独发布到仓库。
跟进更新: Star 收藏,Watch 跟进
先看一个真实的例子。
Shopify 是一家帮商家开网店的加拿大公司,后台有一个 AI 助手叫 Sidekick。Sidekick 分两层:外层的规划器理解商家想干什么,再把请求交给各个专门技能,比如客户分群、销售分析、发邮件[S1]。
客户分群技能做的事是:商家用大白话描述一群客户,模型把它翻译成 Shopify 的分群查询,查出一份名单,拿去发券、做营销。分群查询有专门的语法,大多数商家写不出来;Shopify 微调了一个开源模型来写,常见的请求都能处理好[S1]。
正常的时候是这样的:商家问“哪些客户来自多伦多?”,模型生成 customer_cities CONTAINS 'CA-ON-Toronto',查出 20 个客户。
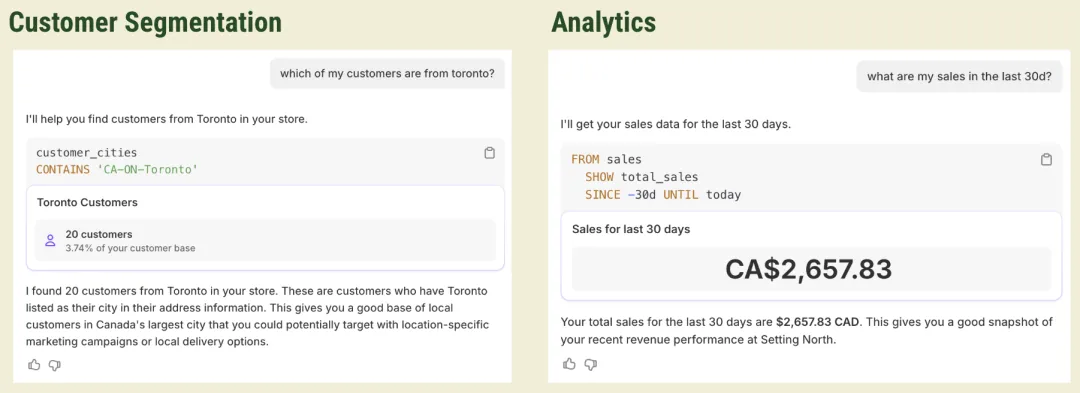
图 1:Sidekick 的两个技能。左边是客户分群:商家问“哪些客户来自多伦多”,模型生成分群查询,查出 20 个客户,占客户总数的 3.74%;右边是销售分析:商家问“最近 30 天卖了多少”,模型生成分析查询,返回 2,657.83 加元。两边的查询语言商家都很难自己写。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 1,https://shopify.engineering/sidekick-curation。
出错的时候:查不了,却给出 0
问题出在查不了的条件上。商家问:
找出职业是医生的客户。(原文:finding customers who are doctors)
Shopify 不记录客户的职业,这个条件根本查不了。可模型不会说“不”。它照样生成一个查询,查询正常执行,返回 0 条结果[S1]。
原文没有给出模型当时写的查询。下面是一种可能的写法(★ 作者构造,没有在真实店铺运行;语法按 Shopify 官方分群查询文档[S3]):
customer_tags CONTAINS 'doctor'分群语言里没有“职业”这个字段,只能拿客户标签去凑。官方文档写明:按标签筛选时,不检查这个标签是否存在[S3]。所以这条查询不会报错,只会返回 0。
商家看到的是“没有符合条件的客户”,而不是“这个条件查不了”。原文的说法是:商家被误导,营销对象选错,用户也被搞糊涂了;而这些问题在训练指标里一点都看不出来[S1]。
正确的输出
应该这样回答(★ 作者构造,按原文“最好附上可以改试什么”的要求写[S1]):
这个条件查不了:Shopify 不记录客户的职业。如果你给医生客户打过标签,可以按标签筛;也可以找买过医疗用品的客户。
这篇文章要回答的就是:怎样让模型学会这样回答。Shopify 的做法里没有新算法,难点全在训练数据上。下面按他们踩坑的顺序讲。带 ★ 的例子是我构造的,没有运行过;不带 ★ 的来自原文。
先把几个词说清楚
为什么模型学不会说“不”
原文给的原因很直接:分群技能的训练数据是数万条脱敏的线上查询,全部是成功的查询,一条拒答都没有[S1]。
线上日志记录的是被执行过的查询。“医生”那条也被执行了,返回 0,在日志里它就是一条成功。真正该拒的请求,要么像这样被记成成功,要么根本没留下来。模型从没见过“这时候该说不”的样子,遇到做不到的请求,只能硬着头皮生成一个查询。
线上日志只记录被执行过的查询,模型从里面学不到“说不”;拒答样本只能专门造。
第一次尝试:直接把标注数据合进去
Shopify 先请标注公司 Toloka 做了一份平衡的数据集:约 600 条正常查询,602 条拒答[S1]。这份数据比生产数据小得多,他们先做了最直接的事:两份合在一起,微调。
结果提升有限,训练还变得不稳定,生成质量下降[S1]。原因在这张图里:
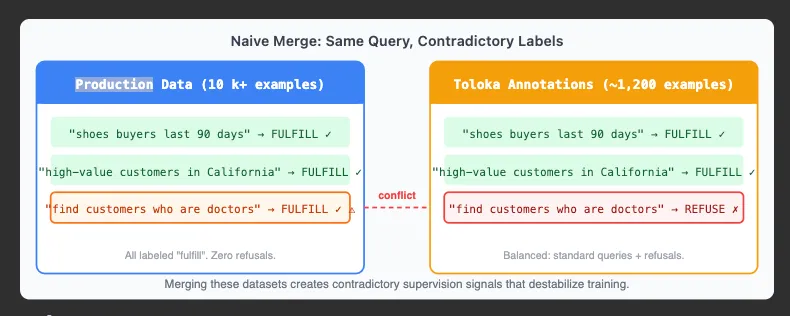
图 2:直接合并的问题。“过去 90 天买鞋的客户”“加州的高价值客户”在两份数据里都标“执行”(FULFILL);同一条“找出职业是医生的客户”,生产数据标“执行”,标注数据标“拒答”(REFUSE)。合并后,模型收到互相矛盾的训练信号。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 2,https://shopify.engineering/sidekick-curation。
生产数据里的“医生”被记成了执行,Toloka 的数据里它是拒答。意思相近的请求,在两份数据里标签完全相反[S1]。模型同时被教“这句要执行”和“这句要拒绝”,学到的只能是混乱。原文说,他们没有办法大规模地调和这些冲突[S1]。
补数据之前先查标签:同一个问题两份数据给出相反答案,比数据少更伤模型。
换个做法:人工标一小份,四个模型照着标全部
Shopify 没有继续加人工标注,而是把这 1,200 条左右的人工标注当成“种子”,请四个前沿大模型当 judge(原文匿名为 A、B、C、D),重新审一遍全部训练数据[S1]。用法有三条规矩。
规矩一:先用种子给 judge 定标准
每个 judge 的提示词里先放一批种子样例:请求,加上人工给的标签。这样 judge 判断“查不了”时,跟着人工标注的标准走,而不是按它自己对 Shopify 数据结构的猜测[S1]。
judge 不只是贴标签。一条请求在两份数据里标签打架时,由 judge 对照种子重新判,给出最终标签[S1]。
人工标注最值钱的用法不是标全量,而是定标准:用一小份种子校准多个 judge,再由 judge 标全部数据。
反过来,种子里有错,judge 也会照着错,错误被复制到几万条数据里。原文的原话是:垃圾进、垃圾出,在这里加倍成立[S1]。
规矩二:四个类别,必须互斥
judge 判断一条请求时,只能在四个类别里选一个[S1]。表里带 ★ 的例子是我构造的:
拿第一行来说:规划器先查到上次邮件活动的 ID,分群技能就能写出 shopify_email.clicked MATCHES (activity_id = 5240029206),活动 ID 取自官方文档的示例[S3]。最后一行的“大客户”,按消费金额是 amount_spent > 2000,按订单数是 number_of_orders >= 10,查出来是两群人[S3],模型不该替商家选。
类别为什么必须互斥?如果“找出我的大客户”既能算“有歧义”,又能算“补上下文后可解”,四个 judge 就会各选各的。原文说,类别不互斥,judge 就会分歧,标签就不一致,不一致会一路传到下游[S1]。他们的经验是:前期把类别定义干净,校准更快,标签更一致,微调也更稳定[S1]。
规矩三:四票全一致才算数
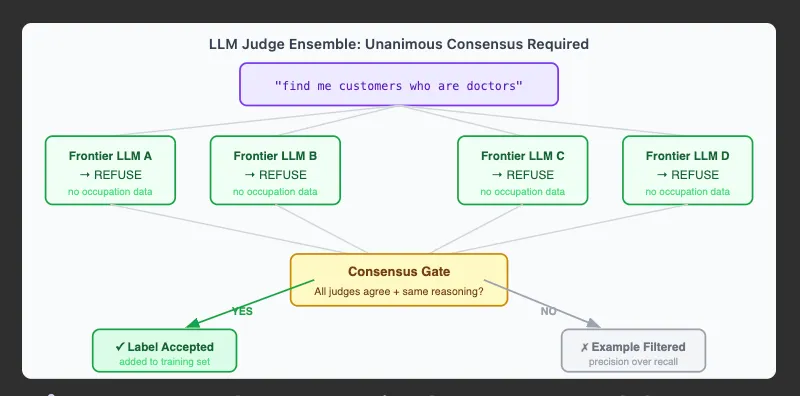
图 3:全票门。四个 judge 各自独立判断“找出职业是医生的客户”,都判为“拒答”,理由都是没有职业数据,标签通过,加入训练集;结论或理由只要有一处不一致,这条样本就被过滤掉。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 3,https://shopify.engineering/sidekick-curation。
四个 judge 的结论和理由都一致,标签才改;有分歧的样本直接丢掉,不做仲裁[S1]。原文说,即使是最好的模型,彼此也“经常”意见不一。他们的取舍是:宁可漏掉一条本该拒答的样本,也不能把商家的正常请求错标成拒答;四个模型都谈不拢的,应该交给人[S1]。
举个例子(★ 作者构造):“找出爱买打折商品的客户”。三个 judge 可能判“补上下文后可解”:如果店里给打折商品打了标签,可以用 products_purchased MATCHES (tag = '打折') 筛[S3]。第四个判“有歧义”:“爱买”是买过一次,还是买过五次?三比一,这条样本丢掉。
四个 judge 全票才改标签,有分歧就丢掉;宁可少一条数据,也不要一条错标签。
全票也不等于一定对。四个模型如果犯同一类错,比如都以为某个字段不存在,全票门拦不住。(作者判断,原文没讨论这一点。)
每条数据的四个去向
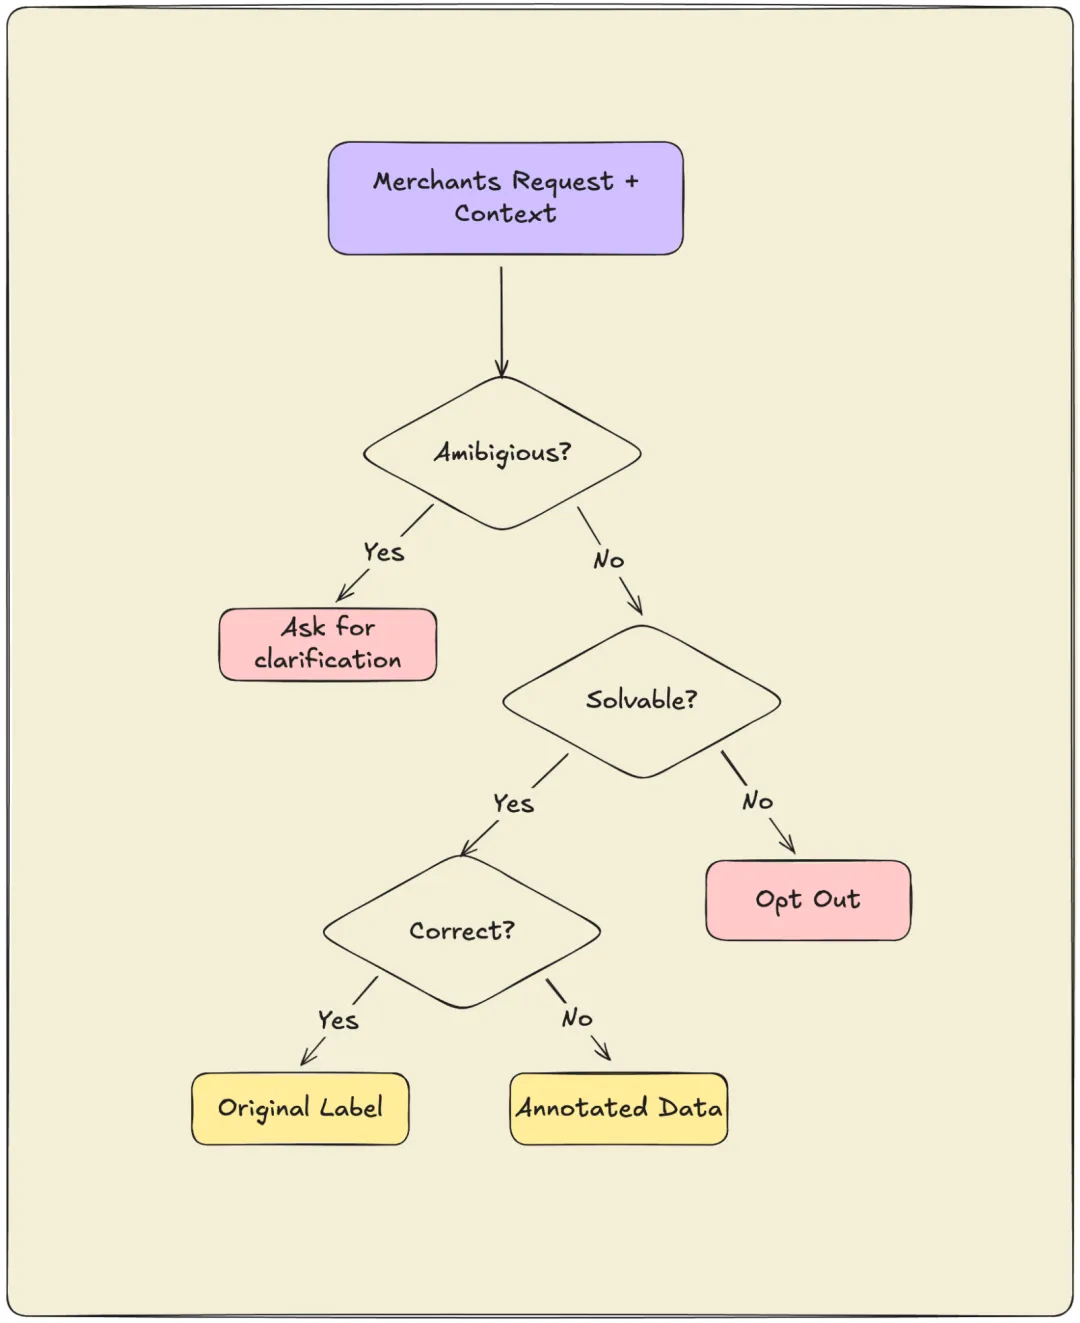
图 4:数据整理的判断流程。先看有没有歧义,有就“请商家澄清”;没有,再看能不能做,做不了就“拒答”(Opt Out);能做的,再看生产数据里原来的标签对不对,对就保留原标签,不对就换成标注后的标签。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 4,https://shopify.engineering/sidekick-curation。
原文没有写明四个类别和这四个去向怎么一一对应,这里不做推测。整个流程按原文描述整理成伪代码是这样(原文没有公开代码):
种子 = 人工标注:约 600 条正常查询 + 602 条拒答每个 judge 的提示词里放入种子样例(few-shot 校准)对训练数据里的每一条请求: 四个 judge 各自给出(类别,理由) 四票类别一致,理由也一致 → 采用这个标签 否则 → 丢掉,或者交给人判断用整理后的数据,从同一个起点重新微调结果:judge 准不准,模型好了多少
judge 自己准不准
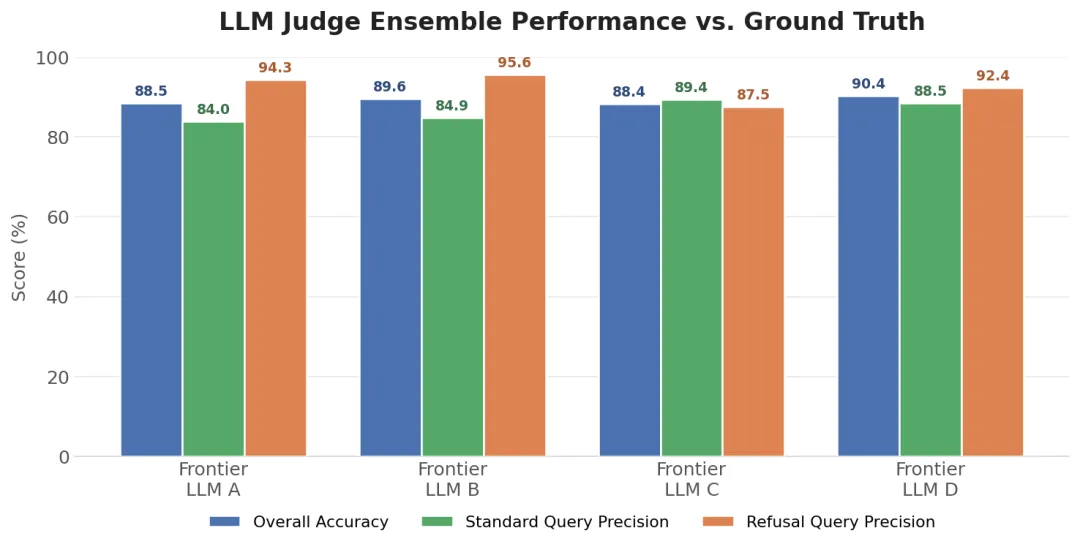
图 5:四个 judge 对照人工种子标注的表现。蓝色是总体准确率,88.4% 到 90.4%;绿色是判为“正常查询”时的精确率;橙色是判为“拒答”时的精确率。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 8,https://shopify.engineering/sidekick-curation。
原文给了两个数:四个 judge 和种子标注的一致率接近 90%,Cohen's kappa 都高于 0.75[S1]。
为什么还要多报一个 kappa?因为一致率会骗人。举个例子(★ 作者构造):100 条请求里 90 条正常、10 条该拒。一个偷懒的 judge 永远判“正常”,一致率就有 90%,可它一条该拒的都没判出来。
kappa 把“碰巧一致”的部分扣掉:
κ = ( po − pe ) / ( 1 − pe )
po 是实际一致率;pe 是按双方各自的标签分布算出的碰巧一致率。套到偷懒的 judge 上:po = 0.9;人工标注里 90% 是“正常”,judge 100% 判“正常”,pe = 0.9 × 1 + 0.1 × 0 = 0.9;所以 κ = 0,和随机猜一样。
一致率要配 kappa 看:九成样本属于同一类时,只会猜这一类的 judge 也有九成一致率。
Shopify 的种子接近对半(约 600 条正常、602 条拒答),这时不管 judge 怎么判,碰巧一致率都约等于 0.5。按图 5 的总体准确率算,κ 在 0.77 到 0.81 之间,和原文“都高于 0.75”对得上。(作者推算,假设图 5 只按“正常 / 拒答”两类统计,原文没说明。)
图 5 还藏着一个细节。A、B 两个 judge 判“拒答”时很少错(精确率 94.3%、95.6%),判“正常”时错得多(84.0%、84.9%):它们更容易把该拒的请求当成正常放过去。C 正好反过来,判“拒答”的精确率(87.5%)低于判“正常”的(89.4%),更容易误拒。错的方向不同,全票门才起作用:一个 judge 放过的样本,另一个 judge 很可能投了反对票,这条样本就会被丢掉。(作者根据图 5 的推断。)
模型好了多少
原文给了三个数字,分量不一样[S1]:
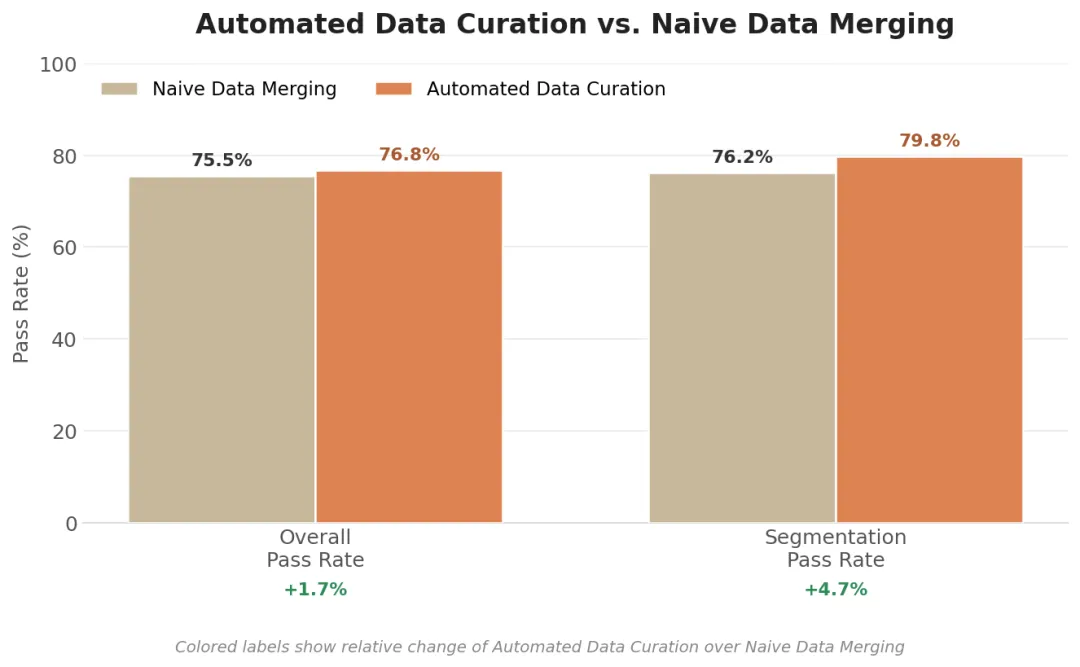
图 6:同一个起点,分别用“直接合并”和“自动整理”的数据微调。总体通过率 75.5% → 76.8%,分群通过率 76.2% → 79.8%;绿色数字是相对提升。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 7,https://shopify.engineering/sidekick-curation。
第三个数字要多说两句。原文没给这两个比例的分母。按常见的理解(作者理解):拒答准确率是该拒的请求里拒对了多少,误报率是能做的请求里被误拒了多少。换成 100 条来想:100 条该拒的请求,拒对约 86 条;100 条能做的请求,误拒约 5 条。
这两个数必须放在一起看。一个什么都拒的模型,该拒的一条不漏,可商家所有正常请求也都被拒了;一个从不拒的模型,误拒率是 0,可“医生”这种请求一条也拦不住。
拒答准确率要和误拒率一起看:什么请求都拒,该拒的自然一条不漏。
误拒同样有代价:商家的正常请求被拒,他会觉得助手没用。全票门宁可漏掉一条拒答、也不错标一条正常请求,防的就是这个[S1]。
学会说“不”,有什么用
原文最后一条经验是:拒答是产品功能,不是失败。系统做不到时,编一个答案是最坏的结果;如实说做不到,最好再给个替代建议,外层规划器就能让对话继续下去[S1]。作者的原话是:我们花了很多时间教模型什么时候说“行”,其实应该先教它什么时候说“不”[S1]。
具体来说:
商家不再被“0 个客户”误导;助手会拒答以后,它给出的 0 才更可信。(作者判断) 拒答附带替代建议,对话可以继续,规划器可以追问,或者换一条路[S1]。 “技能选错”的请求转给销售分析技能,“有歧义”的请求回头问商家[S1]。 “缺少功能”类的拒答攒多了,就是一份需求清单:商家常问、但 Shopify 还做不到的条件。(作者推断,原文没提)
代价是误拒,所以误拒率要一直盯着。
闭环:上线后的新流量喂下一轮
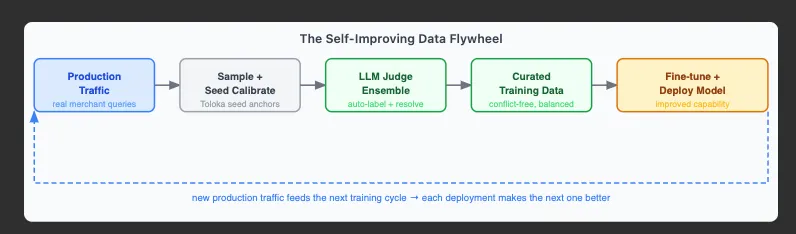
图 7:拒答数据的闭环。线上流量 → 抽样,并用种子校准 → judge 集成自动标注、解决冲突 → 整理好的训练数据(没有冲突,类别平衡)→ 微调并上线;上线后的新流量进入下一轮。来源:Shopify Engineering《Teaching Sidekick to say no》Figure 5,https://shopify.engineering/sidekick-curation。
新模型上线后,商家会换新的说法问同一件事,也会提出训练集里没有的请求。judge 给这些新样本贴标签,丢掉有分歧的,通过的加回训练集;下一轮微调从更多、更干净的数据开始[S1]。
比如(★ 作者构造)商家问“找出住在学校附近的客户”。分群语言有按经纬度距离筛客户的功能[S3],只要规划器先查到学校的位置就能做,这属于“补上下文后可解”,不该拒。
Shopify 说,他们正在把同一套做法用到 Sidekick 的其他技能上。每个领域的模型、阈值和类别都不一样,但骨架相同:一小份高质量种子,照着种子校准的 judge,全票门,再回到线上的闭环[S1]。
放回持续学习闭环里看
同一个团队的另一篇文章讲了更大的持续学习闭环:线上失败的对话被修好,先用 SFT 训进小模型,再用 GRPO 优化,奖励就是 judge 给的分数[S2]。那篇只描述了流程,没有给对照实验。说“不”这篇没用强化学习,但两篇的要害在同一处:judge 和标签定义的“对”。
GRPO 对同一个输入采样一组回答,每个回答的优势是:
Âi = ( ri − mean(r1, …, rG) ) / std(r1, …, rG)
ri 是 judge 给第 i 个回答的分数[P1]。假如 judge 认为“执行查询”总比“拒答”好,同一组里给出“0 个客户”的回答就会拿到正的优势,一轮轮被强化。(作者判断)
原文作者对说“不”这个项目的总结是:最难的部分不是机器学习,而是把模型周围的基础设施搭好,让模型能持续变好[S1]。
闭环里最难的一步不是 GRPO,而是先把“什么是对的”定清楚。
三个常见误解
误解:线上数据越多,训出来的模型越全面。
事实:线上日志只有被执行过的查询。分群技能的数万条训练数据里一条拒答都没有,日志再多也教不会它说“不”[S1]。
误解:一致率 90% 的 judge 就可以放心用。
事实:先看标签分布。九成样本是同一类时,永远猜这一类也有 90% 的一致率,kappa 却是 0。Shopify 同时报了 kappa,用的种子也接近对半[S1]。
误解:四个 judge 全票通过,标签就一定对。
事实:全票只能减少错标,不能消除。四个模型犯同一类错时,全票门拦不住;原文的取舍是用覆盖率换精确率[S1]。
能不能照搬
这篇文章的边界
案例拆解,没有本地复现。原文没有公开代码、数据、judge 提示词和类别定义原文。 带 ★ 的例子都是我构造的,没有在真实店铺运行;查询语法按 Shopify 官方文档写[S3]。 效果数字都是 Shopify 自己报告的,没有独立评测;86.3% 和 4.6% 没给分母。 全票门丢掉了多少样本,原文没有披露。 原文没提强化学习;“放回持续学习闭环里看”一节是我把两篇文章放在一起做的判断。 κ 在 0.77 到 0.81 之间是我按图 5 推算的,假设只按两类统计。
七句话带走
线上日志只记录被执行过的查询,模型从里面学不到“说不”;拒答样本只能专门造。 补数据之前先查标签:同一个问题两份数据给出相反答案,比数据少更伤模型。 人工标注最值钱的用法不是标全量,而是定标准:用一小份种子校准多个 judge,再由 judge 标全部数据。 四个 judge 全票才改标签,有分歧就丢掉;宁可少一条数据,也不要一条错标签。 一致率要配 kappa 看:九成样本属于同一类时,只会猜这一类的 judge 也有九成一致率。 拒答准确率要和误拒率一起看:什么请求都拒,该拒的自然一条不漏。 闭环里最难的一步不是 GRPO,而是先把“什么是对的”定清楚。
GitHub Repo: david-share(https://github.com/david-xinyuwei/david-share)
相关目录: 深度学习与训练专题(https://github.com/david-xinyuwei/david-share/tree/master/Deep-Learning)
内容范围: 训练、微调、强化学习与推理实践;目录下已有 LLM 强化学习训练、Multi-LoRA 适配器、LoRA 作用层对比等专题。本文尚未单独发布到仓库。
跟进更新: Star 收藏,Watch 跟进
参考来源
[S1] Shuang Xie, Teaching Sidekick to say no: automated data curation with LLM judge consensus, Shopify Engineering, 2026-06-15. https://shopify.engineering/sidekick-curation
[S2] Andrew McNamara, Cody Mazza-Anthony, Sidekick's continual learning loop, Shopify Engineering, 2026-08-05. https://shopify.engineering/sidekicks-continual-learning-loop
[S3] Shopify, Segment query language reference, Shopify Dev Docs. https://shopify.dev/docs/api/shopifyql/segment-query-language-reference
[P1] Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, arXiv:2402.03300. https://arxiv.org/abs/2402.03300
作者:魏新宇 (Xinyu Wei) | Microsoft AI GBB