ARTICLE · 1127570
OpenClaw的深层记忆与主动检索记忆
一块是「记忆存下来之后怎么搜」,一块是「不用你开口,系统每轮自己去搜」。两件事,解决的是不同问题。
一、记忆搜索工具:怎么从一堆文件里找到那一段
数据存在哪
权威数据是 Markdown 文件:MEMORY.md、USER.md、memory/*.md。人能直接读、直接改,这点比任何向量库都强。
检索时把文件切成小块,默认 400 token 一块,块之间留 80 token 重叠,存进每个 agent 独立的 SQLite,同时建全文索引和向量索引。
切块纯机械,不判断内容价值——一个光秃秃的标题行也会独占一个检索名额。
检索是混合的,不是纯向量
打分不是四路相加,是先加权、再相乘:
相关度 = (语义向量 0.70 + 全文/BM25 0.30) × 时间衰减 × 重要度 → MMR 去重 λ=0.7 - 向量 0.70
:语义相近,措辞不同也能命中 - 全文 0.30
:专有名词、命令、路径靠它 - 时间衰减
:半衰期 30 天。 MEMORY.md、USER.md和无日期的memory/文件不过期,永久有效 - 重要度
:缺省就是中性值,老索引的排序信号不受影响 - MMR 去重
:λ = 0.7,避免十条结果其实是同一段
两个工具:memory_search(搜)、memory_get(读指定条目)。
实测纯检索 0.7 – 0.9 秒(语料 173 文件 / 636 块,硅基流动 BAAI/bge-m3 1024 维)。
局限:它给的是「片段」,不是「答案」
命中一段原文,不会告诉你这段话意味着什么。摘要、归纳、跨几段拼出一个结论,都还得再读一遍原文自己拼。
这也是为什么下面那块东西存在。
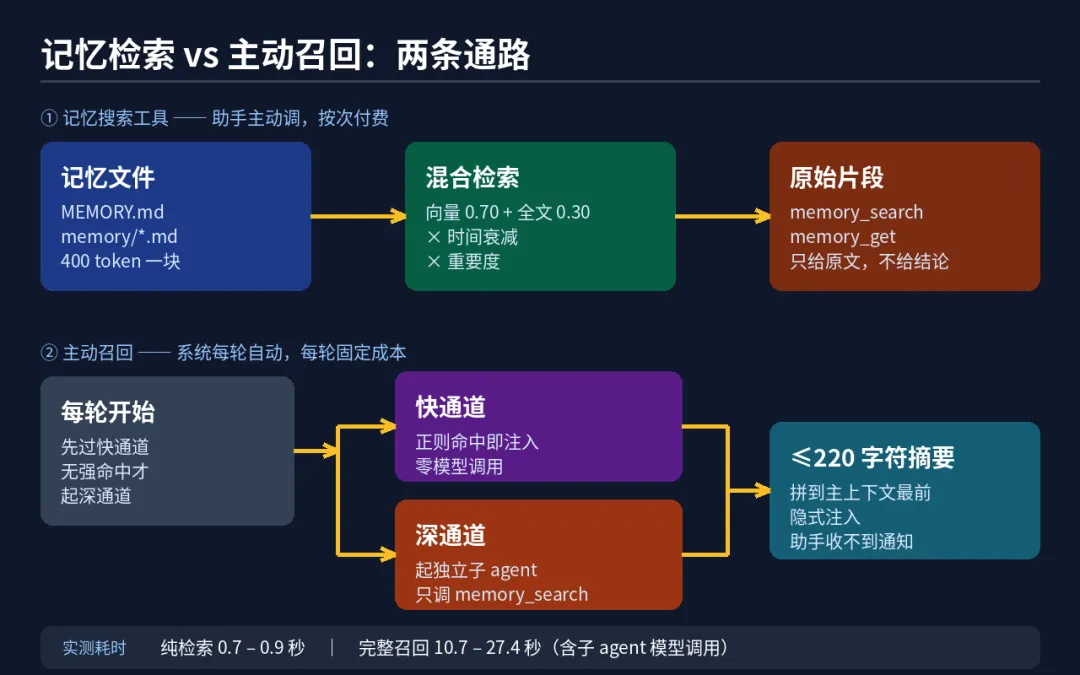
记忆检索的三段通路,以及主动召回里快通道与深通道的二选一分支
二、主动检索:不开口也会去翻记忆
它解决什么
得有人发起检索。 而这个「人」是助手自己——它得判断「这个问题要不要翻记忆」,然后主动调工具。
两处靠不住:
- 可能压根忘了搜
——尤其当问题看起来不像需要历史的时候 - 搜了也可能搜不准
——组织检索词、筛结果都要额外推理
active-memory 把这一步拿掉:每轮先过一遍快通道,深通道按模式决定要不要起,结果直接拼进上下文。
它不存数据,纯粹是调度层。
还有两个前提:agent 要开 Remember across conversations,且记忆 provider 得支持私密会话召回。任一不满足,日志会写 does not support protected private transcript recall,这一轮静默跳过。
两条通路
快通道:预置模式匹配,命中直接注入,不消耗模型调用。
深通道:起一个独立子 agent,调 memory_search / memory_get,整理成不超过 220 字符的摘要,拼到主上下文最前面。子 agent 的工具是白名单限制的,只能查记忆库,跑不出去翻文件或执行命令。
判断无内容可召回就返回空,主回复不受影响。这是正常行为。
三种模式
escalate | |
always | |
off |
escalate 的判断是正则,不是语义
源码预置中英日韩西俄五套规则。中文实测:
命中 上次我们聊过这个 你还记得吗 还记得昨天那个事吗 跳过 这个问题上次我也提过了 上次不是提过吗 我们之前讨论过方案 「提过」「讨论过」在规则里,但句式对不上固定模式就直接跳过,且没有任何提示。 中文规则还有个反向过滤器:句中含「明天、以后、稍后」会被判为「在说未来」而排除,漏判率因此更高。
生产环境建议直接用 always。
实测耗时
| 10.7 – 27.4 秒 |
方差较大,受模型负载与查询复杂度影响。超时会记 status=timeout、summaryChars=0,该轮召回作废。
注入是隐式的——助手不会收到「调用了插件」的通知,表现为上下文里多了一段内容。
三、两块怎么配合
sessionMemory 才带会话 | memory_search / memory_get |
第一块提供能力,第二块提供触发。 缺第一块没东西可搜,缺第二块则全靠模型自觉——而模型会忘。
关键配置
"active-memory": { "enabled": true, "config": { "agents": ["main"], "mode": "always", "logging": true } } agents 是白名单,不填等于没开——插件状态仍显示 enabled,但每轮静默跳过。
可选 thinking(子 agent 思考强度,默认关)、model(单独指定模型)、timeoutMs(召回预算,默认 15 秒)。logging 建议常开,否则跳过时看不到原因。
验证方式:看日志行为,不看配置。 配置已写不等于生效。
源码行为基于 OpenClaw 2026.9.7,耗时数据为本机实测,不同模型与语料规模差异较大。