ARTICLE · 1138443
corpus 生物多样性文献AI挖掘工具安装与实战教程
编者注
最近"AI 读文献"挺火,但大家吐槽最多的是:把一堆 PDF 直接扔给大模型,它要么上下文装不下,要么开始一本正经地编。 今天小编给大家介绍一个 2026 年 10 月刚发在 Current Biology 上的工具——corpus。它的思路很朴素也很硬核:别让大模型"背"文献,而是把文献"编译"成一个可检索的知识库,再让大模型通过 MCP 接口去"查"。
corpus 是由纽约大学 Samuel H. Church、格但斯克大学 Maciej K. Mańko、UCLA Felipe Zapata 和耶鲁 Casey W. Dunn 联合推出的一个开源工具,专门解决生物多样性文献(物种描述、测量、插图、系统发育、命名史)难以被 AI 可靠调取的问题。
主要功能特性
1. 文献 → 知识库(corpuscle)
把某一支系(clade)的 PDF 文献库,转成一个自包含、可搜索的 corpuscle同时处理文本、图版、参考文献,全部带溯源(可追溯到具体文献和页码)
2. 确定性 + 可溯源检索
哈希去重、OCR、书目解析、图版分割等结构步骤可复现 每次回答都直接检索自引用源材料,而不是模型"概率回忆"
3. MCP 服务器
构建结果暴露为一个只读的 MCP(Model Context Protocol)服务器 任何支持 MCP 的 LLM 客户端都能连上来,用预定义的检索工具查询
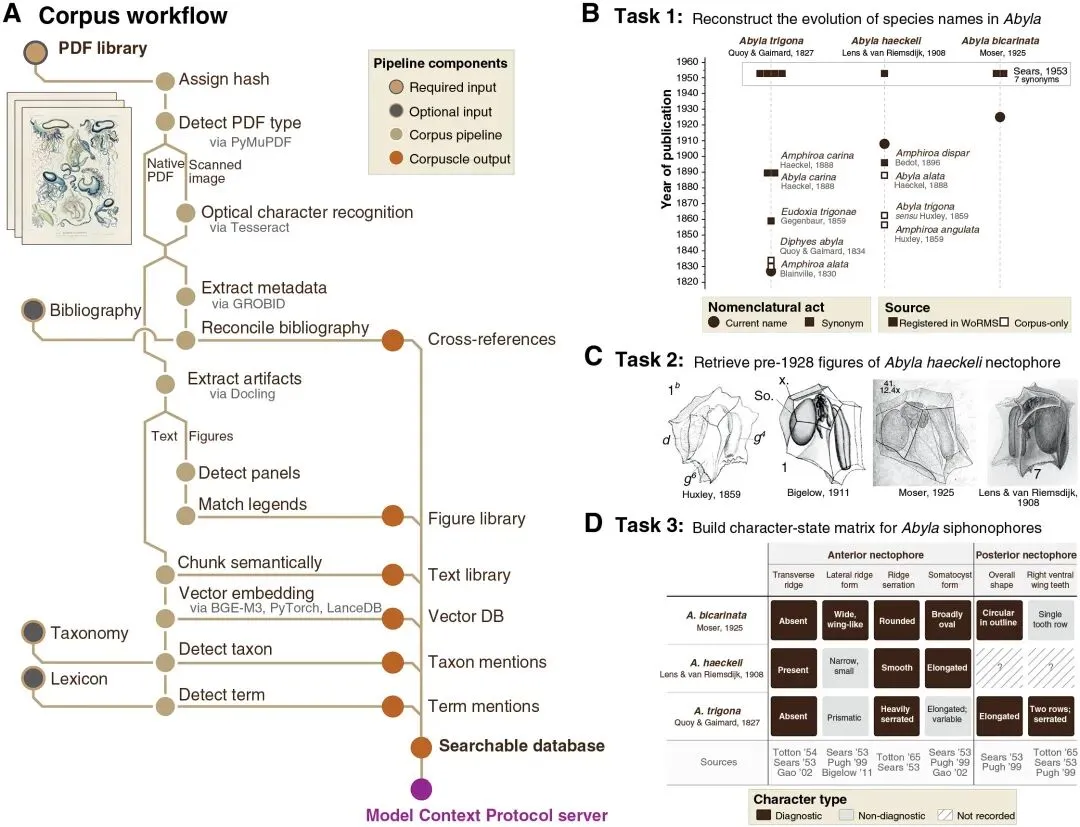
语料库工作流将生物多样性文献库转换为可搜索且可供代理访问的知识库
环境准备
corpus 是 Python 工具,依赖几个外部组件,先装齐(以 Linux/macOS 为例):
系统级依赖:Tesseract(OCR)+ GROBID(书目解析)sudo apt-get install -y tesseract-ocr # Ubuntu/Debianbrew install tesseract # macOSGROBID 建议用官方 Docker 跑(用于参考文献/书目结构解析)docker run -d --rm --name grobid -p 8070:8070 lfoppiano/grobid:0.8.1Python 3.10+ 环境python -m venv corpus-env && source corpus-env/bin/activate
安装 corpus
从官方仓库安装(论文 Supplemental 注明 code availability,以官方仓库为准)git clone https://github.com/your-org/corpus.gitcd corpuspip install -e .核心依赖会被一并拉取pip install pymupdf docling pyTesseract grobid-client-clienttorch lancedb sentence-transformers # BGE-M3 经 sentence-transformers 加载#一行 clone + 一行 install,依赖都是主流库。
2. 准备输入:四种原料缺一不可
corpus 不是"喂一堆 PDF 就完事",它需要你提供四种原料,这也是它比普通 RAG 严谨的地方:
#工作目录结构my_clade/├── pdfs/ # ① PDF 文献库(可含扫描件、多语言、跨世纪)├── bibliography.bib # ② 每条 PDF 的 BibTeX 元数据├── taxonomy/ # ③ 分类学权威(Darwin Core Archive, DwC-A)│ └── taxon.tsv # 可从 WoRMS / GBIF / ITIS / Catalogue of Life 下载└── lexicon.txt # ④ 自定义术语词表(解剖/生态/发育/生物地理)#lexicon.txt 示例(管水母支系)nectophoresomatocystbractgonophore
分类学权威 DwC-A 的作用是协调命名变化——同一个物种在百年里可能换过好几个名字,corpus 靠它把 junior synonym 都归并到 current name 下,这是纯向量检索做不到的。
一键构建 corpuscle
corpus build--pdf-dir ./pdfs--bibliography ./bibliography.bib--taxonomy ./taxonomy--lexicon ./lexicon.txt--output ./corpuscle
内部依次发生:
PDF 库
├─ 哈希去重(识别重复件、建立溯源)
├─ PyMuPDF 检测 PDF 类型(数字原生 vs 扫描件)
│ └─ 扫描件 → Tesseract OCR
├─ GROBID 提取书目 + 引用交叉引用
├─ Docling 提取图版/表格/文本
│ └─ 视觉模型分割复合图版 + 匹配图注
├─ 语义分块 → BGE-M3 向量嵌入(PyTorch + LanceDB)
└─ 分类单元/术语识别
↓
corpuscle(文本库 + 图库 + 向量库 + 可搜索数据库)
增量更新:新增一篇 PDF 只需丢进 pdfs/ 目录重跑一次(构建是幂等+增量的)cp new_paper.pdf ./pdfs/corpus build --pdf-dir ./pdfs --output ./corpuscle # 只处理新增部分#构建是"输入目录的函数"——同一个目录永远产出同一个 corpuscle,可复现。
启动 MCP 服务器
构建产物是一个只读 MCP 服务器,一条命令启动corpus serve ./corpuscle --port 8877
启动后,它暴露两类工具:
- 算法检索
:结构化分类/书目数据的确定性搜索 - 语义检索
:向量库里的语义相似搜索 + 图版/图注检索 + 溯源提取
客户端连接 + 三类实战任务
任何支持 MCP 的 LLM 客户端(如 Claude Desktop、Cursor 等)都能连。以 Claude Desktop 为例,在配置里加:
{"mcpServers": {"corpus": {"command": "corpus","args": ["serve", "./corpuscle", "--port", "8877"]}}}
连上之后,就能做论文里的三类示例任务(以管水母 Abyla 为例):
任务 1:重建一个属的命名史
问:帮我重建 Abyla 属各物种的命名史,包括所有曾用名(junior synonym)和发表年代。corpus 返回:直接从文献检索出的命名事件时间线,每个节点带溯源。
任务 2:检索 1928 年前的物种插图
问:找出 Abyla haeckeli 前泳钟(nectophore)在 1928 年之前发表的所有插图。corpus 返回:跨世纪、跨语言、含 junior synonym 名下发表的图版,逐张带出处。
任务 3:构建性状-状态矩阵
问:为 Abyla 属三个物种构建前/后泳钟的性状-状态矩阵。corpus 返回:从多篇文献抽取、对齐后的字符矩阵,每一格都标注来源文献。
输出的核心:溯源可查
corpus 和"让模型随便答"最大的区别在这里——每个答案都能点回去:
问:Abyla trigona 的前泳钟是否具侧脊?corpus 回答:→ 具侧脊(Present, heavily serrated)→ 来源:Sears 1953;Pugh 1999;Gao 2002→ 页码:可追溯
结构步骤(哈希、分块、OCR)完全确定可复现;语义搜索和 LLM 综合会引入查询间差异,但检索本身 run-to-run 可复现——这正是论文说的"确定性、溯源可查的地基"。
总结与心得分享
corpus 给我们提供了一个把"读文献"这件事工程化的范式。安装不复杂,核心思想更值钱。小编有几点体会:
别把 PDF 直接塞给大模型。 上下文窗口有限、检索有歧义、来源质量参差——尤其分类学专著这种"大部头 + 图版 + 表格"混排的,直接投喂基本是灾难。先把文献"编译"成检索层,再让模型查,才是正路。
四种原料(PDF + BibTeX + 分类学权威 + 词表)是 corpus 的灵魂。 尤其 DwC-A 分类学权威,能解决"一个物种换过八个名字"的命名归并问题——这是普通向量 RAG 做不到、而分类学家最需要的。
"确定性"和"概率"的分工要分清。 OCR、分块、哈希是可复现的;向量语义搜索和 LLM 综合会引入变异。corpus 的设计原则是:让推理站在可复现的检索上,而不是概率回忆上。
这是"context engine"的一个样本。 生物学会越来越需要这类"确定性、溯源可查"的检索引擎——尤其是当你要下结论、要发文章、要引用文献的时候。