ARTICLE · 1143070
Cognee:给 Agent 一堆文档,它下次为什么还是忘了人和事的关系?
一个文档里记着“张三负责支付业务”,另一份制度规范写着“退款流程由支付团队对接”;等到下次直接问 Agent“退款找谁审批”时,如果只靠单纯的文本向量相似度检索,它很可能把两段话都翻了出来,却根本没把两者串联起来推导。
Cognee 的思路就是解决这种断层:它在摄入文本、代码和对话上下文时,将其提炼为可检索的实体、拓扑关系以及细粒度片段,供 Agent 在执行后续任务时按图索骥地精准“回忆”。
项目地址:github.com/topoteretes/cognee
它给的不是一个更大的聊天记录框
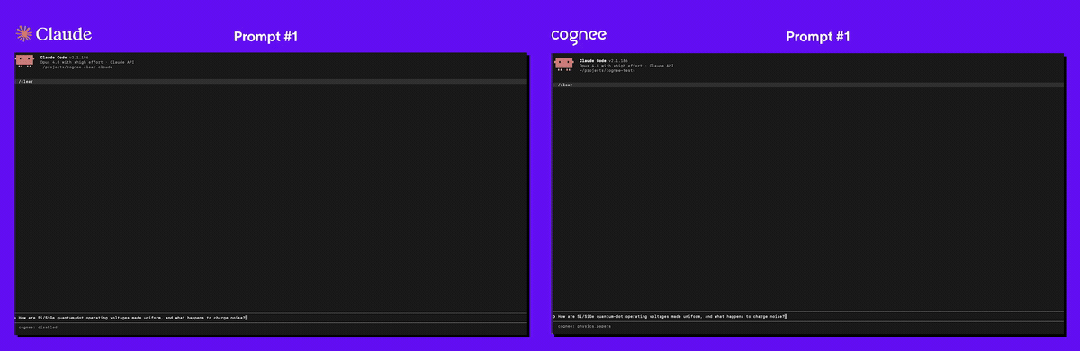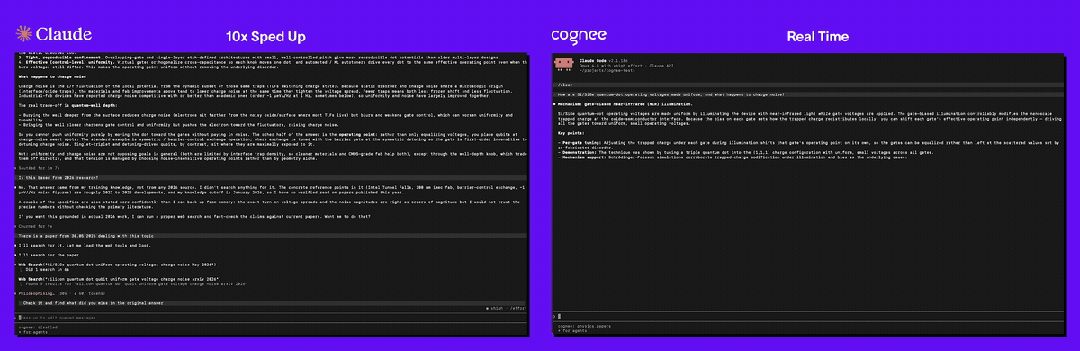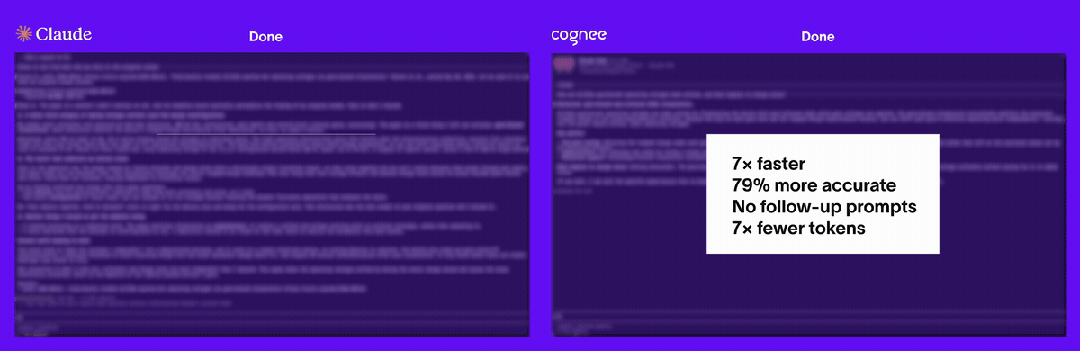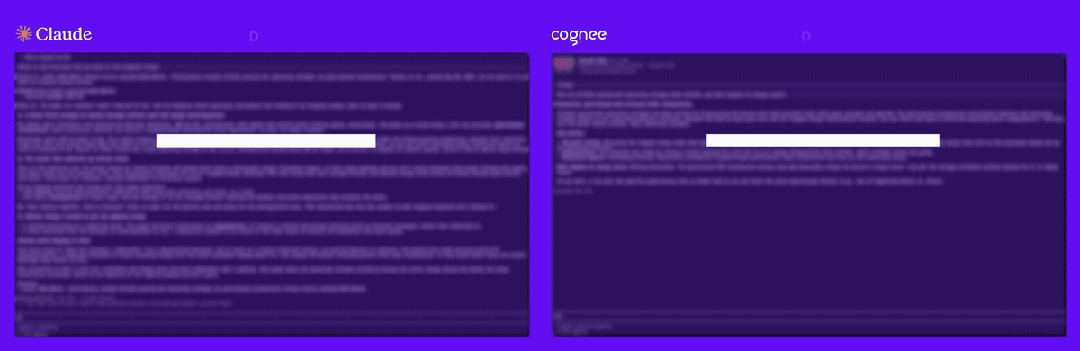
核心交互入口被清晰划分为四项操作:remember(写入记忆)、recall(按需检索召回)、improve(根据反馈迭代沉淀)和 forget(指定遗忘/删除)。
在底层处理上,普通文本会被拆解为实体关系网络与可索引文本块,代码工程则能解析并关联起语法符号与调用依赖;等到 Agent 实际发起查询时,再按需组合图谱拓扑、向量相似度或代码依赖上下文。对于需要长期跨周期跟踪客户档案、排查系统故障或梳理架构决策的 Agent 而言,这种结构化沉淀方式,比无脑把全部历史记录塞进超长 Context 窗口要清晰、可控得多。
如果不想依赖外部云端 API,官方提供了免配置商业 LLM Key 的本地快速上手路径:跑之前需要先在本地拉取配套的抽取模型与 Embedding 向量模型。仓库也自带基于关键词检索的极简示例,想直观观察底层数据结构的话,从这个小例子切入最省力。
刚上手时,建议先拿三份彼此存在逻辑交叉的简短文档做实验:抛出一个必须把其中两份材料关联起来才能推导的问题,然后人工核对召回结果里的证据链,看看实体图谱到底有没有真正连通。
别把“建了图谱”当成回答必然准确
引入图结构并不意味着输出就天然不会出错。在实际工程里,老旧失效关系该怎么自动覆盖、推导出的错误记忆如何精准纠偏、以及删除某个具体人员实体时能否干净剪除其派生的全部关联边,往往都比首次写入建图要棘手得多。代码里的 forget 只是框架层暴露的调用接口,真正的隐私合规与数据清理边界,依然取决于你底层选型的数据存储引擎和持久化备份机制。
如果平时在搭智能体或给大模型挂外挂知识库时,经常遇到类似“找不全信息”或“关系连不上”的问题,想先系统理顺数据怎么切分、向量库怎么存、怎么做混合召回与多跳检索,可以参考网友整理分享的这套资料:云栈《DeepSeek 智能体与知识库全面教程》(https://yunpan.plus/t/634)。里面的个人知识库资料存储、检索执行流程以及 RAG 落地章节,很适合先帮你把“从喂进文档到精准召回”这套底层链路打扎实,再回头去玩 Cognee 的关系图谱记忆会顺手很多。
如果《云栈知识库》整理的这些技术资源对你的研发实战或学习有所帮助,欢迎大家随手点赞、关注并转发给身边正在折腾 Agent 和 RAG 的朋友,后续我们也会持续为大家带来更多优质的工程资料与前沿开源项目解读!
来源:Cognee 官方 README、remember/recall 接口及仓库示例。
标签: #Cognee #Agent #知识图谱 #RAG #深度学习 #开源项目 #向量检索
近期发布: