ARTICLE · 1144459
解锁 Claude 隐藏能力:官方 PDF/Word/Excel 技能,精准处理各类文档
前面四集都在讲「skill 是什么、装到哪、谁来认」。这一集只干一件事:装上一个,用它干活。
一、这一集不绕弯
前三集我们把机制讲完了:格式是同一份、位置有讲究、工具间怎么搬运。如果你从头跟到这里,你现在的问题不是「skill 是什么」,而是「哪个 skill 真的值得装」。
这一集就给一个答案,而且给完当场跑。
答案是官方那个仓库里的一套:pdf、xlsx、docx。它们的身份有点特殊——这四份(含 pptx)是 Claude 处理文档能力背后的那套实现,官方把它们放出来做参考。
所以这一集的结构很简单:先说清它们是什么、许可怎么算,再说三种装法,然后把 pdf 拆开看内部结构,最后拿一张真表跑一遍。
二、三个 skill,三种活
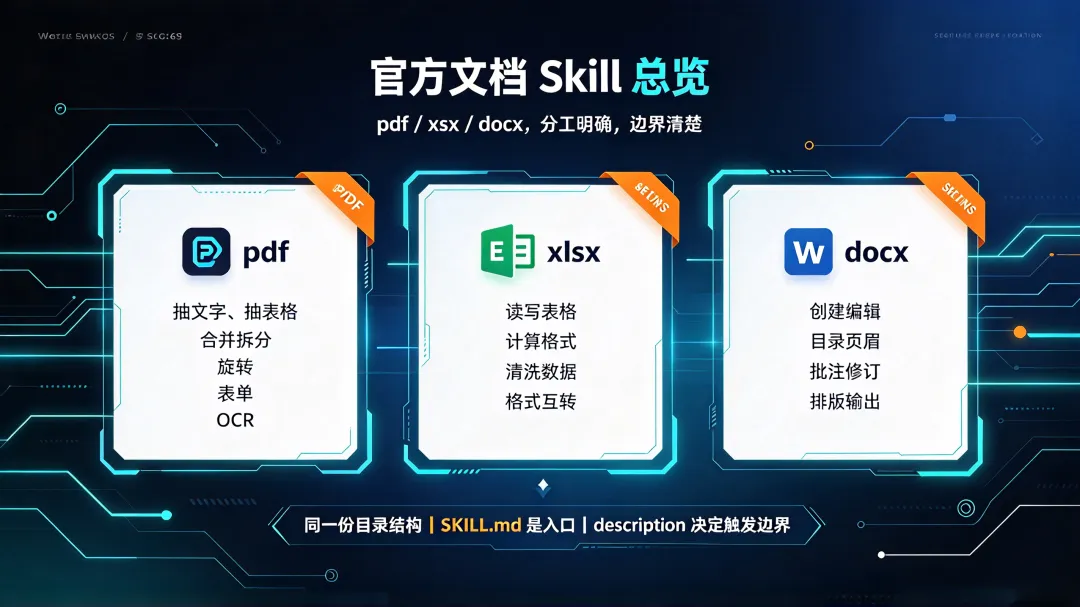
先看它各自管什么。我把三个 SKILL.md 里的 description 摘出来(原文是英文,我按意思转述):
pdf | |
xlsx | .xlsx/.xlsm/.csv/.tsv、加列、算公式、做格式、画图、清洗脏数据、格式互转 |
docx | .docx/.dotx、目录页码页眉、替换图片、查找替换、修订与批注、把内容转成一份排好版的 Word |
注意它们 description 的写法——这是前三集反复讲的那条经验。
pdf 那份几乎是把触发词全列出来:「凡是用户想对 PDF 做任何事」「如果用户提到一个 .pdf 文件或要产出一个」。xlsx 那份更讲究,结尾专门写了一段反向排除:如果主要交付物是 Word 文档、HTML 报告、独立 Python 脚本、数据库管道或 Google Sheets API 集成,不要用这个 skill——哪怕里面有表格数据。
写 skill 的人在这里做的是同一件事:把边界画清楚,让模型有判断依据。 该用的时候别漏,不该用的时候别抢。
三、先说清楚它的身份:不是开源
这一点必须先讲,因为它容易被含糊过去。
anthropics/skills 仓库里那 19 个 skill,许可不是一刀切的:
大部分( canvas-design、frontend-design、skill-creator、mcp-builder这些)是 Apache 2.0,正经开源但 docx、pdf、pptx、xlsx这四个不是。官方 README 的原话是这几个是 *source-available, not open source*——「源码可见,但不是开源」
你打开 pdf/SKILL.md 的头部能直接看到:
license: Proprietary. LICENSE.txt has complete termslicense 写的是 Proprietary(专有),完整条款在同目录的 LICENSE.txt 里。
为什么单独说这一条?因为它决定了你能拿它干什么:读它、学它、自己参考着写,没问题;直接搬进你的商业产品当自己的东西发,要去看 LICENSE.txt。 官方把话说明白了,你也别装看不见。
四、装法有三种,落点认同一份 SKILL.md
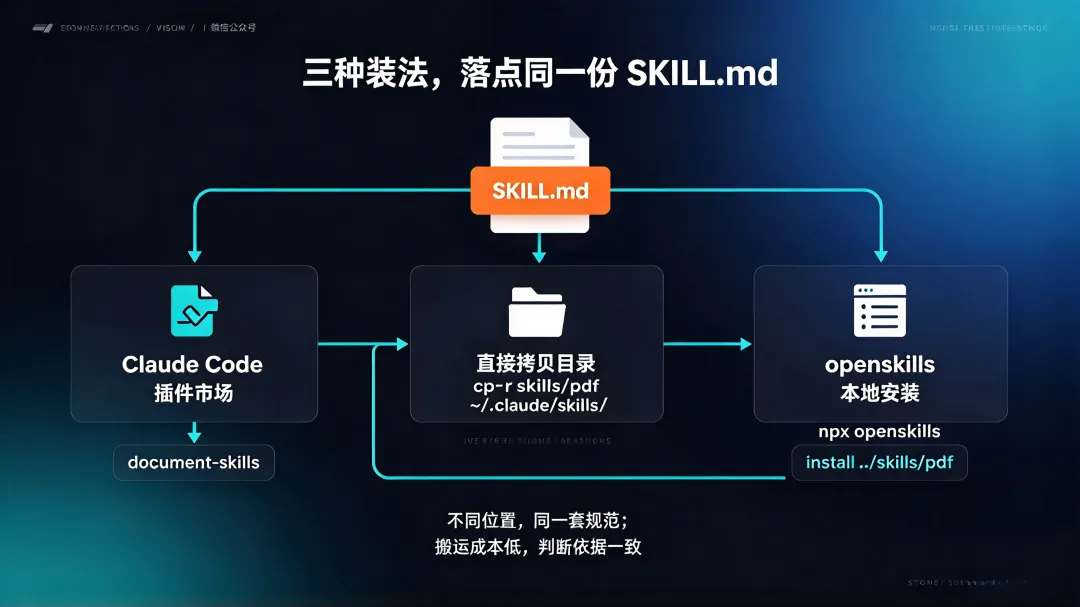
这是这一季的收束——同一个 skill,三种装法,三种落点,但读的都是同一份 SKILL.md。
装法一:Claude Code 官方插件市场。
/plugin marketplace add anthropics/skills/plugin install document-skills@anthropic-agent-skills市场名叫 anthropic-agent-skills,document-skills 是其中一个插件——它一次装四个:xlsx、docx、pptx、pdf。另外还有 example-skills(12 个示例)、claude-api、academy-guide 等。
装法二:直接拷目录。
git clone --depth 1 https://github.com/anthropics/skillscp -r skills/pdf ~/.claude/skills/最朴素,也最不容易出岔子。skill 就是一个目录,拷过去就是装上了。
装法三:用第四集那个 openskills。
npx openskills install ../skills/pdf三种装法,装完落在三个不同地方(插件目录 / ~/.claude/skills/ / .agent/skills/ 或 .claude/skills/),但里面那份 SKILL.md 一模一样。
这就是第一集那个论断的最终验收:格式统一,所以搬运成本几乎为零。你在这一季开头学到的那份规范,到这里变成了「同一份文件,三条路都能送到」。
五、拆开一个「好 skill」看看
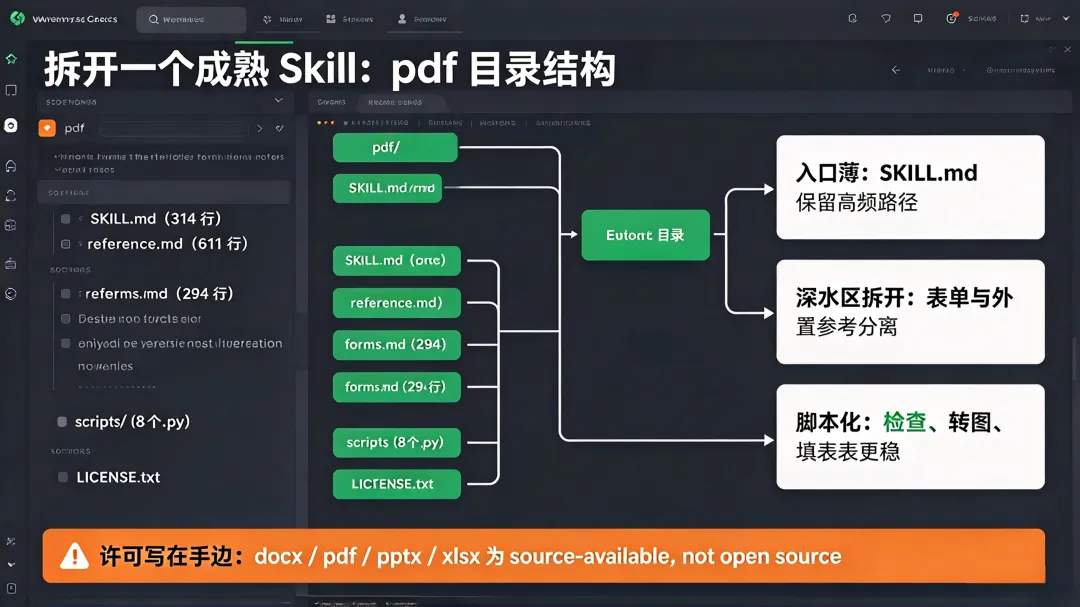
pdf 目录里到底有什么,值得单独看一遍:
pdf/├── SKILL.md (314 行)├── reference.md (611 行)├── forms.md (294 行)├── scripts/ (8 个 .py)└── LICENSE.txt这份结构本身就是第一集「渐进式披露」的活教材:
SKILL.md只有 314 行——第一集说建议别超 500 行,这份守着这条线。它只放最常走的路:用 pypdf读页数、抽文字、合并拆分、旋转;用pdfplumber抽文字和表格。- 重的东西拆出去了
。填充 PDF 表单是很长的一段流程,被放进 forms.md;进阶技巧、JavaScript 库、更多例子放进reference.md。SKILL.md里只留一句「要填表单,去读 FORMS.md 并照做」。 - 能脚本化的写成脚本
。 scripts/下 8 个.py:抽表单字段、检查可填字段、PDF 转图片、生成校验图、按注释填表……这些是「确定性操作」,写成脚本比让模型重新推一遍稳。 - 许可文件贴在旁边
。 LICENSE.txt跟技能放一起,谁拿谁看得到条款。
这就是一个成熟 skill 的样子:入口薄、深水区拆开、确定性步骤脚本化、许可写在手边。
六、实测:从一张 PDF 表到一份 Excel
不演示等于没说。这一节我把整条链路跑一遍——自己造一张带表格的 PDF,把表抽出来,再落到一份 Excel。
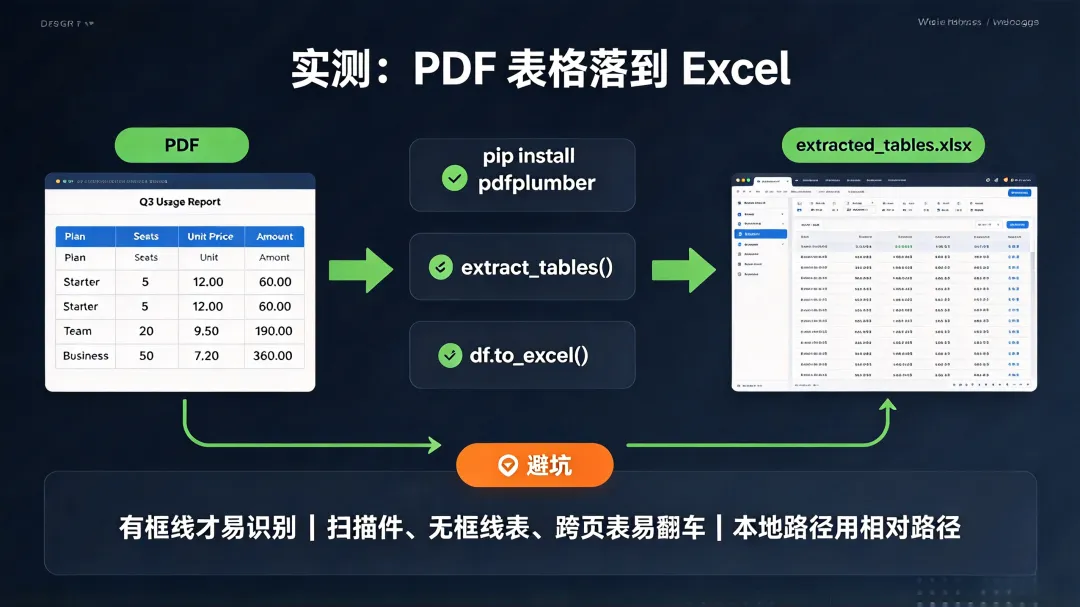
先说依赖:pdf skill 的两条主线是 pypdf(基础操作)和 pdfplumber(抽文字和表格)。前者一般都在,后者要装:
pip install pdfplumber第一步:造一张 PDF。 我用 reportlab 画一份带表格的「Q3 Usage Report」,五行四列,四周和中间都有框线:
from reportlab.lib.pagesizes import A4from reportlab.pdfgen import canvasc = canvas.Canvas("sample.pdf", pagesize=A4)w, h = A4c.setFont("Helvetica-Bold", 16)c.drawString(60, h - 70, "Q3 Usage Report")c.setFont("Helvetica", 10)rows = [ ("Plan", "Seats", "Unit Price", "Amount"), ("Starter", "5", "12.00", "60.00"), ("Team", "20", "9.50", "190.00"), ("Business", "50", "7.20", "360.00"), ("Total", "", "", "610.00"),]top, rh = h - 110, 24cols = [55, 195, 315, 435, 540]for i, row in enumerate(rows): y = top - i * rh for cx, cell in zip(cols[:-1], row): c.drawString(cx + 5, y - 16, cell)for i in range(len(rows) + 1): c.line(cols[0], top - i * rh, cols[-1], top - i * rh)for cx in cols: c.line(cx, top, cx, top - len(rows) * rh)c.save()第二步:抽表。 这就是 SKILL.md 里那几行,原样用:
import pdfplumberwith pdfplumber.open("sample.pdf") as pdf: for i, page in enumerate(pdf.pages): for j, table in enumerate(page.extract_tables()): print("Table %d on page %d:" % (j + 1, i + 1)) for row in table: print(row)我这边跑出来是:
Table 1 on page 1:['Plan', 'Seats', 'Unit Price', 'Amount']['Starter', '5', '12.00', '60.00']['Team', '20', '9.50', '190.00']['Business', '50', '7.20', '360.00']['Total', '', '', '610.00']五行四列,一行不多一行不少。
第三步:落到 Excel。SKILL.md 里给了一段「进阶抽表」,就是接上 pandas:
import pdfplumber, pandas as pdwith pdfplumber.open("sample.pdf") as pdf: all_tables = [] for page in pdf.pages: for table in page.extract_tables(): if table: all_tables.append(pd.DataFrame(table[1:], columns=table[0]))df = pd.concat(all_tables, ignore_index=True)df.to_excel("extracted_tables.xlsx", index=False)跑完真出了一份 extracted_tables.xlsx(5465 字节),打开就是这张表。
注意这一步的分量:这是 pdf 和 xlsx 两个 skill 的交接点。抽表靠 pdf,落表靠 xlsx 那一套(pandas + openpyxl)。你什么都没发明,只是照着两份 SKILL.md 各走了一段。
七、踩到的两件事
演示里最值钱的往往不是成功那次。我这两件事都是真踩的。
第一件:没有框线的表,一行都抽不出来。
我第一版 PDF 只画了横线,没画竖线。跑第二步,输出是空的——extract_tables() 一个表都没找到。
原因不复杂:pdfplumber 默认的抽表策略是看线。它靠页面上的水平线和垂直线推出格子边界;只有横线、没有竖线,它认不出「这一列到哪儿结束」,于是干脆不认为那是张表。
这不是工具的毛病,是PDF 这种格式的固有麻烦:文件里存的是「在某个坐标画一条线、在某个坐标放一段字」,而不是「这是一张表」。所以能不能抽出来,取决于原始 PDF 有没有可识别的结构。同一张表,有框线和没框线,结果是一个有、一个是零。
实用结论:抽不出来先别怀疑代码,先看一眼那张 PDF 长什么样。扫描件、无框线的排版表、跨页表,是三类最容易翻车的。
第二件:openskills 装本地目录,只认相对路径。
第四集介绍的 openskills,这一集我想拿它装 local 的 pdf。第一次我给了绝对路径:
Installing from: D:/CCWorkPlace/temp/anthropic-skills/skills/pdf- Cloning repository...✖ Failed to clone repositoryfatal: repository 'https://github.com/D:/CCWorkPlace/' not found它把我这个 Windows 绝对路径当成了 GitHub 的 owner/repo,拼出了 github.com/D:/CCWorkPlace/... 这么一个不存在的仓库。
换成相对路径就通了:
Installing from: ../anthropic-skills/skills/pdf✅ Installed: pdf Location: ...\.claude\skills\pdf限速提醒:openskills install 的本地路径,用相对路径。绝对路径(至少 Windows 上的)会被误判成远程仓库。
八、你这一季拿到了什么
五集走完,回头看一眼这条线:
- 格式是同一份
——一个目录加一份 SKILL.md,name和description两个必需字段 - Claude Code 怎么认
——位置决定谁看得见,命令名取自目录名 - Codex 怎么认
——同一份格式,换了个家和调用符号 - 怎么灌给别家
—— openskills把清单写进AGENTS.md - 装上跑一遍
—— pdf/xlsx/docx,从一张 PDF 表到一份 Excel
你现在手上有三样东西:一份能照着写的规范、几条验证过的命令、一个真跑通的例子。
这一季你要是只带走一件事,我希望是这个:skill 不是「装了就完」,是你得知道它靠什么被触发。description 写清楚,位置放对,名字跟目录对齐——这三条踩稳,剩下的都是搬运。
上面那个「有没有框线」的坑,我猜不止我一个人踩过。你遇到过的抽表失败是什么样? 说个场景,我看看能不能凑成一篇「PDF 抽表避坑」的续集。