ARTICLE · 1144466
AI 时代,我想把试算TB从 Excel 里搬出来,最近烧的Token让我确认了一件事
AI 时代,我想把试算TB从 Excel 里搬出来,最近烧的Token让我确认了一件事大家好,我是瓜哥。 这次想聊聊 AI 时代的 试算平衡表(Trial Balance,简称 TB) 设计。 TB 在审计作业中的重要性不用我多说,做过审计的应该都懂。客户给来的未审数、各科目底稿形成的调整、最终的审定数,都要在这里对上。以前的 TB 可能还主要是做试算平衡,这些年迭代下来,虽然还是用着 Excel,但已经兼顾了单体合并、披露数据同步到 Word 附注、各科目的勾稽校验的自动化流。 所以,做 TB 的产品,得一路想着数从哪儿来、怎么算、改了以后影响哪里、人怎么核对。这里多一处要手动维护的关系,项目组就多一份搬数、检查、找差异的负担。 三年前我开始在所里做 TB 产品,想把从试算到合并、报告附注一条龙都打通。从一个项目组跑通,到面向全所大几千人推广,不同类型的业务、不同风格和习惯、不同准则、不同期间的项目组,都得考虑。在一个组跑通的全套自动化,换一类业务、换一个人的使用习惯,就可能又冒出一堆问题。这个过程相当艰难,中间也挨了一年的骂,TB 设计里的绝大多数痛点,我都深有体会,我可以毫无谦虚的说,你们遇到过的没遇到过的情况我都遇到过了
现在,我想重新考虑一个问题:如果以后软件主要由 AI 操作,TB 还有必要继续放在 Excel 里吗? 这个假期烧了非常多的token,按我的思路写了一个面向Agent的TB,验证了一下自己的想法 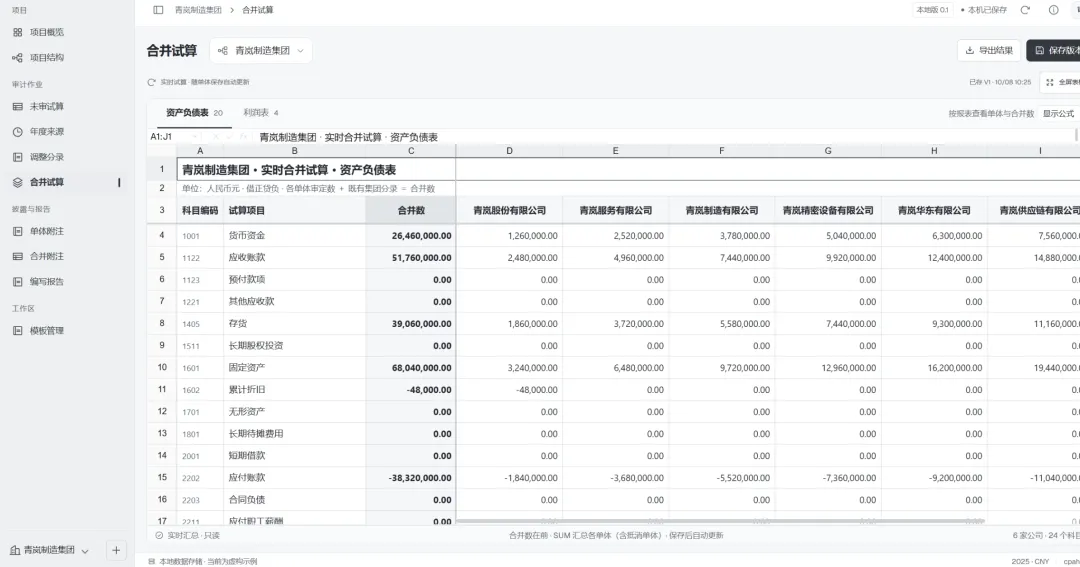
以前要我不用 Excel,我会直接狠狠地骂这个产品一顿。毕竟我在 Excel 里有一堆操作习惯和插件,这是我作业了多年的工具,除非你的产品有信心还原所有Excel的操作,并且我不需要重新学习。 所以当时做产品,我选择了 Excel/Word + 加载项的方案,模板也沿用大家熟悉的 Excel 模板。我们做了不少工程化的工作,把试算、合并、附注和报告之间的同步与校验打通。 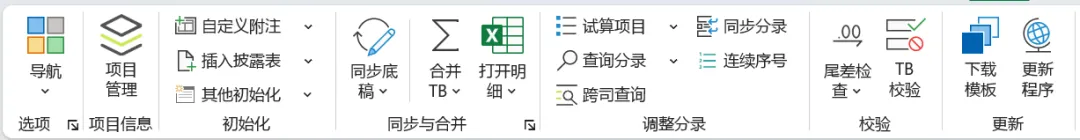
Excel插件↑ Word插件↓ 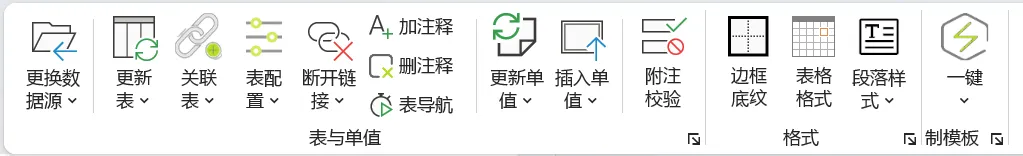
但整条链路做完整以后,学习成本也上来了。我回头看以前写的产品手册,为了解释为什么这么设计、哪些场景怎么处理,哪些表是否参与合并,哪些行是否参与披露,如何设计和定义自己的模板,写了 10w 字……用户还得理解锚点、列映射、汇总参数和校验标识。国资、上市和 IPO 的披露要求不一样,改一处模板,还得知道会影响后面哪一步。 Excel 和 Word 太灵活是一把双刃剑,你想怎么摆这些数据都可以,但是要维持数据关系,就得增加规则。软件有了自动化,人还是得花时间学。能玩得 6 的项目组,可以用它做出各种类别的模板;没时间踩坑的组,基本就是两眼一黑....
这有点像 Photoshop,功能够专业,但要学透是需要时间的。大家确实太忙了,一口气灌这么多规则,再叠加前期软件的 bug、Excel 本身的局限性和性能问题,还有一些项目组不太合适的Excel操作习惯,直接爆炸! 当然并不是说Excel不好,在我心里Excel依旧YYDS,我的Excel插件CPAHelper迭代到现在使用量10W+,所以我绝对不是一个排斥Excel的人,大部分项目组在未来很长一段时间内肯定还是会使用Excel的TB 对于产品来说很多东西没有绝对的好坏,最终都是取舍,我们这里讨论的是未来Agent完全渗透到我们工作的方方面面,TB该如何考虑 以前设计软件,我要考虑按钮放在哪里、用户怎样找到它、怎样按顺序操作,这是给人设计产品的思路。一个专业软件那么多功能,还要应对那么多情况,人学习起来太痛苦了。 那如果这个软件是给 AI 设计的,我把功能全部开放出来,文档写到 Skill 里,AI 照着需求去读、去操作,这部分学习成本不就交给它了么。 所以我的做法是把所有功能开放 CLI,也就是一组操作命令:建项、填数、写分录、设置校验、生成报告。配合Skill让这些命令和参数,让 AI 去学就行了。 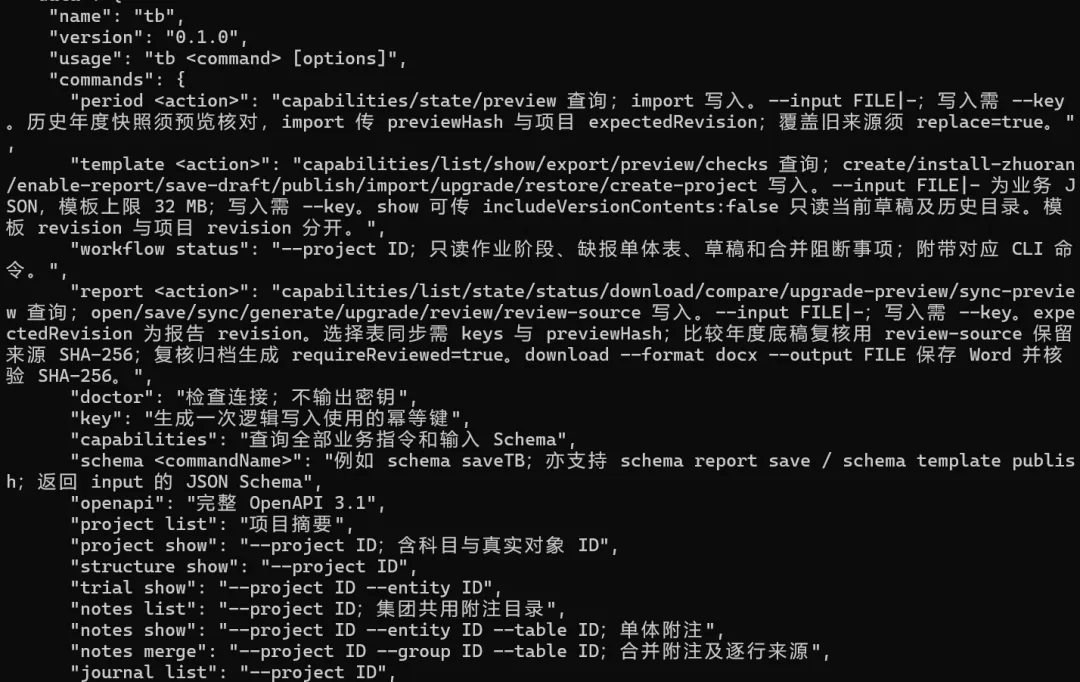
人告诉它要做哪个项目、用什么模板、数据在哪里、有什么特殊要求。AI 自己去读软件的规则,调用功能,最后把结果和需要处理的问题交回来。 比如:“看这个文件夹内的报表,把这几家公司的未审数填好。没给的数先留空,科目对应不确定的地方列出来。 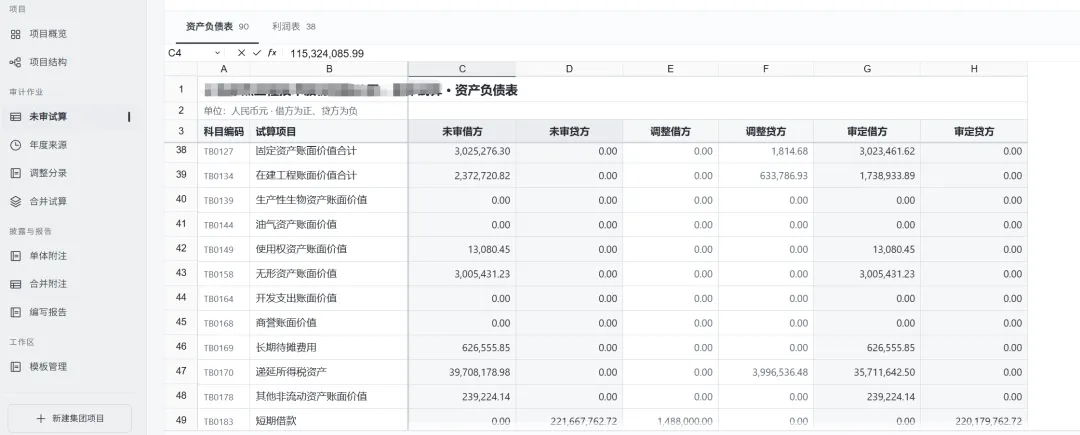
Agent调CLI能快速把表填好,效率上比操作Excel更高 AI 读取资料、查询模板,把能确定的数据填进去。填了哪些数、依据是什么、哪些地方缺材料,都要让我看得到。 附注也一样:有的数来自余额表,有的要从明细表、测算底稿里取,资料够的地方让 AI 搬过来,不够的地方留着问题。 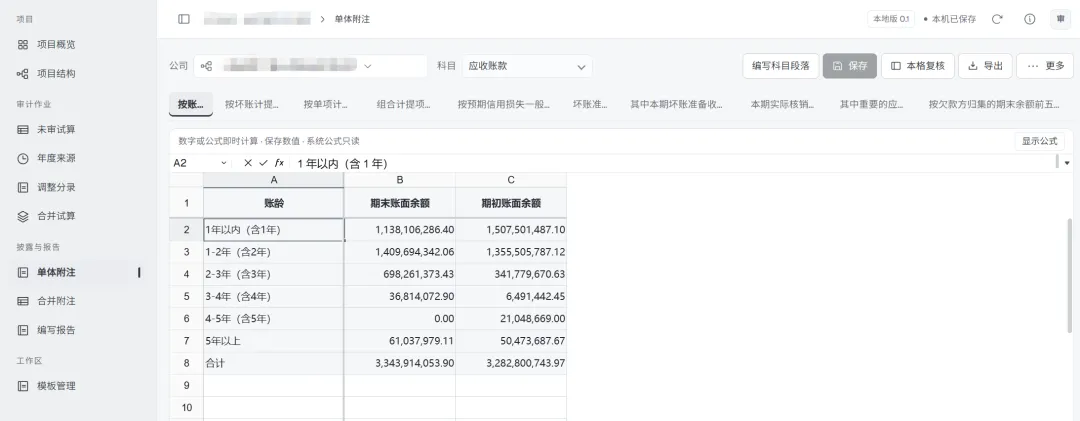
Excel 适合自由分析和建模,但“贴 TB”“贴附注”的主要工作是填数。为了搬数,让每个人先理解整套模板的内部结构,我觉得成本太高。 脱离 Excel 不代表软件内没有表格了,我仍保留了熟悉的表格界面,让人看数、改数、写分录;计算和存储放到结构化业务系统里,让 AI 也能操作同一套数据。 人打开 TB,需要看清数据是否有问题。 比如固定资产原值,期初加增加、减减少,要核对到期末;原值减累计折旧形成的净额,还要与审定试算核对。我希望也能用业务语言告诉 AI,让它通过接口配置这些校验。 国资、上市、IPO,以及项目里特殊的披露要求,也可以把口径告诉 AI,让它按要求设置。以前得自己记住在哪儿配、怎么配,现在让 AI 去学这套操作。 规则配完,我要能看见它取了哪些数、来自哪张表、差额是多少。这些信息既在界面上展示,也让 AI 能直接读到。我可以自己看,也可以让 AI 给我汇报,怎么方便怎么来。 复核这一步对于AI的操作结果和验收来说也非常重要,我们都很怕AI在填数的过程中出错,只要提前把验收规则以及填写的机制设计好,比如填了数必须查看勾稽校验是否正常,出错了软件直接返回错误值,AI回去根据错误进行二次修正,在ReAct循环中把数填好,那质量就是有保障的。 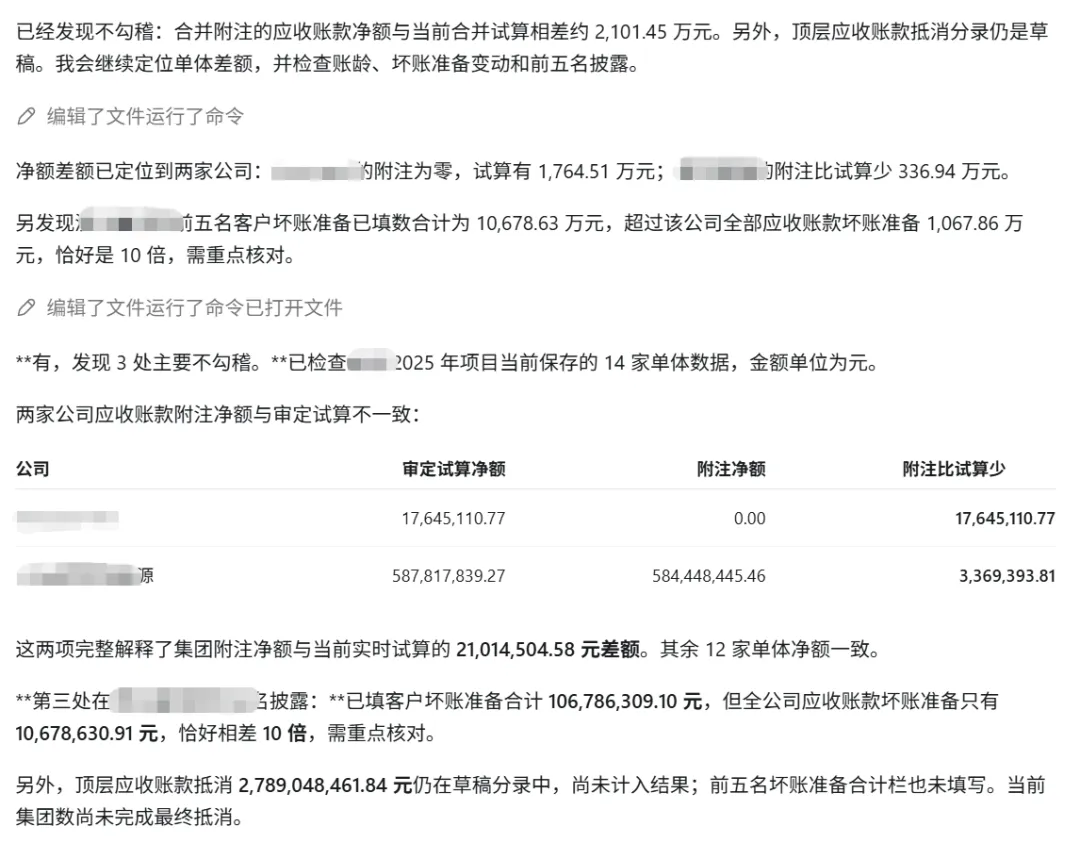
外部 AI 负责理解资料和调用接口,TB 软件负责保存、计算和校验,结果留给人复核。 以前在 Excel 里合并,我们已经按明细项目匹配,但还得维护行列、公式和链接。哪家公司加了行、哪张表换了结构,都要考虑。特别是主体一多,比如上来就要合并大几百家单体,在Excel中反复建链接、重算、重新合并,Excel 的性能也可能被拉爆。 脱离Excel,用结构化的数据可以直接记录一个数属于哪家公司、哪个科目、哪个期间、哪项明细。软件按业务关系汇总,减少对单元格位置的依赖,目标是让合并结果实时更新。 报告也是同样的思路。王老师的附注工具已经很好用了,我们在 Excel 到 Word 同步上也做了非常多的工作,节约了大量刷报告的时间,但毕竟还是跨了两个软件,这边改了数,那边要更新,中间的链接还得维护。 如果直接在一套软件里用同一套数据,报告表格就能沿着同一份来源更新。数据改完,先看差异,再同步生成新版本,人工写的段落和旧报告都保留,也省掉了跨软件维护链接的负担。 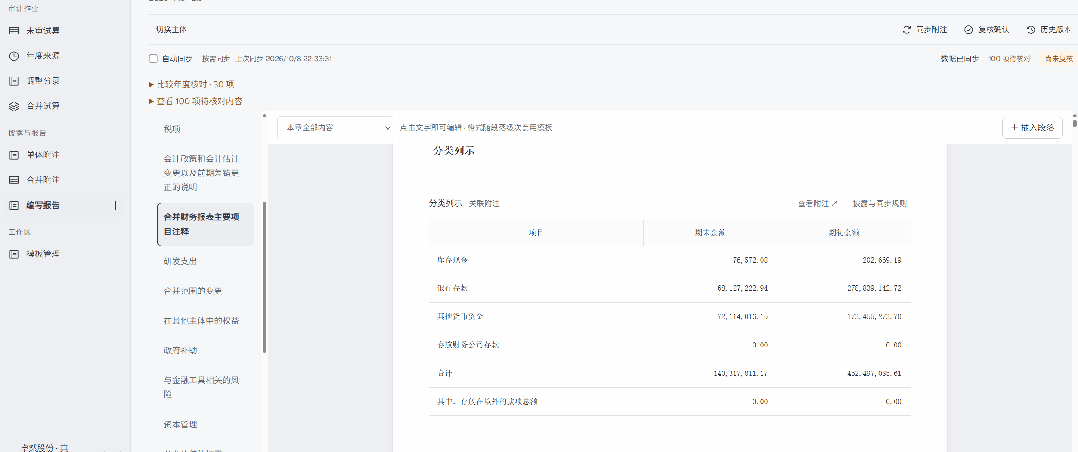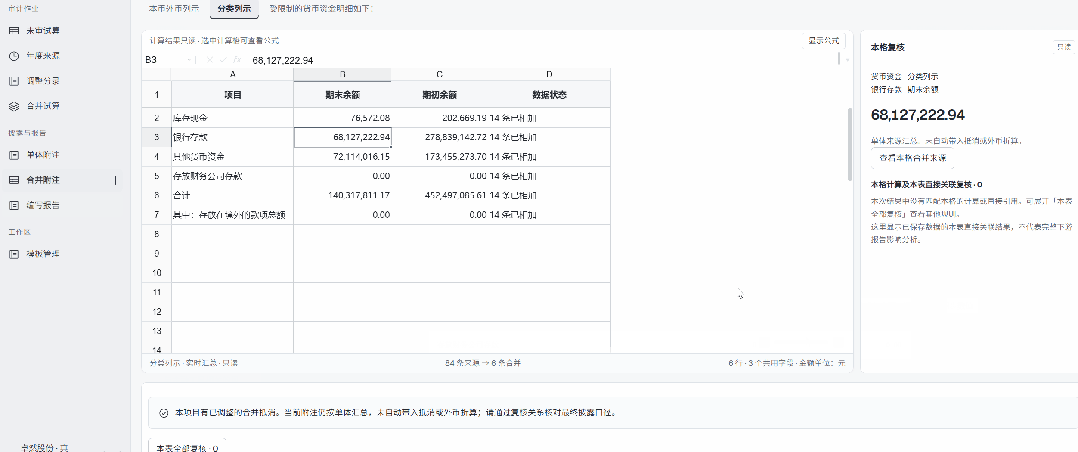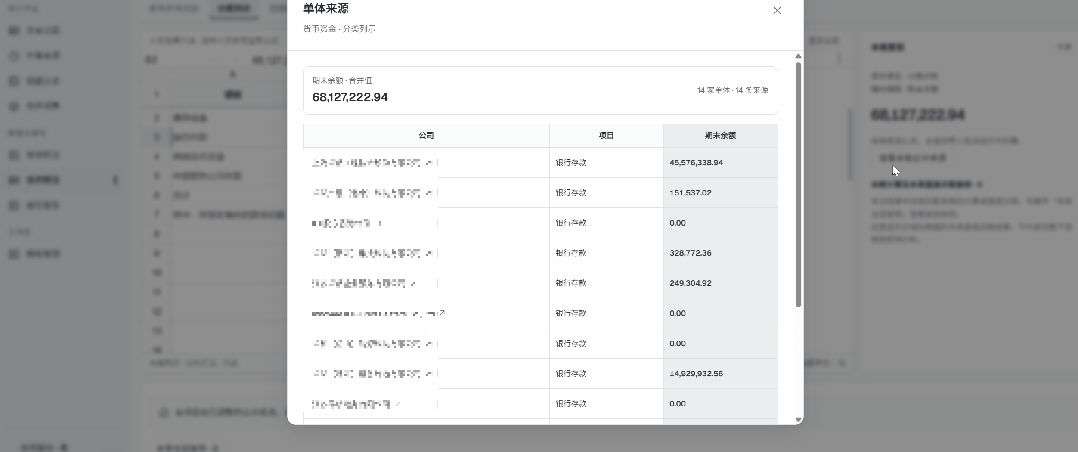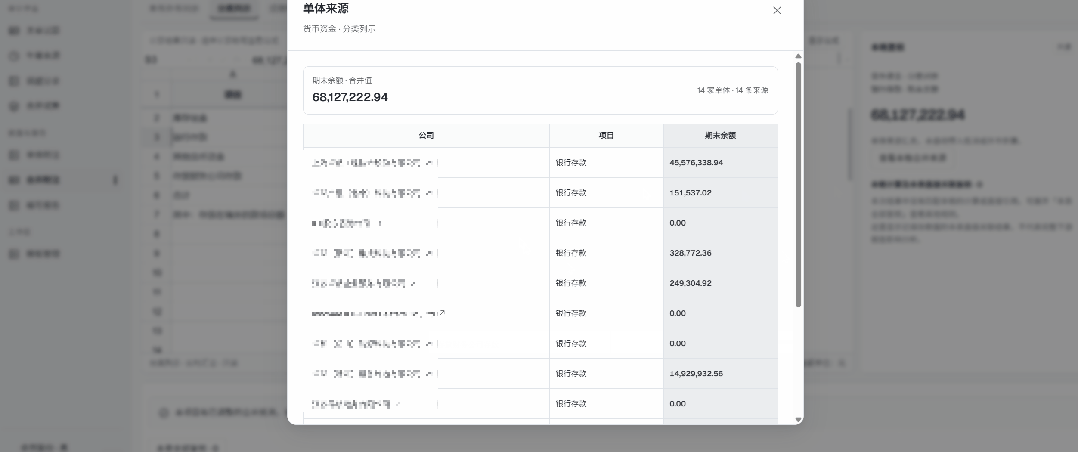
在一个软件内方便从报告披露附注直接跳转合并附注,看到组成部分数字的来源 目前,我把结构化数据、表格界面、CLI、校验和报告生成接了起来,从建项、填数、调整和附注,到改数后重新生成 Word,都走过一遍。至少从我 POC 的这条路径看,让Agent控制TB是完全能走通的,脱离Excel的底层逻辑是人不需要再花大量精力去操作这些数据,所以不需要Excel了(当然软件里面的表格编辑还是需要的) 所以以后人在 TB 里主要做复核和做调整,填数、搬运、汇总、配置这些活,让 Agent 接手就行了。那为什么不在TB中加一个侧边AI对话,而是把TB的所有功能开放?因为只有这样,整套 TB 作业才能成为 Agent 可以调用的一项能力,能直接接入完整的审计工作流。 当然,这条路仍然有门槛。AI 会接触到你的业务数据,数据安全这一关,得自己或者公司来解决。对模型能力的要求也比较高,得能理解资料、遵守规则、正确调用工具,数字上的差错率不能太高。 去年到今年年初,我一直觉得模型的算数不行,上下文长了,简单的加减法都会看错。但到了现在这个时点,大家应该也看到了 OpenAI 公布的内部模型数学成果库,截至 10 月 8 日已有 719 篇手稿、372 组相关成果,都是数学界人类很多年没有解答的难题,这些进展让我对模型理解复杂规则、数字推理和使用工具有了更多信心,相比起来,在审计行业中的TB填数,复核校验这种场景,简直就是小儿科了。 未来的 TB,或许真的不需要大家再去手搓 Excel 了,你们觉得呢?
01 我以前也离不开 Excel
02 让 AI 去学怎么操作
03 填数之后,用复核规则做好验收
04 合并和披露也换一种做法
05 最后
end