ARTICLE · 1144644
震惊!找 AI 工具不用再翻导航站了,这款国产 AI 垂直搜索引擎一句话帮你挑好
想找一个能在笔记本上跑的开源模型,去导航站点进「大模型」分类,几百个卡片排在那儿,哪个能本地跑、哪个要显卡、哪个只是个论文仓库,都得自己一个个点开看。用百度搜,前几页多是各种「十大 AI 工具」盘点,点进去往往又是另一个导航站。问 Perplexity 能得到一段总结,但换个问法,推荐的东西可能就不一样了。
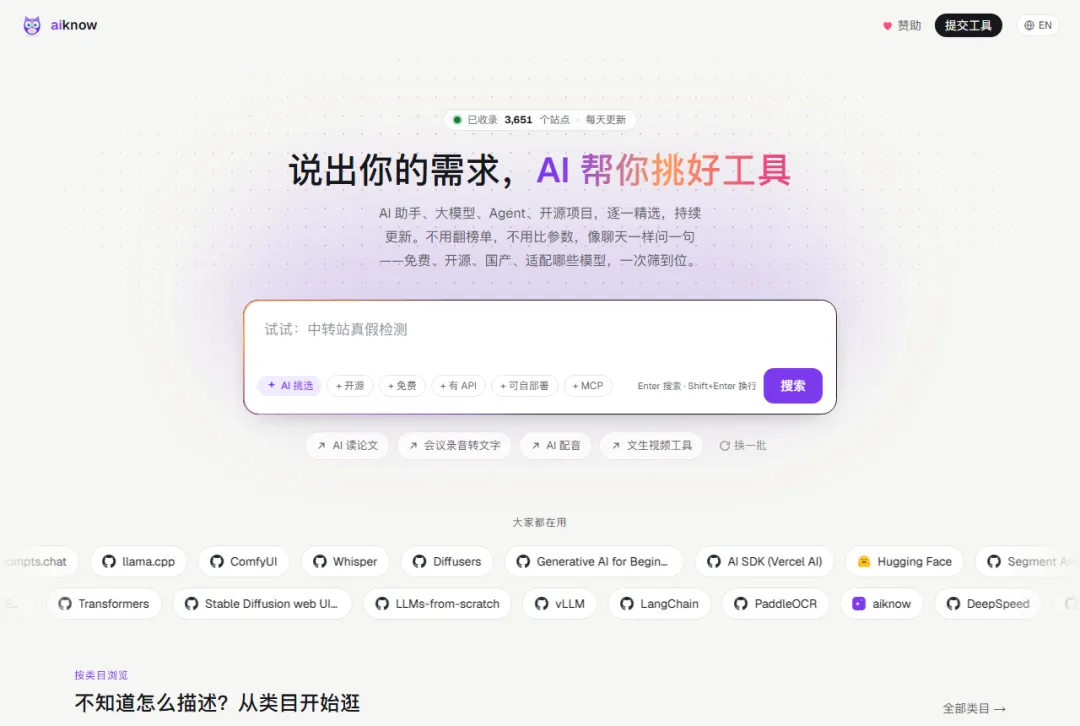
今天推荐一个专门解决这个问题的网站:aiknow(www.aiknow.cc)。它只干一件事,你用一句话说想要什么,它在一个整理好的 AI 工具库里帮你挑。比如输入「我想找个能本地跑的开源大模型」,它会把这句话拆成「开源」「本地模型」「开源模型」三个条件去筛,再用一两句话告诉你,显存小选哪个、追求效果选哪个。
下面说说它好用在哪,以及背后是怎么做的。
它和百度、Perplexity 有什么不一样
「AI 搜索引擎」这个词现在有点被用乱了,大致可以分三种。
百度、谷歌这种传统搜索引擎,搜的是网页。一个 AI 工具在网上会对应几十个网页:官网、评测、教程、新闻、搬运站。你搜「免费 AI 视频生成」,排在前面的往往是做了 SEO 的盘点文章,有时候还夹着广告。它们也主要靠关键词匹配,你写「能本地跑」,它就去找出现了「本地」和「跑」的网页。
Perplexity、秘塔 AI 搜索、Kimi 探索版这类是通用 AI 搜索。你问一个问题,它去全网搜一圈,读几十个网页,写一段带引用的回答。用来了解一件事很好用,但用来「挑工具」有两个毛病:推荐什么取决于它这次碰巧读到了哪几篇文章,同一个问题问两次答案可能不一样;它也没法让你接着按「开源」「有 API」去筛。
aiknow 属于第三种,AI 垂直搜索。它搜的不是网页,是一条条整理好的工具记录,每条都有一样的字段:价格、是不是开源、有没有 API、支持哪些平台、哪个国家的、能接哪些模型。所以它能精确筛选,排序也稳定。AI 只在最后出场,负责解释为什么推荐这个。
拿表格对比一下会清楚点:
这几种各有用处:想了解一个领域,问 Perplexity 更合适;明确要找一个能用的工具,垂直搜索更直接。在 aiknow 里搜「AI 搜索引擎」,出来的就是 Perplexity、Felo、Phind、Consensus,还有一堆开源的 Deep Research 项目,想自己搭一个的也可以看看。
工具库从哪来
现在库里有 3651 个 AI 工具、模型和开源项目,分在 100 个小类目里。
来源基本是开发者真在聊、真在推荐的地方:中文的 linux.do 等技术论坛,英文的 Hacker News、Product Hunt 和 X,GitHub 上的新项目,还有日本的 Zenn、韩国的 GeekNews、俄罗斯的 Habr,用来补各国本土的 AI 产品。用户也可以自己提交。
它只收 AI 工具本身,用 AI 写出来的普通 App、小游戏不收,所以搜出来的都是能直接拿来用的东西。
每条网址进来,要先抓网页,由大模型写一句话简介、提几个候选标签,再判断它是不是 AI 工具、该归哪一类。最后这一步用的是专门做判定的模型:给它一段内容和一道选择题,它只回答选项和概率。这个概率是校准过的,说 0.8 大概就是十次里对八次,所以可以按把握大小分流:很有把握的直接上线,很没把握的直接拒,拿不准的交给人工审核。
目前上线了 3651 个,拒了 597 个,另有 140 个链接失效被下架。系统每个月还会自动巡检一遍:链接打不开的下架;GitHub 仓库被删了、归档超过一年,或者一年半没提交而且星数不到一千的,也下架。AI 圈东西过期得快,这一步挺必要。
一句话是怎么被「听懂」的
还是拿那个例子:
我想找个能本地跑的开源大模型
它会被拆成三个条件:授权是开源,模型是本地模型,类型是开源模型。这三个直接当筛选条件,剩下的部分再交给关键词和语义检索。
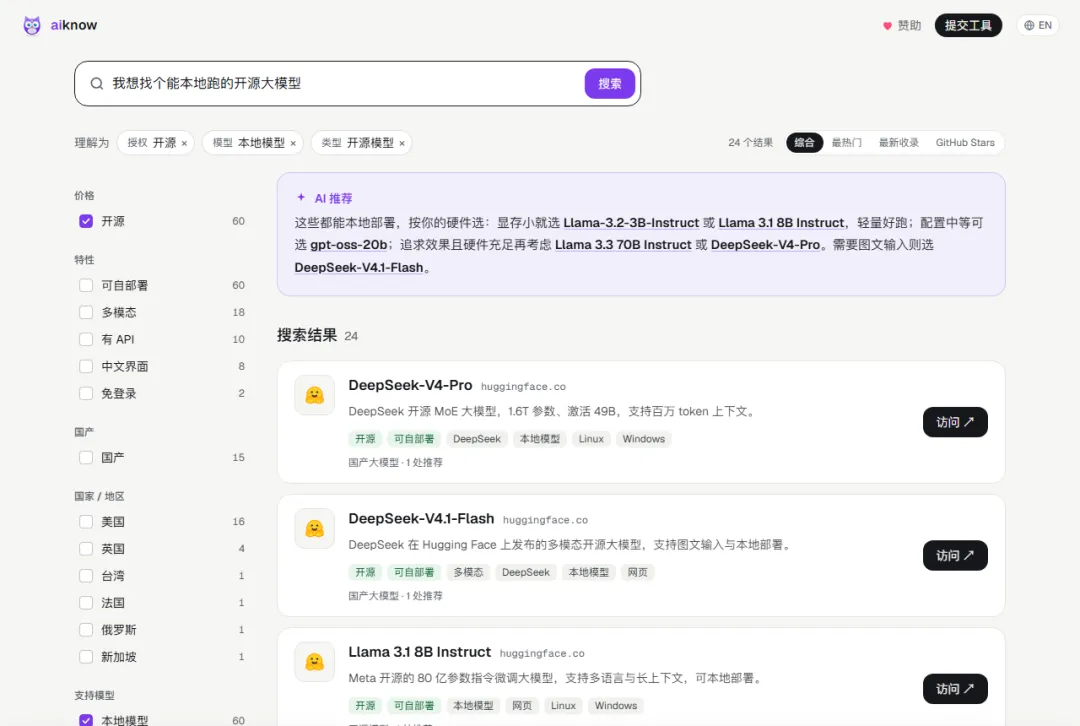
理解分两层。第一层是一本规则词典,专门对付高频、意思明确的说法。比如「抓包」「反代」「语音输入」这类词直接对应到类目;各种外号也认得,「大肥鱼」就是 DeepSeek,搜「雷布斯的 AI」会落到小米的 MiMo。
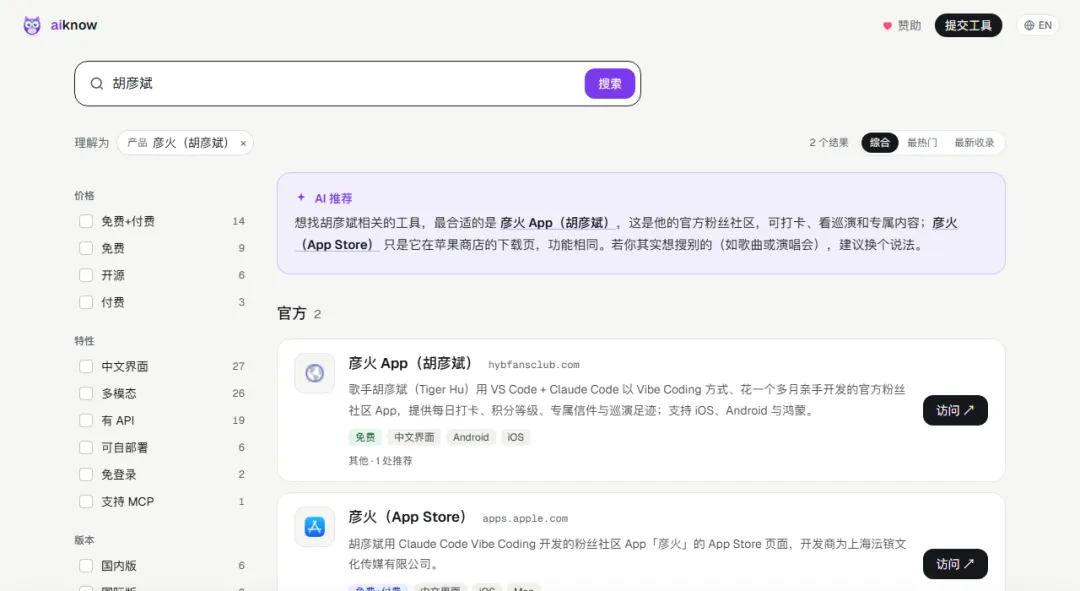
人名也能搜。胡彦斌今年学了 Vibe Coding,用 Claude Code 花一个多月亲手做了个粉丝社区 App,叫「彦火」,上了不少新闻。很多人只记得「胡彦斌做了个 App」,记不住名字。在 aiknow 里搜「胡彦斌」,会直接理解成「产品:彦火」,官网和 App Store 页面排最前:
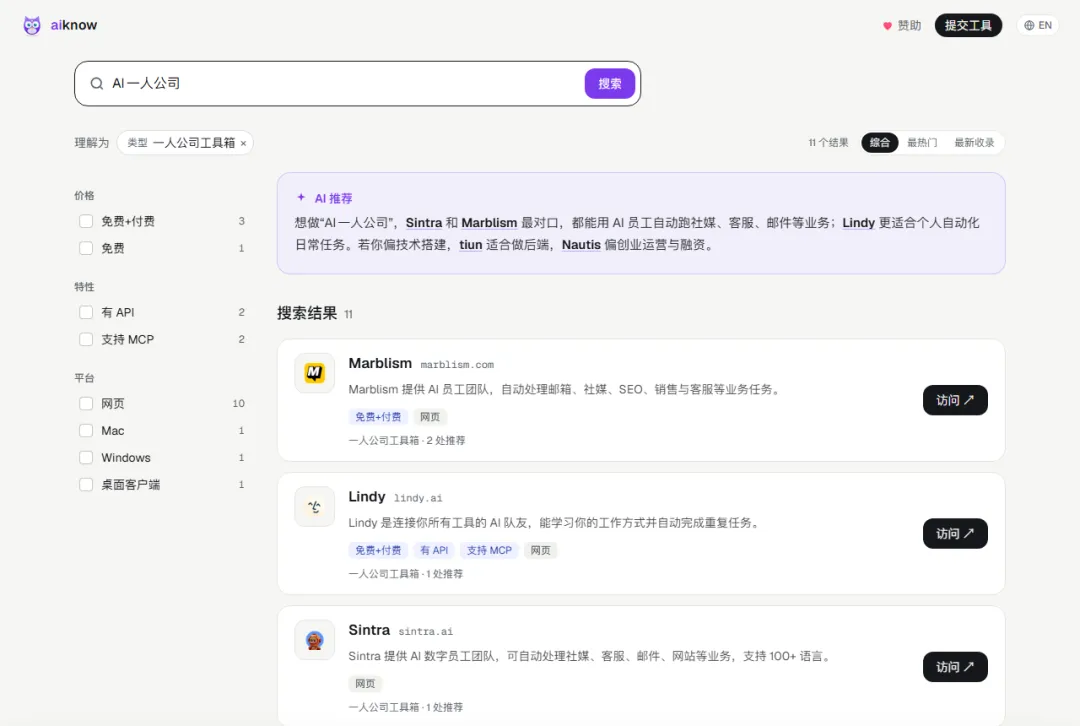
场景说法也行,比如「AI 一人公司」「一个人创业用什么 AI 工具」。这类说法会被理解成「一人公司工具箱」,出来的是 Marblism、Lindy、Sintra 这类能替你跑社媒、回客服、发邮件的「AI 员工」:
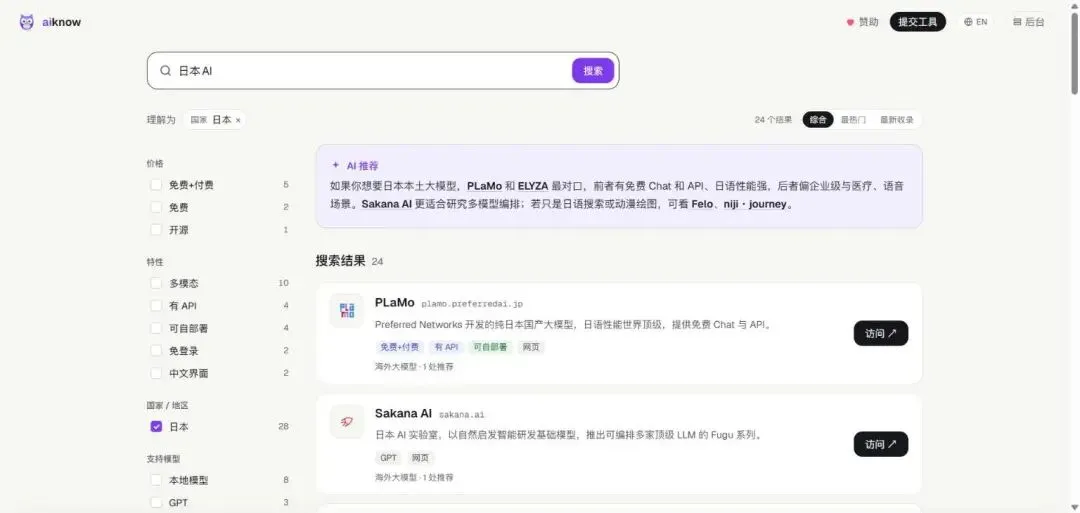
按国家找也可以。搜「日本AI」,理解为「国家:日本」,出来的是 PLaMo、Sakana AI、ELYZA 这些日本本土产品,不会给你一堆标题里恰好带「日本」两个字的网页:
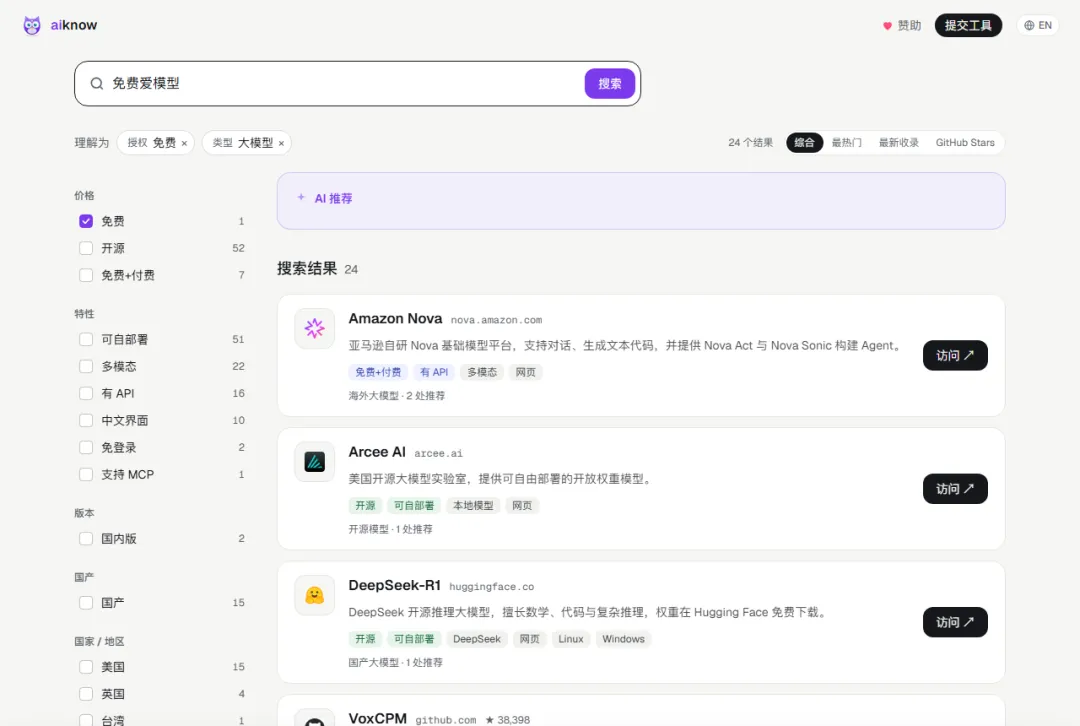
打错字也不怕。有人搜「饭代」,其实想打「反代」;还有人搜「免费爱模型」,是拼音输入法把「AI 模型」打成了「爱模型」。这些都会自动改过来:
第二层交给判定模型,处理词典覆盖不到的说法:这句话要的是哪一类工具,有没有隐含着「要免费」「要有 API」。概率不够高的条件就不用,宁可少理解一点,也不理解错。
为什么不全交给大模型?一是慢,让大模型吐一段结构化结果要好几秒;二是贵,每搜一次就调一次;三是不稳定,同一句话两次理解得不一样,结果排序就跟着跳。所以分工是:词典管高频的,判定模型管长尾的,大模型只在最后写推荐语。
几个热门搜索的实际效果
放几个最近搜得多的词,看看实际出来的是什么:
搜「Claude Code 国内平替」,理解为「国产 + 编程 Agent」,出来 Qwen Code、Kimi Code、Qoder、Trae、京东的 JoyCode。
搜「Nano Banana」,直接定位到 Gemini 那个生图模型,后面跟着 GPT Image 这些同类。
搜「免费的 AI 视频生成」,理解为「免费 + AI 视频」,可灵、LiblibAI、即梦、CapCut 排在前面。
搜「AI 做 PPT」,有 MindShow、Gamma、AiPPT、WPS AI,也有开源的 PPTAgent。
搜「数字人」,HeyGen、Synthesia、D-ID、讯飞智作、魔珐星云。
还有「抓包」。这个词以前搜出来是一堆逆向工具,后来网站专门加了「AI 抓包 / 流量分析」类目,收了各种把 Wireshark 接给 AI 的 MCP 服务、Burp Suite 官方的 MCP、mitmproxy、Charles、Reqable 的 AI 版,还有能看 Claude Code、Codex 往外发了什么请求的 claude-tap。网管排查断网丢包、开发者抓手机 App 的包,现在都能直接搜到。
这些词都不是某个产品的名字,是一类需求,正好是导航站和通用搜索引擎最吃力的地方。
排序和 AI 推荐
检索是关键词和向量混着来。关键词管精确匹配,比如搜「Cursor 替代」,Cursor 这个词必须命中;向量管意思相近,「能本地跑」「离线部署」「self-hosted」字面完全不一样,意思差不多。
只说了一个类别的搜索,比如「AI 绘图」「日本AI」,会单独换一套排序:主类目对得上的优先,产品本身优先于周边项目,再按热度排。不然排第一的很可能是某个「Awesome 合集」或者论文仓库,Midjourney 反而挤不进前十。条件叠太多、筛不出结果时,它会按优先级逐个放宽条件,并告诉你放宽了哪一个。
搜索结果上面那段 AI 推荐,只看这次结果里前几个工具的简介、标签和数据,只推荐列表里有的东西,不会凭记忆推荐列表外的产品。它会把取舍说出来,比如「A 最贴合,但它其实是个 IDE;B 免费,可只做语音输入」,帮你少点开几个网页。推荐语还会缓存,同样的搜索词和结果直接复用。就算 AI 服务临时出问题,也只是这一段不显示,搜索照常能用。
适合谁用
想找 AI 工具、又懒得在导航站里一个个翻的人;想按「免费」「开源」「有 API」「能本地跑」这些条件精确筛选的开发者;想看看某个国家、某个场景有哪些 AI 产品的人。
目前收录 3651 个工具,100 个类目,覆盖 AI 助手、国内外大模型、API、AI 编程、Agent、MCP、Skills、RAG、绘图、视频、语音等,中英文都有,免费,不用注册。也有不足,比如很小众的需求覆盖还不够,AI 推荐偶尔会把「沾点边」的说成「最合适」。
地址:www.aiknow.cc(复制到浏览器打开)
做了 AI 工具、模型或者 MCP 服务,也可以在网站上直接提交,审核过了就能被搜到。