ARTICLE · 1149164
AI 时代,软件手册该为 Agent 重写一遍
AI 时代,软件手册该为 Agent 重写一遍
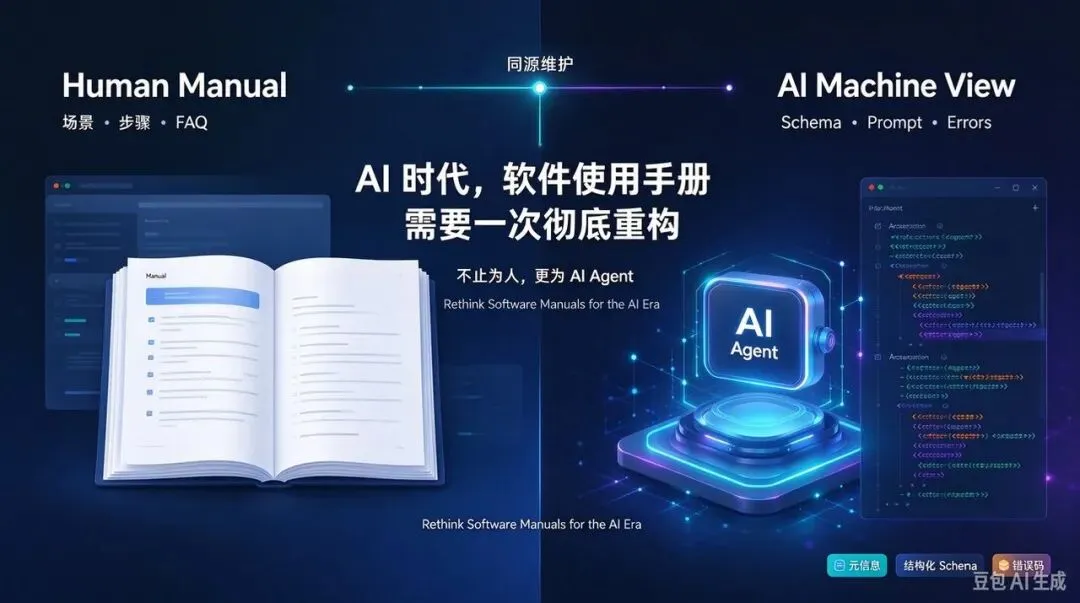
我们一直在谈 AI 赋能、智能自动化、Agent 落地,但有一个最基础、最致命的底层问题被忽略了:今天 99% 的软件工具手册、产品文档、操作指南,都是「仅为人类设计」的。
企业花大量成本训练 AI、搭建 Agent 工作流,却因为文档不支持 AI 高效读取,出现调用错乱、参数幻觉、执行失败、反复重试——AI 落地成本被拉高,自动化成功率被压低。
本文只回答一个问题:如何让工具文档成为 AI 稳定调用的基建。 不涉及模型微调方法,也不讲具体文档工具教程。
你将学到三点
- 目标决定内容
——传统手册的目标是「让人学会用」,AI 手册的目标是「让机器稳定、低成本、零幻觉地调用」。目标不同,内容体系必须拆分。 - AI 专属手册是六个模块,不止 Prompt
——元信息、结构化 Schema、调用约束 Prompt、Few-Shot 样例、错误码容错、AI 可读变更日志,缺一不可。 - 落地二选一
——中小工具、快速验证用「单文档双分区」;核心业务、企业级系统用「双文档分离」。
为什么传统手册,完全不适配 AI
很多团队的落地误区是:直接把现成的产品手册喂给大模型,指望 AI 能自主学习、正确调用工具。结果往往是——AI 读得懂、用不好,看似能用、极不稳定。
两者的根本差异在于目标不同:
人文手册有四项天然属性,恰好与 AI 调用的需求完全相悖:
- 信息冗余,Token 成本极高。
产品介绍、操作小贴士、案例故事对人类学习有价值,对 AI 工具调用完全无用。多余文本持续占用上下文窗口,拉高推理成本与响应延迟。 - 语言模糊,充满歧义与默认常识。
「适量填写」「按规则操作」「特殊情况除外」——人类凭经验能懂,AI 会直接产生幻觉、边界判断错误。 - 无结构化定义,机器无法精准解析。
传统手册极少严格定义参数类型、必填项、枚举值、返回结构、错误码、限流规则。没有标准化结构,AI 只能靠模型泛化能力猜测调用规则,容错率极低。 - 只讲「怎么做」,不讲「不能做什么」。
人文手册几乎不会标注能力边界、高危操作、禁止行为、参数禁忌——而这恰恰是防止 AI 越权、误用的核心约束。
方案总览:人机双轨文档体系
我们不需要废弃传统人文手册,而是建立**「人机双轨」的全新文档架构**:一套面向人类学习阅读,一套面向 AI 解析调用,同源维护、独立读取、各司其职。
同源维护 │ ┌───────┴───────┐ ▼ ▼ 人文视图 AI 机器视图 manual.md tool-ai-spec ───────── ───────────── 场景/步骤/截图 元信息 + Schema FAQ/排错 约束 Prompt + 错误码 面向「学」 面向「调」 三条设计规则,经得起迭代:
- 绝不让两套视图互相污染
——AI 视图不塞故事,人文视图不塞参数表。 - Prompt 只是 AI 视图的一个模块
,不是全部;单独优化 Prompt,解决不了 Schema 与错误码缺失的问题。 - 同源维护、独立读取
——文档更新时两套视图同步更新,避免新旧规则冲突。
AI 专属手册的六个核心模块
1. 工具元信息(AI 识别基础)
模型读取文档的头部信息,用于快速识别工具定位、成本与状态,避免无效调用:工具唯一标识、版本号、更新时间、废弃标记;一句话能力摘要;能力边界——明确工具「不能做什么」,这是防幻觉核心;调用成本、限流规则、最大并发、超时时间。
2. 结构化 Schema 定义(精准调用核心)
用机器可解析的标准化结构替代模糊的文字描述,杜绝参数猜测,对标 OpenAPI 规范:输入参数的名称、类型、必填/可选、枚举约束、取值范围;返回参数的字段定义、默认值、空值规则;批量调用的数据条数上限与文件尺寸约束。
{"tool_id":"export-report","version":"2.1.0","cannot_do":["不支持导出超过 30 天的历史数据"],"input":{"format":{"type":"enum","values":["csv","xlsx"],"required":true},"rows":{"type":"int","min":1,"max":50000,"default":1000}},"errors":{"E429":"retry_after_60s","E403":"abort_and_report"}}这段示例想说明的是:参数类型、枚举值、边界、错误码全部是声明式的——AI 读到的是规则而不是需要推理的散文,数据格式对错从此由 Schema 保证,而非靠模型猜。
3. AI 专属调用约束 Prompt(行为规则核心)
Schema 解决「数据格式对错」,专属 Prompt 解决「AI 行为逻辑对错」,核心包含四类规则:
- 调用前置校验规则
:参数非空校验、枚举匹配、权限校验逻辑 - 禁止行为规则
:禁止批量超限、禁止越权调用、禁止自定义参数 - 失败处理规则
:不同错误码的重试策略、终止策略、上报策略 - 结果输出规则
:返回数据的整理格式、禁止编造信息、精简要求
4. 极简 Few-Shot 样例
摒弃冗长的人类操作案例,只保留高保真、极简的「输入–输出」样例,用最少 Token 帮助 AI 快速对齐标准调用逻辑,降低理解偏差。
5. 完整错误码与容错策略
单独梳理机器可读的错误码体系,明确每一类报错的成因与 AI 自动化处理方案,解决调用失败后盲目重试、卡死流程的问题。
6. AI 可读版本变更日志
标记参数新增、废弃、规则变更内容,让 AI Agent 自动适配工具版本迭代,避免新旧规则冲突导致的批量调用失败。
两种落地方案:按迭代节奏选
manual.mdtool-ai-spec.json 面向 AI,含 Schema、Prompt、错误策略、样例 |
决策规则:先用单文档双分区验证价值,工具进入核心链路后再升级为双文档分离。
效果与收益:赢在效率与性价比
很多团队误以为「优化文档是小事,优化模型才是大事」,但实际落地中,文档标准化带来的收益,远高于小规模模型微调(就我们观察到的落地案例而言,效果因团队与工具复杂度而异):
- 大幅降低 AI 运行成本
——机器可读文档剔除无效冗余,减少上下文 Token 消耗,降低推理成本与响应延迟。 - 彻底降低幻觉与调用失败率
——Schema + 强约束 Prompt + 明确边界,从源头杜绝参数编造、越权调用,让工具调用从「猜测式」变成「确定性」。 - 让 AI 工作流可维护、可迭代
——工具版本迭代同步更新 AI 规范文档,无需反复微调模型、重写 Prompt。
反对意见与适用边界:主张「先优化模型、文档以后再说」的团队,在模型能力持续提升的语境下短期或许成立;但只要工具仍在迭代、Agent 仍在批量调用,文档不结构化带来的调用失败与重试成本就会持续累积。两种方案都保留了「不足」一栏——轻量方案结构化不够严谨,企业级方案初期改造成本更高,按阶段取舍即可,不存在一步到位的免费方案。
总结
- 目标不同,内容必分
——人文视图与 AI 机器视图必须双轨并行。 - 六个模块缺一不可
——Prompt 只是其中之一。 - 先选对落地节奏
——轻量用单文档双分区,企业级用双文档分离,先验证价值再升级标准。
在 AI 智能化转型的早期阶段,真正拉开团队差距的,往往不是模型选型、算法能力,而是标准化、机器可读的基础基建。不妨先从你手头最核心的一个工具开始,把它的「AI 参考区块」写出来。
你的团队是怎么给 AI 喂工具文档的?欢迎在评论区聊聊踩过的坑。