ARTICLE · 1153635
国产AI芯片软件栈横向对标(下)——四条路线一张表
一句话摘要:用一张六维对标表,把昇腾之外的寒武纪、海光、摩尔线程、昆仑芯放进同一坐标系;先看它们各走哪条兼容路线,你就知道该用哪种迁移姿势、成本大概是什么级别。
0. 先说清楚:本文的事实边界
本文四家厂商的组件名称(SDK、框架插件、算子库、通信库、编译器)均来自各自官方一手来源(官网、官方文档站、官方 GitHub/Gitee 组织),写作时已逐条核对,文末附来源。
三点务必注意:
版本与型号是易变信息,本文按「截至 2026-09」标注;芯片型号演进(如寒武纪 570/590、海光 K100/BW、昆仑芯 P800)以官方最新页面为准。 标「待验证」的项不在正文断言,例如昆仑芯通信库 BKCL 的全称、海光软件栈代号 DAS 的全称、摩尔线程 S4000 的显存数值、寒武纪「思元 690」的商品名——这些我未在官方一手页核实,故不写进结论。 本文的「迁移成本分级」是基于兼容策略的架构判断,不是实测成本;真实成本取决于具体负载的算子覆盖(02 的昇腾实测锚点已展示过自研派的工程税)。
1. 为什么写这篇
02 拆透了昇腾——它是国产里的「自研派」标杆:自己造了整套 CANN(AscendCL / GE / ATC / TBE)[10],代价是迁移要重写算子。
但国产不止昇腾这一种打法。另外四家,其实走了三条完全不同的路线。这篇文章就把它们摆到一张表里,让你一眼看清「谁借了谁的生态、你上车的姿势是什么」。
2. 先看四条「兼容路线」
对标之前,先回答最关键的一个问题:一条 CUDA 代码要跑上这家芯片,走哪条路?
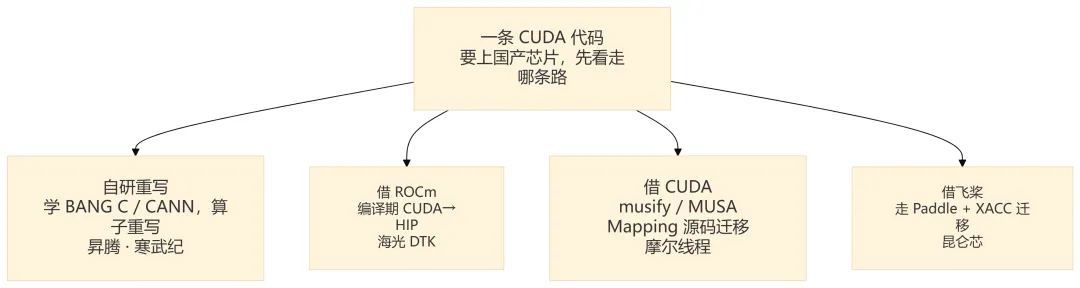
自研派(重写):昇腾(02 已拆)、寒武纪。软件栈完全自研,不宣称兼容 CUDA/ROCm,迁移 = 重写算子,学习成本最高。 借 ROCm(编译期转换):海光。DCU 走 AMD ROCm/HIP 生态,DTK 提供「CUDA 源码 → HIP」的编译期转换,你基本不用改源码,但要接受 CUDA 版本覆盖和架构差异(如 warp size = 64)。 借 CUDA(源码迁移):摩尔线程。MUSA 主打「CUDA on MUSA」,用 musify 文本替换或 MUSA Mapping 编译期 AST 重写,把 cuda*换成musa*再编译。借飞桨(生态迁移):昆仑芯。深度绑定百度飞桨,模型走飞桨原生 XPU 后端;PyTorch 靠定制构建,推理靠 vLLM-Kunlun。
一句话:海光借 ROCm、摩尔线程借 CUDA、昆仑芯借飞桨、寒武纪谁都不借自己造。路线定了,迁移成本的大盘就定了。
3. 统一标尺:六个对标维度
02 已经把 CUDA 拆成六层。横向比较四家时,我们不再逐层铺开,而是把六层收敛成六个可横向比较的维度:
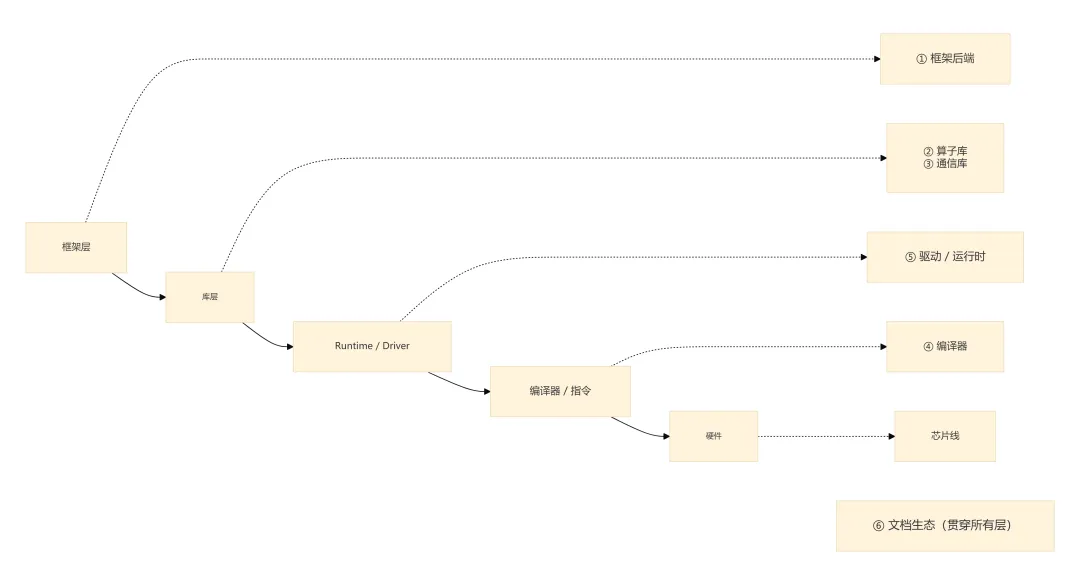
后面第 4 节的对标表,就是按这六个维度填的。
4. 横向对标表(核心)
下表每一格都是官方精确名称(非俗称),五家并排(昇腾来自 02,作参照):
| 兼容策略 | |||||
| 框架后端 | |||||
| 算子库 | |||||
| 通信库 | |||||
| 编译器 | |||||
| 驱动 / 运行时 | |||||
| 文档生态 |
表格只给「是什么」;「意味着什么」和「已知限制」看下一节。
5. 逐厂商要点
5.1 寒武纪:最像昇腾的「自研派」
软件栈统称 Cambricon NeuWare,编程语言是自研的 BANG C/C++(CUDA-like 语法: __mlu_global__、<<<>>>)。组件命名整齐,且有类 PTX 的中间层 MLISA:CNCC(BANG 编译器)→ CNAS(MLISA 汇编器)→ 设备二进制,这和 CUDA 的 nvcc→PTX→SASS 一一对应 [1]。 运行时也分两层:CNRT(对标 CUDA Runtime)、CNDrv(对标 Driver API);监控命令 cnmon 对标 nvidia-smi。 推理侧靠 MagicMind(基于 MLIR 的图编译引擎)。 已知限制:官方明示 Edge 平台不支持 CNCC/CNAS/LLVM-MM;框架后端强绑定特定框架版本(如 torch_mlu 对应 PyTorch 2.1.0)[1]、[2]。
5.2 海光:借 ROCm,上车最快但要认架构差异
DCU 走 ROCm/HIP 生态,开发套件是 DTK(DCU Toolkit);DTK 同时提供 HIP 和 CUDA 两种编程模型,CUDA 是「编译期转 HIP」[3]、[4]。 通信库用 RCCL,算子库直接复用 ROCm 的 rocBLAS / hipBLAS / MIOpen,框架后端以飞桨官方 DCU 版 + vLLM/SGLang/JAX/Triton 的官方 -das适配仓库为主 [3]、[4]。已知限制(据官方适配文档):DCU 的 warp size = 64(CUDA 是 32),移植要改;DTK 的 CUDA 兼容版本较旧、部分 API(如 cufft 系列)未实现 [4]。
5.3 摩尔线程:借 CUDA,迁移姿势最像「替换编译」
MUSA 统一架构主打「CUDA on MUSA」:musify 做纯文本 cuda*→musa*替换,MUSA Mapping 做编译期 AST 重写,约 3 万条映射 [5]、[6]。组件命名是对 CUDA 的「镜像」:mcc(对标 nvcc)、MTRTC、muDNN / muBLAS(MUSA-X)、MCCL(对标 NCCL)、MUSA Driver + libmusart。 已知限制(官方明示):MUSA Mapping「非运行时模拟、仅源码级映射、不保证所有 CUDA API 语义一致」;musify「纯文本匹配、可能误改」;MCCL 仅部分架构提供(官方 README 标注 S4000,S80/S3000 无)[5]、[6]。
5.4 昆仑芯:借飞桨,Paddle 是主门、PyTorch 是侧门
芯片分 K 系列(1 代)→ R 系列(2 代)→ P800(3 代);软件栈是「昆仑芯 SDK」全栈,编译器 XACC(基于 LLVM/Clang)主打「零代码侵入自动迁移」[7]、[8]。 飞桨有原生 XPU 后端( paddlepaddle_xpu包、WITH_XPU/BKCL编译项),通信库 BKCL;PyTorch 靠「昆仑芯分支 / xpytorch 定制构建」;推理由百度开源的 vLLM-Kunlun 承载 [8]、[9]。已知限制:官网暂无独立开发者文档中心、SDK 不面向公众开放下载;公开的 PyTorch 分支长期未更新;TensorFlow 后端未在官方渠道找到(待验证)[7]、[8]。
6. 替换路径:你上车的姿势和成本
把第 2 节的四条路线,落到「迁移类型」上:
| 源码级迁移 | |||
| 源码级迁移 | |||
| 生态迁移 + 部分重写 | |||
| 重写(自研) | |||
| 重写(自研) |
这是架构判断,不是实测:真实成本取决于你负载的算子覆盖——路线再「省事」,踩到一个缺失算子或一条未测的并行组合,成本就会反超(02 的昇腾实测已证明这一点)。
7. 选型判断清单
横向比较国产芯片时,按这个顺序走:
先问兼容路线:自研(昇腾/寒武纪)、借 ROCm(海光)、借 CUDA(摩尔线程)、借飞桨(昆仑芯)——它决定迁移的大盘。 再查算子覆盖:你的模型里最不常见的算子(MoE 路由、稀疏注意力、多模态注入、投机解码),官方是否已支持?这是真实成本的最大变量。 看通信库与多卡:多卡训练/推理看通信库(HCCL/CNCL/RCCL/MCCL/BKCL)是否覆盖你的并行策略和卡型号。 看版本锁定成本:框架后端是否强绑特定框架版本?升级一次要重新验证多少? 看文档与 SDK 可得性:SDK 是否公开下载?文档是否可自助排查?(这是昆仑芯、海光这类「B 端为主」厂商和昇腾、摩尔线程的明显差异。)
8. 思考题 + 下期预告
思考题
海光「借 ROCm」和摩尔线程「借 CUDA」,在「迁移一个带自定义算子的模型」时,各有什么不同的坑? 为什么「借生态」路线省了自研的账,却可能在算子覆盖和版本锁定上补回来? 拿到一张「兼容 CUDA」的宣传页,你应该追问哪几个具体问题才能判断是不是真兼容?
下期预告
四条路线看清了,下一步是从下到上走一遍替换:驱动 → 运行时 → 算子 → 框架 → 通信,每一层替换的先后顺序、验收标准和回退方案。下一期《国产芯片杂谈系列(四):从下到上的国产替换路径》,把今天这张表变成一条可执行路线图。
参考资料
[1] Cambricon NeuWare / CNToolkit 官方文档站(CNCC/CNAS/LLVM-MM/MLISA/CNRT/CNDrv/CNNL/CNCL 组件). https://www.cambricon.com/docs/sdk_1.15.0/cntoolkit_3.7.2/cntoolkit_install_3.7.2/index.html (查阅 2026-09-30)
[2] Cambricon 官方 GitHub 组织(torch_mlu / mlu-ops / vllm-mlu 等). https://github.com/Cambricon (查阅 2026-09-30)
[3] Hygon 官方 GitHub 组织 HYGON-AI(vllm-plugin-das / sglang-das / triton-das / jax-das 等). https://github.com/HYGON-AI (查阅 2026-09-30)
[4] PaddlePaddle 官方文档:DCU 硬件支持(paddlepaddle-dcu / WITH_ROCM / RCCL / DTK). https://www.paddlepaddle.org.cn/documentation/docs/zh/guides/hardware_support/dcu/install_cn.html (查阅 2026-09-30)
[5] MUSA SDK 官方文档中心(MUSA 架构 / MUSA-X / MCCL / mcc / musify / MUSA Mapping). https://docs.mthreads.com/musa-sdk/version-5.2.0/introduction (查阅 2026-09-30)
[6] MooreThreads/torch_musa 官方仓库(MCCL 架构限制等). https://github.com/MooreThreads/torch_musa (查阅 2026-09-30)
[7] 昆仑芯官网(XPU 架构 / 昆仑芯 SDK / XACC). https://www.kunlunxin.com/ (查阅 2026-09-30)
[8] baidu/vLLM-Kunlun 官方仓库(P800 / xpytorch / 算子包). https://github.com/baidu/vLLM-Kunlun (查阅 2026-09-30)
[9] PaddlePaddle 官方文档:昆仑芯片运行飞桨(paddlepaddle_xpu / WITH_XPU / BKCL). https://www.paddlepaddle.org.cn/documentation/docs/zh/2.5/guides/hardware_support/xpu_docs/index_cn.html (查阅 2026-09-30)
[10] 华为昇腾社区(昇腾 CANN,02 篇对标来源). https://www.hiascend.com/ (查阅 2026-09-30)