ARTICLE · 1154144
AI自动剪口播视频,我只下了4条指令
AI自动剪口播视频,我只下了4条指令你刷到的口播视频里,旁边那种跟着讲解走的动画,过去一般要设计师对着字幕一帧一帧地抠。现在,AI 已经能自己做出来了。 
今天我做了个实验。只给 AI 一份字幕文件,就是我讲“普通人怎么选 AI 工具”的那条口播:80 句话,1 分 55 秒,聊了腾讯的 WorkBuddy、字节的 TRAE 和 OpenAI 的 Codex。然后跟它说:帮我找配图,做成竖屏的 MG 动画,前面我要放主播。 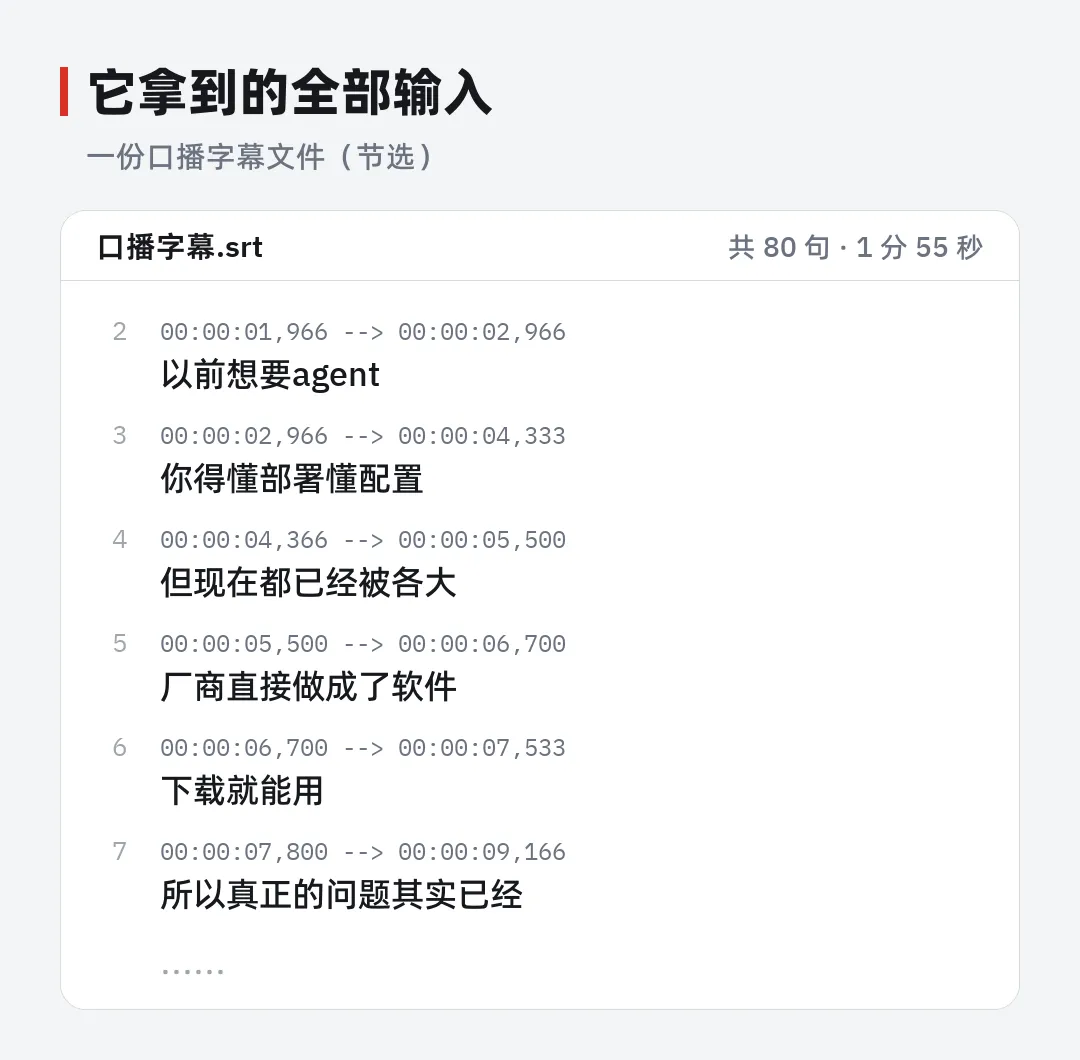
图 1|它拿到的全部输入:一份口播字幕(节选) 这里说的 MG 动画,就是口播视频里主播旁边那些会动的图文:截图、标签、红框、大字,跟着讲解一个个蹦出来。 干活的是 Claude Code,一个能自己写代码、运行程序的 AI 编程助手。从拿到字幕到交付,前后一个多小时,我一共说了七八句话。下面按时间顺序,把它是怎么干的、我是怎么说的,都摊开给你看。 第一步:一句话交代任务 我发给它的第一条指令,原话是这样的: 我的提示词 ① 这是一个新的 srt 字幕文件,现在我需要你根据这个字幕先帮我找新闻图,或者适合字幕的图片素材,素材找好后,帮我把整个字幕做成 MG 动画,要包括这些图片。我的目的是最后要做成一个口播素材,前景我会放主播人物,尺寸是 9:16 手机的尺寸,不要做成横屏了。 这句话里其实只有三件事:先找图,再做动画,最后的用途和尺寸。我没告诉它用什么软件、分几个镜头、配什么颜色——这些都留给它自己判断。 它回的第一句也挺有意思:上次的教训是主播位置没先确认、导致返工,所以这次先把竖屏里主播的位置和字幕高度定下来,同时让找素材的工作先在后台跑。也就是说,它会记住上一次踩过的坑。 第二步:两个助手同时找图,顺手把稿子核了一遍 动画还没动,它先拆出两个子助手同时上网:一个查 WorkBuddy,一个查 TRAE 和 Codex。 我事先定过规矩:只用官方来源,不用新闻图片社的照片,AI 生成的图要注明。所以两个助手只翻官网、官方文档和官方公告,分别用了二十多分钟和四十多分钟,一共交回 83 份素材,每一份都登记了来源页面和原图链接。 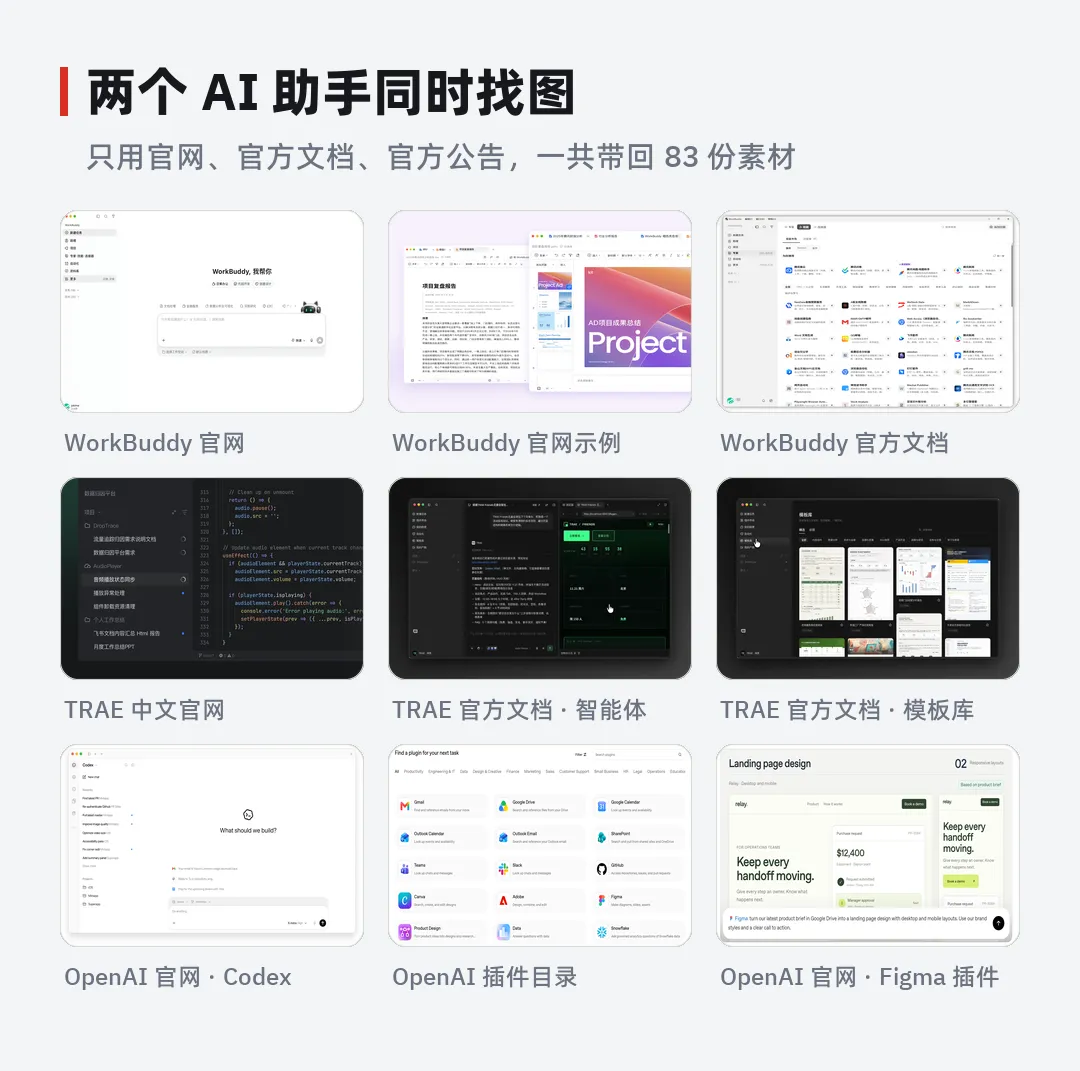
图 2|两个助手带回的部分官方素材 其实更让我意外的是,它顺手把我的稿子也核了一遍。有几处结果,直接改变了画面上写什么: 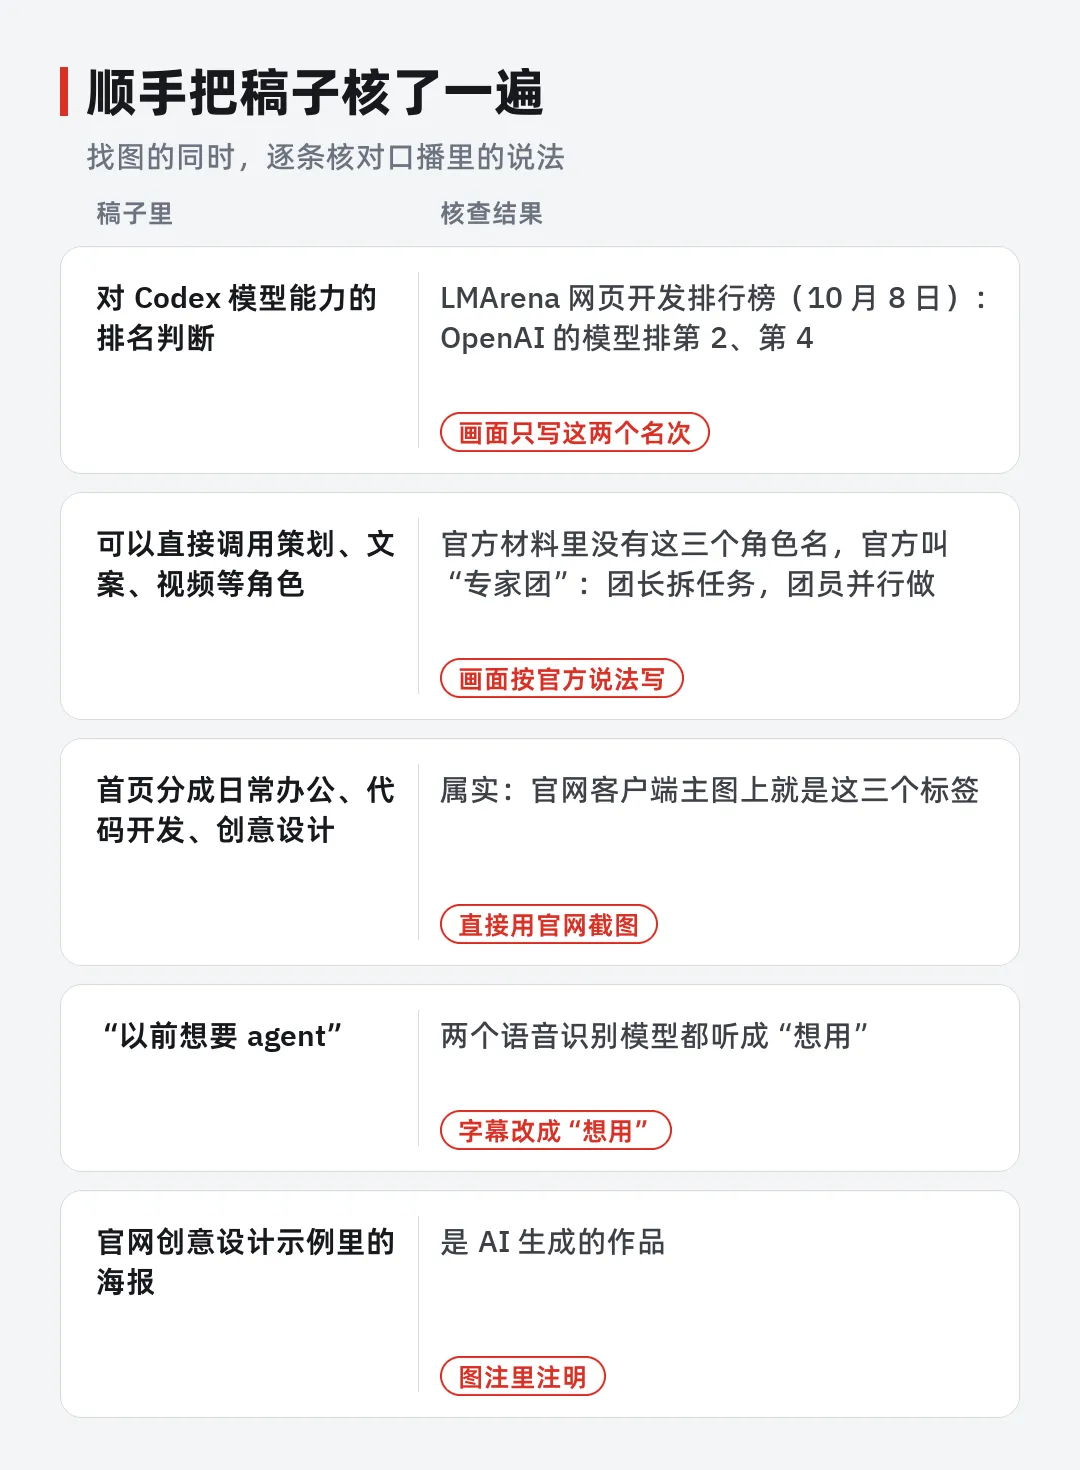
图 3|稿子里的说法和核查结果 第三步:动画是“写”出来的 图还在找,动画已经开工了。它做动画的方式挺特别:不开 AE 这类动画软件,直接写 Python 代码。每个镜头是一段程序,输入一个时间点,算出这一刻的画面;从第 0 秒算到第 115 秒,每秒 30 张,再用 ffmpeg 合成视频。 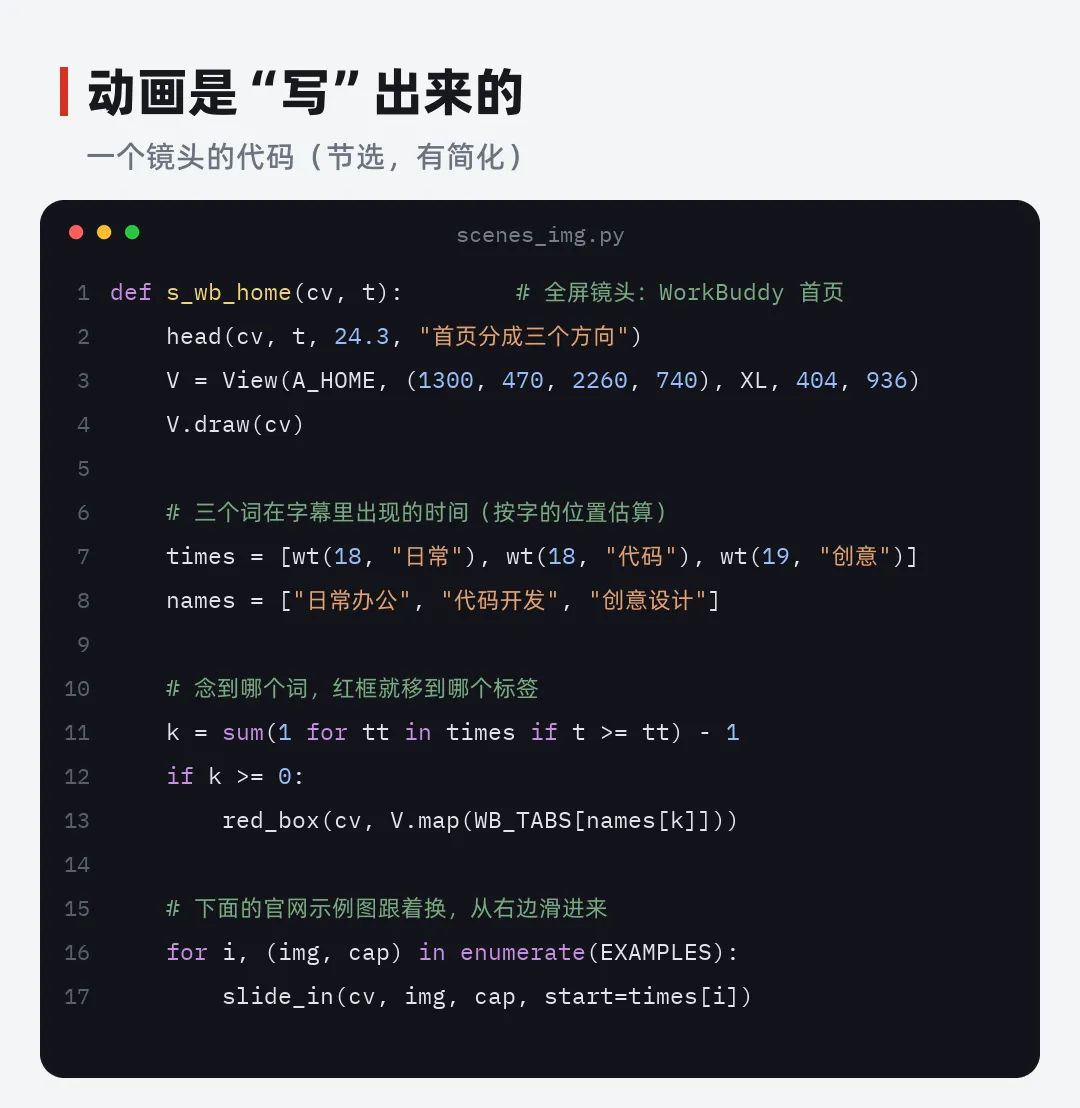
图 4|一个镜头的代码(节选,有简化) 为了让画面跟着我的话走,它会先估算每个词在字幕里出现的时间。我念到“日常办公”,红框就落到首页的“日常办公”标签上;念到“代码开发”,红框移过去,下面换成官网的开发示例。 整条动画 26 个镜头,渲染一遍一分钟左右。改了哪里,马上能重出一版看——这一点比传统剪辑快太多。 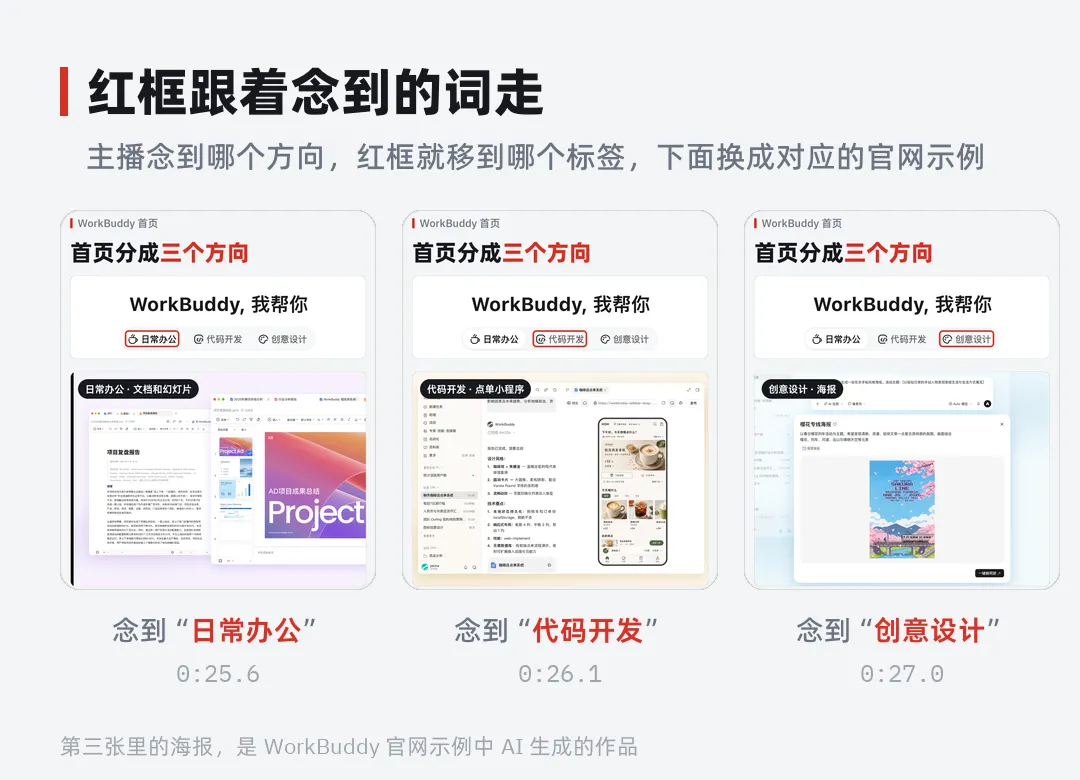
图 5|红框跟着念到的词走(第三张海报为 WorkBuddy 官网示例中 AI 生成的作品) 第四步:我只问了一句“会不会很死板” 一开始,它用的是常见的竖屏版式:上半屏放动画,主播固定在下半屏。我看了样片,只问了它一句: 我的提示词 ② 人物一直固定在下面会不会感觉很死板? 它的回答是会:两分钟都是同一个构图,看着像“上面翻 PPT、下面有人在念”。接着它马上给了我四种机位: 大约 5 到 10 秒换一次,都卡在句子和句子之间直接切。它还用两道选择题让我拍板:主播的位置由谁来移动?全屏那几秒主播暂时离开画面行不行?我各点了一下,它就按当时的机位把之后每个镜头重新排版:主播在哪、有多大,画面就让出哪一块。 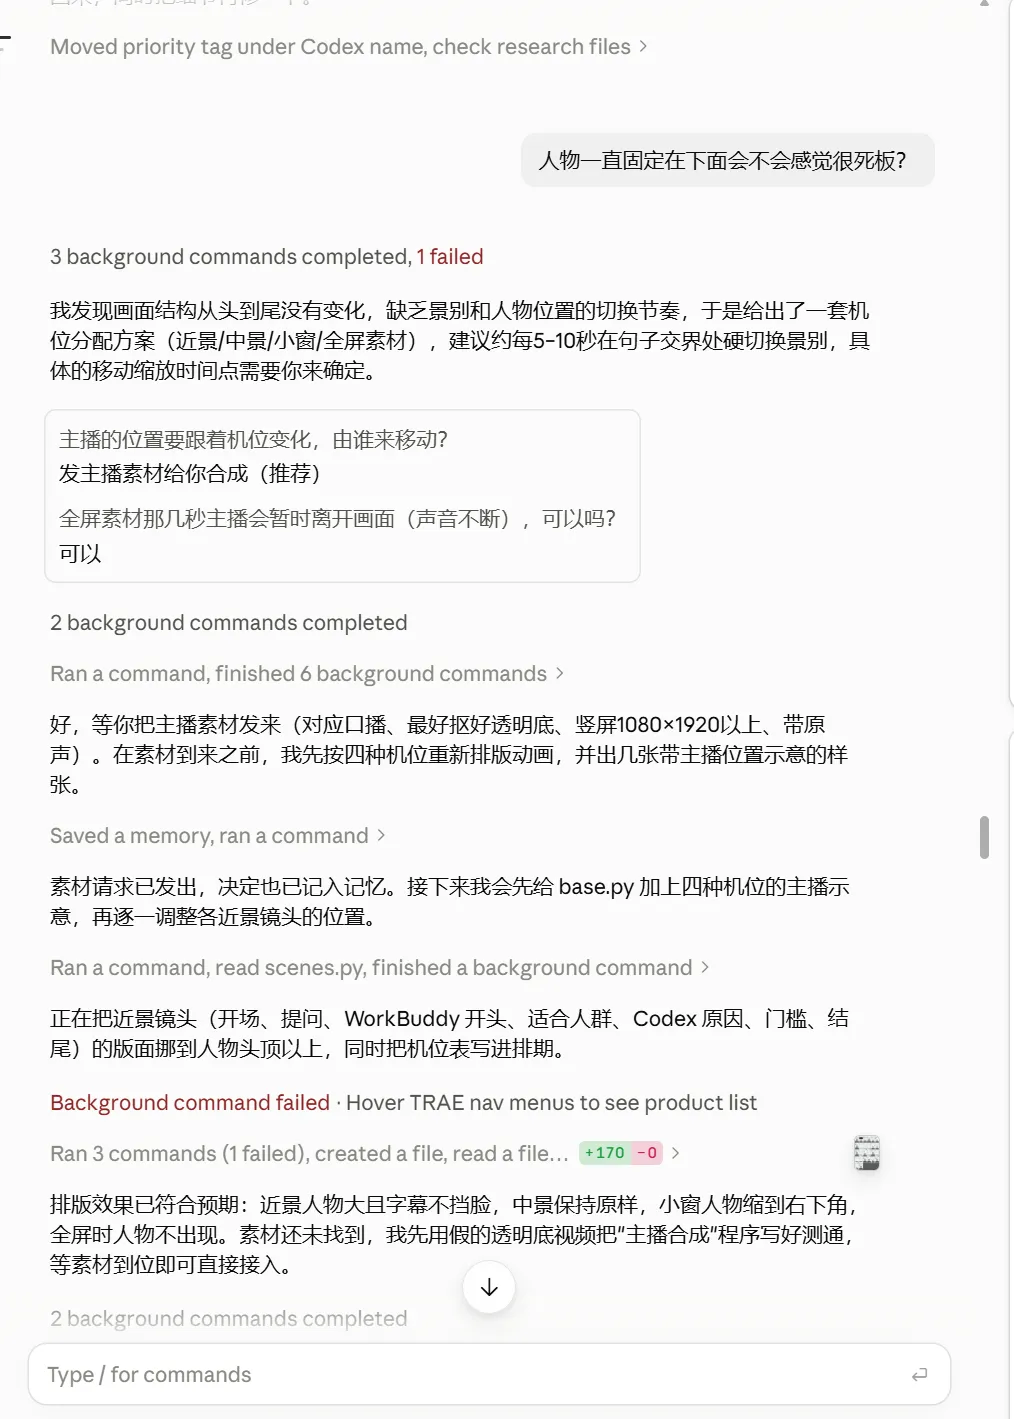
AI 给出机位方案后,用两道选择题让我拍板(操作截图) 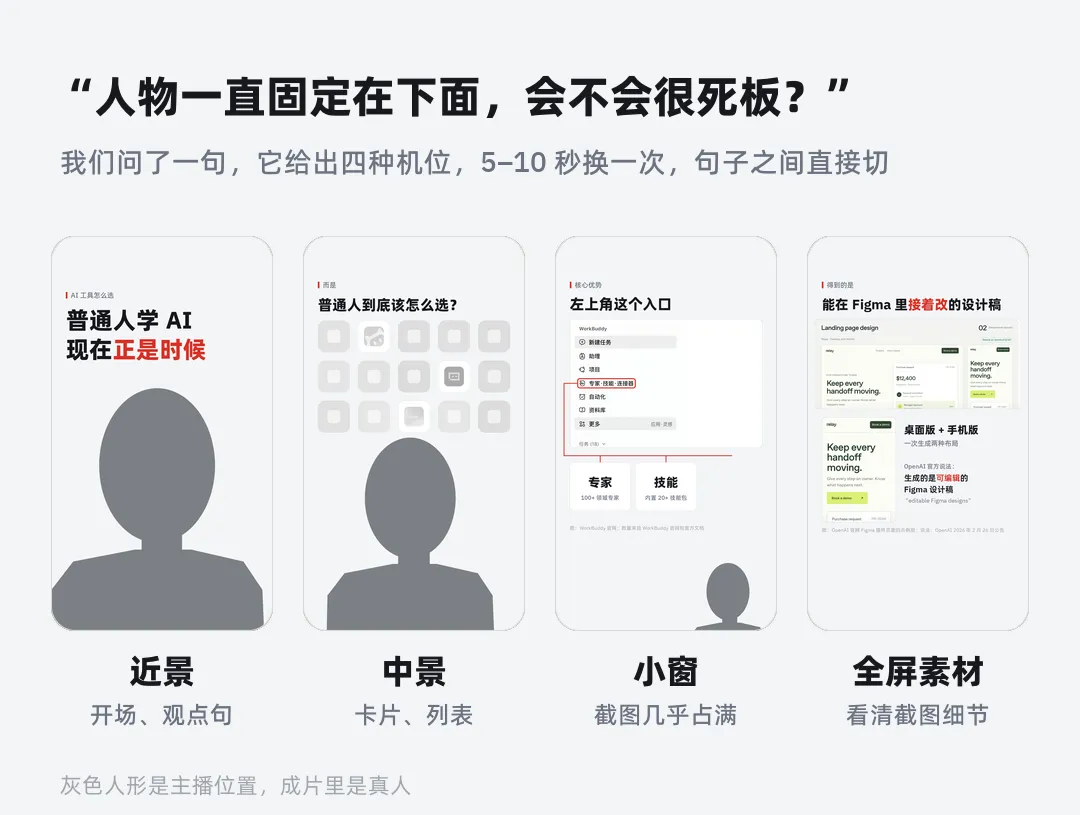
图 6|四种机位(灰色人形是主播的位置) 第五步:发主播视频,它查出了我没发现的问题 动画做得差不多了,我把主播的原视频发给它: 我的提示词 ③ 这是主播视频,然后里面声音和字幕你帮我检查下,和你现在的字幕是不是对的上,如果对不上你帮我改下,然后把这个主播抠像,放进你正在做的这个 MG 动画里面去。 它先看了视频的基本情况:分辨率、时长、背景是不是绿幕、有没有声音轨。然后用两个 Whisper 语音识别模型(在本地显卡上跑)把音频转成带时间的文字,再和字幕逐字对齐,发现了两个问题: 说实话,这两个问题我自己都没发现。成片按 1.2 倍速出,是我定的;它把字幕和动画整体往后挪了 0.2 秒,挪完以后,每句开头和声音的平均偏差在 0.03 秒左右。另外还改了几处字:音频里说的是“以前想用 agent”,字幕写成了“想要”;语音识别把 WorkBuddy 听成了“workbody”,也一并改正。 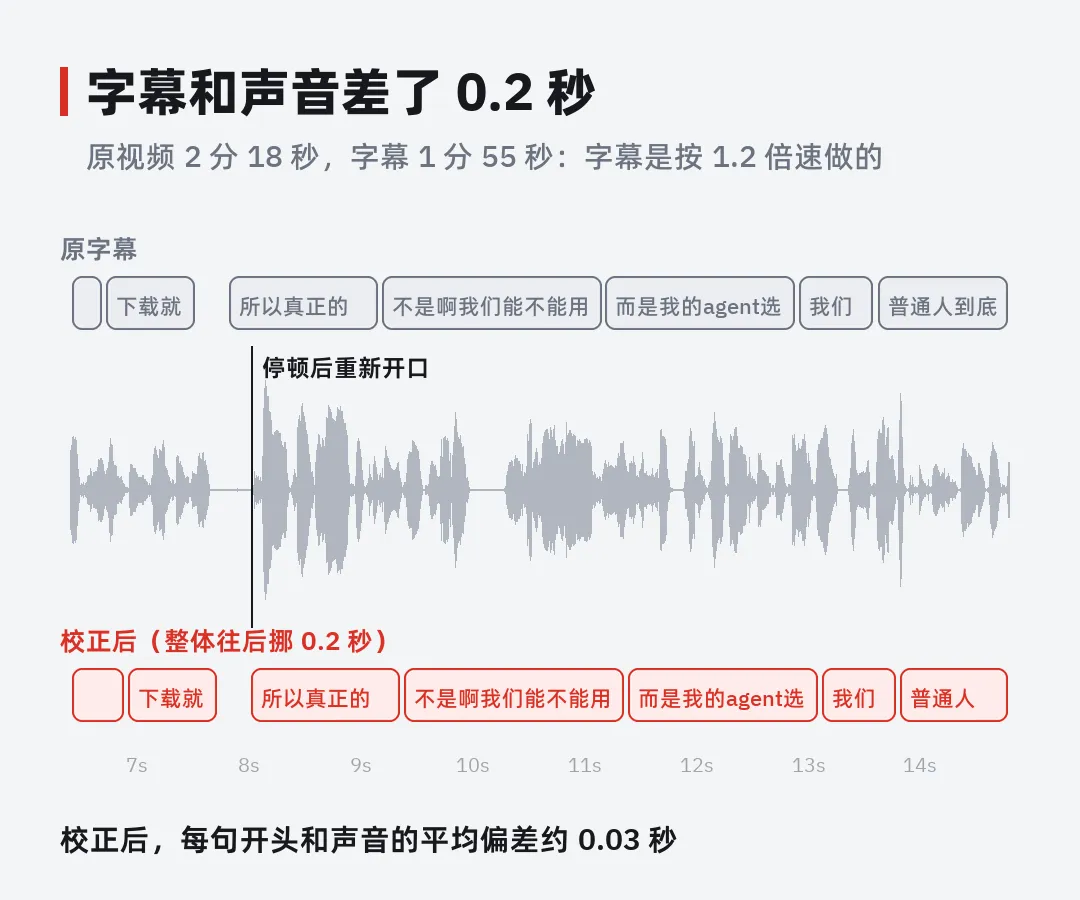
图 7|字幕和声音的对齐 它还量了主播在原画面里的位置和比例,给每种机位算好了缩放和坐标;又找了一个字幕高度,放在画面高度的 76% 到 81% 之间,四种机位都试过,不会挡住脸。 第六步:它会自己挑毛病 每做完一批镜头,它都会出一张关键帧总览,叠上灰色人形和字幕条,看有没有东西被挡住。后来它又写了个小检查:逐个镜头比较“切走前的那一帧”和“所有元素都出来以后的样子”,看有没有哪句字刚出来就被切走。 这一查又找出 4 处。比如“优先考虑”这个标签,原本出现后不到半秒就切走了,它把出现时间往前挪了。 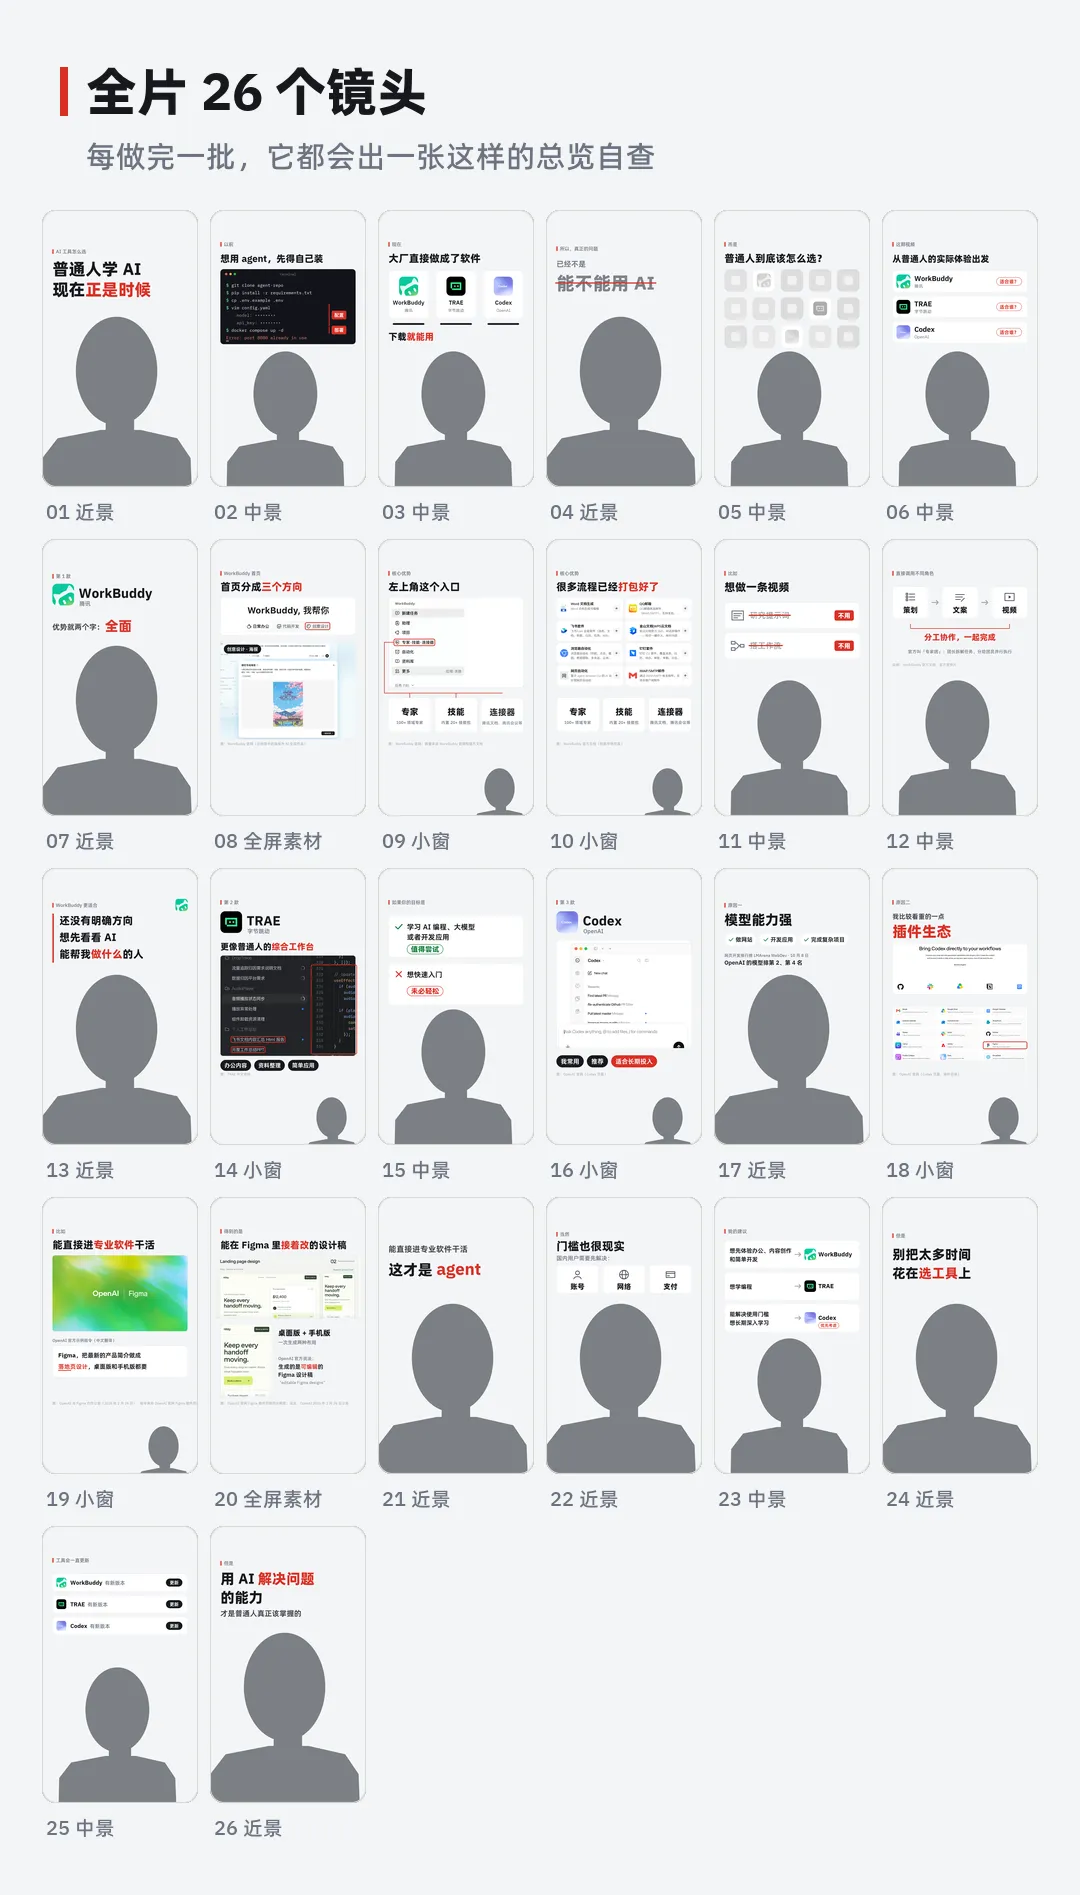
图 8|全片 26 个镜头的关键帧 抠像这一步,交给了 ChatCut 自动完成 主播抠像这一步,Claude Code 没有做。原视频是在普通墙面前拍的,不是绿幕,分辨率也只有 544×960。电脑上没有专门抠视频人像的模型,要么从网上下载一个,要么用现成的通用分割模型凑合,头发边缘会偏硬。 它问我要不要从网上下载一个抠像模型,我想了想,回了一句: 我的提示词 ④ 这样,你先把 MG 动画做出来,抠像我去 ChatCut 里想办法。 它马上调整计划:不下载模型了,集中把动画做完。最后交回来的是这几样: 最后的抠像,是在剪辑软件 ChatCut 里自动完成的:它自动把主播从普通墙面的背景里抠出来,再和这条 MG 动画合成成片。不是绿幕拍的素材,也不用我一帧一帧手动抠。 所以整条视频其实是两个 AI 工具配合完成的:Claude Code 负责找图、核稿、做动画、对字幕,ChatCut 负责抠像和合成。 我的提示词,可以直接抄 回头看,整个过程我真正“下指令”的只有这四句话。我把它们整理成一个可以复用的流程:
如果你也想试,我建议第一条指令里写清楚这三样,其余的交给它: 几点实际的感受 一是时间。从拿到字幕到交付,前后几个小时,找图和核实占了大头,渲染一遍整条动画只要一分钟左右。 二是分工。我做的事情变成了提意见和拍板:四种机位是从那句“会不会很死板”来的;抠像交给 ChatCut 自动处理,也是我定的。 三是规矩。我事先给过它一份发布审核清单:不用极限词、图片要登记来源、AI 生成的图要注明。它做每个镜头都照着执行,画面上把排名判断换成实际名次,就是这么来的。 四是原片的质量。主播原片只有 544×960,放到竖屏画面里要放大 1.8 到 2.3 倍,人会比动画软一些。如果还要这么做,拍摄时分辨率要高一些。 所以我的感受很简单:找图、核对、做动画、对字幕这些活,AI 已经能接过去,而且干得挺细;但做成什么样、哪里要改,还得是人来拿主意。 你觉得这样做出来的动画,能看出是 AI 做的吗?欢迎在留言区聊聊。 文中产品截图来自 WorkBuddy、TRAE、OpenAI 的官网和官方文档,版权归原方所有;动画画面由 AI 编写的程序生成;排行榜数据来自第三方网站 LMArena(2026 年 10 月 8 日),非 OpenAI 官方数据。
排名只写名次。稿子里有一句对 Codex 模型能力的排名判断。助手去查了 LMArena 的网页开发排行榜(10 月 8 日),OpenAI 的模型排在第 2 和第 4。画面上就只写这两个名次,不帮我把话说满。 名称照官方。我说 WorkBuddy 能“直接调用策划、文案、视频等角色”。官方公开材料里找不到这三个角色名,官方的叫法是“专家团”:团长拆解任务,团员并行完成。画面按官方的说法写。 AI 图要标注。WorkBuddy 官网“创意设计”示例里的那张海报,是 AI 生成的作品。动画用到这张图时,图注里注明了。
近景:主播放大,画面上只留一句大字,用在开场和观点句; 中景:主播在下半屏,上半屏放卡片和列表; 小窗:主播缩到右下角,截图几乎占满屏幕; 全屏素材:主播暂时离开画面,声音不断,用来看清截图细节。
原视频 2 分 18 秒,字幕只有 1 分 55 秒,比例是 1.2。也就是说,这份字幕是按 1.2 倍速的版本做的; 就算按 1.2 倍速算,字幕整体还早了 0.2 秒左右。它又用音量检测找出说话的停顿处复核了一遍,结论一样。
无声的 MG 动画成片(1080×1920,30 帧,放最底层); 加速到 1.2 倍的主播视频; 校正后的字幕; 一张机位表:每段从第几秒到第几秒、主播放多大、放在哪,方便我在剪辑软件里摆; 一条带灰色人形和声音的审片版,只用来检查; 改了能直接重新渲染的工程文件。
规矩:素材从哪来(比如:只用官方来源,AI 生成的图要注明); 用途:最后拿去干什么(比如:口播素材,前景放主播); 规格:尺寸和方向(比如:9:16 竖屏,不要横屏)。