ARTICLE · 1157720
8万Star的REA火了:没有源码,AI也能帮你拆软件
你电脑里装着一个很好用的老软件。用了几年,公司不再更新它,文档找不到,开发者也联系不上。某个功能突然出了问题,你知道它以前怎么工作,却不知道问题藏在哪一行代码里。
过去,想拆开这样的软件,往往得请懂逆向工程的人。拿到的不是原作者的代码,而是已经编译好的程序。它像一台封好外壳的机器,你要沿着零件和电路,倒着推回当初的设计。
最近爆火的REA,试图让AI也加入这种调查。项目名字是Reverse Engineer Anything,被一些中文报道叫作“逆向灭霸”。截至10月11日,其GitHub仓库已获得超过8万颗星。热闹的名字背后,是一项很具体的工作:让编程智能体调用分析工具,追踪软件究竟怎样运行。
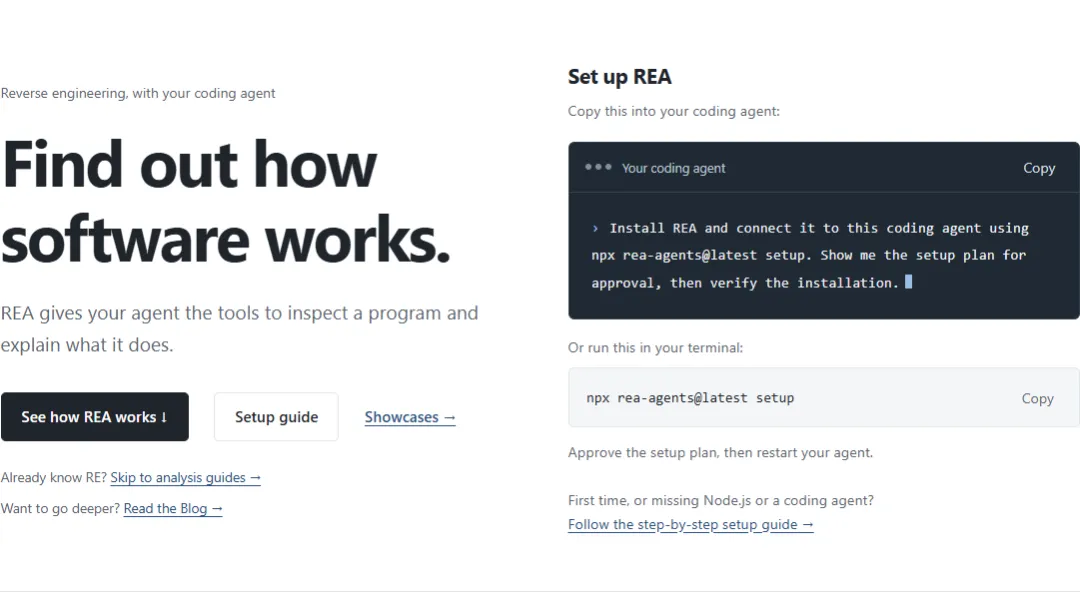
REA并不是一个把所有软件瞬间变回源代码的按钮。它更像工具接口,把原本属于专业分析环境的信息,交给能够连续追问的AI。智能体看到一段可疑逻辑,可以继续找调用者、查看数据、比较结果,而不是读完一页代码就停止。
这里有个容易被名字遮住的事实:很多底层分析仍然依靠已有的专业工具。处理原生程序,需要相应的反汇编或反编译环境;分析JavaScript和Electron应用,则会用到不同路径。REA把这些能力接起来,不意味着所有文件都能由同一个方法无损还原。
从原始机器指令中,确实可以恢复不少行为:某个按钮触发了什么,数据怎样传递,一个数值为什么被算成这样。但程序编译之后,原来的注释、变量命名与设计思路可能已经不在里面。你看到的伪代码,是帮助理解的表达,并不一定是作者当年写下的那一份。
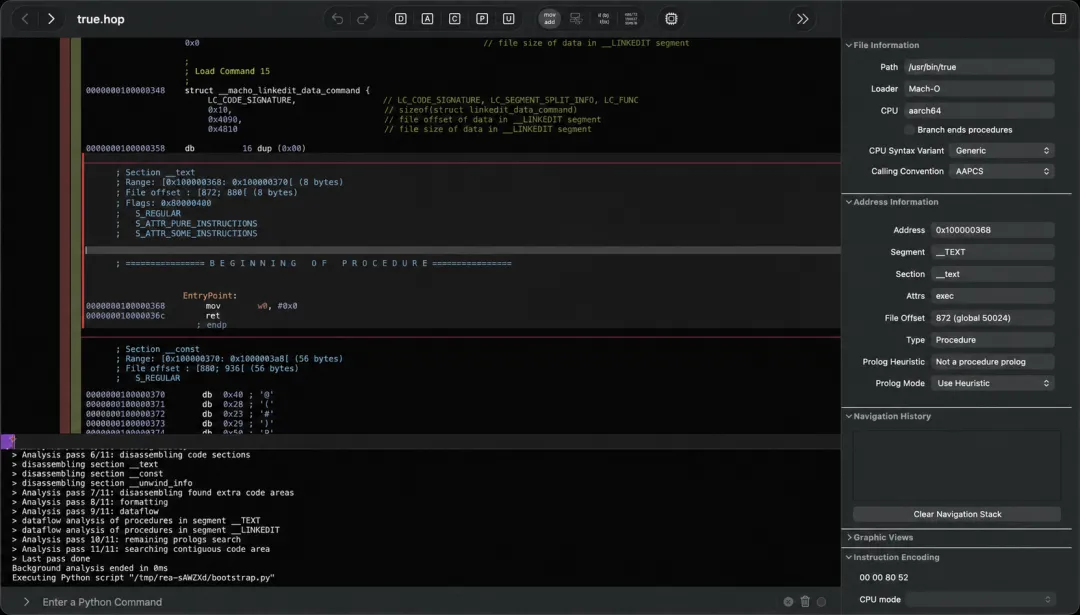
这像从一栋现成建筑,反推它的施工图。墙在哪、管线怎么走,可以勘查;设计者最初放弃过哪些方案,为什么临时改了一个房间,却未必能仅凭建筑还原出来。
REA官网用一个很日常的问题解释这种能力:为什么计算器里的“200加10%”,可能得到220,而不是200.1?你在屏幕上只看到一个百分号,背后却有一套与当前运算相联系的规则。读懂规则,比模仿按钮的样子更重要。
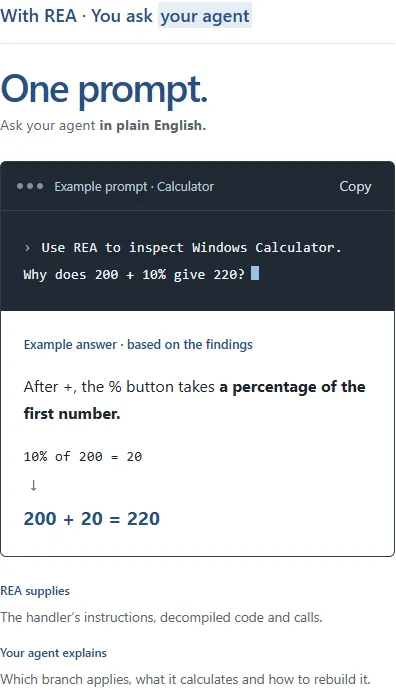
智能体的作用,是把这个问题变成可以逐步查的路径。百分号如何处理输入,处理后的数字传给谁,加法最后用了哪个值。一个人类能够理解的提问,顺着程序内部的结构,变成一连串具体检查。
这种提问方式,把逆向的入口降低了一些。用户未必需要一开始就知道函数地址,也不必先猜对每个模块的名字,可以从行为出发:为什么会这样?但入口低了,不代表结论就天然可靠。AI也可能沿着一条看似合理的路径,读错关键细节。
所以,官方案例中更有说服力的,不是“AI解释得很像专家”,而是解释之后还能拿结果与原程序比。它找出了一段逻辑,重新写出来,再用输入检验两者是否表现一致。
DX-Ball的案例就是这样。研究者追踪老游戏中一个声音左右声道分配函数,查看调用关系、机器指令和常量,恢复相应的C代码。项目对这个函数做了3,205组行为比较,并在指定工具链下核对编译后的字节。
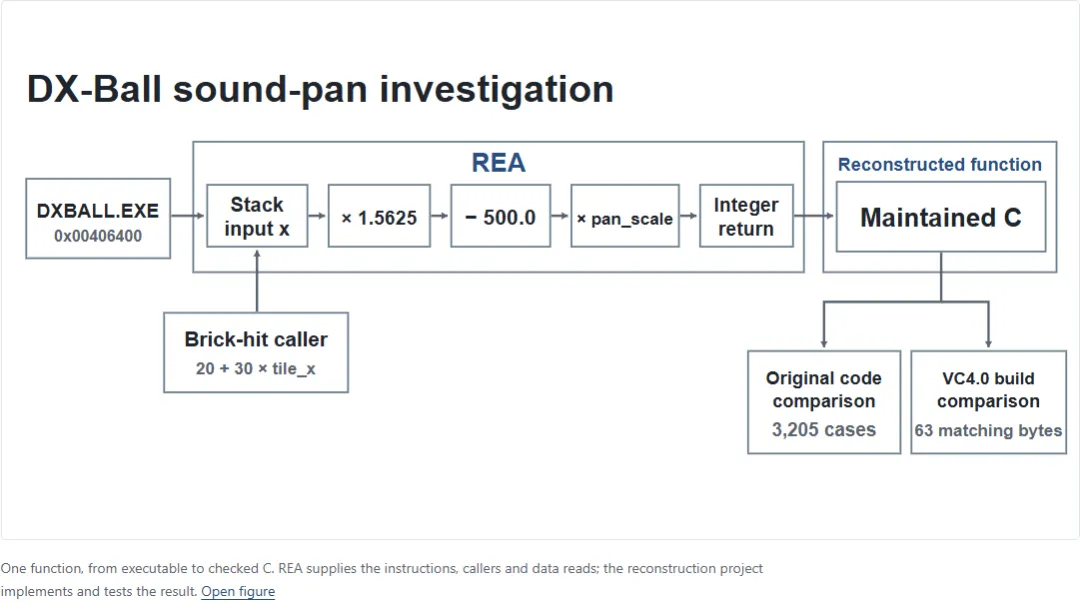
这是一项扎实的局部验证,不是整款游戏已经被一键复制。案例页面也保留了项目仍在推进的部分。一个函数通过测试,说明这一个函数有了可信证据;把它放回完整软件,仍要处理状态、依赖和其他功能。
为什么要如此强调局部?因为软件的难,常常不在一段孤立的算法里,而在各部分怎样一起工作。保存文件时的权限、更新后的兼容、崩溃后的恢复,都可能藏着平时看不见的条件。平常用得顺,不等于在边缘情况里也正确。
REA还展示了浏览器恐龙游戏的分析例子,把游戏行为与相应代码联系起来。这样的案例容易让人直观地感到,AI正在从“照着描述写一个类似游戏”,走向“读原来的实现,再讨论它为什么这样运行”。
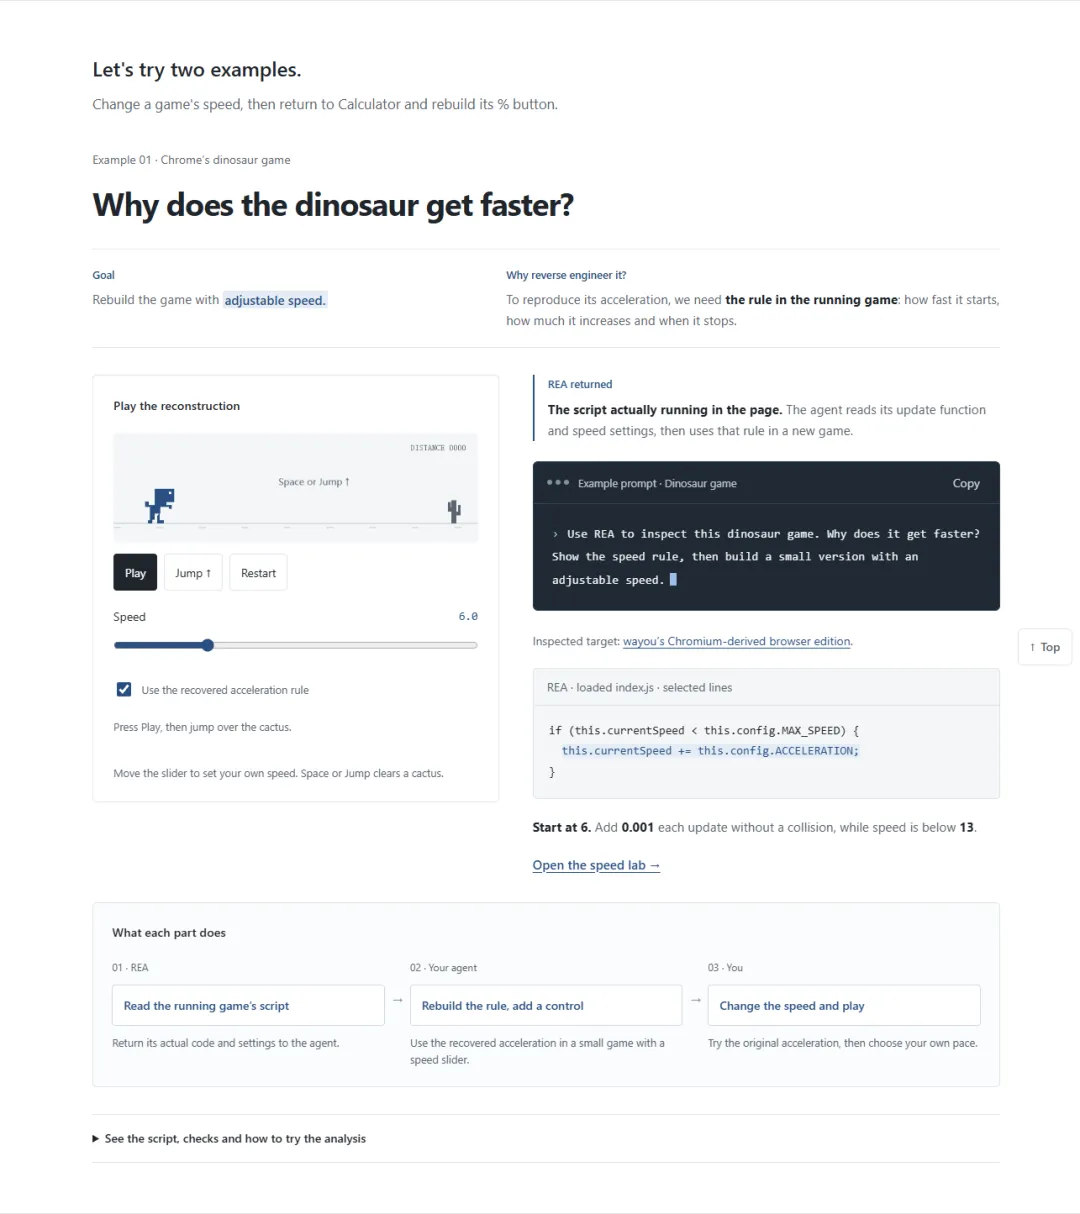
两者看起来接近,信息来源却不同。照着屏幕做,容易漏掉隐藏的规则;读实现,可以找到细节,但仍需要验证这些细节在真实运行时有没有其他条件。最好的结果,是观察与代码互相校验,而不是只相信其中一种。
对开发者来说,这有可能改变维护旧系统的成本。很多组织不是缺少一套全新的软件,而是已有软件没人愿意碰,某个关键模块又不能随便换掉。如果工具能更快解释旧逻辑,维修就不必每次从一片黑箱开始。
跨工具的数据兼容也可能受益。两个应用都说自己支持复制粘贴,传出去的却可能一个是纯文本,另一个还带着结构与格式。调查这些差异,有助于理解互通为什么出问题。不过,发现通信路径与获得合法访问权限,仍然是两件不同的事。
这也是“逆向灭霸”这个称呼需要降一点温的地方。软件价值不只在能被读出的客户端代码里。服务器上的服务、长期积累的数据、业务流程和用户信任,都不会随着反编译一个文件而自动到手。
哪怕外观做得一样,真正使用起来,差别也可能很快出现。原产品知道用户上一轮做过什么,知道失败时怎么恢复,知道怎样处理几十种看似不起眼的例外。复制界面相对容易,复制这些经过长期使用磨出的判断,困难得多。
工具的用途还需要放在授权范围内。分析自己的程序、得到许可的文件,或者符合许可条件的开放项目,与绕过别人的授权、擅自复制商业软件,不是同一件事。能力变得容易调用,也不意味着使用边界消失了。
此外,“本地分析”不等于所有信息都绝不会离开本机。底层工具可以在本地读取文件,但如果智能体使用云端模型,分析结果是否发送给模型服务,还取决于配置和数据政策。处理企业程序之前,需要弄清这条路径,而不是只看一个本地运行的标签。
REA的热度,反映的是一个真实的期待:人们希望AI不只替我们创造新软件,也能帮我们理解已经存在的软件。我们生活里有大量“用得上,却讲不明白”的工具。把它们变得可解释,本身就是很有价值的进步。
只是,可信的理解不会止于一句流畅的说明。它应该能指出自己看到了什么、还没看到什么,哪项结论经过比较,哪项只是推测。软件被拆开之后,新的责任不是少了,而是从“猜里面是什么”,变成“证明自己真的读懂了什么”。
如果这条路走得通,最先受益的未必是做出一个轰动的复制品。也可能是一家终于能维护旧系统的公司,一个找到兼容问题的开发者,或者一款多年无人照料、终于有人能接着修的老游戏。那些被封在程序里的知识,有机会重新回到人能讨论、能修改的世界。
/ / / /
人工智能前沿动态,商业科技一手信息
👇真诚推荐关注👇